ConVIRT:从自然配对的图像和文本数据中对比学习医学视觉表示
原文:Zhang Y, Jiang H, Miura Y, et al. Contrastive learning of medical visual representations from paired images and text[J]. arXiv preprint arXiv:2010.00747, 2020.
1. Abstract
医学图像的视觉表示学习是医学图像理解的核心,但由于手工标记数据集的规模较小,其研究进展受到了阻碍。现有的工作通常依赖于从ImageNet预训练的迁移权重(由于图像特征差异很大,这是次优的),或者依赖于从与医学图像匹配的文本报告中基于规则的提取标签(这是不精确的,而且难以泛化)。我们提出了一种无监督的方法ConVIRT,直接从自然配对的图像和文本数据中学习医学视觉表示。我们通过两种模态之间的双向对比目标,用配对的文本数据预训练医学图像编码器的方法是领域无关的,并且不需要额外的专家输入。我们将预训练的权重迁移到4个医学图像分类任务和2个zero-shot检索任务上,结果表明,我们的方法在大多数情况下都能得到比基线模型更好的图像表示。在所有4项分类任务中,与有监督的ImageNet预训练模型相比,ConVIRT只需要10%的ImageNet标记数据,就能实现更好或类似的性能,显示出更高的数据效率。
2. Method, Experiment and Result
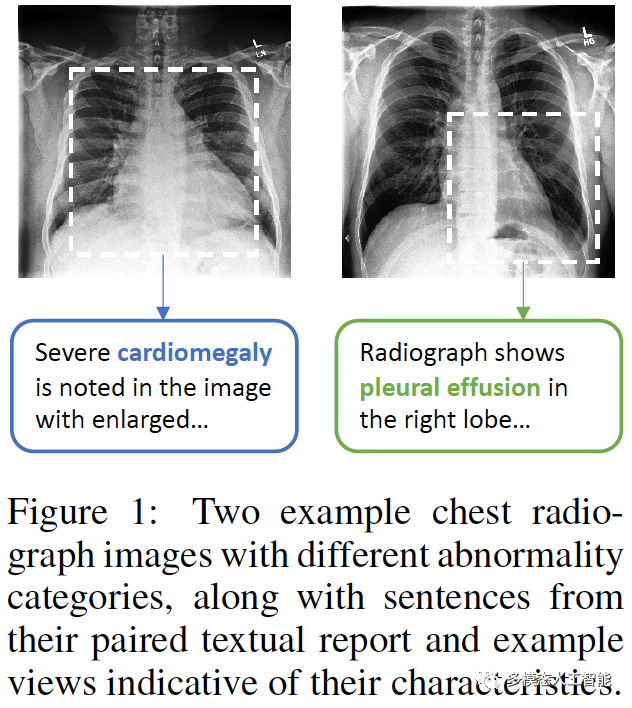
图1. 两个不同异常类别的胸片图像示例,以及来自其配对文本报告中的句子。左图:图像中可见严重的心脏肿大…。右图:X光片显示右肺叶有胸腔积液…。
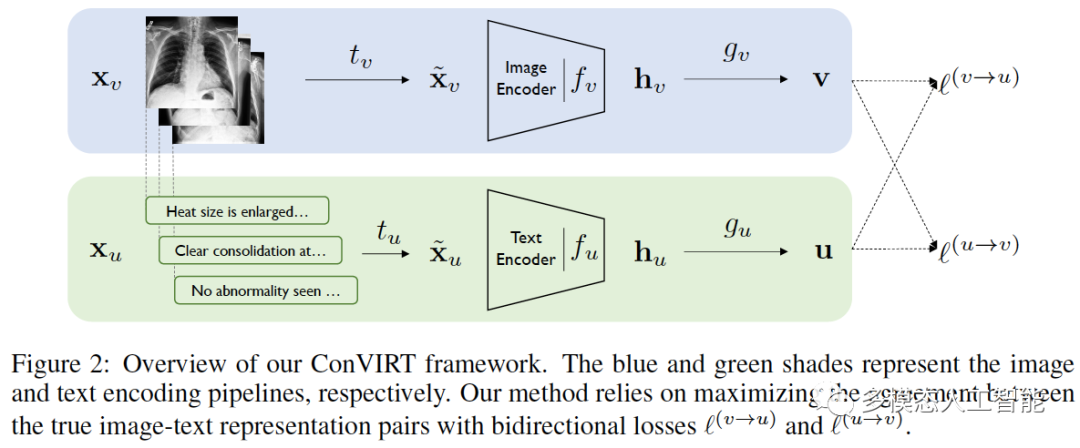
图2. ConVIRT框架的概述。蓝色和绿色分别表示图像和文本编码流程。我们的方法依赖于最大化具有双向损失的图像-文本表示对之间的一致性。
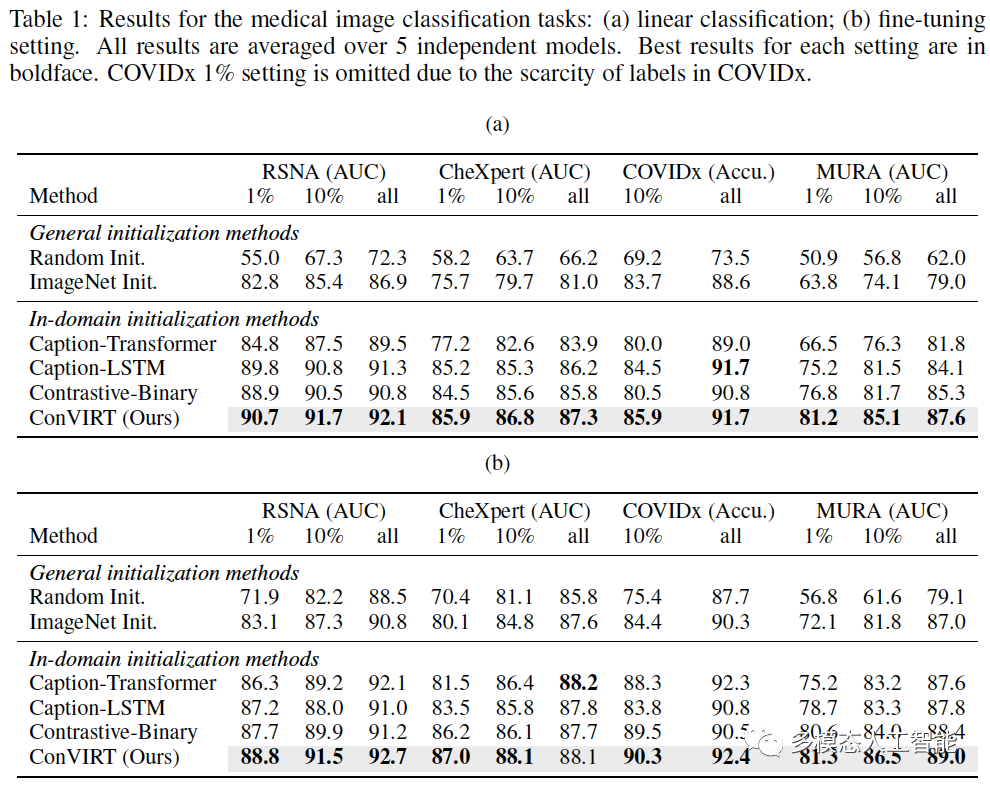
表1. 医学图像分类结果。(a)线性分类;(b)微调设置。所有结果均为5个独立模型的平均值。
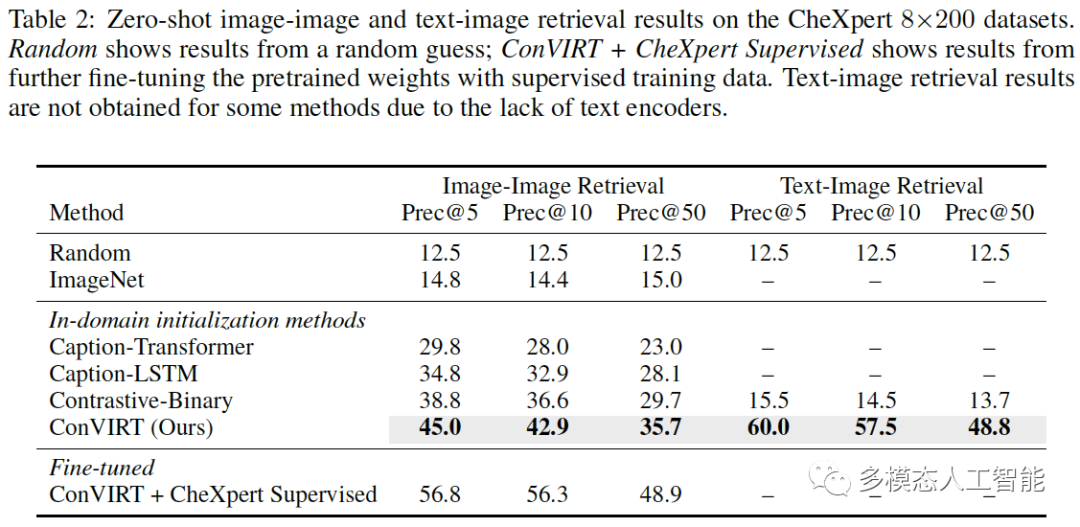
表2. CheXpert 8×200数据集上的zero-shot图像-图像、文本-图像的检索结果。ConVIRT+CheXpert-Supervised显示了使用有监督的训练数据进一步微调预训练权重的结果。由于缺少文本编码器,某些方法无法获得文本-图像检索结果。
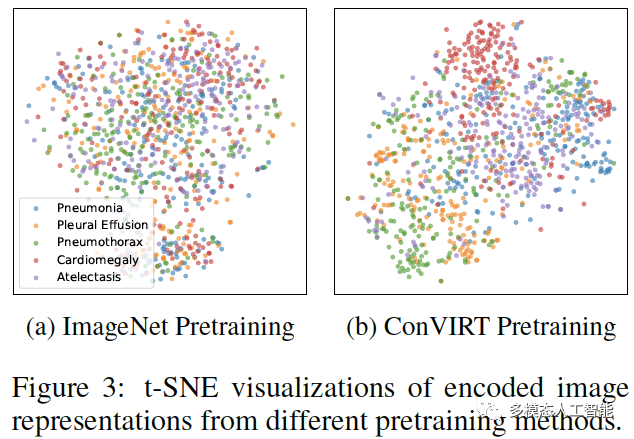
图3. ImageNet和ConVIRT预训练方法的编码图像表示的t-SNE可视化结果。
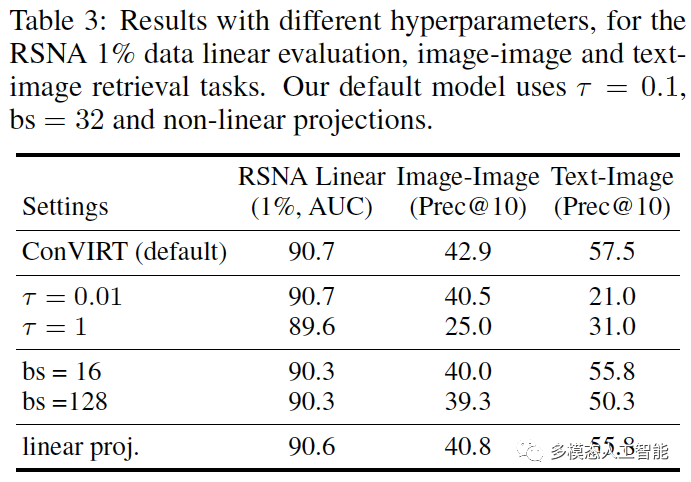
表3. 不同超参数情况下,RSNA线性评估、图像-图像、文本-图像检索任务的结果。我们的默认模型使用τ=0.1、bs=32和非线性投影。
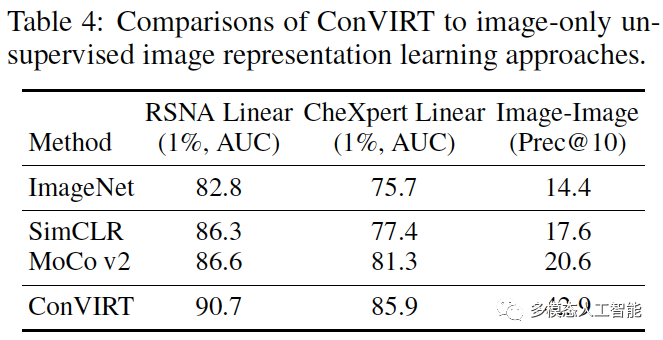
表4. ConVIRT与无监督图像表示学习方法的比较。
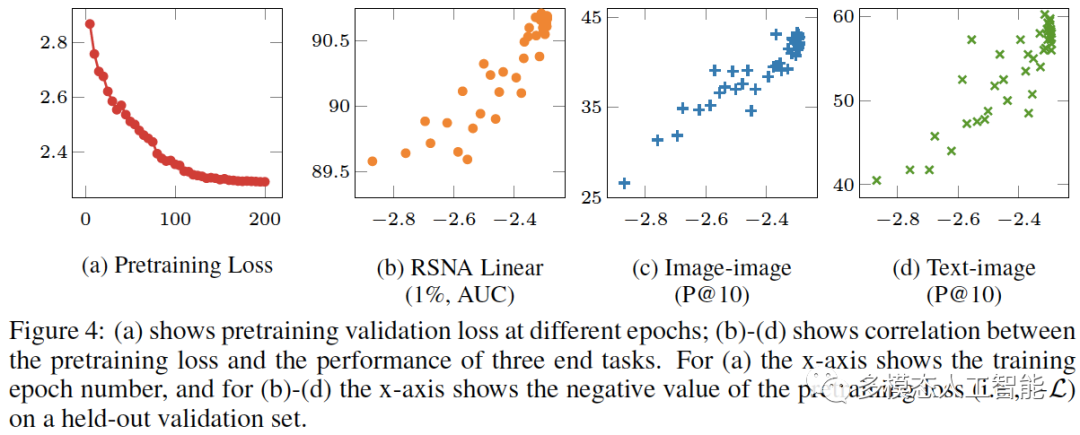
图4. (a)显示了不同epochs的预训练验证损失。(b)-(d)显示了预训练损失与三项任务性能之间的相关性。对于(a),x轴表示训练的epochs。对于(b)-(d),x轴表示在验证集上的预训练损失的负值。
3. Conclusion / Discussion
我们提出了一种无监督的方法ConVIRT,用于从自然配对的图像和文本中学习医学视觉表示。我们的方法依赖于通过两种模态之间的双向目标,将图像表示与配对的文本表示进行对比。ConVIRT在4个医学图像分类任务和2个图像检索任务上的性能优于其他方法,并且得到了更高质量的表示。与有监督的ImageNet预训练模型相比,ConVIRT能够在标记数据少一个数量级的情况下达到相同水平的分类精度。我们希望我们的工作能够启发未来的工作,使文本数据更高效地用于医学图像的理解。
关注“多模态人工智能”公众号,一起进步!

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献3条内容

所有评论(0)