机器学习之K-近邻算法(KNN)
0 参考资料
[1] 【机器学习实战-完整版合集】《菊安酱的机器学习实战》完整版全集,首次大公开!!!_哔哩哔哩_bilibili
[2] 深入浅出KNN算法(二) sklearn KNN实践 - zzzzMing - 博客园 (cnblogs.com)
[3] 利用K近邻(回归)KNeighborsRegressor进行回归训练并预测_小臭猪的大臭猪的博客-CSDN博客
[4] 特征工程学习笔记_liuqihang11的博客-CSDN博客
1 KNN算法概述
k-近邻算法(k-Nearest Neighbour algorithm),又称为KNN算法。工作原理:给定一个已知标签类别的训练数据集,输入没有标签的新数据后,在训练数据集中找到与新数据最邻近的k个实例,如果这k个实例的多数属于某个类别,那么新数据就属于这个类别,这就是KNN分类算法的工作原理;同KNN分类器类似,KNN回归算法也是寻找出在训练数据集中找到与新数据最邻近的k个实例,但不再是根据K个实例所在分类来确定输入数据的分类,而是返回临近K个数据的平均数。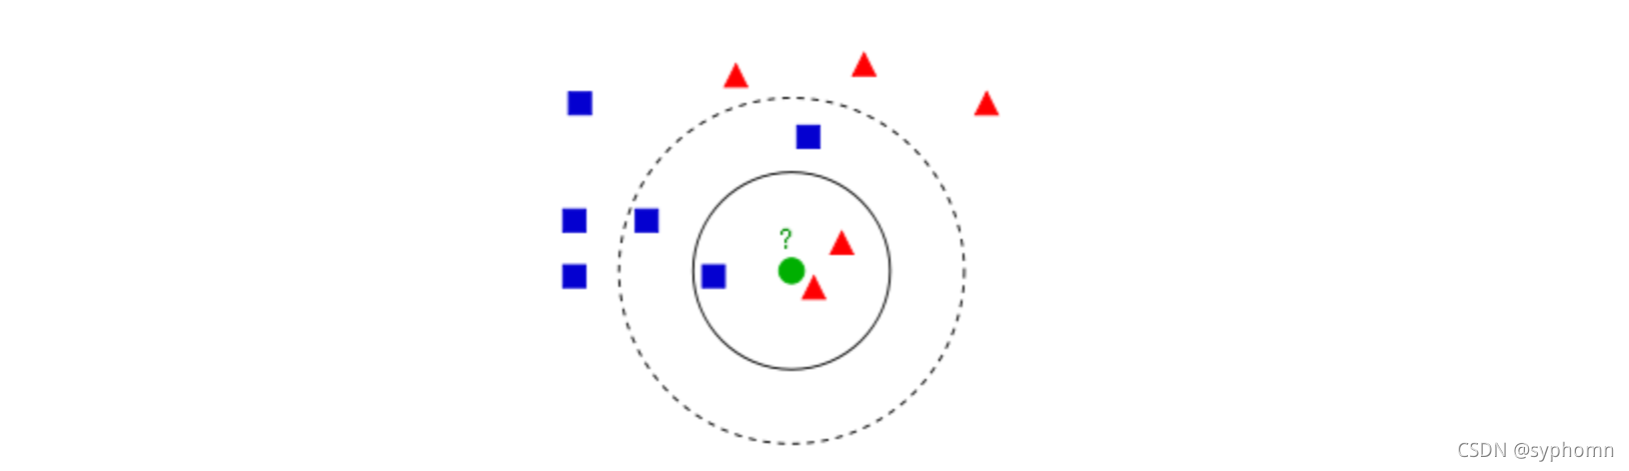
上图中有红色三角和蓝色方块两种类别,现在需要判断绿色圆点属于哪种类别。
当k=3时,离绿色圆点最近的三个实例有两个属于红色,一个属于蓝色,故绿色圆点属于红色三角这种类别;
当k=5时,离绿色圆点最近的五个实例有两个属于红色,三个属于蓝色,故绿色圆点属于蓝色方块这种类别。
2 数据预处理
2.1 数值型数据
KNN算法容易受到数据量纲的影响,在计算之前需要对数据执行归一化或者标准化处理。
2.2 字符型数据
先将字符型数据转化为数值型,再归一化处理。特别地,如果数据的特征都是由字符型数据组成,可以不用转化,不过之后的距离计算不能采用欧式距离,而应该采用汉明距离(sklearn中似乎还没有集成该距离公式)
3 距离计算
KNN算法的核心在于距离计算,对于数值型计算通常采用欧式距离计算公式;对于字符型数据通常采用汉明距离。
N维空间中,欧氏距离计算公式:
汉明距离用于计算两个等长字符串对应位置上不同字符串的个数:例如对于str1='0000',与str2='0101',两个字符串的汉明距离就是2。
4 sklearn实现KNN算法
4.1 KNN分类器
4.1.1 sklearn实现KNN分类的基本流程
(1)导入模块
from sklearn.neighbors import KNeighborsClassifier
(2)实例化
knn = KNeighborsClassifier(n_neighbors=k)
(3)训练
knn.fit(X_train, y_train)
(4)输出预测结果
knn.predict(x_predict)
(5)计算准确率
knn.score(Xtest,Ytest)4.1.2 重要参数
(1)n_neighbors:指 KNN 中的 “K”,需要选取的离待判定数据最近的数据数目。
(2)metric:指定距离度量方法,一般都是使用欧式距离。 'euclidean' 为欧式距离 ; 'manhattan':曼哈顿距离 ;'chebyshev';切比雪夫距离 ; 'minkowski': 闵可夫斯基距离。默认参数为 'minkowski'。
(3)p和metric结合使用的,当metric参数是"minkowski"的时候,p=1为曼哈顿距离, p=2为欧式距离。一般默认为欧氏距离。
(4)n_jobs:指定多少个CPU进行运算,默认是-1,也就是使用全部的CPU计算。
需要指出的是sklearn的KNeighborsClassifier模块没有计算字符串汉明距离的方法,也需要自己定义,或者将字符串转化为可以计算欧式距离的数值型。
KNeighborsClassifier(n_neighbors = K,
                       p = 2,
                       metric = 'minkowski',
                       n_jobs = -1
                       )
4.1.3 KNN求解分类问题实例
下面是一个使用鸢尾花数据集分类的实例,数据来自于sklearn官方。

官方所给的鸢尾花数据集主要包含了鸢尾花的花萼长度,花萼宽度,花瓣长度,花瓣宽度4个特征,以及鸢尾花卉的种类,有Setosa,Versicolour,Virginica三个种类。下面是使用sklearn实现knn分类的Python代码:
from sklearn.datasets import load_iris # 导入数据集
from sklearn.neighbors import KNeighborsClassifier # 导入KNN分类模块
from sklearn.model_selection import train_test_split  # 用于划分测试集和训练集
import pandas as pd

# 本例没有对数据归一化,因为所有数据的范围基本一致,单位也一致
iris = load_iris()
# pd.concat([pd.DataFrame(iris.data), pd.DataFrame(iris.target)], axis=1)  # 以表格形式展现数据

# 划分数据为测试集与训练集,0.3表示0.3为测试集,顺序一定不能乱
Xtrain, Xtest, Ytrain, Ytest = train_test_split(
    iris.data, iris.target, test_size=0.3)
knn = KNeighborsClassifier(n_neighbors=11)
knn = knn.fit(Xtrain, Ytrain)
score= knn.score(Xtest,Ytest)
print(score)
4.2 KNN回归器
回归器的参数与分类器的参数基本一致,只是分类器返回的是最近的k个样本中出现次数做多的类别,回归器是返回k个样本的平均数。
下面使用KNN回归器实现波士顿的房价预测:
from sklearn.datasets import load_boston
import pandas as pd
from sklearn.preprocessing import MinMaxScaler  # 导入归一化模块
from sklearn.feature_selection import SelectKBest, f_regression  # 使用F检验选择特征
from sklearn.model_selection import train_test_split  # 划分训练集与测试集
from sklearn.neighbors import KNeighborsRegressor

x = load_boston().data
y = load_boston().target
scaler = MinMaxScaler()  # 实例化
x = scaler.fit_transform(x)  # 归一化数据结果
selector = SelectKBest(f_regression, k=8)  # 实例化
x = selector.fit_transform(x, y)  # 使用F回归选择最优的8个特征

# 注意,本应该先划分训练集和测试集之后再进行数据处理,但为了简便,这里反过来了,实际上这是不规范的
Xtrain, Xtest, Ytrain, Ytest = train_test_split(x, y, test_size=0.3,random_state=168)
knn = KNeighborsRegressor()
knn = knn.fit(Xtrain, Ytrain)
score = knn.score(Xtest, Ytest)
print(score) # 准确率在80%,还不错(没有调过参数)
北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)