NLP—1.自然语言处理的基础任务与应用
引言
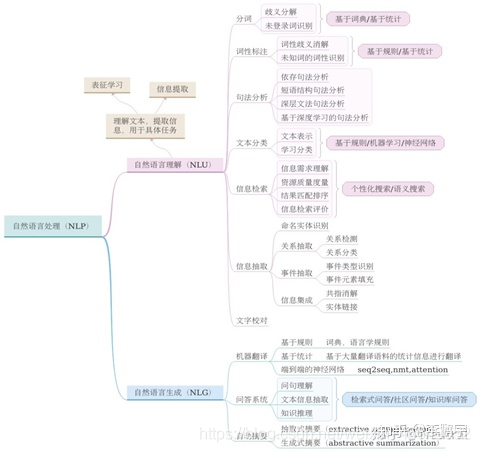
一、自然语言处理基础任务
自然语言处理中包含以下基础任务:
-
分词-word segmentation
Jieba分词
SnowNLP
LTP
HanNLP -
词性标注-POS
句子中的每个单词被分类为一种词性,如动词,名词等,词性标注的过程依赖当前单词以及上下文信息,词性标注问题即序列标注问题。序列标注问题可以当做分类问题,一方面,可以对于当前单词以及上下文单词(sliding window)提取特征,并用这些特征做分类;另一方面,利用序列模型考虑单词之间前后的依赖关系来做预测,常见的序列模型算法有:HMM,CRF,RNN,LSTM,Transformer
词性标注是自然语言最基础的任务,可以认为是Solved Problem(已经解决的问题),很多时候,可以作为上游任务的特征。 -
命名实体识别-NER
命名实体识别类似于词性标注,命名实体识别的结果一般如下:张三/PER 的 家 住 在 北京/LOC
不管是做文本摘要,还是问答系统、对话系统任务,又或者是文本分类任务,实体对任务会产生非常重要的影响。
-
句法分析-Syntatic Analysis
句法分析就是对一个句子的词语句法做分词,比如主谓宾。句法分析的结果是一棵树。这个在工业界用的地方不多。与之类似的依存文法分析(Dependency Parsing)用的地方比较多。在短文本分类中,如何准确的把控短文本的含义呢?针对这个场景,我们要做的是在各个维度来分析短文本 -
语义分析-Semantic Analysis
语义理解涉及两个问题:1、 如何理解一个单词的意思?(理解某个单词在某句话中的意思)
2、如何理解一个文本的意思?(理解整句话的意思)
主要技术有:SkipGram,CBOW,Glove,ELMo,BERT,ALBERT,XLNet,GPT-2,GPT-3,Tiny-BERT
二、自然语言处理应用
- 写作助手(拼写纠错)
- 文本分类
情感分析:将情感分为正面反面
情绪分析:判断一个是否处于高兴、兴奋等状态
主题分类:比如:将新闻类型进行分类 - 信息检索(information retrieval)
信息检索基础架构为:- 检索Query
- 文本处理
- 在数据库中搜索
- 返回排序前多少的结果
- 问答系统
问答系统的目的是直接提供用户的答案。
问答系统和检索系统的区别:检索系统返回相关结果,问答系统则直接返回答案。
问答系统需要更多语义方面的理解。 - 自动生成文本摘要
自动生成文本摘要是一个生成任务。具体任务:给予一个很长的文本,对这些文本进行简化。自动生成文本摘要有两种方法:一种方法是Extractive Method,它是在原始文本中国,抽取几句话来生成摘要,对原始文本不进行改变。另一种方法是Abstractive Method,其过程为:对原始文本进行理解,再将理解到的含义转化为文本。 - 机器翻译
机器翻译有三种方法:一种是Rule-based Method,另一种是Statistical Method,基于统计的语言模型,最后一种是生成式的方式。 - 信息抽取
如果对您有帮助,麻烦点赞关注,这真的对我很重要!!!如果需要互关,请评论或者私信!


北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 5
 0
- 0


 已为社区贡献15条内容

所有评论(0)