Python网络爬虫实战14:爬取酷狗音乐中top500的歌曲
·
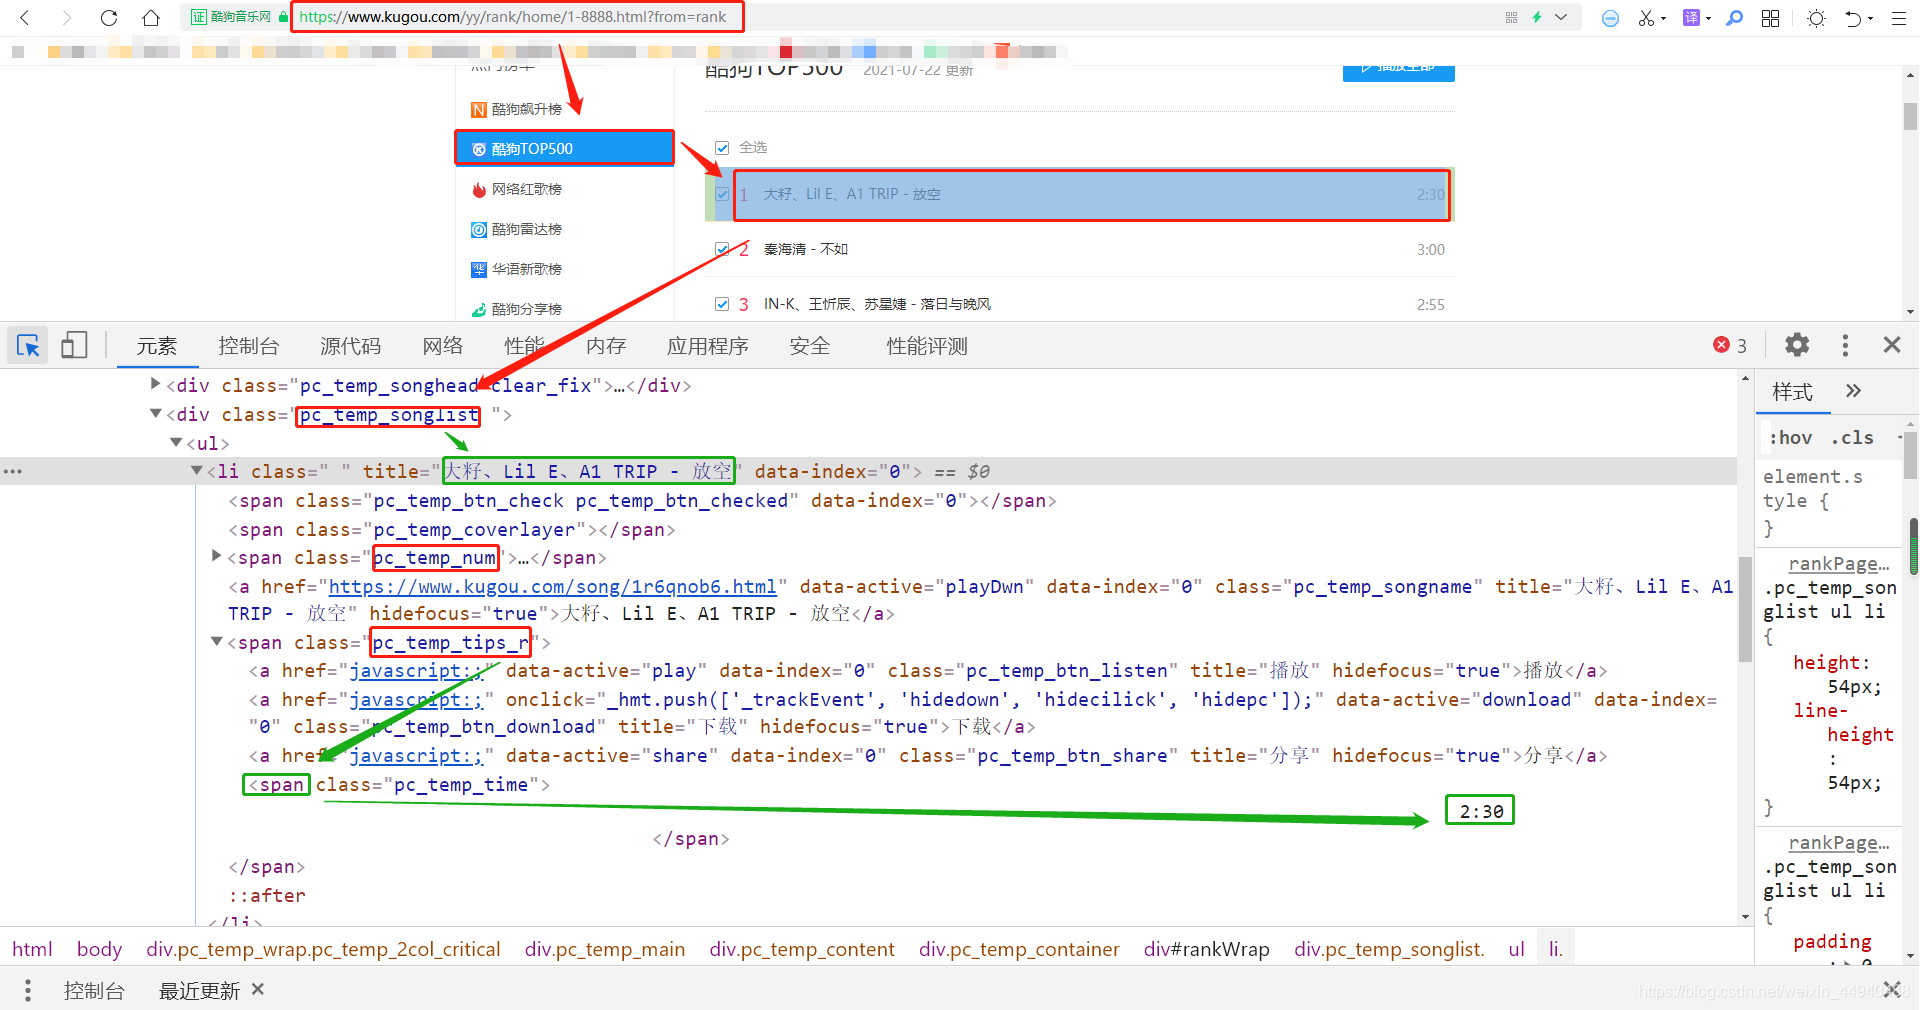
1. 网页源码
2. 代码实例
# coding:utf-8
# 第一步:导入相关库
import requests     # 用于请求网页获取网页数据
from bs4 import BeautifulSoup   # 用于解析网页数据
import time    # 让程序暂停
import io
import sys

# 第二步:编码设置
sys.stdout = io.TextIOWrapper(sys.stdout.buffer,encoding='gb18030') #改变标准输出的默认编码

# 第三步:用户代理设置,伪装浏览器进行访问,便于爬虫的稳定性
headers = {
    'User-Agent':'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/56.0.2924.87 Safari/537.36'
}

# 第四步:用于获取网页信息并输出信息
def get_info(url):
    wb_data = requests.get(url,headers=headers)    # 传入url后进行请求和解析。
    soup = BeautifulSoup(wb_data.text,'lxml')
    ranks = soup.select('span.pc_temp_num')
    titles = soup.select('div.pc_temp_songlist > ul > li > a')
    times = soup.select('span.pc_temp_tips_r > span')
    for rank,title,time in zip(ranks,titles,times):
        data = {
            'rank':rank.get_text().strip(),
            'singer':title.get_text().split('-')[0],
            'song':title.get_text().split('-')[-1],
            'time':time.get_text().strip()
        }
        print(data)


# 第五步:程序的主入口。通过对网页进行观察,利用列表的推导式构造23个URL,并依次调用get_info()函数
if __name__ == '__main__':
    urls = ['http://www.kugou.com/yy/rank/home/{}-8888.html'.format(str(i)) for i in range(1,24)]
    for url in urls:
        get_info(url)
        time.sleep(1)    # 每循环依次,让程序暂停1秒,防止请求网页频率过快而导致爬虫失败
3. 运行结果


北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献5条内容

所有评论(0)