机器学习中的常用概率分布
1、伯努利分布
伯努利分布是单个二值型随机变量的分布。
它由单个参数ϕ∈[0,1]\phi \in [0, 1]ϕ∈[0,1]控制,ϕ\phiϕ给出了等于1的概率。它具有如下的一些性质:
P(x=1)=ϕP(x=0)=1−ϕP(x=x)=ϕx(1−ϕ)1−xEx[x]=ϕVarx(x)=ϕ(1−ϕ)
\begin{aligned}
P(x =1) = \phi \\
P(x =0) = 1-\phi \\
P(x = x) = \phi^x (1-\phi)^{1-x} \\
E_{x}[x] = \phi \\
Var_{x}(x) = \phi(1-\phi) \\
\end{aligned}
P(x=1)=ϕP(x=0)=1−ϕP(x=x)=ϕx(1−ϕ)1−xEx[x]=ϕVarx(x)=ϕ(1−ϕ)
2、多项式分布
多项式分布是指在具有kkk个不同状态的单个离散型随机变量上的分布,其中kkk是一个有限值。多项式分布的参数由向量p∈[0,1]k−1\rm p \in [0, 1]^{k-1}p∈[0,1]k−1参数化,其中每一个分量pip_ipi表示第iii个状态的概率。最后的第kkk个状态的概率可以通过1−1⊤p1-\bf 1^\top \rm p1−1⊤p给出。
注意我们必须限制1⊤p≤1\bf 1^\top \rm p \le 11⊤p≤1。多项式分布经常用来表示对象分类的分布,所以我们很少假设状态1具有数值1之类的。
因此,我们通常不需要去计算多项式分布的随机变量的期望和方差。
多项式分布和伯努利分布足够用来描述在它们领域内的任意分布。
它们能够描述这些分布,不是因为它们特别强大,而是因为它们的领域很简单;
它们可以对那些,能够将所有的状态进行枚举的离散型进行建模。
当处理的是连续型时,会有不可数无限多的状态,所以任何通过少量参数描述的都必须在分布上加以严格的限制。
3、高斯分布
实数上最常用的分布就是高斯分布,也称为正态分布:
下图画出来标准的正态分布:

正态分布由两个参数控制,μ∈R\mu \in Rμ∈R和σ∈(0,∞)\sigma \in (0, \infty)σ∈(0,∞)。
参数μ\muμ给出了中心峰值的坐标,这也是分布的均值:E[x]=μE[x] = \muE[x]=μ。
分布的标准误差用σ\sigmaσ表示,方差用σ2\sigma^2σ2表示。
当我们要对概率密度函数求值时,我们需要对σ\sigmaσ平方并且取倒数。
当我们需要经常对不同参数下的概率密度函数求值时,一种更高效使用参数描述分布的方式是使用参数β∈(0,∞)\beta \in (0, \infty)β∈(0,∞),来控制分布的精度(或方差的倒数):
KaTeX parse error: Undefined control sequence: \cal at position 2:
\̲c̲a̲l̲ ̲N(x; \mu, \beta…
采用正态分布在很多应用中都是一个明智的选择。
当我们由于缺乏关于某个实数上分布的先验知识而不知道该选择怎样的形式时,正态分布是默认的比较好的选择,其中有两个原因。
正态分布可以推广到RnR^nRn空间,略。
4、指数分布和拉普拉斯分布
在深度学习中,我们经常会需要一个在x=0x=0x=0点处取得边界点(sharp
point)的分布。 为了实现这一目的,我们可以使用指数分布:
p(x;λ)=λ1x≥0exp(−λx)
p(x; \lambda) = \lambda \bf 1_{x\ge 0} \exp(-\lambda x)
p(x;λ)=λ1x≥0exp(−λx)
典型的指数分布:
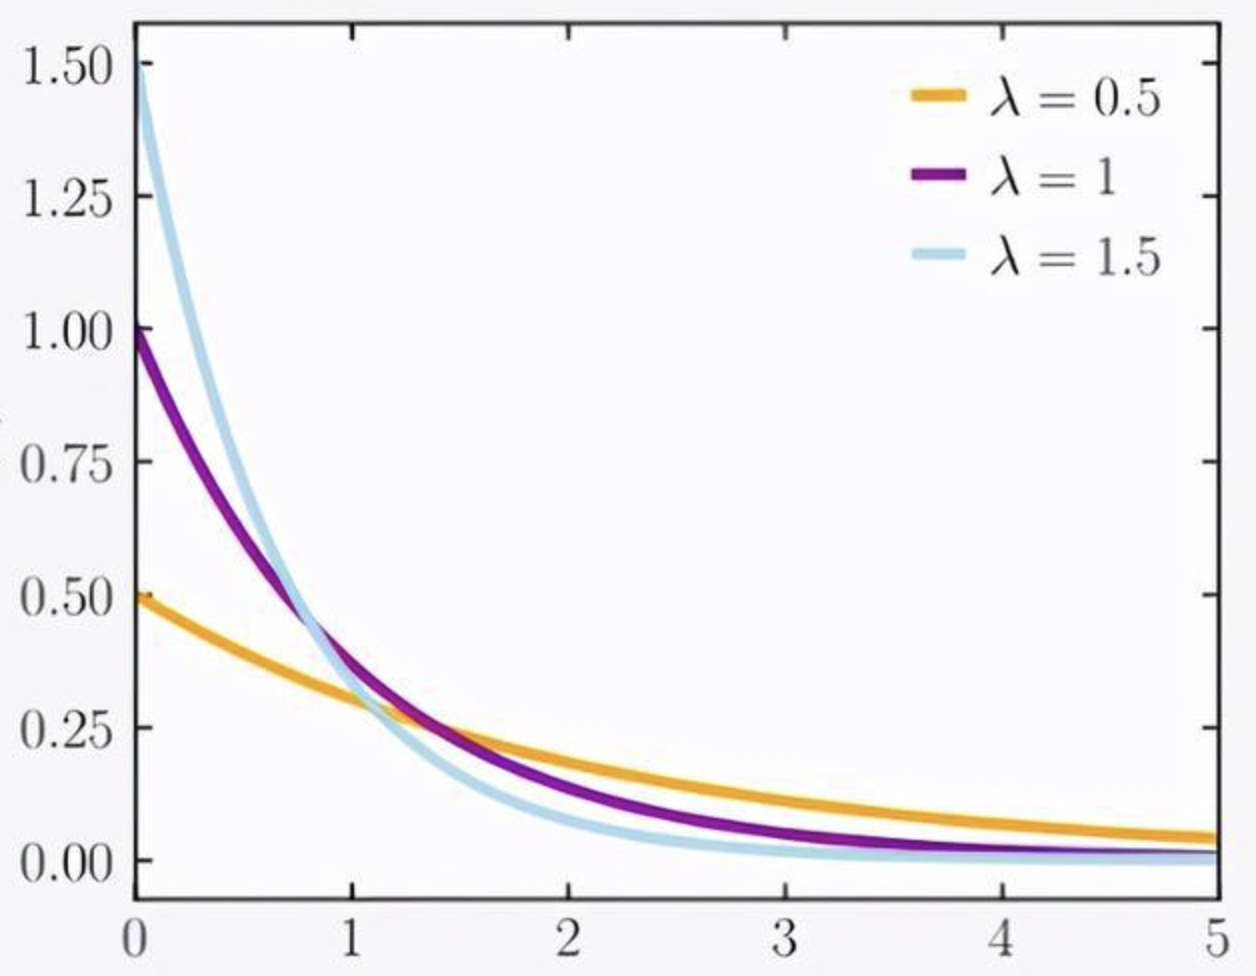
指数分布使用指示函数(indicator
function)1x≥0\bf 1_{x\ge 0}1x≥0来使得当xxx取负值时的概率为零。
一个联系紧密的是拉普拉斯分布,它允许我们在任意一点μ\muμ处设置概率质量的峰值
Laplace(x;μ,γ)=12γexp(−∣x−μ∣γ) \text{Laplace}(x; \mu, \gamma) = \frac{1}{2\gamma} \exp \left( -\frac{|x-\mu|}{\gamma} \right) Laplace(x;μ,γ)=2γ1exp(−γ∣x−μ∣)
5、Dirac分布和经验分布
在一些情况下,我们希望概率分布中的所有质量都集中在一个点上。 这可以通过Dirac delta函数
δ(x)\delta(x)δ(x)定义概率密度函数来实现:
p(x)=δ(x−μ) p(x) = \delta(x-\mu) p(x)=δ(x−μ)
Dirac delta函数被定义成在除了0以外的所有点的值都为0,但是积分为1。
不像普通函数一样对xxx的每一个值都有一个实数值的输出,它是一种不同类型的数学对象,被称为广义函数,是依据积分性质定义的数学对象。
我们可以把Dirac delta函数想成一系列函数的极限点,这一系列函数把除0以外的所有点的概率密度越变越小。
通过把p(x)p(x)p(x)定义成δ\deltaδ函数左移−μ-\mu−μ个单位,我们得到了一个在x=μx=\mux=μ处具有无限窄也无限高的峰值的概率质量。
Dirac delta函数经常作为经验分布的一个组成部分出现:
p^(x)=1m∑i=1mδ(x−x(i))
\hat{p}(x) = \frac{1}{m} \sum_{i=1}^m \delta(x - x^{(i)})
p^(x)=m1i=1∑mδ(x−x(i))
经验分布将概率密度1m\frac{1}{m}m1赋给mmm个点x(1),…,x(m)x^{(1)}, \dots, x^{(m)}x(1),…,x(m)中的每一个,这些点是给定的数据集或者采样的集合。
Dirac delta函数只有在定义连续型的经验分布时,才是必要的。
对于离散型,情况更加简单:可以被定义成一个多项式分布,对于每一个可能的输入,其概率可以简单地设为在训练集上那个输入值的。
当我们在训练集上训练模型时,我们可以认为从这个训练集上得到的指明了我们采样来源的分布。
关于另外一种重要的观点是,它是训练数据的似然最大的那个概率密度函数。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)