爬虫获取豆瓣top250信息(详解版)
·
第一版:
# 拿到页面源代码 requests
# 通过re来提取想要的有效信息 re
# csv 数据存储
import requests
import re
import csv
# 现在要提取名字,年份
url = "https://movie.douban.com/top250"
headers = {
"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/91.0.4472.124 Safari/537.36"
}
resp = requests.get(url,headers=headers)
page_content =resp.text
# 解析数据
# .*? 惰性匹配
obj = re.compile(r'<li>.*?<div class="item">.*?<span class="title">(?P<name>.*?)'
r'</span>.*?<p class="">.*?<br>(?P<year>.*?) .*?'
r'<span class="rating_num" property="v:average">(?P<score>.*?)</span>'
r'.*?<span>(?P<number>.*?)人评价',re.S)
# 开始匹配
result = obj.finditer(page_content)
f = open("data.csv",mode="w",newline="",encoding="utf-8")
csvwriter = csv.writer(f)
for it in result:
# print(it.group("name"))
# print(it.group("year").strip())
# print(it.group("score"))
# print(it.group("number"))
dic = it.groupdict() # 以字典的格式进行存入
dic['year'] = dic['year'].strip() # 单独处理一下,去掉空格
csvwriter.writerow(dic.values())
f.close()
print("over!")
resp.close() # 关掉resp
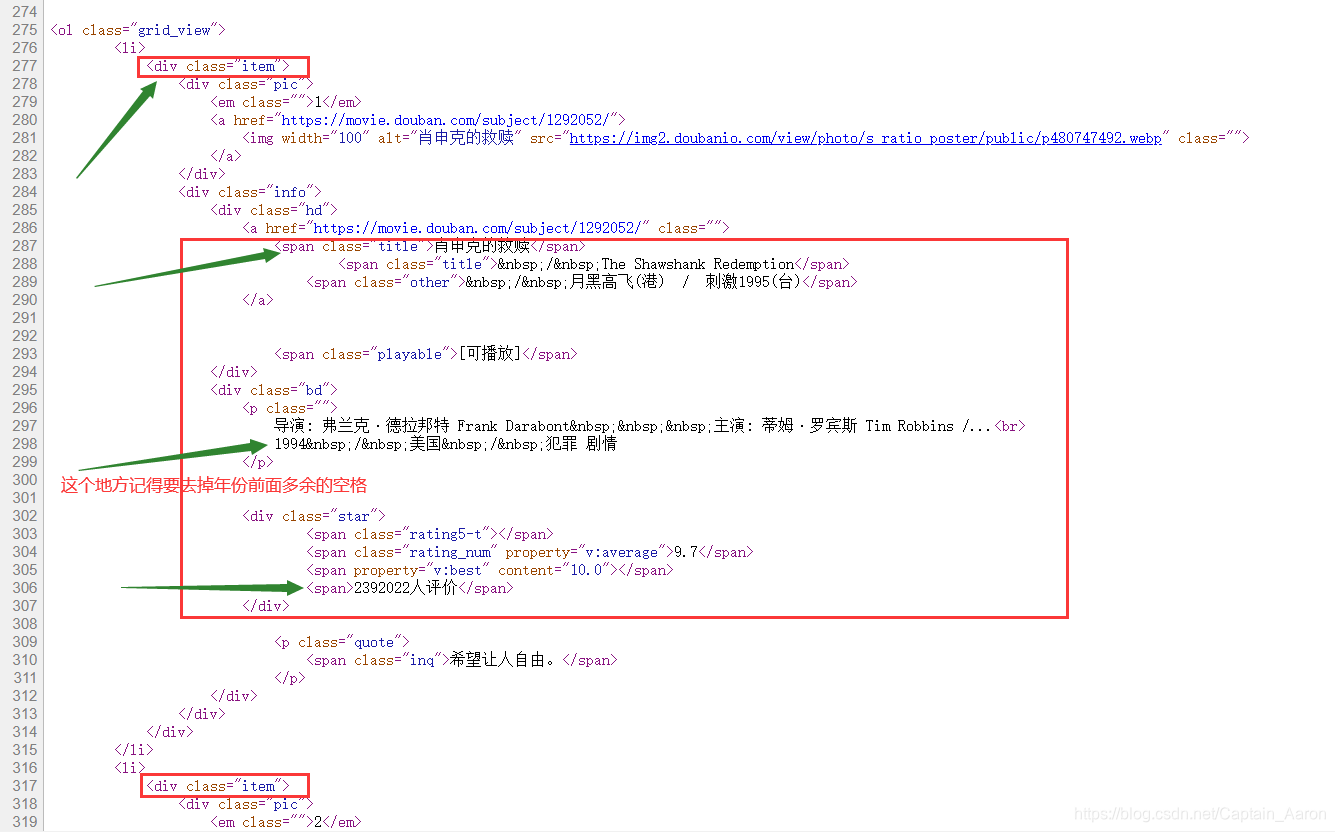
查看网页源代码:
因为豆瓣top250的电影信息是内嵌在网页源码中的,无法从控制台F12直接通过json格式来获取信息,因此需要查看网页源代码,来获取你想要的信息
(定位到电影信息的那个地方)
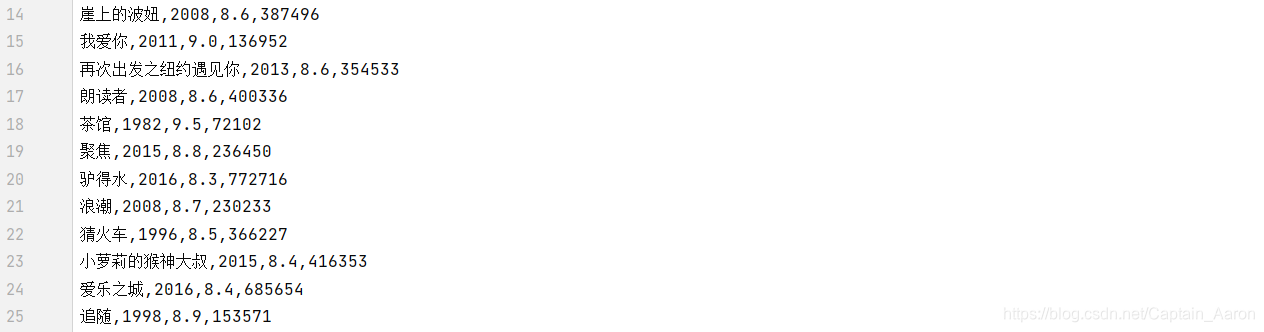
运行结果:(只能获取到第一个页面的25条信息)
第二版:(可以分页获取)
# 拿到页面源代码 requests
# 通过re来提取想要的有效信息 re
# csv 数据存储
import requests
import re
import csv
# 现在要提取名字,年份,评分,评价人数
url = ["https://movie.douban.com/top250?start={}&filter=".format(i) for i in range(0,250,25)]
headers = {
"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/91.0.4472.124 Safari/537.36"
}
page_content =""
for urls in url:
resp = requests.get(urls,headers=headers)
page_content =resp.text + page_content
# 解析数据
# .*? 惰性匹配
obj = re.compile(r'<li>.*?<div class="item">.*?<span class="title">(?P<name>.*?)'
r'</span>.*?<p class="">.*?<br>(?P<year>.*?) .*?'
r'<span class="rating_num" property="v:average">(?P<score>.*?)</span>'
r'.*?<span>(?P<number>.*?)人评价',re.S)
# 开始匹配
result = obj.finditer(page_content)
f = open("data.csv",mode="w",newline="",encoding="utf-8")
csvwriter = csv.writer(f)
for it in result:
# print(it.group("name"))
# print(it.group("year").strip())
# print(it.group("score"))
# print(it.group("number"))
dic = it.groupdict() # 以字典的格式进行存入
dic['year'] = dic['year'].strip() # 单独处理一下,去掉空格
csvwriter.writerow(dic.values())
f.close()
print("over!")
resp.close() # 关掉resp
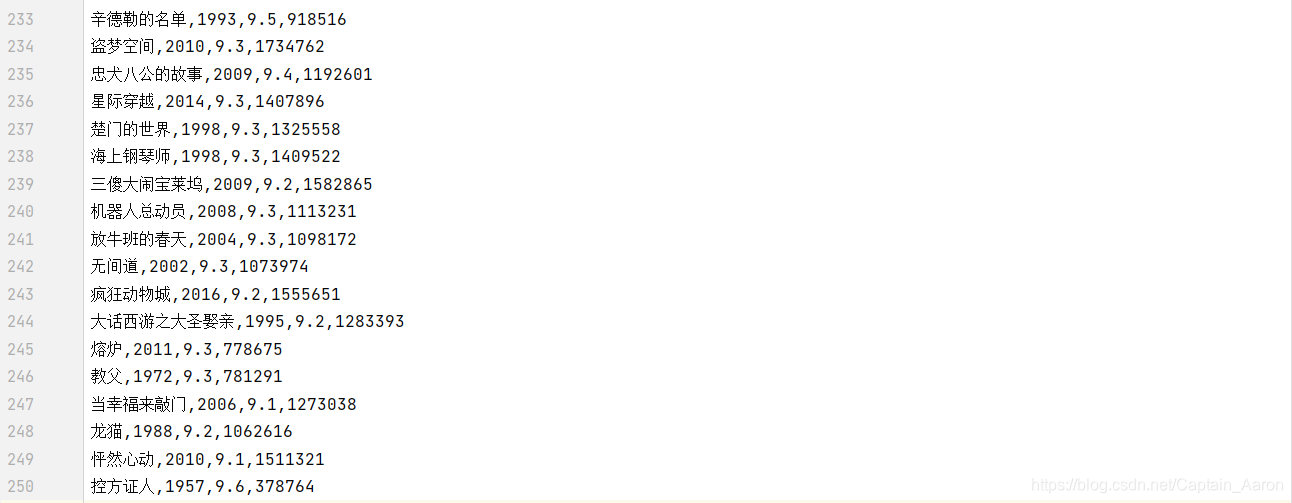
运行结果:

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 2
 0
- 0


 已为社区贡献1条内容

所有评论(0)