python爬虫基础(一)~爬虫概念和架构
目录
1. 爬虫
1.1 概念
参考:百度百科~爬虫
网络爬虫(又称为网页蜘蛛,网络机器人,在FOAF社区中间,更经常的称为网页追逐者),是一种按照一定的规则,自动地抓取html网页信息的程序或者脚本。另外一些不常使用的名字还有蚂蚁、自动索引、模拟程序或者蠕虫。
1.2 分类
- 通用网络爬虫。又称全网爬虫(Scalable Web Crawler),爬行对象从一些种子 URL 扩充到整个 Web,主要为门户站点搜索引擎和大型 Web 服务提供商采集数据。 商业应用,很少个人使用。
- 聚焦网络爬虫(Focused Crawler)。又称主题网络爬虫(Topical Crawler),是指选择性地爬行那些与预先定义好的主题相关页面的网络爬虫。我们通常意义上说的爬虫,给定词或者url,爬取想要的网页内容。--我认为是个人初级爬虫
- 增量式网络爬虫(Incremental Web Crawler)。是指对已下载网页采取增量式更新和只爬行新产生的或者已经发生变化网页的爬虫,它能够在一定程度上保证所爬行的页面是尽可能新的页面。针对特定网页,及时发现、爬取更新信息, 并可以发送邮件通知用户。---我认为是个人中级爬虫
- Deep Web 爬虫Web 页面按存在方式可以分为表层网页(Surface Web)和深层网页(Deep Web,也称 Invisible Web Pages 或 Hidden Web)。 表层网页是指传统搜索引擎可以索引的页面,以超链接可以到达的静态网页为主构成的 Web 页面。Deep Web 是那些大部分内容不能通过静态链接获取的、隐藏在搜索表单后的,只有用户提交一些关键词才能获得的 Web 页面。例如那些用户注册后内容才可见的网页就属于 Deep Web。 2000 年 Bright Planet 指出:Deep Web 中可访问信息容量是 Surface Web 的几百倍,是互联网上最大、发展最快的新型信息资源。
2. 爬虫架构
用python3!python3!python3!python2已经过时了
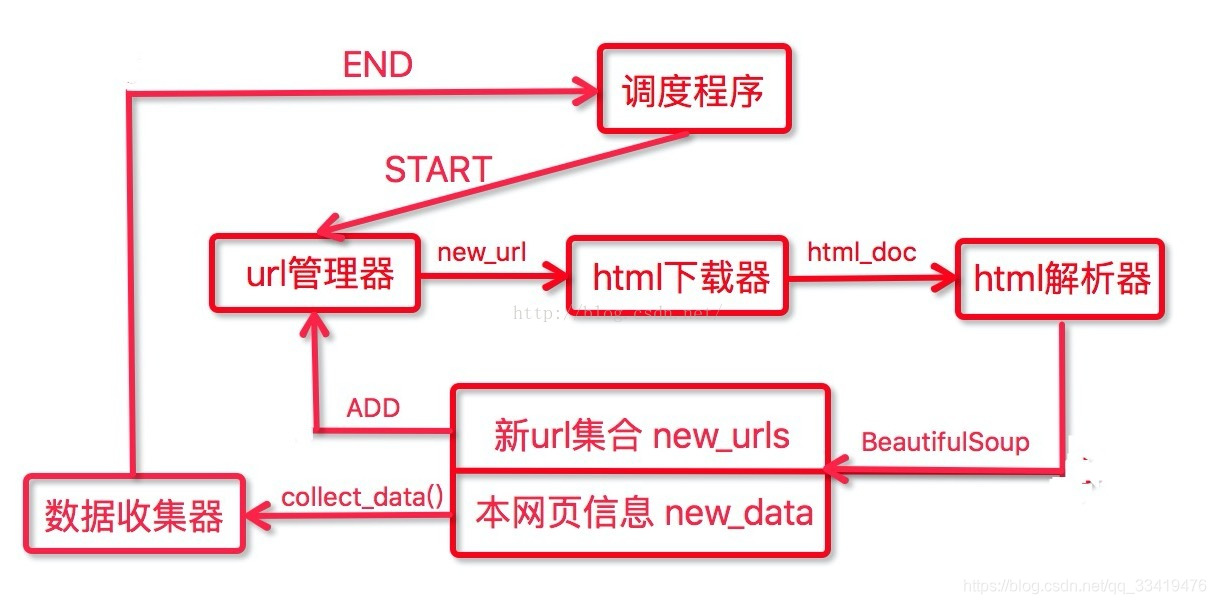
2.1 url管理器
管理将要爬取的url和已经爬取的url,将待爬取的url传送给网页下载器。
2.2 网页(html)下载(download)器
将url指定的网页下载下来,保存为一个json字符串,然后将这个字符串传送给html解析器解析。
download packages:requests, urllib
html download包含三个核心部分:
- 构造url请求对象
- 发送url请求,获取响应
- 读取/下载html全部网页内容
2.2.1 urllib下载html源码
    # 访问、下载html网页
    url = 'https://baike.baidu.com/item/' + urllib.parse.quote(content)      # 请求地址
    # 请求头部,伪造浏览器,防止爬虫被反
    headers = {
        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/67.0.3396.99 Safari/537.36'
    }
    # 利用请求地址和请求头部构造请求对象
    req = urllib.request.Request(url=url, headers=headers, method='GET')
    response = urllib.request.urlopen(req)      # 发送请求,获得响应
    text = response.read().decode('utf-8')      # 读取响应,获得文本
urllib.parse.quote(content) <--因为url只允许一部分ascii字符,其他字符(如汉子)是不符合标准的,此时就要进行编码。
urllib.request.Request --> urlopen()方法可以实现最基本构造HTTP请求的方法,但如果加入headers等信息,就可以利用Request类来构造请求。
2.2.2 requests下载html源码
#coding=utf-8
import requests
from bs4 import BeautifulSoup

resp=requests.get('https://www.baidu.com') #请求百度首页
print(resp) #打印请求结果的状态码
print(resp.content) #打印请求到的网页源码

bsobj=BeautifulSoup(resp.content,'lxml') #将网页源码构造成BeautifulSoup对象,方便操作
a_list=bsobj.find_all('a') #获取网页中的所有a标签对象
text='' # 创建一个空字符串
for a in a_list:
    href=a.get('href') #获取a标签对象的href属性,即这个对象指向的链接地址
    text+=href+'\n' #加入到字符串中,并换行
with open('url.txt','w') as f: #在当前路径下,以写的方式打开一个名为'url.txt',如果不存在则创建
f.write(text) #将text里的数据写入到文本中-->注意:百度爬取的html有静态页面和动态页面。静态简单,比如百度百科;动态困难,比如淘女郎,参考:python爬虫入门教程(三):淘女郎爬虫 ( 接口解析 | 图片下载 )-CSDN博客
2.3 网页(html)解析(parser)器
一方面,html parser会解析出有价值的数据;另一方面,解析出字符串中的url,将其补充到url管理器。这三个模块形成了一个循环,只要有未爬取的url,这个循环就会一直继续下去。
parser packages: bs4, lxml, xpath。正则表达式用于提取解析器提取不到的数据!!!
html parser包含三个核心内容:
- 解析html内容
- 抽取特定标签,返回一个标签列表
- 获取标签文本/属性值
2.3.1 BeautifulSoup解析包
将网页源码解析成BeautifulSoup对象,方便操作
抽取标签方法:find()方法、find_all()方法、select()方法
获取标签文本、属性值方法:text()方法、get_text()方法、get()方法
具体方法介绍,看我的第二篇博客:python爬虫基础(二)~工具包: 下载包requests、urllib和解析包BeautifulSoup(bs4)、xpath,python爬虫基础(二)~工具包: 下载包requests、urllib和解析包BeautifulSoup(bs4)、lxml.etree.xpath_etree与beautifulsoup-CSDN博客
   # 爬取图片
    # 找到所有img标签,返回一个url的标签列表
    img_urllist = []
    resp = requests.get(url=url, headers=headers)
    content = resp.content
    soup = BeautifulSoup(content, 'lxml')
    # img_list = soup.select('div .album-wrap')
    img_list = soup.select('a>div>img')
    print(img_list)
    for img in img_list:
        try:
            # src = img.find('img').get('src')
            src = img.get('src')
            if re.match(r'https:(.*)image(.*)auto$', src):
                img_urllist.append(src)
        except:
            continue
2.3.2 xpath解析包
def query(content):
    # 请求地址
    url = 'https://baike.baidu.com/item/' + urllib.parse.quote(content)
    # 请求头部
    headers = {
        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/67.0.3396.99 Safari/537.36'
    }
    # 利用请求地址和请求头部构造请求对象
    req = urllib.request.Request(url=url, headers=headers, method='GET')
    # 发送请求,获得响应
    response = urllib.request.urlopen(req)
    # 读取响应,获得文本
    text = response.read().decode('utf-8')
    # 构造 _Element 对象
    html = etree.HTML(text)
    # 使用 xpath 匹配数据,得到匹配字符串列表
    sen_list = html.xpath('//div[contains(@class,"lemma-summary")]//text()')
    print(sen_list)
    # 过滤数据,去掉空白
    sen_list_after_filter = [item.strip('\n') for item in sen_list if item != '\n']
    # 将字符串列表连成字符串并返回
    return ''.join(sen_list_after_filter)
2.4 数据存储器
2.4.1 保存文本
- 写入--"w"; 追加--"a"
source:菜鸟教程,Python open() 函数 | 菜鸟教程
| 模式 | 描述 |
|---|---|
| t | 文本模式 (默认)。 |
| x | 写模式,新建一个文件,如果该文件已存在则会报错。 |
| b | 二进制模式。 |
| + | 打开一个文件进行更新(可读可写)。 |
| U | 通用换行模式(不推荐)。 |
| r | 以只读方式打开文件。文件的指针将会放在文件的开头。这是默认模式。 |
| rb | 以二进制格式打开一个文件用于只读。文件指针将会放在文件的开头。这是默认模式。一般用于非文本文件如图片等。 |
| r+ | 打开一个文件用于读写。文件指针将会放在文件的开头。 |
| rb+ | 以二进制格式打开一个文件用于读写。文件指针将会放在文件的开头。一般用于非文本文件如图片等。 |
| w | 打开一个文件只用于写入。如果该文件已存在则打开文件,并从开头开始编辑,即原有内容会被删除。如果该文件不存在,创建新文件。 |
| wb | 以二进制格式打开一个文件只用于写入。如果该文件已存在则打开文件,并从开头开始编辑,即原有内容会被删除。如果该文件不存在,创建新文件。一般用于非文本文件如图片等。 |
| w+ | 打开一个文件用于读写。如果该文件已存在则打开文件,并从开头开始编辑,即原有内容会被删除。如果该文件不存在,创建新文件。 |
| wb+ | 以二进制格式打开一个文件用于读写。如果该文件已存在则打开文件,并从开头开始编辑,即原有内容会被删除。如果该文件不存在,创建新文件。一般用于非文本文件如图片等。 |
| a | 打开一个文件用于追加。如果该文件已存在,文件指针将会放在文件的结尾。也就是说,新的内容将会被写入到已有内容之后。如果该文件不存在,创建新文件进行写入。 |
| ab | 以二进制格式打开一个文件用于追加。如果该文件已存在,文件指针将会放在文件的结尾。也就是说,新的内容将会被写入到已有内容之后。如果该文件不存在,创建新文件进行写入。 |
| a+ | 打开一个文件用于读写。如果该文件已存在,文件指针将会放在文件的结尾。文件打开时会是追加模式。如果该文件不存在,创建新文件用于读写。 |
| ab+ | 以二进制格式打开一个文件用于追加。如果该文件已存在,文件指针将会放在文件的结尾。如果该文件不存在,创建新文件用于读写。 |
with open('url.txt','w') as f: #在当前路径下,以写的方式打开一个名为'url.txt',如果不存在则创建
    f.write(text) #将text里的数据写入到文本中
2.4.2 保存图片
需要用二进制, 'wb'
with open(file_path, 'wb') as f:
    f.write(soup.content)
2.4.3 保存表格table数据
- 工信部表格数据保存方法,source:python + pandas爬取网页表格数据_工标网爬虫-CSDN博客
# 先请求页面,xpath定位表格区域
res = requests.get('http://www.csres.com/notice/50655.html')
res_elements = etree.HTML(res.text)
table = res_elements.xpath('//table[@id="table1"]')
table = etree.tostring(table[0], encoding='utf-8').decode()

# 调用pandas的read_html方法解析表格数据
df = pd.read_html(table, encoding='utf-8', header=0)[0]
results = list(df.T.to_dict().values())  # 转换成列表嵌套字典的格式

转存为csv文件
df.to_csv("std.csv", index=False)
- 百度百科表格数据保存
temp2.4.4 将数据重复写入已存在的excel文件
 # 保存信息框数据到excel
    if not os.path.exists('profile'):
        os.mkdir('profile')

    profile_file = project_path + '/profile/' + 'profile.csv'
    field_list = ['中文名', '外文名', '别名', '性别', '学位', '职称', '国籍', '民族', '出生地', '籍贯', '出生日期', '逝世日期',
                  '星座', '血型', '身高','体重', '毕业院校', '职业', '经纪公司', '代表作品', '主要成就', '生肖', '语种', '特长', '粉丝名']
    if not os.path.exists(profile_file):
        workbook = xlwt.Workbook(encoding='utf-8')
        output_sheet = workbook.add_sheet('profile_sheet', cell_overwrite_ok=True)
        for i in range(len(field_list)):
            output_sheet.write(0, i, field_list[i])
        workbook.save(profile_file)

    rb = xlrd.open_workbook(profile_file)
    rows_num = rb.sheet_by_name('profile_sheet').nrows
    # print(rows_num)
    wb = copy(rb)
    output_sheet = wb.get_sheet(0)
    # print(profile)
    for i in range(len(field_list)):
        if profile_dict.get(field_list[i]):
            output_sheet.write(rows_num, i, profile_dict.get(field_list[i]))
        else:
            continue
    os.remove(profile_file)
    wb.save(profile_file)
3. 爬虫难点要点
3.1 设置headers
- 伪造火狐浏览器的headers
    # 请求头部,伪造浏览器,防止爬虫被反
    headers = {
        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/67.0.3396.99 Safari/537.36'
}- 自己设置headers
# 创建一个session
    session = requests.Session()
    # 设置用于访问的请求头
    headers = {
        'accept': 'application/json, text/javascript, */*; q=0.01',
        'accept-encoding': 'gzip, deflate, br',
        'accept-language': 'zh-CN,zh;q=0.9',
        'content-type': 'application/x-www-form-urlencoded; charset=UTF-8',
        'origin': 'https://mm.taobao.com',
        'referer': 'https://mm.taobao.com/search_tstar_model.htm',
        'user-agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/66.0.3359.139 Safari/537.36',
        'x-requested-with': 'XMLHttpRequest',
    }
session是requests库中的一个类,创建session对象进行访问的好处是,session对象能够自动维护访问的cookies信息(通过js修改的cookies信息它是记录不到的)
--> 为啥要记录cookies信息:因为有些站点的服务器会验证你的cookies信息,当cookies信息不正确时,服务器会拒绝你的访问。
--> 设置headers和data的目的:是为了将本次请求伪装成浏览器的请求,并通过传递的数据控制服务器返回我们需要的信息。
————————————————
版权声明:本文为CSDN博主「笔墨留年」的原创文章,遵循CC 4.0 BY-SA版权协议,转载请附上原文出处链接及本声明。
原文链接:https://blog.csdn.net/aaronjny/article/details/80291997
3.2 字符编解码知识
现在html网页基本都采用utf-8编码,在爬虫爬取网页时不必过多关注网页的编解码。
以前,request返回的消息编码为gb2312,我们需要先进行解码decode('utf-8'),才不会出现乱码。比如:淘女郎case,因为主页源码为gbk编码,所以需要先用gbk对其解码。
唯一一个例外时urllib发送url请求获取网页源码时,需要先解码decode('utf-8'),再进行网页解析,不然会出现乱码。
3.3 爬取动态页面
source: 淘女郎case
problem: 爬取的内容是从源码取得的,但是在页面中看到了内容,在源码里面却没有,why?
analysis: 这就是动态页面抓取。当我们访问这个网址的时候,浏览器返回给我们的只有一部分信息。 ==> "数据加载中" 实际上,服务器先给我们返回了这个页面,然后又通过ajax技术,请求了另外一个借口。接口返回了淘女郎们的信息,随后浏览器运行javascript代码,将这些信息填充到先前额页面中。因此,我们才在页面中看到了淘女郎们的信息。
(源码页面 -> 检查 -> 网络 -> 内容信息)
3.4 爬虫爬取的图片损坏、无法打开
--> attention:需要用二进制binary格式保存图片,即'wb'
problem:pycharm imge not loaded try to open it enternally to fix format problem
analysis:原因是不能用bref图片网址保存图片,需要用src图片网址保存图片
by the way:我送你解析图片标签过程中,过滤无效img图片的正则表达式
    # img_list = soup.select('div .album-wrap')
    img_list = soup.select('a>div>img')
    # print(img_list)
    for img in img_list:
        try:
            # src = img.find('img').get('src')
            src = img.get('src')
            if re.match(r'https:(.*)image(.*)auto$', src):
                img_urllist.append(src)
        except:
continue至于为啥用soup.select()而不是soup.find_all()? 我个人认为,select()方法兼容方法更多,更关键的是,它支持提取子标签匹配规则,即:'a>div>img'。
by the way: 提取标签中子标签的属性值
src = img.find('img').get('src')3.5 异常处理
- SSL: CERTIFICATE_VERIFY_FAILED。因为当使用urllib.urlopen打开一个 https 链接时,会验证一次 SSL 证书。
import ssl
ssl._create_default_https_context = ssl._create_unverified_context- 怎么去除抓取数据中的'\xa0\xa0\xa0\xa乱码 --> ''.join(str.split())方法,但是这种方法会删除原有文本中的空格
>>> s ='1室1厅1卫                    \xa0\xa0\xa0\xa038㎡'
>>> "" .join(s. split())
'1室1厅1卫38㎡'- 如何删除爬取的html网页内容中的NBSP-乱码空格,string.replace(u'\xa0', u' ')
# 删除爬取到html内容中的nbsp:str.replace(u'\xa0', u' ')
row_content = re.sub('\n', '', row_content.replace(u'\xa0', u' '))
br_text_list.append(row_content + '\n')
3.6 如何获取两个不同之间的所有文本
BeautifulSoup_object的previous_sibling、previous_siblings 和 next_sibling、next_siblings方法,可以获取同级标签文本,即兄弟节点的文本。
source:Python html中一级元素.next_sibling打印为空_beautifulsoup兄弟节点打印空白-CSDN博客;Beatifulsoup4 兄弟节点 next_sibling和next_sibling()_bs4 select兄弟节点-CSDN博客
sibling_soup = BeautifulSoup(sibling_html, 'html.parser')
br = sibling_soup.p
while br.next_sibling != None:
    print br
    br = br.next_sibling
---------------------------------------------------------------
for tag in soup.select('div .col-md-4'):
    if tag.get_text() == 'Total':
        result = tag.next_sibling.get_text()
--> 判断each br in 返回的标签兄弟节点列表 是否是标签,因为有些兄弟节点为空。
            for br in i.next_siblings:  # 获取人物履历标签后面所有的兄弟标签
            # print(br)
            if type(br) is bs4.element.Tag:  # 判断br是不是一个标签
                attrs = ''.join(br.attrs['class'])
                if attrs == 'para':
                    br_text_list.append(br.get_text())
                elif attrs == re.compile('para-title level'):
                    break
            else:
continuesource:http://www.voidcn.com/article/p-eqwgopwx-bvx.html
from bs4 import BeautifulSoup

soup = BeautifulSoup("""
    <html><div class="lead">lead</div>data<div class="end"></div></html>"
    """, "lxml")

node = soup.find('div', {'class': 'lead'})
s = []
while True:
    if node is None:
        break
    node = node.next_sibling
    if hasattr(node, "attrs") and ("end" in node.attrs['class'] ):
        break
    else:
        if node is not None:
            s.append(node)
print s
参考
[1] 爬虫实战(一) 用Python爬取百度百科, https://www.cnblogs.com/wsmrzx/p/10531708.html
[2] python爬虫入门教程(二):开始一个简单的爬虫, python爬虫入门教程(二):开始一个简单的爬虫_python 爬虫-CSDN博客

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 3
 0
- 0


 已为社区贡献4条内容

所有评论(0)