机器学习之最小二乘法
欢迎关注笔者的微信公众号

最小二乘法(又称最小平方法)是一种数学优化技术。它通过最小化误差的平方和寻找数据的最佳函数匹配。利用最小二乘法可以简便地求得未知的数据,并使得这些求得的数据与实际数据之间误差的平方和为最小。
当我们需要设计一个线性函数(y=ax+b 或 Ax+Bx+C=0y=ax+b \ 或 \ Ax+Bx+C=0y=ax+b 或 Ax+Bx+C=0)去拟合一些呈线性关系的数据点时,我们如何评价我们设计的拟合函数的拟合效果呢?换言之,我们如何评价我们设计的拟合函数与实际值的差距、损失?
一个直接的思路是计算所有实际点到拟合函数的距离的和:L=∑∣Ax0+By0+C∣A2+B2L = \sum \frac{|Ax_0+By_0+C|}{\sqrt{A^2+B^2}}L=∑A2+B2∣Ax0+By0+C∣
显然,这种计算方式有除法,开根号,开方,非常的复杂,耗时,不可取。
损失计算函数应当尽量简单且能直观反映损失。
通常使用如下函数来评价损失 L(a,b)=∑i=1N(yi−f(xi))2L(a,b) = \sum_{i=1}^{N} (y_i-f(x_i))^2L(a,b)=∑i=1N(yi−f(xi))2
yiy_iyi是实际值,f(xi)f(x_i)f(xi)是拟合函数预测值。通过计算两者的差值的平方(取绝对值会更复杂)来评判单个点的拟合损失,对所有结果求和来评判整体的拟合效果
L(a,b)L(a, b)L(a,b)是一个二元函数,我们的目标就是求L(a,b)L(a, b)L(a,b)的最小值,即minL(a,b)\min L(a, b)minL(a,b)时a,ba,ba,b的取值,这时也是拟合效果最好的。
要求LLL的最小值,问题就转化为求LLL的偏导数(神经网络中称为梯度)
{∂L∂a=0∂L∂b=0
\left\{ \begin{gathered}
\frac{\partial L}{\partial a} = 0 \\
\frac{\partial L}{\partial b} = 0
\end{gathered} \right.
⎩⎪⎪⎨⎪⎪⎧∂a∂L=0∂b∂L=0
用数学语言表示直线:参数化 y=ax+by = ax+by=ax+b 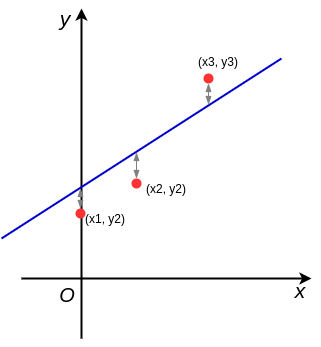
指定标准:建立评价函数 L(a,b)L(a, b)L(a,b)
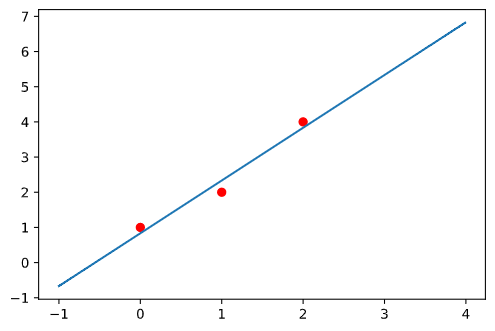
已知数据点(0, 1), (1, 2), (2, 4),求线性函数f(x)=ax+bf(x)=ax+bf(x)=ax+b
Step1: 构造评价函数
L(a,b)=∑i=1N(yi−f(xi))2 L(a,b)=(1−b)2+(2−(a+b))2+(4−(2a+b))2
L(a, b) = \sum_{i=1}^N (y_i - f(x_i))^2 \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ \ L(a, b) = (1-b)^2+(2-(a+b))^2+(4-(2a+b))^2
L(a,b)=i=1∑N(yi−f(xi))2 L(a,b)=(1−b)2+(2−(a+b))2+(4−(2a+b))2
Step2: 分别对于a和b合并同类项,整理成二次函数形式
g1(a)=(1−b)2+(2−(a+b))2+(4−(2a+b))2g2(b)=3b2+(6a−14)b+(5a2−20a+21)
g_1(a) = (1-b)^2 + (2-(a+b))^2 + (4 - (2a+b))^2 \\
g_2(b) = 3b^2 + (6a-14)b + (5a^2 -20a + 21)
g1(a)=(1−b)2+(2−(a+b))2+(4−(2a+b))2g2(b)=3b2+(6a−14)b+(5a2−20a+21)
Step3: 求二次方法构造二元一次方程组求出a、b
{a=−6b−2010b=−6a−146 ⟹ {a=32b=56
\left\{ \begin{gathered}
a = -\frac{6b-20}{10} \\
b = -\frac{6a-14}{6}
\end{gathered} \right.
\implies
\left\{ \begin{gathered}
a = \frac{3}{2} \\
b = \frac{5}{6} \end{gathered} \right.
⎩⎪⎪⎨⎪⎪⎧a=−106b−20b=−66a−14⟹⎩⎪⎨⎪⎧a=23b=65
最小二乘法的几何意义
SSS是n维欧式空间的点集,a⃗是x\vec a是xa是x处的观测值,b⃗\vec bb是对应的拟合值
S={Pi(xi,yi)}a⃗=(y1,y2,y3,...,yn)∈Rb⃗=(f(xi),f(x2),f(x3),...,f(xn))∈R拟合⇔∣a⃗−b⃗∣2=(y1−f(x1))2+(y2−f(x2))2+(y3−f(x3))2+...+(yn−f(xn))2=L
S= \{P_i(x_i, y_i)\}
\vec a = (y_1, y_2, y_3, ..., y_n) \in \mathbb{R} \\
\vec b = (f(x_i), f(x_2), f(x_3), ..., f(x_n)) \in \mathbb{R} \\
拟合\Leftrightarrow | \vec a - \vec b |^2 = (y_1-f(x_1))^2 + (y_2-f(x_2))^2 + (y_3-f(x_3))^2 + ... + (y_n-f(x_n))^2 = L
S={Pi(xi,yi)}a=(y1,y2,y3,...,yn)∈Rb=(f(xi),f(x2),f(x3),...,f(xn))∈R拟合⇔∣a−b∣2=(y1−f(x1))2+(y2−f(x2))2+(y3−f(x3))2+...+(yn−f(xn))2=L
最小二乘法的几何意义就是去寻找n维空间上点的最小距离,让这两个点的距离尽可能的小。距离越小,拟合的效果就越好。
最小二乘法的非线性拟合
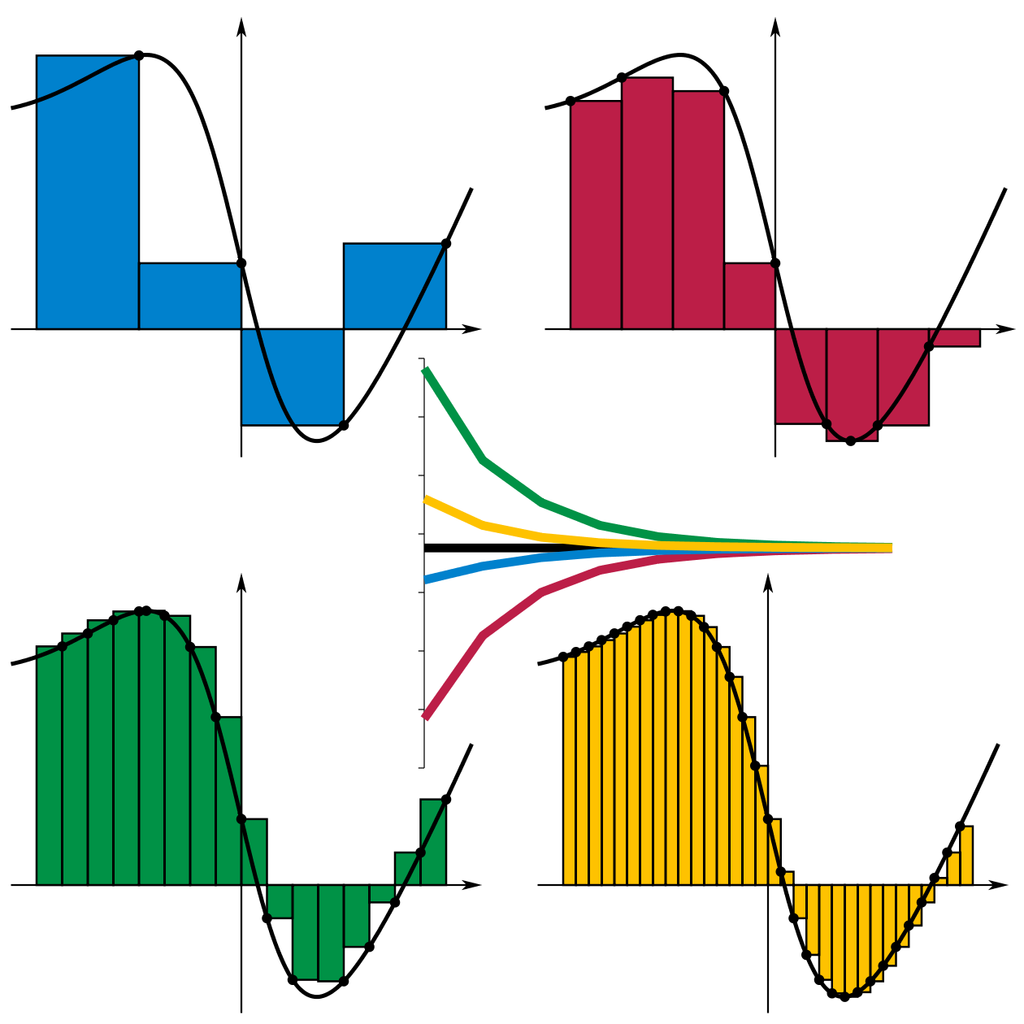
最小二乘法的一个本质难点就是函数型的选取。对于非线性函数, 我们可以将它划分成非常小的一段,这一段可以用线性函数来拟合。这种思想在定积分中也有应用。
在神经网络中通常使用激活函数来引入非线性因素用以拟合各种曲线。
常用的激活函数有:sigmoid,tanh,RELU,LeakReLu,SoftMaxsigmoid, tanh, RELU, LeakReLu, SoftMaxsigmoid,tanh,RELU,LeakReLu,SoftMax 等等
sigmoid: f(x)=11+e−x
sigmoid: \ \ \ \ f(x) = \frac{1}{1+e^{-x}}
sigmoid: f(x)=1+e−x1
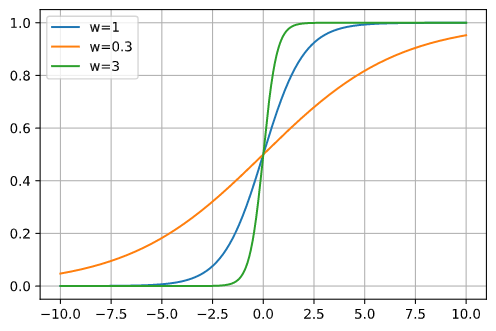
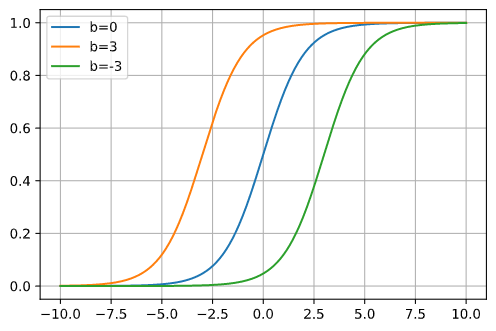
如下图所示:
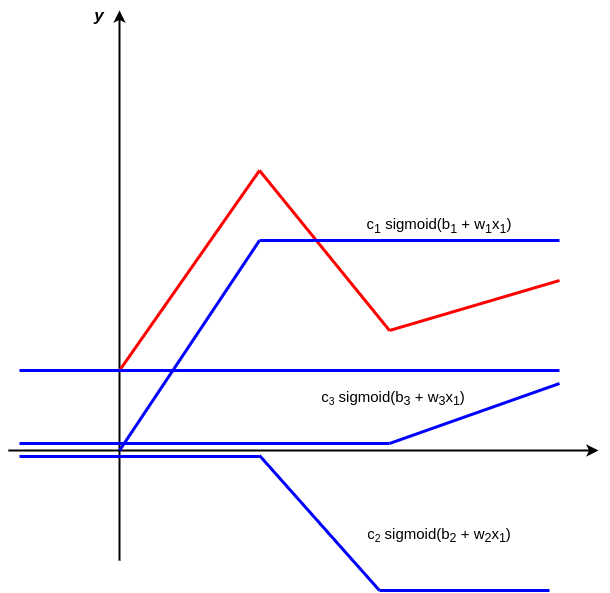
图中红色曲线可以通过其他三条蓝色曲线“组合”而成。
总结
| 优点 | 缺点 | 适用性 |
|---|---|---|
| 1. 反映综合趋势 2. 具有强几何意义 3. 具有强统计意义 | 1. 难以选取函数型 2. 对于含有指数和对数型的拟合函数难以计算参数 | 1. 适用于预测 2. 某些情况下也可以做插值 |

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 5
 0
- 0


 已为社区贡献1条内容

所有评论(0)