大数据工具——Kylin
官网:
http://kylin.apache.org/cn/
官方文档
http://kylin.apache.org/cn/docs/
下载地址
http://kylin.apache.org/cn/download/
一、Kylin简介
1.Kylin概念
Kylin是一个分布式的数据仓库平台,可以将Hive中的数据同步到Kylin中进行数据分析,也可也实现多维立方体的查询,将最终结果保存到Hbase中。
Kylin的出现就是为了解决大数据系统中TB级别数据的数据分析需求,它提供Hadoop/Spark之上的SQL查询接口及多维分析(OLAP)能力以支持超大规模数据,它能在亚秒内查询巨大的Hive表。其核心是预计算,计算结果存在HBase中。
作为大数据分析神器,它也需要站在巨人的肩膀上,依赖HDFS、MapReduce/Spark、Hive/Kafka、HBase等服务。
2.维度和度量
维度:我们看事物的角度,如果是统计维度,可以从粗粒度到细粒度(例如,时间,从年,月,天,小时,分钟,秒,毫秒,微秒,纳秒)
度量:对维度聚合的结果
3.数据立方体
其实就是维度立方体,也就是站在不同角度去看待问题,例如我们有abc,那么我们要将ABC三个值得每个角度去统计,ab,ac,bc,a,b,c,abc,这种方式的统计可以使用Kylin来实现,kylin里面最大的特点就是创建维度模型,统计维度结果。
4.技术架构
数据源:获取Hadoop/Hive的数据,同步到Kylin内部
数据分析:使用Kylin内部的立方体模型进行多维统计
存储数据:建立在Hbase数据库上面存储的。RowKey是通过多个维度拼接而成的,value就是具体值
整体流程:加载Hive数据到Kylin中,然后创建Model模块,根据Model创建立方体(Cube)模型,执行立方体模型进行分析,将分析结果存入Hbase数据库(预计算)
4.Kylin有点
Kylin的主要优势为以下几点:
- 可扩展超快OLAP引擎:Kylin是为减少在Hadoop/Spark上百亿规模数据查询延迟而设计
- Hadoop ANSI SQL 接口:Kylin为Hadoop提供标准SQL支持大部分查询功能
- 交互式查询能力:通过Kylin,用户可以与Hadoop数据进行亚秒级交互,在同样的数据集上提供比Hive更好的性能
- 多维立方体(MOLAP Cube):用户能够在Kylin里为百亿以上数据集定义数据模型并构建立方体
- 与BI工具无缝整合:Kylin提供与BI工具的整合能力,如Tableau,PowerBI/Excel,MSTR,QlikSense,Hue和SuperSet
- 其它特性:Job管理与监控;压缩与编码;增量更新;利用HBase Coprocessor;基于HyperLogLog的Dinstinc Count近似算法;友好的web界面以管理,监控和使用立方体;项目及表级别的访问控制安全;支持LDAP、SSO
二、基本操作
1.同步Hive表
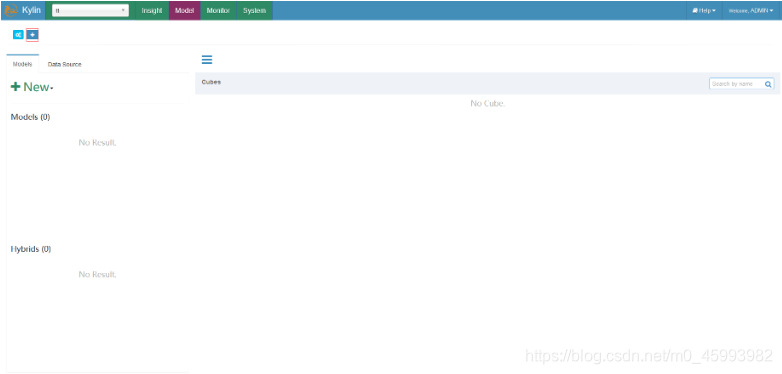
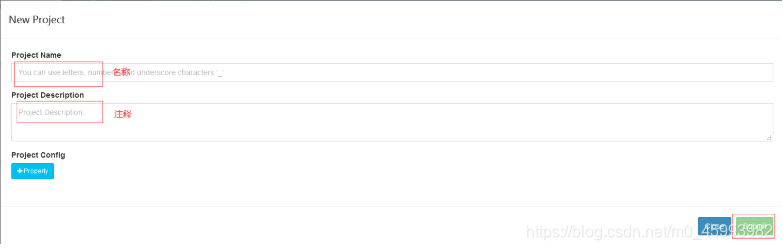
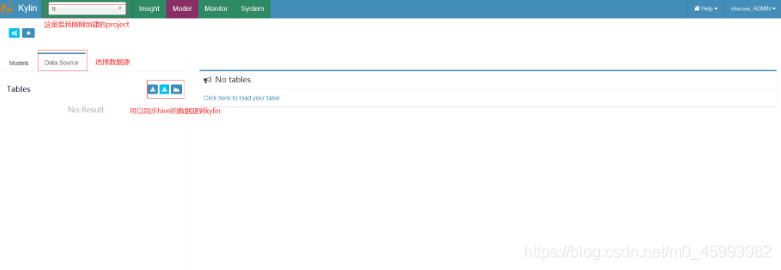
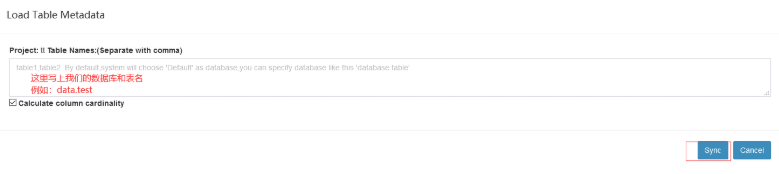
2.创建Model
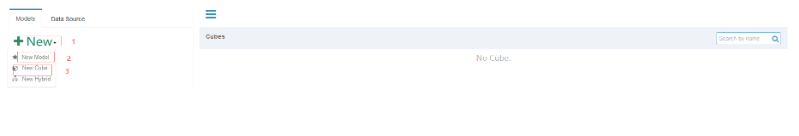
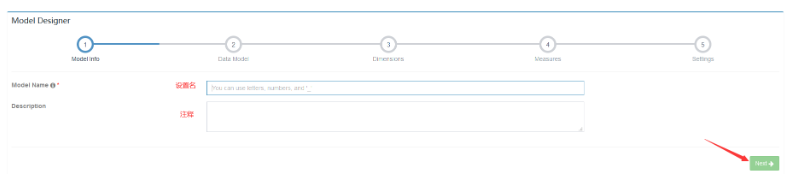
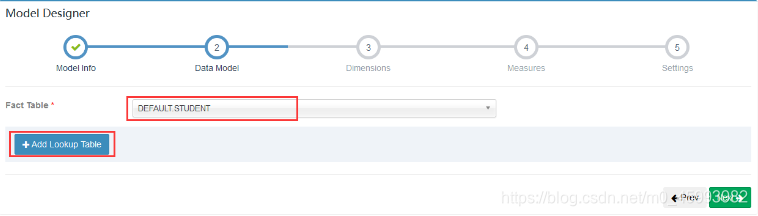
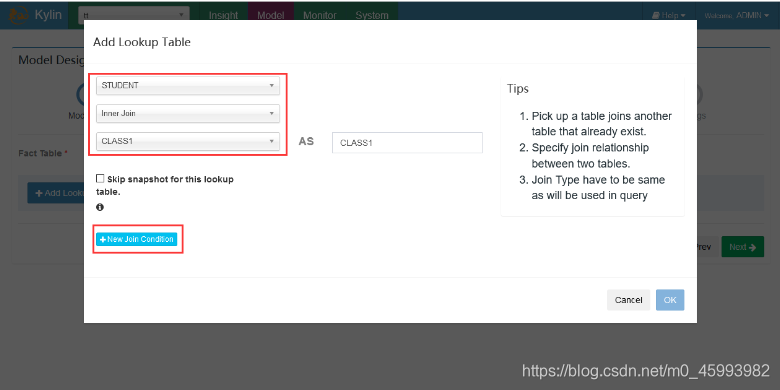
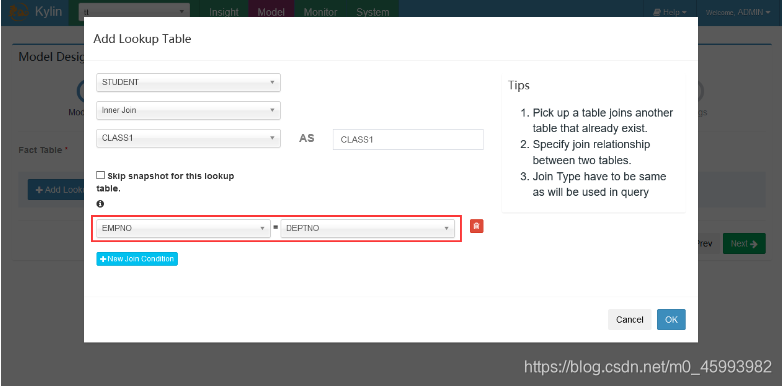
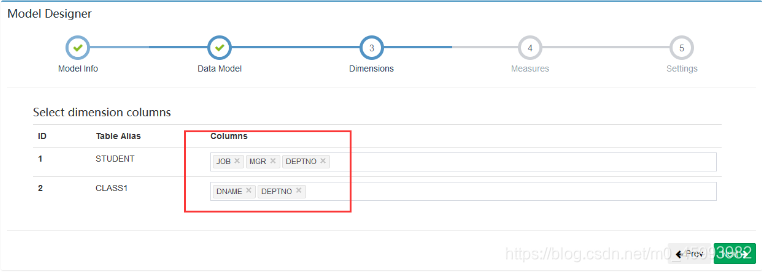
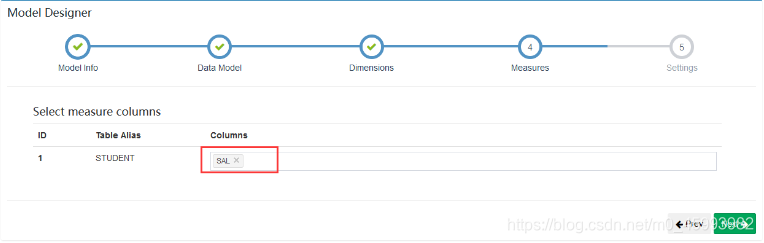
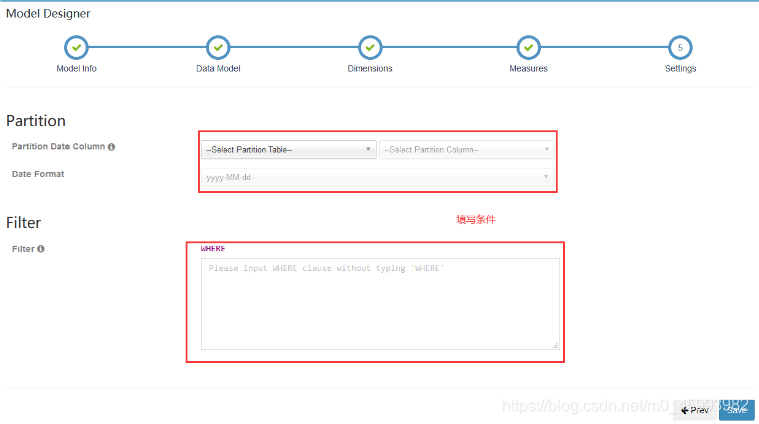
3.创建Cube
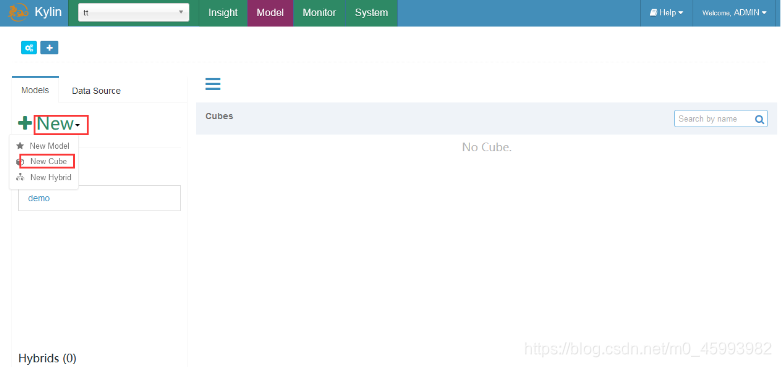
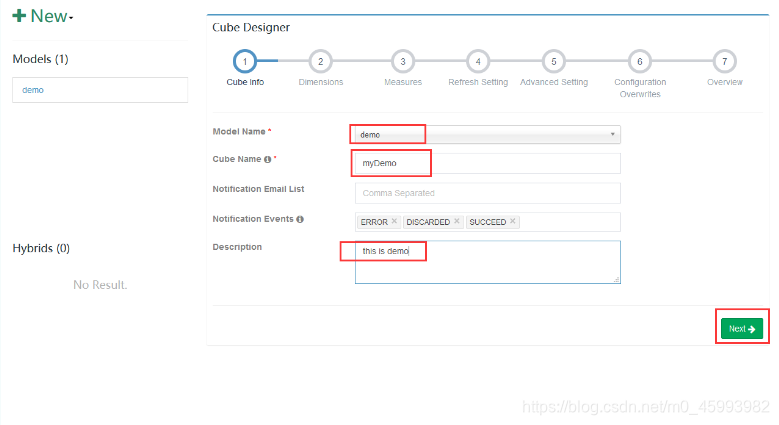
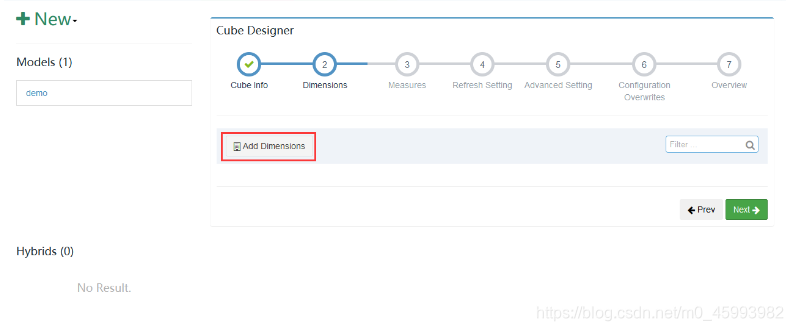
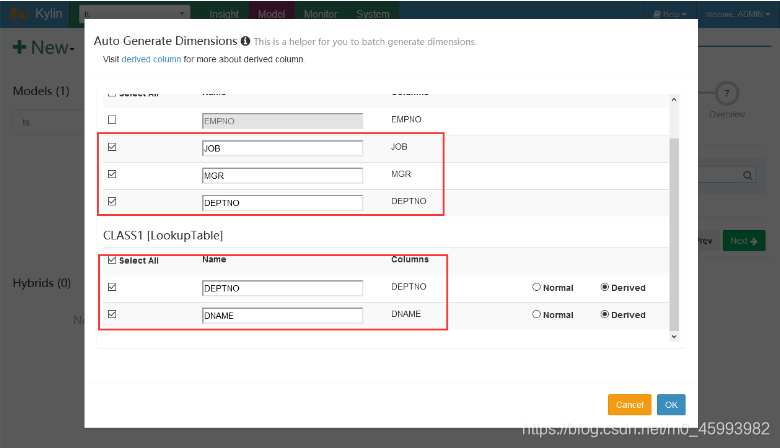
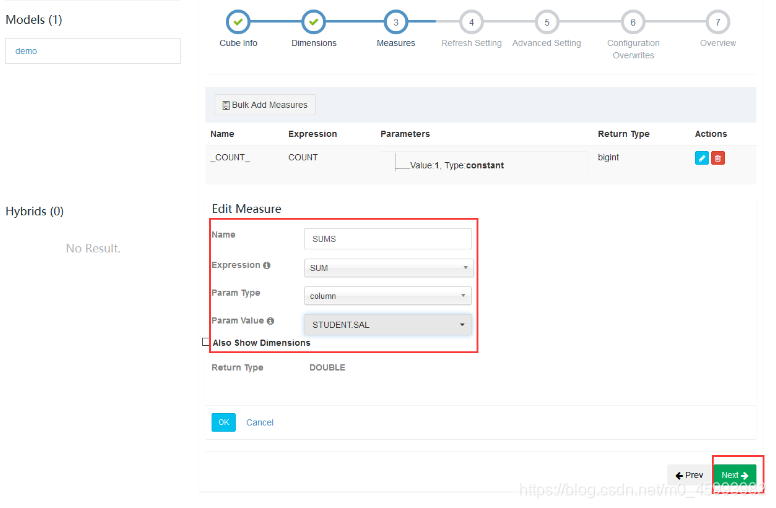
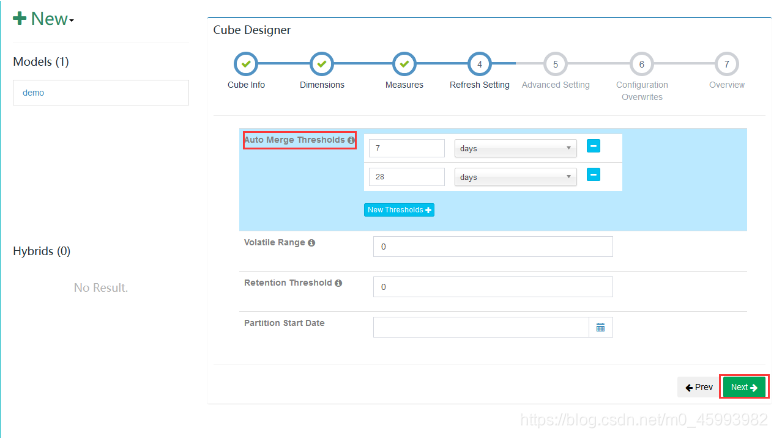
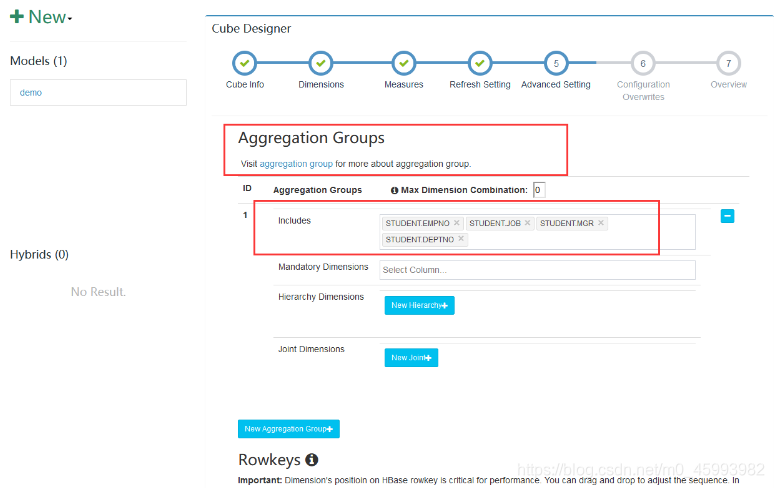
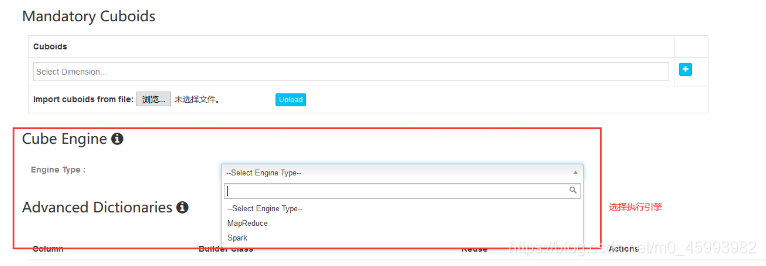
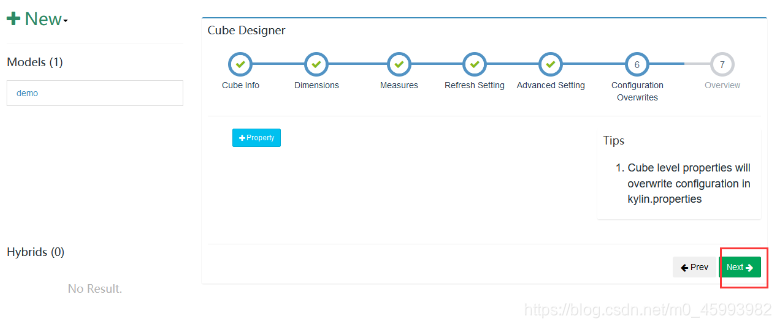
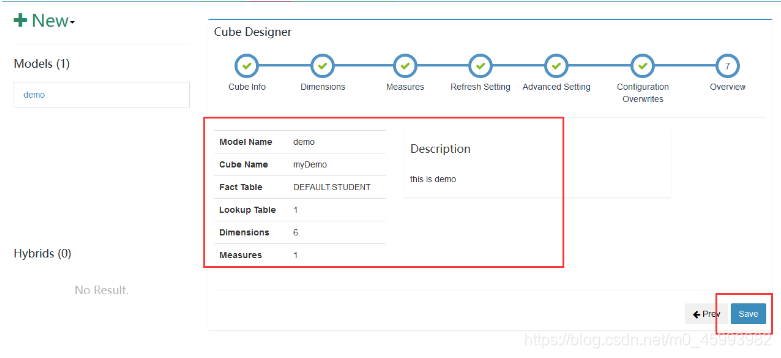
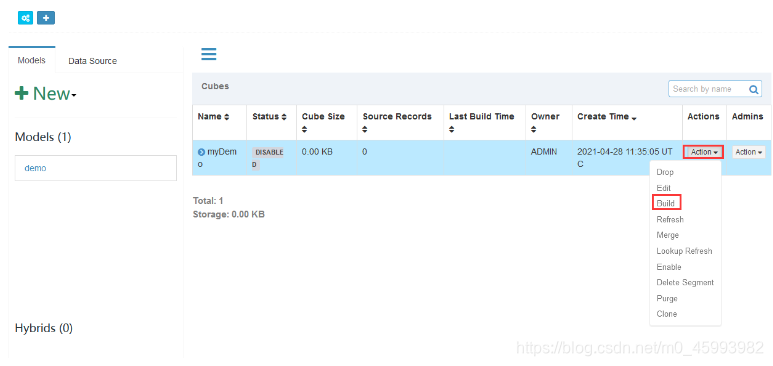
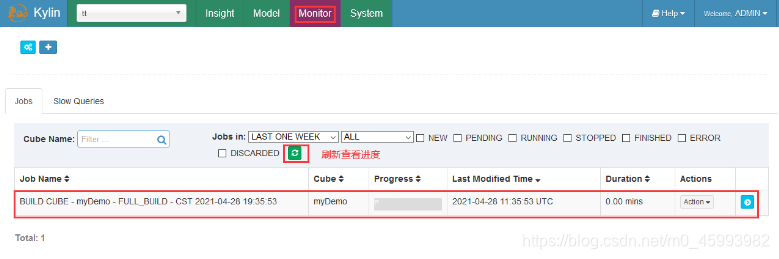
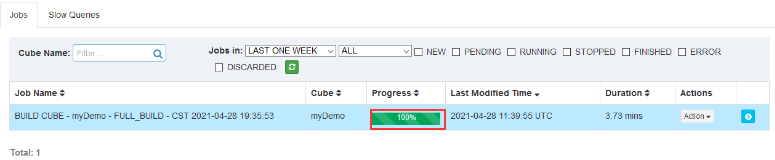
三、增量构建全量构建
1.理解Cube,Cuboid与Segment的关系
Cube:维度立方体,代表一个任务,最大最上层
Cuboid:维度立方体树,也就是它内部的维度结构,维度结构越少运行速度越快,反之越慢
Segment:代表一个块,块表示每一次执行的结果,也就可以看出一个Hbase的表
2.全量构建
Cube中只存在唯一的一个Segment。该Segment没有分割时间的概念,也就没有起始时间和结束时间
对于全量构建来说,每当需要更新Cube数据的时候,它不会区分历史数据和新加入的数据,也就是说,在构建的时候会导入并处理所有的原始数据
3.增量构建
只会导入新Segment指定的时间区间内的原始数据,并只对这部分原始数据进行预计算
4.对比
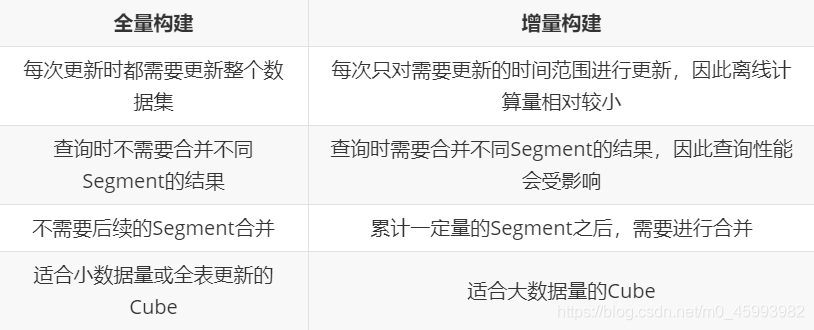
5.Cube碎片管理
增量构建的问题:
日积月累,增量构建的Cube中的Segment越来越多,该Cube的查询性能也会越来越慢,因为需要在单点的查询引擎中完成越来越多的运行时聚合。为了保持查询性能:
- 需要定期地将某些Segment合并在一起
- 或者让Cube根据Segment保留策略自动地淘汰那些不会再被查询到的陈旧Segment
管理Cube碎片:
生成一个Segment,对应就是HBase中的一张表。增量构建的Cube每天都可能会有新的增量。这样的Cube中最终可能包含上百个Segment,这将会导致Kylin性能受到严重的影响。
- 从执行引擎的角度来说,运行时的查询引擎需要聚合多个Segment的结果才能返回正确的查询结果
- 从存储引擎的角度来说,大量的Segment会带来大量的文件,给存储空间的多个模块带来巨大的压力,例如Zookeeper、HDFS Namenode等
6.Cube优化
- 使用衍生维度
即使用维度表的主键(也就是事实表的外键)来代替维度表的非主键维度,这种方式牺牲一部分运行时间性能来节省Cube的空间占用目的。 - 使用聚合组
- 强制维度(Mandatory)
若为强制维度,则该分组中每一个Cubiod都会包含这个维度,若该维度一定会出现在查询中,则应当将其设置为强制维度
设置成强制维度。这样该聚合组产生的cuboid都要有这个维度。

聚合组里有a,b,c三个维度,将a设置成强制维度,
则该聚合组会产生  a,ab,ac,abc 4种cuboid,
而不会产生b , c , bc 这三个cuboid,减少了3个。
- 层级维度(Hierachy)
每一个层级中应包含2-n个维度,这n个维度会以()、(N1)、(N1,N2)、…、(N1, N2,…,Nn)这N+1种情况进行组合
聚合组有 a b c 三个维度 且设置成层级维度 a>b>c.
则该聚合组会产生 a, ab, abc 三个cuboid
不会产生 b,c,bc,ac 这4个cuboid,减少了4个
- 联合维度(Joint)
每一个联合维度包括两个或者更多的维度,联合维度内的维度,要么不出现,要么必须一起出现。不同的联合之间不应当有共同的维度
聚合组有 a b c 三个维度,且设置 ab为联合维度,
则该聚合组会产生 c,ab,abc 三个cuboid
而不会产生 a,b ,ac,bc, 减少了4个
- 粒度优化
粒度优化对应的是提高Cube的并发度,其设置是在自定义属性中的。根据相对应的情况调高最少使用分区,降低最大使用分区,能够有效增加系统的并行度。
一共有三个属性可以提高并发度。
kylin.hbase.region.cut(共使用几个分区)
kylin.hbase.region.count.min(最少使用几个分区)
kylin.hbase.region.count.max(最多使用几个分区)
- RowKey优化
和Hbase 的RowKey优化类似
在查询的过程中,被用作过滤条件的维度可能放在其他维度的前面
经常出现的维度应该放在前面
基数比较大的维度应该放在前面

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 2
 0
- 0


 已为社区贡献5条内容

所有评论(0)