爬虫:获取OLD的Oxford 3000 and 5000
·
Oxford Learner’s Dictionaries
Oxford 3000 and 5000
一、代码
# 导入模块
from selenium import webdriver
from bs4 import BeautifulSoup
import requests
import urllib
import time
import numpy as np
import pandas as pd

# 网页地址
url = "https://www.oxfordlearnersdictionaries.com/wordlists/oxford3000-5000"

# 打开浏览器
driver = webdriver.Chrome(r"C:\Users\53224\_jupyter\chromedriver.exe")

# 打开网页
driver.get(url)  # 点击Filters > List > Oxford 5000

word_li_list = driver.find_elements_by_css_selector("ul.top-g > li")
len(word_li_list)

special_word_dic = {
    'nursing': {
        'uk_pron_url': "https://www.oxfordlearnersdictionaries.com/media/english/uk_pron/n/nur/nursi/nursing__gb_1.mp3",
        'us_pron_url': "https://www.oxfordlearnersdictionaries.com/media/english/us_pron/n/nur/nursi/nursing__us_1.mp3",
    },
}
special_word_dic.keys()

word_list = []
word_url_list = []
pos_list = []
ox3000_list = []
ox5000_list = []
uk_pron_url_list = []
us_pron_url_list = []

# word_li_list = word_li_list[3550:]

cnt = 1
for word_li in word_li_list:
    word = word_li.get_attribute('data-hw')
    word_url = word_li.find_element_by_css_selector("a").get_attribute("href")
    pos = word_li.find_element_by_css_selector("span.pos").text
    ox3000 = word_li.get_attribute('data-ox3000')
    ox5000 = word_li.get_attribute('data-ox5000')

    media_div_list = word_li.find_elements_by_css_selector("div > div")
    uk_pron_url = None
    us_pron_url = None
    if len(media_div_list) == 0:
        uk_pron_url = special_word_dic[word]['uk_pron_url']
        us_pron_url = special_word_dic[word]['us_pron_url']
    else:
        uk_pron_url = "https://www.oxfordlearnersdictionaries.com" + media_div_list[0].get_attribute("data-src-mp3")
        us_pron_url = "https://www.oxfordlearnersdictionaries.com" + media_div_list[1].get_attribute("data-src-mp3")

    print(cnt, word, word_url, pos, ox3000, ox5000)
    print(uk_pron_url)
    print(us_pron_url)

    cnt += 1

    word_list.append(word)
    word_url_list.append(word_url)
    pos_list.append(pos)
    ox3000_list.append(ox3000)
    ox5000_list.append(ox5000)
    uk_pron_url_list.append(uk_pron_url)
    us_pron_url_list.append(us_pron_url)

print(len(word_list))
print(len(word_url_list))
print(len(pos_list))
print(len(ox3000_list))
print(len(ox5000_list))
print(len(uk_pron_url_list))
print(len(us_pron_url_list))

word_data = []
for i in range(len(word_list)):
    print(i, [word_list[i], word_url_list[i], pos_list[i], ox3000_list[i], ox5000_list[i], uk_pron_url_list[i], us_pron_url_list[i]])
    word_data.append([word_list[i], word_url_list[i], pos_list[i], ox3000_list[i], ox5000_list[i], uk_pron_url_list[i], us_pron_url_list[i]])
# word_data

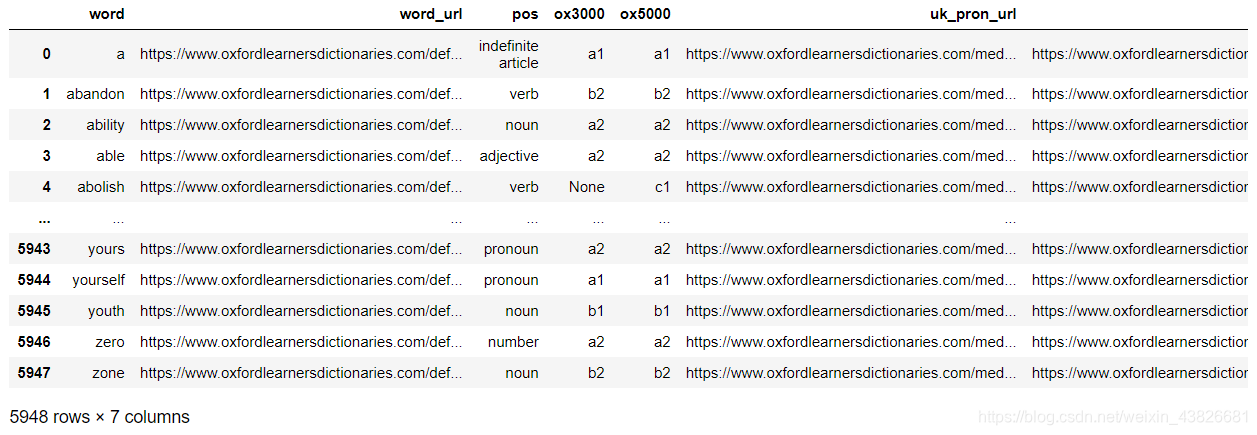
columns = ['word', 'word_url', 'pos', 'ox3000', 'ox5000', 'uk_pron_url', 'us_pron_url']
word_table = pd.DataFrame(word_data, columns=columns)
word_table

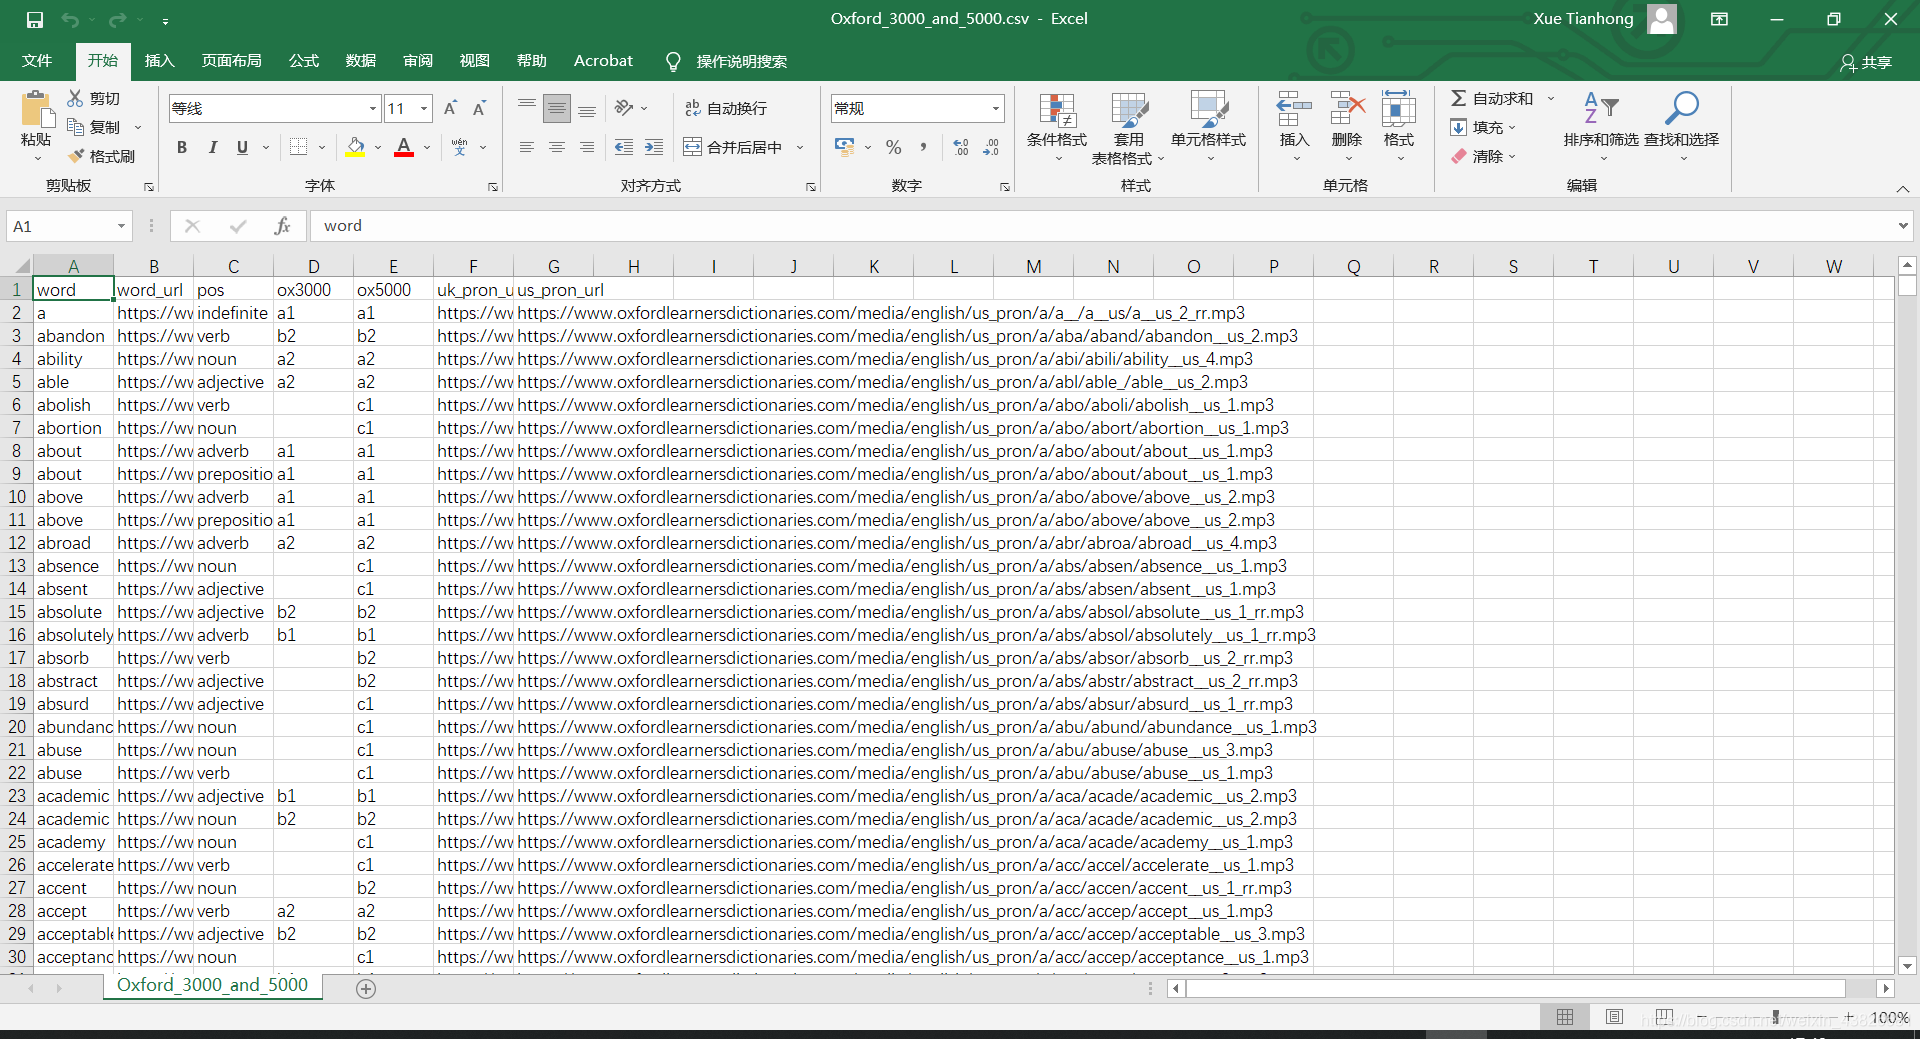
word_table.to_csv("Oxford_3000_and_5000.csv", index=False)
二、运行结果

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)