xpath爬取页面内容保存成文档_python网络爬虫学习笔记(一) 爬取简单静态网页_cos的博客-CSDN博客...
目录
一、使用urllib3实现HTTP请求
1.生成请求
2.处理请求头
3.Timeout设置
4.请求重试设置
5.生成完整HTTP请求
二、使用requests库实现HTTP请求
解决字符编码问题
三、解析网页
1.元素面板
2.源代码面板
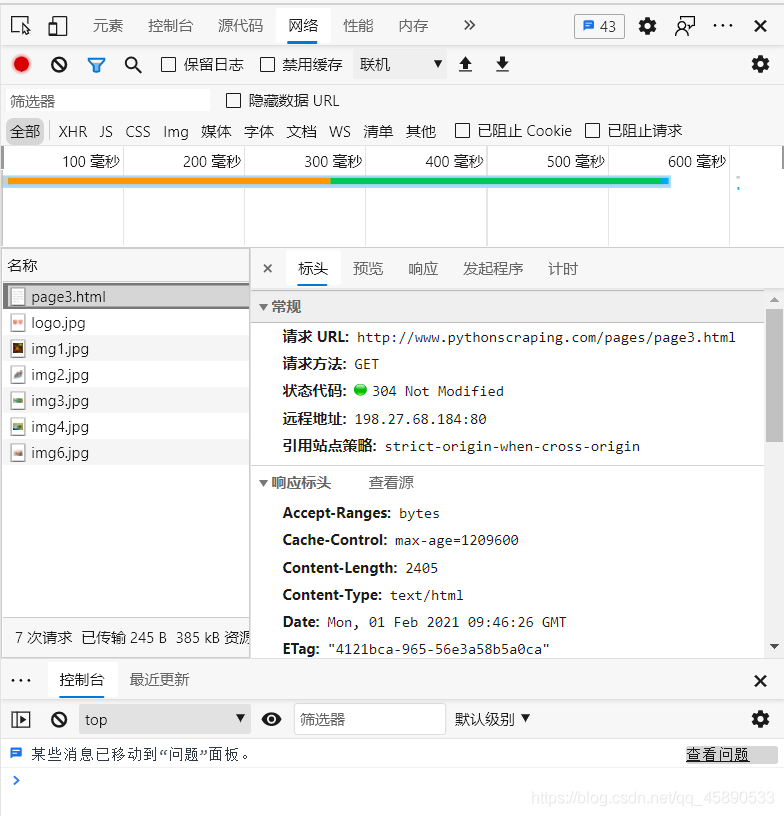
3.网络面板
四、使用正则表达式解析网页
1. Python正则表达式:寻找字符串中的姓名和电话号码
完整代码
五、使用Xpath解析网页
1.基本语法
2.谓语
3. 功能函数
4.谷歌开发者工具使用
六、数据存储
1.以json格式存储
一、使用urllib3实现HTTP请求
1.生成请求
通过request方法生成请求,原型如下
urllib3.request(method,url,fields=None,headers=None,**urlopen_kw)
参数说明method接收string。表示请求的类型,如"GET"(通常使用)、“HEAD”、"DELETE"等,无默认值
url接收string。表示字符串形式的网址。无默认值
fields接收dict。表示请求类型所带的参数。默认为None
headers接收dict。表示请求头所带参数。默认为None
**urlopen_kw:接收dict和python中的数据类型的数据,依据具体需求及请求的类型可添加的参数,通常参数赋值为字典类型或者具体数据
code:
import urllib3
http = urllib3.PoolManager()
rq = http.request('GET',url='http://www.pythonscraping.com/pages/page3.html')
print('服务器响应码:', rq.status)
print('响应实体:', rq.data)
2.处理请求头
传入headers参数可通过定义一个字典类型实现,定义一个包含User-Agent信息的字典,使用浏览器为火狐和chrome浏览器,操作系统为"Window NT 6.1;Win64; x64",向网站"http://www.tipdm/index.html"发送带headers参数的GET请求,hearders参数为定义的User-Agent字典
import urllib3
http = urllib3.PoolManager()
head = {'User-Agent':'Window NT 6.1;Win64; x64'}
http.request('GET',url='http://www.pythonscraping.com/pages/page3.html',headers=head)
3.Timeout设置
为防止因网络不稳定等原因丢包,可在请求中增加timeout参数设置,通常为浮点数,可直接在url后设置该次请求的全部参数,也可以分别设置这次请求的连接与读取timeout参数,在PoolManager实例中设置timeout参数可应用至该实例的全部请求中
直接设置
http.request('GET',url='',headers=head,timeout=3.0)
#超过3s的话超时终止
http.request('GET',url='http://www.pythonscraping.com/pages/page3.html',headers=head,timeout=urllib3.Timeout(connect=1.0,read=2.0))
#链接超过1s,读取超过2s终止
应用至该实例的全部请求中
import urllib3
http = urllib3.PoolManager(timeout=4.0)
head = {'User-Agent':'Window NT 6.1;Win64; x64'}
http.request('GET',url='http://www.pythonscraping.com/pages/page3.html',headers=head)
#超过4s超时
4.请求重试设置
urllib3库可以通过设置retries参数对重试进行控制。默认进行3次请求重试,并进行3次重定向。自定义重试次数通过赋值一个整型给retries参数实现,可通过定义retries实例来定制请求重试次数及重定向次数。若需要同时关闭请求重试及重定向则可以将retries参数赋值为False,仅关闭重定向则将redirect参数赋值为False。与Timeout设置类似,可以在PoolManager实例中设置retries参数控制全部该实例下的请求重试策略。
直接设置
在这里插入代码片
应用至该实例的全部请求中
import urllib3
http = urllib3.PoolManager(timeout=4.0,retries=10)
head = {'User-Agent':'Window NT 6.1;Win64; x64'}
http.request('GET',url='http://www.pythonscraping.com/pages/page3.html',headers=head)
#超过4s超时 重试10次
5.生成完整HTTP请求
使用urllib3库实现向http://www.pythonscraping.com/pages/page3.html生成一个完整的请求,该请求应当包含链接、请求头、超时时间和重试次数设置。

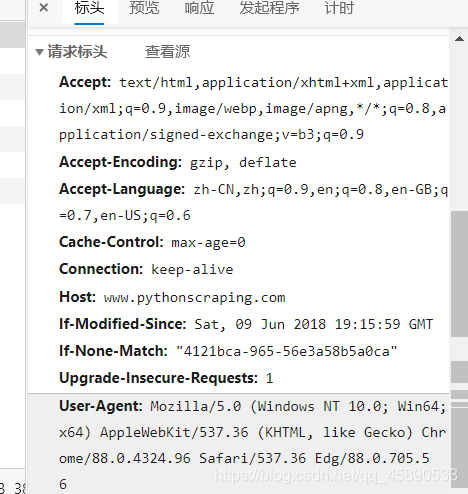
注意编码方式utf-8
import urllib3
#发送请求实例
http = urllib3.PoolManager()
#网址
url = 'http://www.pythonscraping.com/pages/page3.html'
#请求头
head = {'User-Agent':'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/88.0.4324.96 Safari/537.36 Edg/88.0.705.56'}
#超时时间
tm = urllib3.Timeout(connect=1.0,read=3.0)
#重试次数和重定向次数设置,生成请求
rq = http.request('GET',url=url,headers=head,timeout=tm,redirect=4)
print('服务器响应码:', rq.status)
print('响应实体:', rq.data.decode('utf-8'))
服务器响应码: 200
响应实体:
width:75px;
}
table{
width:50%;
}
td{
margin:10px;
padding:10px;
}
.wrapper{
width:800px;
}
.excitingNote{
font-style:italic;
font-weight:bold;
}

Totally Normal Gifts
hand-curated by well-paid, free-range Tibetan monks.
We haven't figured out how to make online shopping carts yet, but you can send us a check to:
123 Main St.
Abuja, Nigeria
We will then send your totally amazing gift, pronto! Please include an extra $5.00 for gift wrapping.
Item Title | Description | Cost | Image |
|---|---|---|---|
Vegetable Basket | This vegetable basket is the perfect gift for your health conscious (or overweight) friends! Now with super-colorful bell peppers! | $15.00 |
|
Russian Nesting Dolls | Hand-painted by trained monkeys, these exquisite dolls are priceless! And by "priceless," we mean "extremely expensive"! 8 entire dolls per set! Octuple the presents! | $10,000.52 |
|
Fish Painting | If something seems fishy about this painting, it's because it's a fish! Also hand-painted by trained monkeys! | $10,005.00 |
|
Dead Parrot | This is an ex-parrot! Or maybe he's only resting? | $0.50 |
|
Mystery Box | If you love suprises, this mystery box is for you! Do not place on light-colored surfaces. May cause oil staining. Keep your friends guessing! | $1.50 |
|


二、使用requests库实现HTTP请求
import requests
url = 'http://www.pythonscraping.com/pages/page3.html'
rq2 = requests.get(url)
rq2.encoding = 'utf-8'
print('响应码:',rq2.status_code)
print('编码:',rq2.encoding)
print('请求头:',rq2.headers)
print('实体:',rq2.text)
解决字符编码问题
需要注意的是,当requests库猜测错时,需要手动指定encoding编码,避免返回的网页内容解析出现乱码。手动指定的方法并不灵活,无法自适应对应爬取过程中不同网页的编码,而使用chardet库比较简便灵活,chardet库是一个非常优秀的字符串∕文件编码检测模块。
chardet库使用detect方法检测给定字符串的编码,detect方法常用的参数及其说明如下
参数说明byte_str接收string。表示需要检测编码的字符串。无默认值
import chardet
chardet.detect(rq2.content)
输出:100%的概率是用ascii码编码的

完整代码
import requests
import chardet
url = 'http://www.pythonscraping.com/pages/page3.html'
head={'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/88.0.4324.96 Safari/537.36 Edg/88.0.705.56'}
rq2 = requests.get(url,headers=head,timeout=2.0)
rq2.encoding = chardet.detect(rq2.content)['encoding']
print('实体:',rq2.content)
三、解析网页
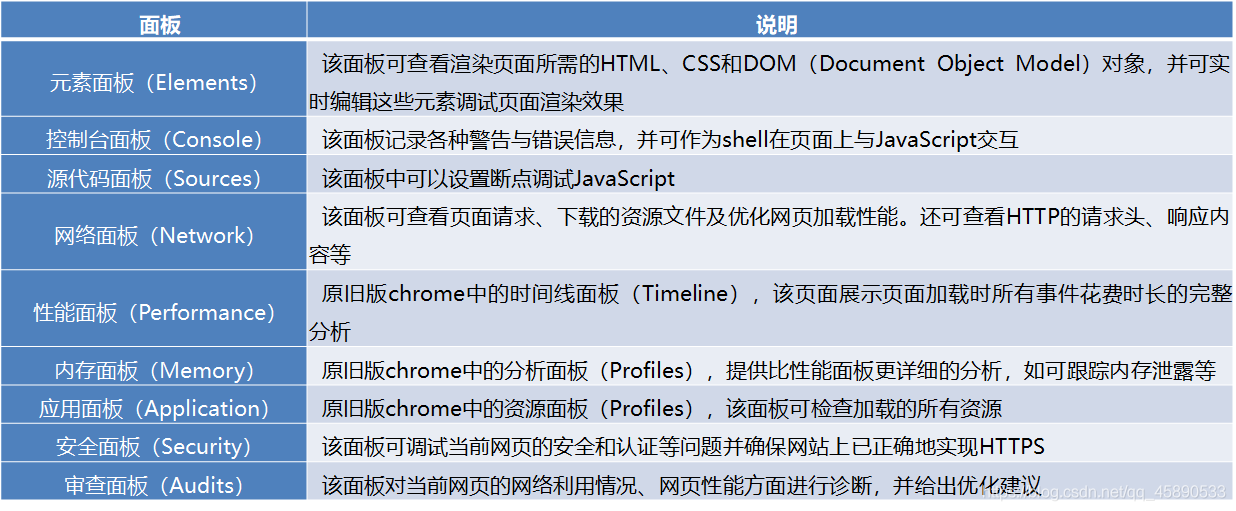
chrome开发者工具各面板功能如下
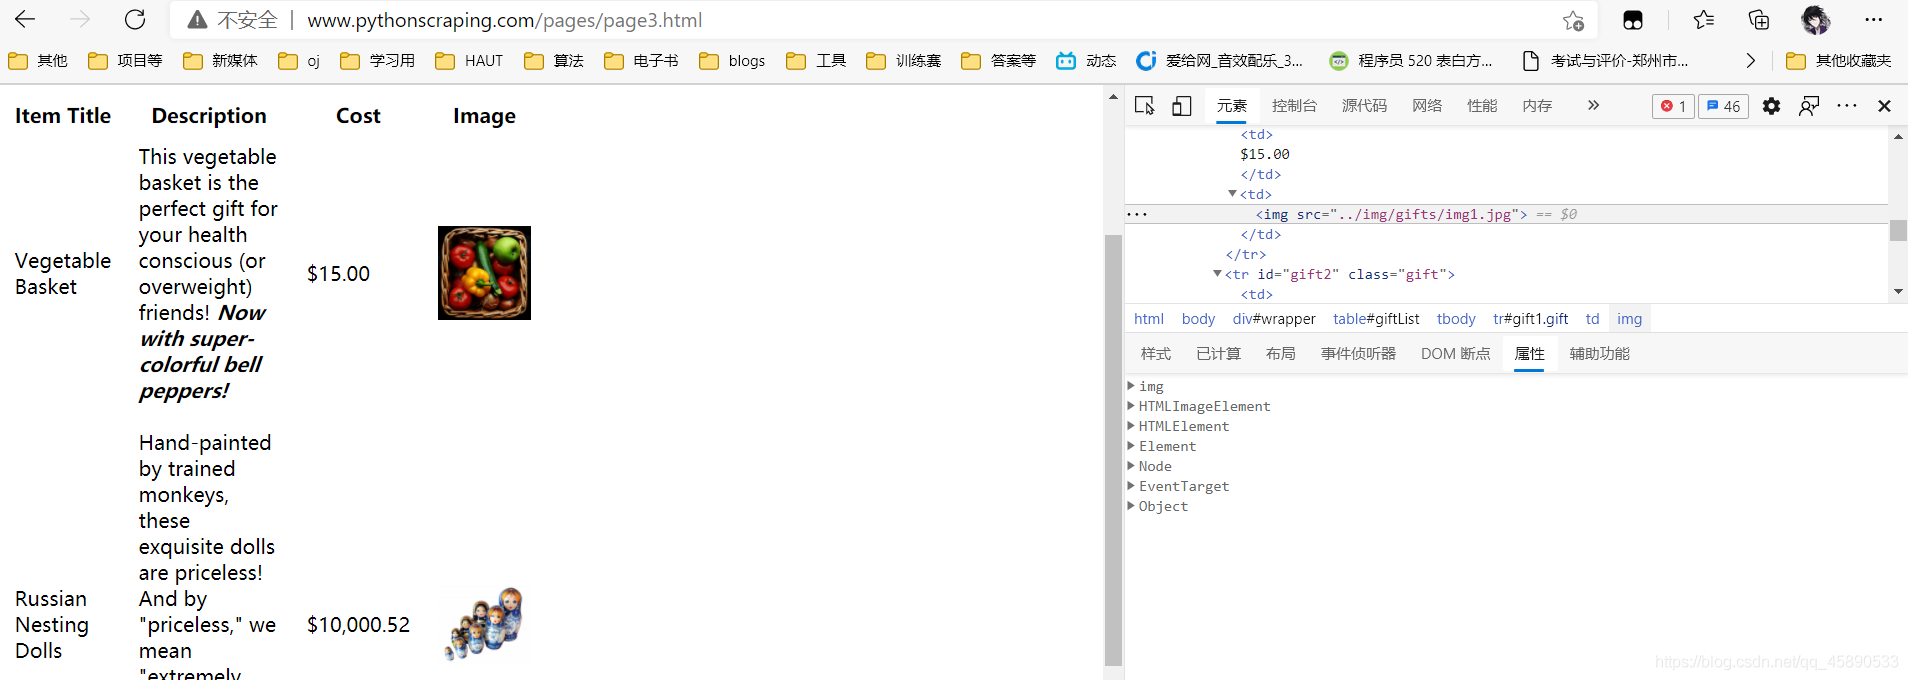
1.元素面板
在爬虫开发中,元素面板主要用来查看页面元素所对应的位置,比如图片所在位置或文字链接所对应的位置。面板左侧可看到当前页面的结构,为树状结构,单击三角符号即可展开分支。
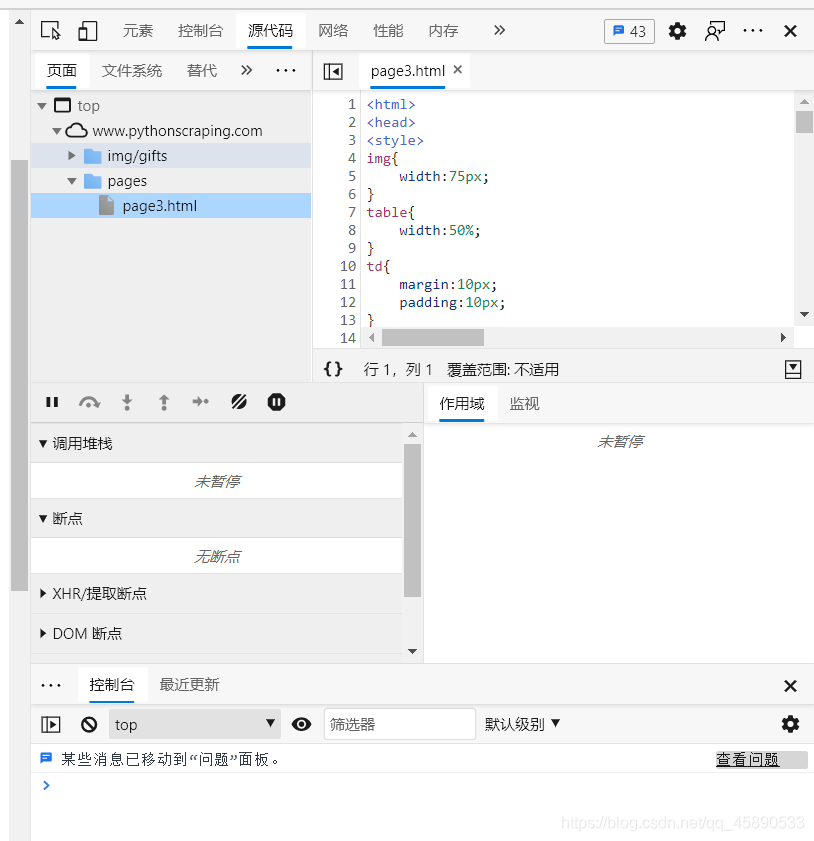
2.源代码面板
切换至源代码面板(Sources)
3.网络面板
切换至网络面板(Network),需先重新加载页面,点击某资源,将在中间显示该资源的头部信息、预览、响应信息、Cookies和花费时间详情,如图所示。
四、使用正则表达式解析网页
1. Python正则表达式:寻找字符串中的姓名和电话号码
正则表达式是一种可以用于模式匹配和替换的工具,可以让用户通过使用一系列的特殊字符构建匹配模式,然后把匹配模式与待比较字符串或文件进行比较,根据比较对象中是否包含匹配模式,执行相应的程序。
rawdata = “555-1239Moe Szyslak(636) 555-0113Burns, C.Montgomery555-6542Rev. Timothy Lovejoy555 8904Ned Flanders636-555-3226Simpson,Homer5553642Dr. Julius Hibbert ”
试试
import re
string = '1. A small sentence - 2.Anthoer tiny sentence. '
print('re.findall:',re.findall('sentence',string))
print('re.search:',re.search('sentence',string))
print('re.match:',re.match('sentence',string))
print('re.match:',re.match('1. A small sentence',string))
print('re.sub:',re.sub('small','large',string))
print('re.sub:',re.sub('small','',string))
输出:
re.findall: [‘sentence’, ‘sentence’]
re.search:
re.match: None
re.match:
re.sub: 1. A large sentence - 2.Anthoer tiny sentence.
re.sub: 1. A sentence - 2.Anthoer tiny sentence.
常用广义化符号
1、英文句号“.”:能代表除换行符“\n”任意一个字符;
string = '1. A small sentence - 2.Anthoer tiny sentence. '
re.findall('A.',string)
输出:['A ', ‘An’]
2、字符类“[]”:被包含在中括号内部,任何中括号内的字符都会被匹配;
string = 'small smell smll smsmll sm3ll sm.ll sm?ll sm\nll sm\tll'
print('re.findall:',re.findall('sm.ll',string))
print('re.findall:',re.findall('sm[asdfg]ll',string))
print('re.findall:',re.findall('sm[a-zA-Z0-9]ll',string))
print('re.findall:',re.findall('sm\.ll',string))
print('re.findall:',re.findall('sm[.?]ll',string))
输出:
re.findall: ['small', 'smell', 'sm3ll', 'sm.ll', 'sm?ll', 'sm\tll']
re.findall: ['small']
re.findall: ['small', 'smell', 'sm3ll']
re.findall: ['sm.ll']
re.findall: ['sm.ll', 'sm?ll']
3.量化符号"{}":可以被匹配多少次
print('re.findall:',re.findall('sm..ll',string))
print('re.findall:',re.findall('sm.{2}ll',string))
print('re.findall:',re.findall('sm.{1,2}ll',string))
print('re.findall:',re.findall('sm.{1,}ll',string))
print('re.findall:',re.findall('sm.?ll',string)) # {0,1}
print('re.findall:',re.findall('sm.+ll',string)) # {0,}
print('re.findall:',re.findall('sm.*ll',string)) # {1,}
输出:
re.findall: [‘smsmll’]
re.findall: [‘smsmll’]
re.findall: [‘small’, ‘smell’, ‘smsmll’, ‘sm3ll’, ‘sm.ll’, ‘sm?ll’, ‘sm\tll’]
re.findall: [‘small smell smll smsmll sm3ll sm.ll sm?ll’, ‘sm\tll’]
re.findall: [‘small’, ‘smell’, ‘smll’, ‘smll’, ‘sm3ll’, ‘sm.ll’, ‘sm?ll’, ‘sm\tll’]
re.findall: [‘small smell smll smsmll sm3ll sm.ll sm?ll’, ‘sm\tll’]
re.findall: [‘small smell smll smsmll sm3ll sm.ll sm?ll’, ‘sm\tll’]
ps:贪婪规则,尽可能匹配多的
完整代码
import pandas as pd
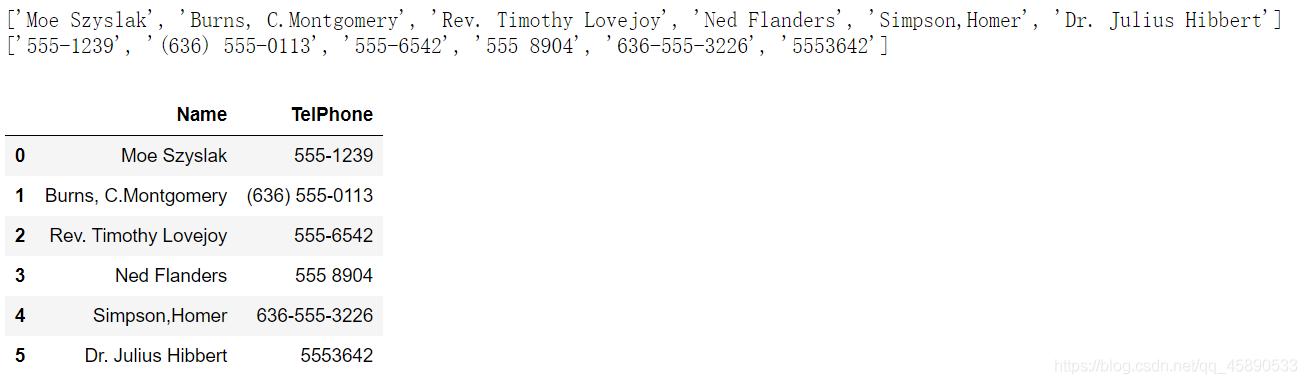
rawdata = '555-1239Moe Szyslak(636) 555-0113Burns, C.Montgomery555-6542Rev. Timothy Lovejoy555 8904Ned Flanders636-555-3226Simpson,Homer5553642Dr. Julius Hibbert'
names = re.findall('[A-Z][A-Za-z,. ]*',rawdata)
print(names)
number = re.findall('\(?[0-9]{0,3}\)?[ \-]?[0-9]{3}[ \-]?[0-9]{4}',rawdata)
print(number)
pd.DataFrame({'Name':names,'TelPhone':number})
输出:
五、使用Xpath解析网页
XML路径语言(XML Path Language),它是一种基于XML的树状结构,在数据结构树中找寻节点,确定XML文档中某部分位置的语言。使用Xpath需要从lxml库中导入etree模块,还需使用HTML类对需要匹配的HTML对象进行初始化(XPath只能处理文档的DOM表现形式)。HTML类的基本语法格式如下。
1.基本语法
lxml.etree.HTML(text, parser=None, *, base_url=None)
参数说明text接收str。表示需要转换为HTML的字符串。无默认值
parser接收str。表示选择的HTML解析器。无默认值
base_url接收str。表示设置文档的原始URL,用于在查找外部实体的相对路径。默认为None
若HTML中的节点没有闭合,etree模块也提供自动补全功能。调用tostring方法即可输出修正后的HTML代码,但是结果为bytes类型,需要使用decode方法转成str类型。
Xpath使用类似正则的表达式来匹配HTML文件中的内容,常用匹配表达式如下。
表达式说明nodename选取nodename节点的所有子节点
/从当前节点选取直接子节点
//从当前节点选取子孙节点
.选取当前节点
…选取当前节点的父节点
@选取属性
2.谓语
Xpath中的谓语用来查找某个特定的节点或包含某个指定的值的节点,谓语被嵌在路径后的方括号中,如下。
表达式说明/html/body/div[1]选取属于body子节点下的第一个div节点
/html/body/div[last()]选取属于body子节点下的最后一个div节点
/html/body/div[last()-1]选取属于body子节点下的倒数第二个div节点
/html/body/div[positon()❤️]选取属于body子节点下的下前两个div节点
/html/body/div[@id]选取属于body子节点下的带有id属性的div节点
/html/body/div[@id=“content”]选取属于body子节点下的id属性值为content的div节点
/html/body/div[xx>10.00]选取属于body子节点下的xx元素值大于10的节点
3. 功能函数
Xpath中还提供部分功能函数进行模糊搜索,有时对象仅掌握了其部分特征,当需要模糊搜索该类对象时,可使用功能函数来实现,具体函数如下。
功能函数示例说明starts-with//div[starts-with(@id,”co”)]选取id值以co开头的div节点
contains//div[contains(@id,”co”)]选取id值包含co的div节点
and//div[contains(@id,”co”)andcontains(@id,”en”)]选取id值包含co和en的div节点
text()//li[contains(text(),”first”)]选取节点文本包含first的div节点
4.谷歌开发者工具使用
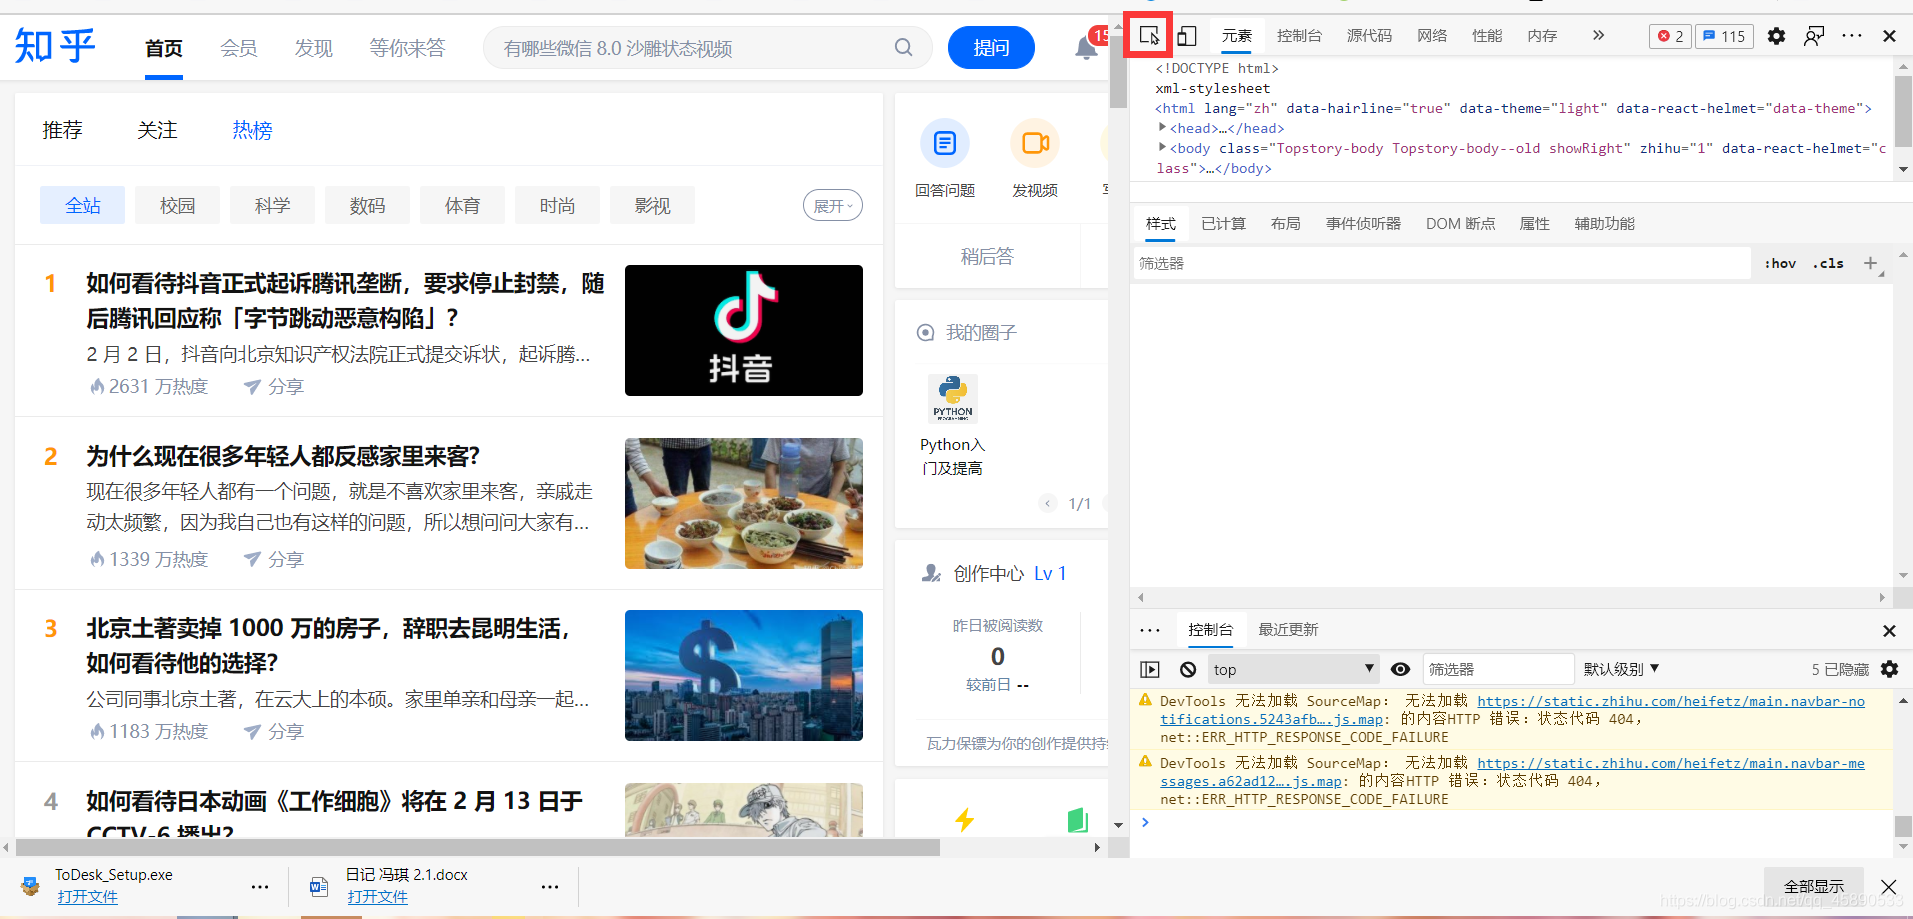
谷歌开发者工具提供非常便捷的复制xpath路径的方法
eg:爬取知乎热榜完整代码
试了一下爬取知乎热榜,需要登录所以可以自己登陆然后获取cookie
import requests
from lxml import etree
url = "https://www.zhihu.com/hot"
hd = { 'Cookie':'你的Cookie', #'Host':'www.zhihu.com',
'User-Agent':'Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/50.0.2661.102 Safari/537.36'}
response = requests.get(url, headers=hd)
html_str = response.content.decode()
html = etree.HTML(html_str)
title = html.xpath("//section[@class='HotItem']/div[@class='HotItem-content']/a/@title")
href = html.xpath("//section[@class='HotItem']/div[@class='HotItem-content']/a/@href")
f = open("zhihu.txt",'r+')
for i in range(1,41):
print(i,'.'+title[i])
print('链接:'+href[i])
print('-'*50)
f.write(str(i)+'.'+title[i]+'\n')
f.write('链接:'+href[i]+'\n')
f.write('-'*50+'\n')
f.close()
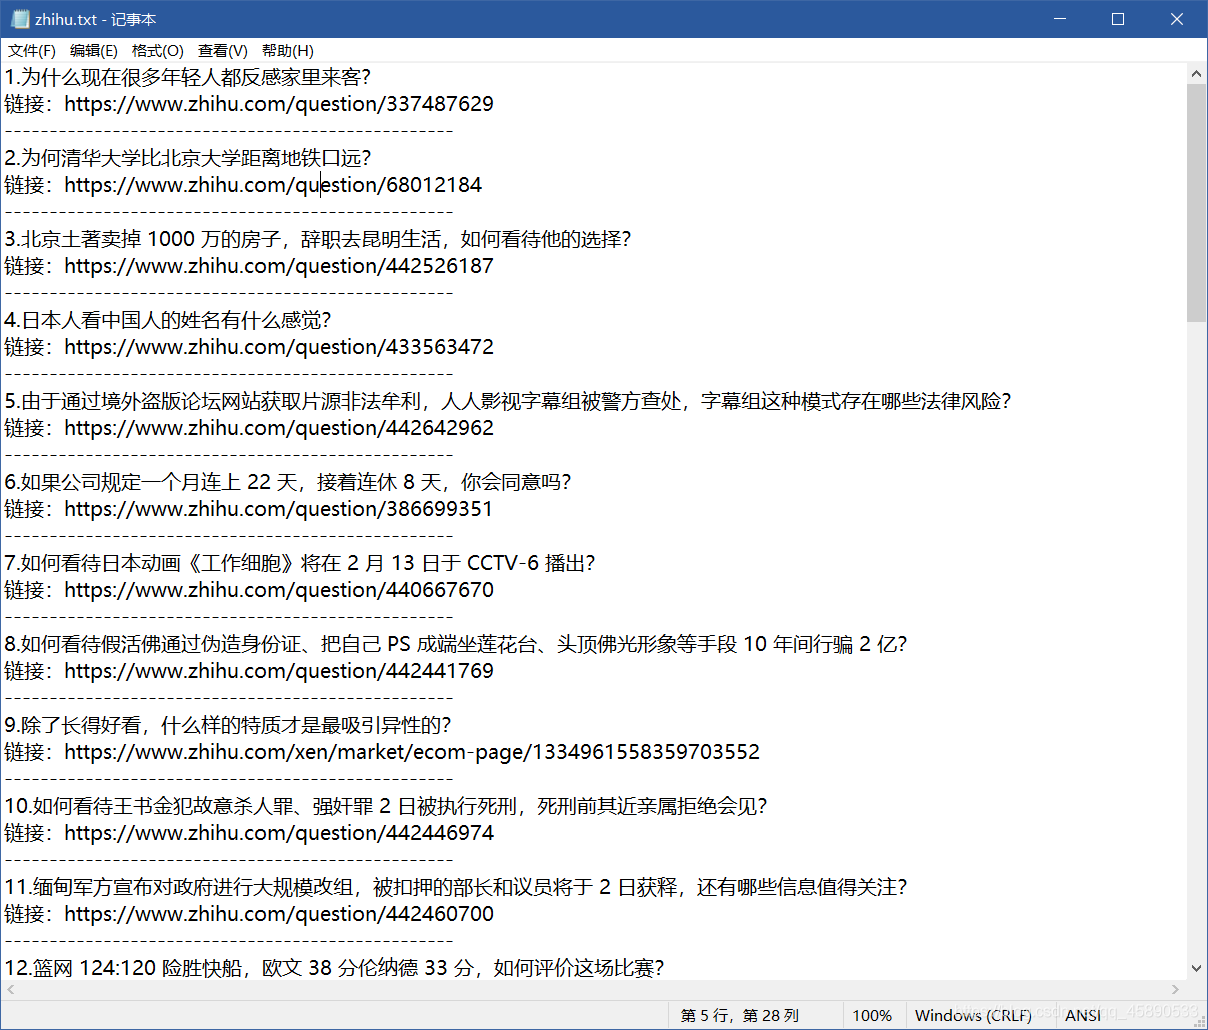
爬取结果
六、数据存储
1.以json格式存储
import requests
from lxml import etree
import json
#上面代码略
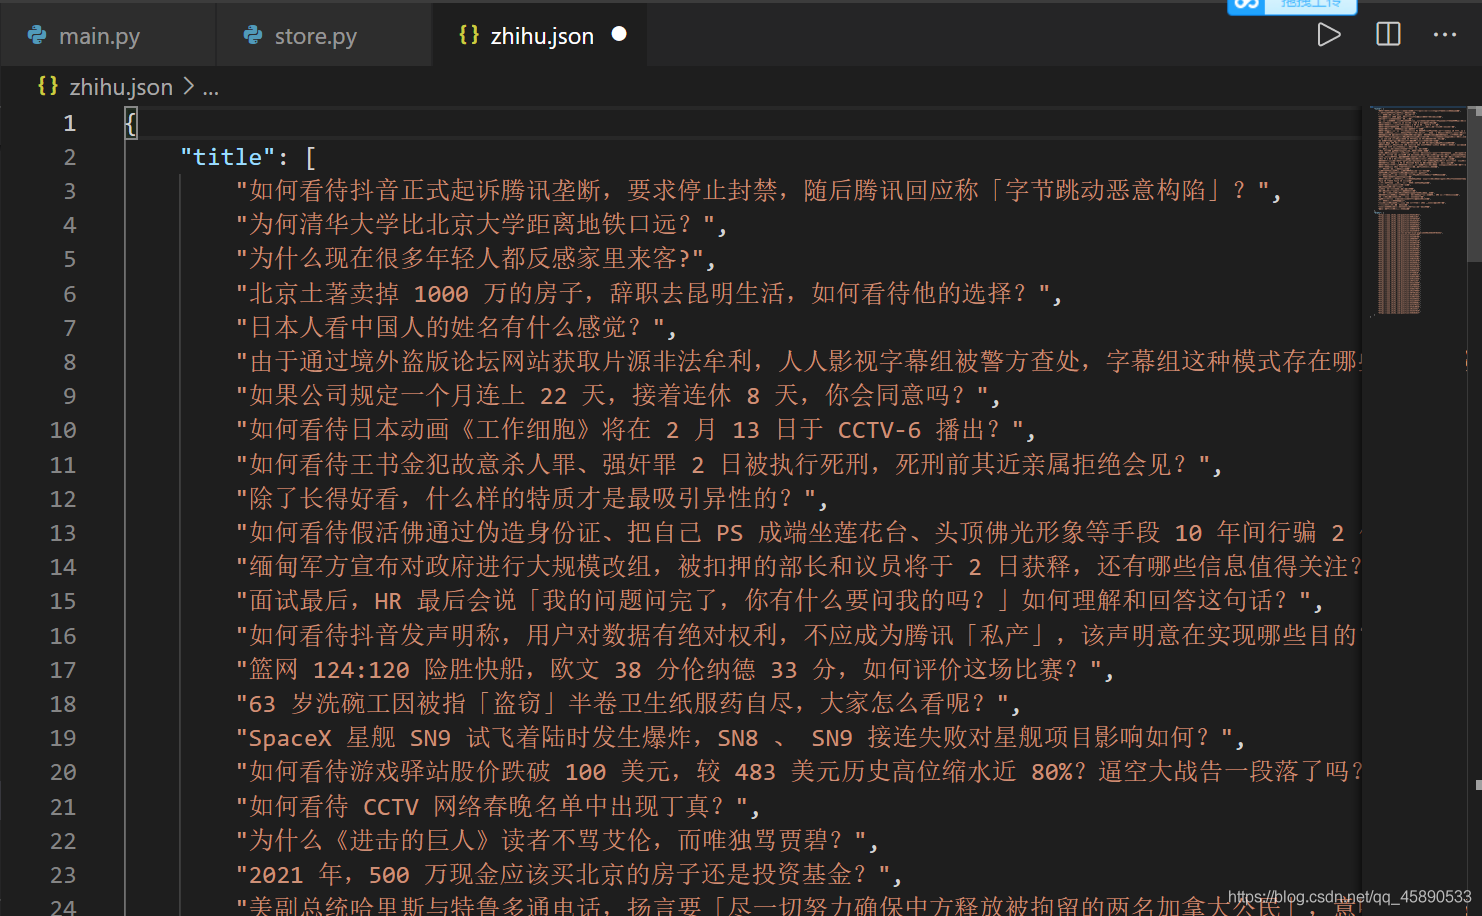
with open('zhihu.json','w') as j:
json.dump({'title':title,'hrefL':href},j,ensure_ascii=False)
存储结果(ps:经过文件格式化处理)

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)