Python自然语言处理 | 语言处理与python
·
- 本章解决问题
- 将简单的程序与大量的文本结合起来,我们能实现什么?
- 我们如何能自动提取概括文本风格和内容的关键词和短语?
- Python编程语言为上述工作提供了哪些工具和技术?
- 自然语言处理中的有哪些有趣的挑战?
1 文本和单词
# 导入nltk的文本
from nltk.book import *
# 如输出text1,就能看出是否导入成功
text1
几个常用的函数:
- text.concordance(word)
- 这个函数就是用来搜索单词word在text 中出现多的情况,包括出现的那一行,重点强调上下文,实例如下:
- 从输出格式中可以看出来, concordance 将要查询的单词,基本显示在一列,这样容易观察其上下文.
# 搜索文本text2中affection出现最多的文本
print(text2.concordance("affection"))
- text.similar(word)
- 这个函数的作用则是根据word 的上下文的单词的情况,来查找具有相似的上下文的单词. 比如affection 在上面可以看到,有这样的用法:
- 可以看出的是, text1 和text2 对同一个单词monstrous 的不同使用风格.
print(text1.similar('affection'))
print(text2.similar('affection'))
- text.common_contexts([word1,word2…])
- 跟simailar() 有点类似,也是在根据上下文搜索的.
- 不同的是,这个函数是用来搜索 共用 参数中的列表中的所有单词,的上下文.即: word1,word2 相同的上下文
print(text1.common_contexts(['affection','love']))
print(text2.common_contexts(['affection','love']))
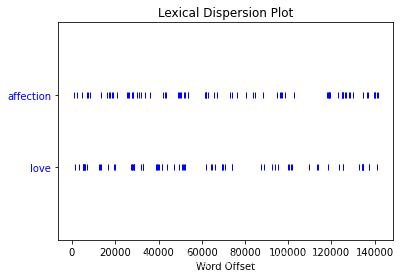
- text.dispersion_plot([word1, word2,])
- 这个函数是用离散图 表示 语料中word 出现的位置序列表示.
text2.dispersion_plot(['affection','love'])
- len:统计单词量:以单词和标点符号为单位
- text.count():统计频数
print(len(text1))
print(text1.count('the'))
print(len(text1)/len(set(text1))) # 平均每个单词的使用的频数
# 定义文章单词的平均使用频数的函数
def lexical_diversity(text):
    return len(text) / len(set(text))

# 定义某个词占文本的百分比
def percentage(count,total):
    return 100*count/total
lexical_diversity(text3)
percentage(text3.count('a'),len(text3))
2 近观Python:将文本当做词链表
- 列表的使用
- 变量的定义
- 字符串的使用
name = ''.join(['chen',' ','jia'])
name.split()
3 计算语言:简单的统计
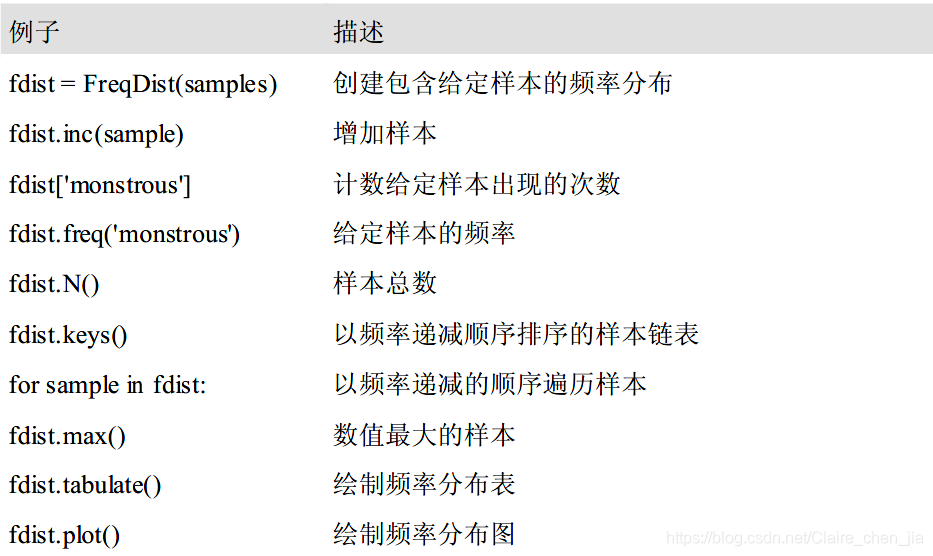
- 频率分布 FreqDist(text)
- 告诉我们文本中每一个词项的频率;
- FreqDist继承自dict,所以我们可以像操作字典一样操作FreqDist对象;
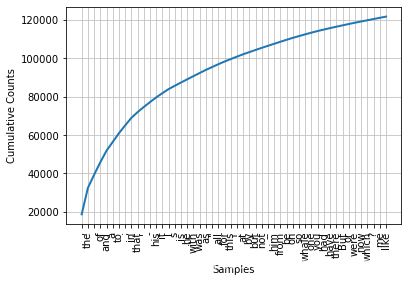
- FreqDist.plot(n):该方法接受一个数字n,会绘制出现次数最多的前n项,在本例中即绘制高频词汇;
- FreqDist.tabulate(n):该方法接受一个数字n作为参数,会以表格的方式打印出现次数最多的前n项;
- FreqDist::most_common(n):该方法接受一个数字n作为参数,返回出现次数最多的前n项列表;
- FreqDist.hapaxes():该方法会返回一个低频项列表,低频项即出现一次的项;
- FreqDist.max():该方法会返回出现次数最多的项。
fdist = FreqDist(text1)  # text1 的文本词项频率分布
fdist
for key in fdist:
    print(key, fdist[key])
fdist["whale"] # 白鲸记中鲸鱼的词项分布
fdist.plot(50,cumulative=True) # 50个常用词的累计频率图
fdist.tabulate(15) # 会以表格的方式打印出现次数最多的前n项
fdist.most_common(15) # 会以列表的方式打印出现次数最多的前n项
fdist.hapaxes() # 该方法会返回一个低频项列表,低频项即出现一次的项。
fdist.max() # 该方法会返回出现次数最多的项.
- 细粒度的选择词
# 找出文本词汇中大于num个字符且频率为freq的词
def word_long(num,text,freq):
    v = set(text)
    long_word = [w for w in v if len(w)>num and fdist[w] > freq]
    sorted(long_word)
    return long_word
word_long(14,text1,5) # 找出text1中字符串大于14的词 且使用超过5次的词
- 词语搭配和双连词(bigram)
- bigrams:从提取文本词汇中的两两形成词对,即双连词;
- text.collocations():找出频数较高的双联词
a = bigrams([ 'more' , ' is' , 'said' , 'than' , 'done'])
for i in a:
    print(i)
text1.collocations() # 找出text1中的常用的双联词
- 计数文中单词的字符长度的分布
fdist = FreqDist([len(w) for w in text1])  # 记录每个单词的字符长度的分布
fdist  # 得到分布
fdist.keys() # 得到单词的字符长度
fdist.items() # 得到单词的字符长度和出现的频次
4 回到python:决策与控制
程序设计的一个关键特征是让机器能按照我们的意愿决策,遇到特定条件时执行特定命令,或者对文本数据从头到尾不断循环遍历直到条件满足。这一特征被称为控制。
- [w for w in text if condition]
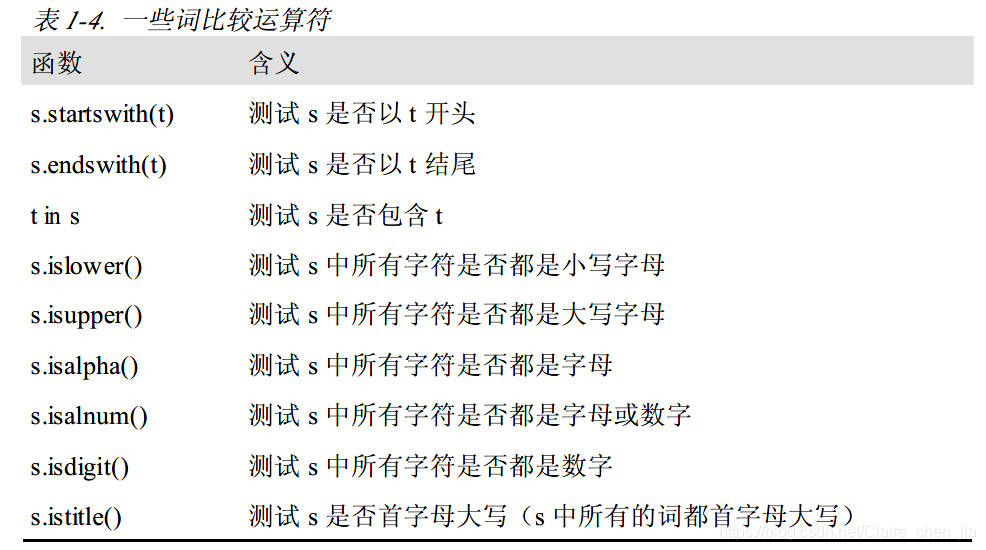
sorted([w for w in set(text1) if w.endswith('ableness')])
[w.upper() for w in text1] # 对每个单词元素进行操作 --> 变为大写
len(set([word.lower() for word in text1 if word.isalpha()])) # 将大写的单词变为小写后,方便计数
- 嵌套代码块:if 语句
- 条件循环:for
tricky = sorted([w for w in set(text2) if 'cie'in w or 'cei' in w])
for word in tricky:
    print(word)
5 自动理解自然语言
我们将从代码的细节中退出来,描绘一下自然语言处理的全景图。
1. 词意消歧(Word Sense Disambiguation):针对有不同词意的词,要分析出特定上下文中的词被赋予的是哪个意思。
2. 指代消解(Anaphora Resolution):确定代词或名词短语指代的对象。
https://zhuanlan.zhihu.com/p/150304175?from_voters_page=true
3. 语义角色标注(Semantic Role Labeling):确定名词短语如何与动词相关联(如代理,受事,工具,etc.)。
4. 自动问答(Question Answering):NLTK提供了一个原始的对话系统:运行nltk.chat.chatbots()。
5. 机器翻译(Machine Translation):文本对齐(text alignment),根据两种语言的文档或双语词典,自动配对组成句子。
6. 文本含义识别(Recognizing Textual Entailment)
import nltk
nltk.chat.chatbots()
1
6 小结
1. 在Python 中文本用链表来表示:['Monty', 'Python']。我们可以使用索引、分片和len()等函数对链表进行操作。

2. 词“token”(标识符)是指文本中词汇表中词语的一次出现;词“type”(类型)则是指词作为一个特定序列字母的唯一形式。我们使用len(text)计数词的标识符,使用len(set(text))计数词的类型。

3. 我们使用sorted(set(t))获得文本t的词汇表。

4. 我们使用[f(x) for x in text]对文本的每一个标识符进行操作。

5. 为了获得没有大小写区分和忽略标点符号的词汇表,我们可以使用set([w.lower() for w in text if w.isalpha()])。

6. 我们使用for 语句对文本中的每个词进行处理,例如for w in t:或者for word in text:。后面必须跟冒号和一块在每次循环被执行的缩进的代码。

7. 我们使用if 语句测试一个条件:if len(word)<5:。后面必须跟冒号和一块仅当条件为真时执行的缩进的代码。

8. 频率分布是词语及其的频率计数的集合(例如:一个文本中的词与它们出现的频率)。

9. 函数是指定了名字并且可以重用的代码块。函数通过def 关键字定义,例如在def mult(x, y)中x 和y 是函数的参数,起到实际数据值的占位符的作用。
7 练习
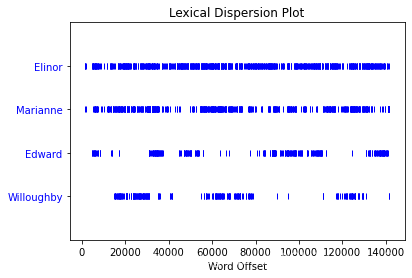
# 制作《理智与情感》中四个主角:Elinor,Marianne,Edward 和Willoughby 的分布图。
# 在这部小说中关于男性和女性所扮演的不同角色,你能观察到什么?你能找出一对夫妻吗?
text2.dispersion_plot(['Elinor','Marianne','Edward','Willoughby'])

# 根据人名在文中位置的分布,可以初步得出以下结论:

# a)Elinor在文中出现最为频繁,贯穿文章始终,其次Marianne出现也相当频繁,且二人常常同时出现,由此推断应该两人相识且关系密切,是推动故事情节的发展的主线人物。

# b)Edwardhe和Willoughby往往错开出现,推断二人并不熟识。
#  w.isupper()和not w.islower()这两个测试之间的差异是什么?
# 前者判断w中的字符是否全部大写,后者判断w中的字符是否全部小写。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献7条内容

所有评论(0)