python爬取京东手机参数_python爬虫——分页爬取京东商城商品信息(手机为例)...
1、最近刚开始学习python 写了个爬虫练习,感觉主要是得会用F12查询网站结构代码。还涉及到反爬虫,每个网站都不一样,拿到的解析出的json数据格式也不同。得有些Web知识的基础才行。
https://www.bilibili.com/video/av54287470/ 视频讲解
2、上代码
import urllib.request
import time
# xpath lxml第三方包 将html转化为树形结构
from lxml import etree
# re系统包 正则
import re
"""
爬取数据方式: 1、通过网页源代码(数据绑定在html标签中)
根据目标网址绑定数据的方式决定 2、通过接口获取json(json绑定)
京东商品信息 获取目标url(开发者模式) 获取网页源代码抓取数据
搜索页面、商品子页面{获取搜索页面的所有商品 class="gl-i-wrap",所有商品的子页面【二次爬取】}
发送url获取响应数据 反爬
进行数据处理
"""
# 分页抓取手机商品信息
def jdPhone_spider(url,beginPage,endPage):
for page in range(beginPage,endPage+1):
#京东页码奇数递增处理 反爬
pn = page*2 -1
print("正在抓取第"+str(page)+"页")
fullurl = url+"&page="+str(pn)#构建带页码的url
# 防止被封
time.sleep(2)
#读取页面
load_page(fullurl)
# 读取查询页面
def load_page(url):
#定义请求头
headers = {
"user_agent":"Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.86 Safari/537.36"
}
# 给请求添加请求头
request = urllib.request.Request(url,headers=headers)
html = urllib.request.urlopen(request).read()
content = etree.HTML(html) #转化为tree 使用xpth进行匹配(标签匹配 跟正则挺像)
# print(content)
#获取商品的详情页面 div下的@代表属性
content_list = content.xpath('//div[@class="gl-i-wrap"]/div[@class="p-img"]/a/@href')
# print(content_list)
#url统一处理
for i in range(1,31):
# 异常处理,防止页码越界
try:
# ""前加r代表字符串(原始字符串) 正则截取数据 根据:截取
result = re.split(r":",content_list[i-1])[1]
content_list[i-1] = result
except Exception as e:
continue
# print(content_list)
# j是所有的商品详情页面
for j in content_list:
# print(j)
new_url = "http:"+j #拿到完整url 接下来读取子页面信息
load_link_page(new_url,headers)
# 读取商品详情子页面的信息
def load_link_page(url,headers):
request = urllib.request.Request(url, headers=headers)
html = urllib.request.urlopen(request).read()
content = etree.HTML(html) # 转化为tree 使用xpth进行匹配(标签)
#获取手机的品牌
brand = content.xpath('//div[@class="p-parameter"]/ul[@id="parameter-brand"]/li/@title')
print(brand)
if __name__ == '__main__':
beginPage = int(input("请输入起始页:"))
endPage = int(input("请输入结束页:"))
# 目标url 手机变成unicode编码%E6%89%8B%E6%9C%BA
url = "https://search.jd.com/Search?keyword=%E6%89%8B%E6%9C%BA&enc=utf-8"
jdPhone_spider(url,beginPage,endPage)
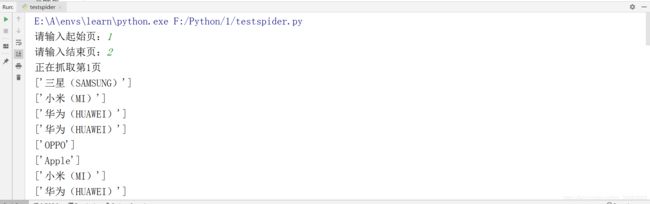
3、部分结果

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 1
 0
- 0


 已为社区贡献4条内容

所有评论(0)