机器学习-38-GAN-05-General Framework of GAN(fGAN,GAN的一般框架)
文章目录
General Framework of GAN
之前在讲GAN的时候,提到我们实际是在用Discriminator来衡量两个数据的分布之间的JS divergence,那能不能是其他类型的divergence来衡量真实数据和生成数据之间的差距?又如何进行衡量?(虽然在实作上用不同divergence结果没有很大差别)
李老师原话:在数学上感觉非常的屌
在开始讲fGAN之前,需要先补充两个基础知识,f-divergence和Fenchel Conjugate。为什么要讲它们,后面会提到。
f-divergence(通用的divergence模型)
任意的divergence都可以用来衡量真实数据和生成数据之间的差距,用f-divergence进行衡量的算法就叫fGAN。先来看看f-divergence的概念:
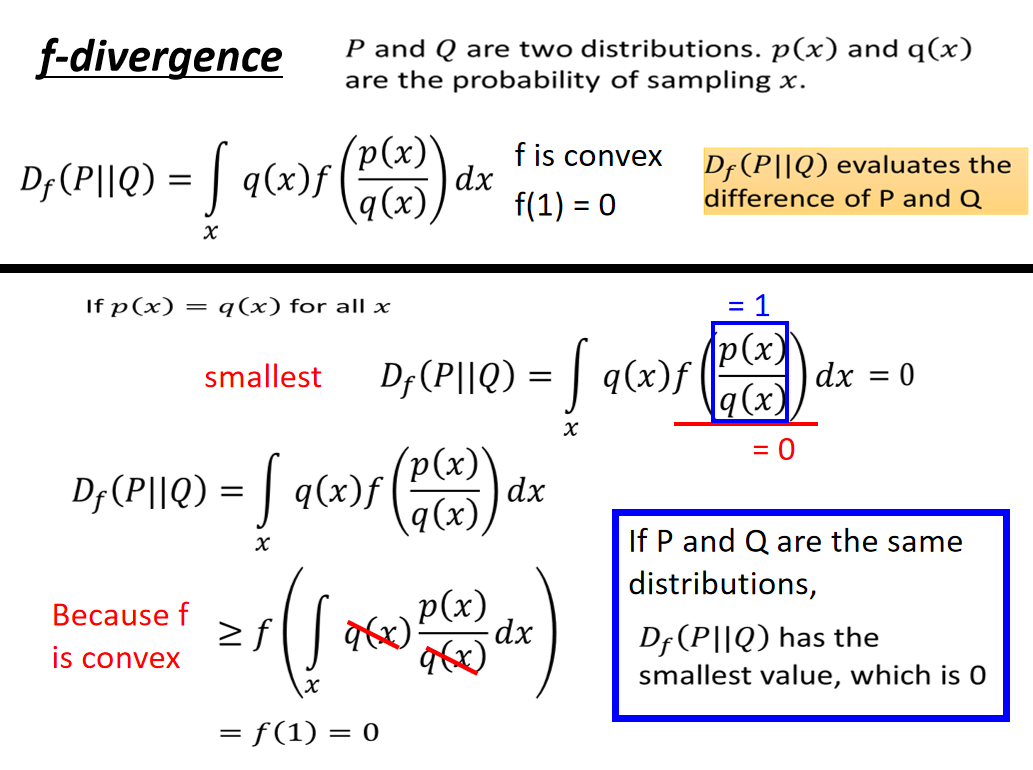
假设有两个分布 P 和 Q,p(x) 和 q(x) 分别代表样本 x 从这两个分布中采样出来的概率,则能定义 P 和 Q 之间的 f-divergence 为:
D
f
(
P
∣
∣
Q
)
=
∫
x
q
(
x
)
f
(
p
(
x
)
q
(
x
)
)
d
x
D_f(P||Q) = \int_xq(x)f(\frac{p(x)}{q(x)})dx
Df(P∣∣Q)=∫xq(x)f(q(x)p(x))dx
其中对于函数 f(x) 有两个要求:
- f 要求是凸函数
- 要求 f(1)=0
更换不同的函数 f(x),就能得到不同的 f-divergence。
为什么这个式子可以用来衡量 P 和 Q 之间的差异呢?它有以下几个特点:
- 如果对于所有的 x,有 p(x)=q(x),那么 D f ( P ∣ ∣ Q ) = ∫ x q ( x ) f ( 1 ) d x = 0 D_f(P||Q) = \int_xq(x)f(1)dx = 0 Df(P∣∣Q)=∫xq(x)f(1)dx=0 。原因很简单,f(1)=0。
- 恒定的,有 D f ( P ∣ ∣ Q ) ≥ 0 D_f(P||Q)≥0 Df(P∣∣Q)≥0 。因为 f(x) 是一个凸函数,所以有
D f ( P ∣ ∣ Q ) = ∫ x q ( x ) f ( p ( x ) q ( x ) ) d x ≥ f ( ∫ x q ( x ) p ( x ) q ( x ) d x ) = f ( ∫ x p ( x ) d x ) = f ( 1 ) = 0 \begin{aligned} D_f(P||Q) = \int_xq(x)f(\frac{p(x)}{q(x)})dx ≥ & f(\int_xq(x)\frac{p(x)}{q(x)}dx) \\ = & f(\int_xp(x)dx) \\ = & f(1)\\ = & 0 \end{aligned} Df(P∣∣Q)=∫xq(x)f(q(x)p(x))dx≥===f(∫xq(x)q(x)p(x)dx)f(∫xp(x)dx)f(1)0
因此, D f ( P ∣ ∣ Q ) D_f(P||Q) Df(P∣∣Q) 可用来对 P 和 Q 之间差距作出衡量。
下面列举几个常见的 f(x) 取值及其得到的 f-divergence。

Fenchel Conjugate(凸共轭)
每一个凸函数都有一个共轭函数(conjugate function),记为
f
∗
f^*
f∗ ,长这样:
f
∗
(
t
)
=
max
x
∈
d
o
m
(
f
)
{
x
t
−
f
(
x
)
}
f^*(t) = \max\limits_{x∈dom(f)}\{xt-f(x)\}
f∗(t)=x∈dom(f)max{xt−f(x)}
在这个函数中,t 是自变量,就是说带一个值 t 到
f
∗
f^*
f∗ 里面,穷举所有的x,看看哪个x可以使得
f
∗
f^*
f∗ 最大。
比较笨的穷举法如下:
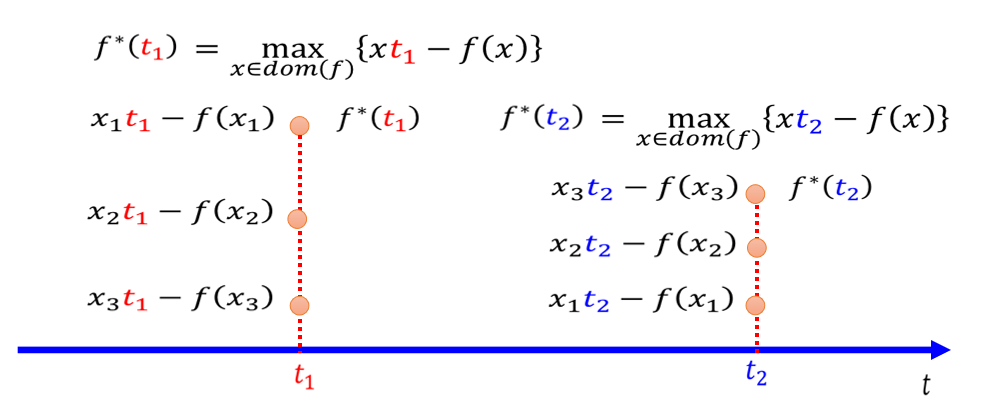
另外一种方法:函数 x t − f ( x ) xt-f(x) xt−f(x)是直线,我们带不同的 x x x得到不同的直线,例如下面有三条直线:
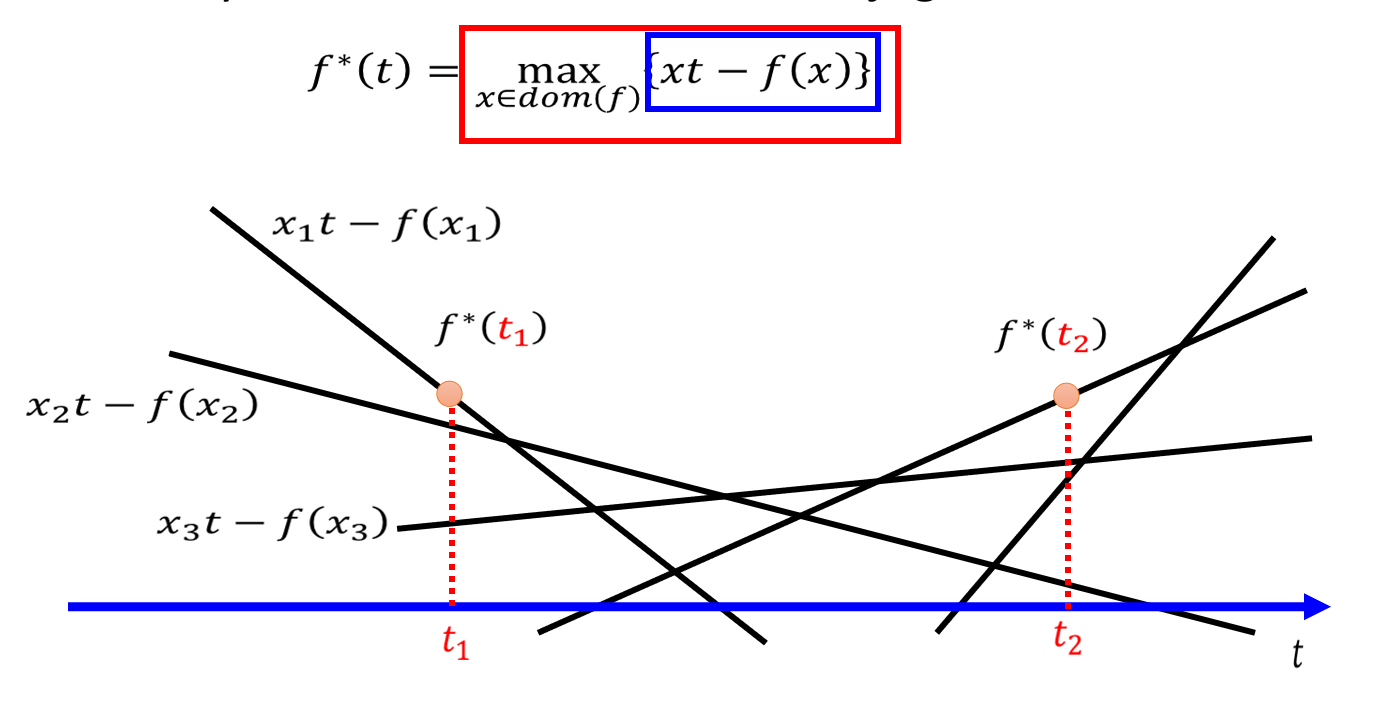
然后找不同的t对应的最大值。(就是所有直线的upper bound)
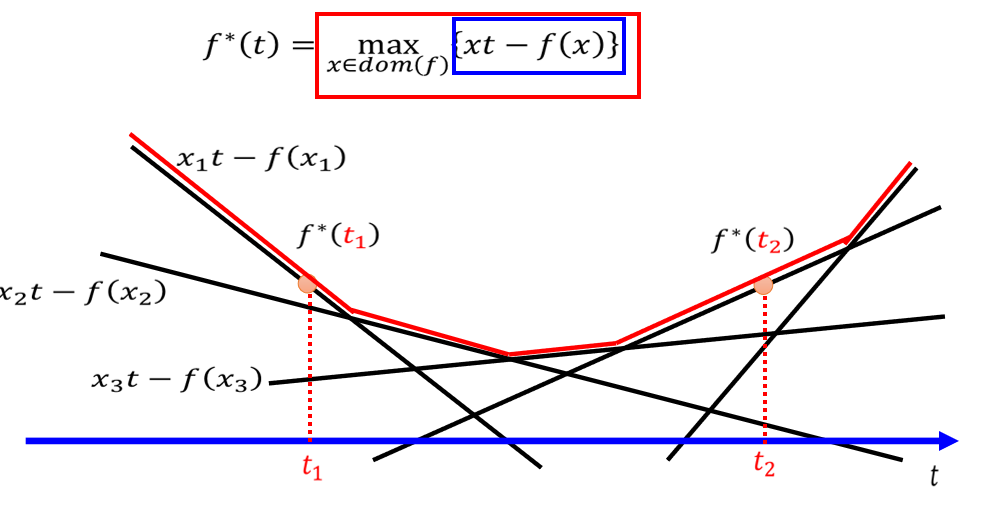
上面的红线无论你如何画,最后都是convex的。
看个例子,假设: f ( x ) = x l o g x f(x) = xlogx f(x)=xlogx,把 x = 0.1 , x = 1 , x = 10 x=0.1,x=1,x=10 x=0.1,x=1,x=10带入,结果如图所示:
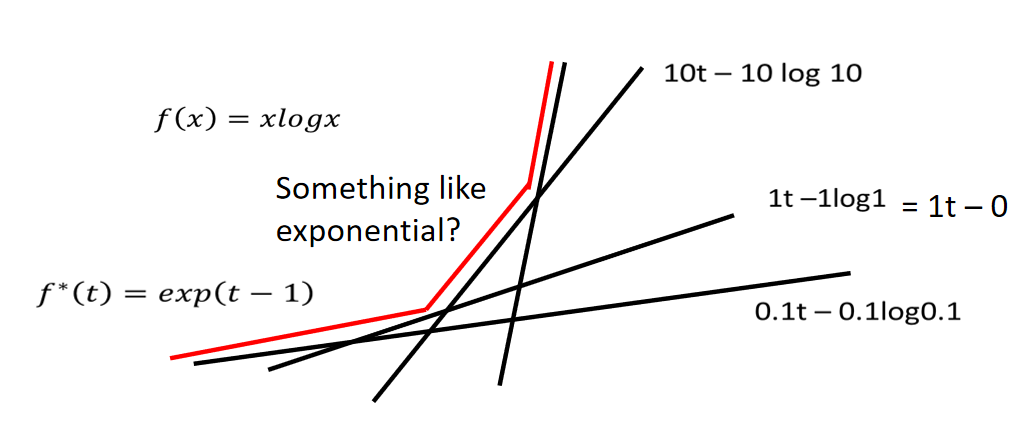
红线最后接近:
f
∗
(
t
)
=
e
t
−
1
f^*(t) = e^{t-1}
f∗(t)=et−1
下面是数学证明:
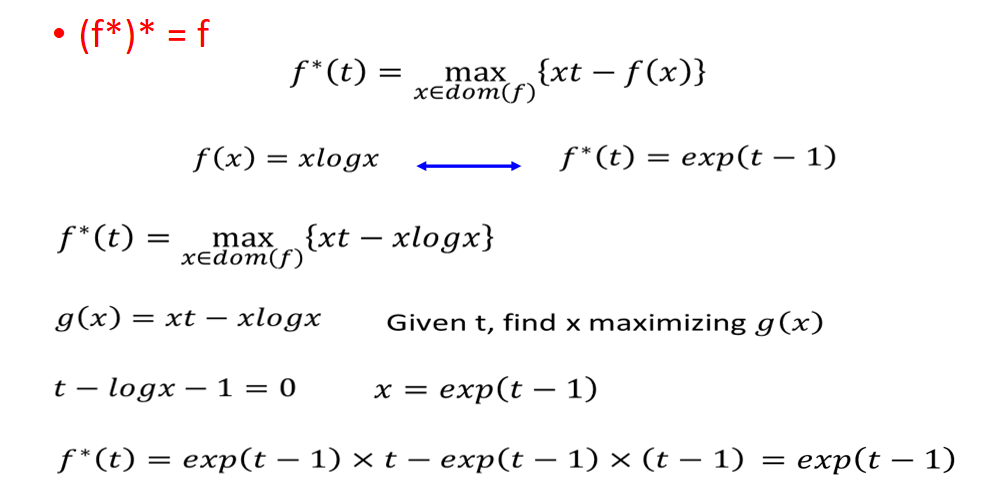
假设
f
(
x
)
=
x
l
o
g
x
f(x) = xlogx
f(x)=xlogx,则:
f
∗
(
t
)
=
max
x
∈
d
o
m
(
f
)
{
x
t
−
f
(
x
)
}
=
max
x
∈
d
o
m
(
f
)
{
x
t
−
x
l
o
g
x
}
f^*(t) = \max\limits_{x∈dom(f)}\{xt-f(x)\} = \max\limits_{x∈dom(f)}\{xt-xlogx\}
f∗(t)=x∈dom(f)max{xt−f(x)}=x∈dom(f)max{xt−xlogx}
令上式中
x
t
−
x
l
o
g
x
=
g
(
x
)
xt-xlogx = g(x)
xt−xlogx=g(x),给一个t,求得最大的g(x)
如何求呢?求极值,就是用g(x)对x进行求导等于0:
g
′
(
x
)
=
t
−
l
o
g
x
−
1
=
0
=
>
x
=
e
t
−
1
g'(x) = t-logx - 1 = 0 \ \ \ => \ \ \ x=e^{t-1}
g′(x)=t−logx−1=0 => x=et−1
把上面内容代入公式
f
∗
(
t
)
f^*(t)
f∗(t) :
f
∗
(
t
)
=
x
t
−
x
l
o
g
x
=
e
t
−
1
×
t
−
e
t
−
1
×
(
t
−
1
)
=
e
t
−
1
f^*(t) = xt- xlogx = e^{t-1}×t-e^{t-1}×(t-1) = e^{t-1}
f∗(t)=xt−xlogx=et−1×t−et−1×(t−1)=et−1
一般化后:
(
f
∗
)
∗
=
f
(f^*)^* = f
(f∗)∗=f
对于共轭函数,还有一个性质,就是共轭函数是相互的,也就是对每一对共轭函数来说,有:
f
∗
(
t
)
=
max
x
∈
d
o
m
(
f
)
{
x
t
−
f
(
x
)
}
←
→
f
(
x
)
=
max
t
∈
d
o
m
(
f
)
{
x
t
−
f
∗
(
t
)
}
f^*(t) = \max\limits_{x∈dom(f)}\{xt-f(x)\} ←→f(x) = \max\limits_{t∈dom(f)}\{xt-f^*(t)\}
f∗(t)=x∈dom(f)max{xt−f(x)}←→f(x)=t∈dom(f)max{xt−f∗(t)}
Connection with GAN
上面的内容到底和GAN有什么关系呢?
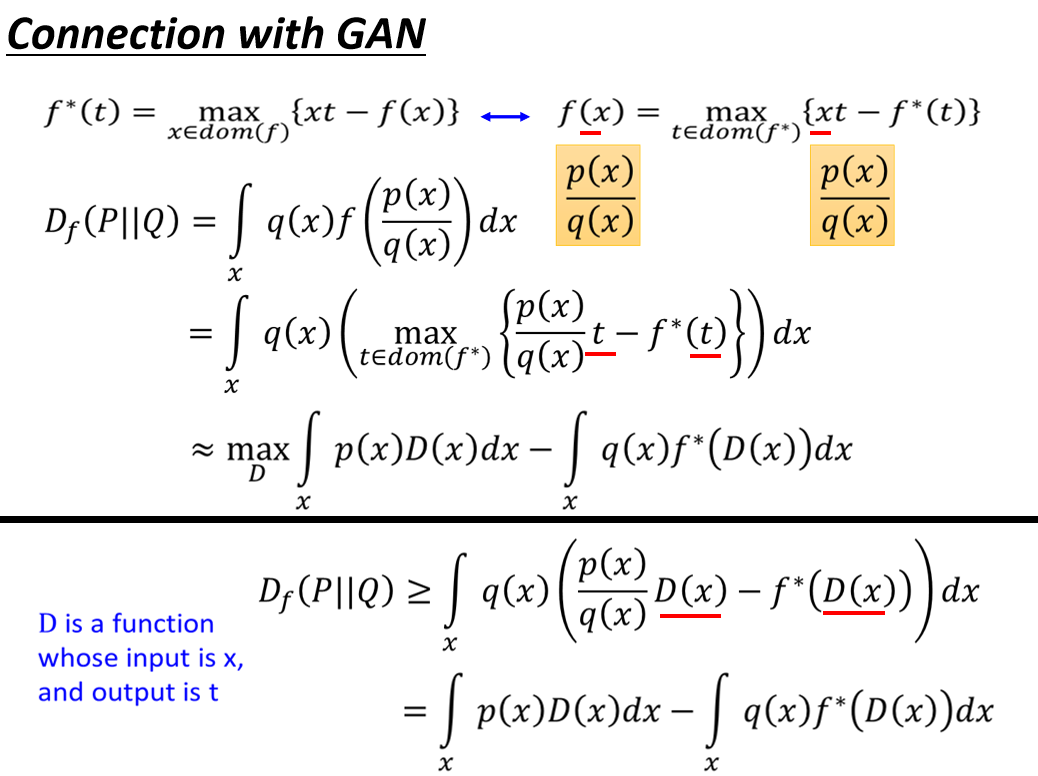
我们假设有一个divergence:
D
f
(
P
∣
∣
D
)
=
∫
x
q
(
x
)
f
(
p
(
x
)
q
(
x
)
)
d
x
=
∫
x
q
(
x
)
(
max
t
∈
d
o
m
(
f
∗
)
{
p
(
x
)
q
(
x
)
t
−
f
∗
(
t
)
}
)
d
x
D_f(P||D) = \int_xq(x)f(\frac{p(x)}{q(x)})dx = \int_xq(x)\left(\max\limits_{t∈dom(f^*)}\{\frac{p(x)}{q(x)}t-f^*(t)\}\right)dx
Df(P∣∣D)=∫xq(x)f(q(x)p(x))dx=∫xq(x)(t∈dom(f∗)max{q(x)p(x)t−f∗(t)})dx
接下来,我们学习一个function D,这个D的输入是x, 输出是t,我们将t用D(x)替代,同时我们去掉max的概念,改为
≥
≥
≥ ,那么上式可改写为:
D
f
(
P
∣
∣
D
)
≥
∫
x
q
(
x
)
(
p
(
x
)
q
(
x
)
D
(
x
)
−
f
∗
(
D
(
x
)
)
)
d
x
=
∫
x
p
(
x
)
D
(
x
)
d
x
−
∫
x
q
(
x
)
f
∗
(
D
(
x
)
)
d
x
D_f(P||D) ≥ \int_xq(x)\left(\frac{p(x)}{q(x)}D(x)-f^*\left(D(x)\right)\right)dx = \int_xp(x)D(x)dx-\int_xq(x)f^*(D(x))dx
Df(P∣∣D)≥∫xq(x)(q(x)p(x)D(x)−f∗(D(x)))dx=∫xp(x)D(x)dx−∫xq(x)f∗(D(x))dx
那么其实相当于:
D
f
(
P
∣
∣
D
)
≈
max
D
∫
x
p
(
x
)
D
(
x
)
d
x
−
∫
x
q
(
x
)
f
∗
(
D
(
x
)
)
d
x
D_f(P||D) ≈ \max\limits_D\int_xp(x)D(x)dx - \int_xq(x)f^*(D(x))dx
Df(P∣∣D)≈Dmax∫xp(x)D(x)dx−∫xq(x)f∗(D(x))dx
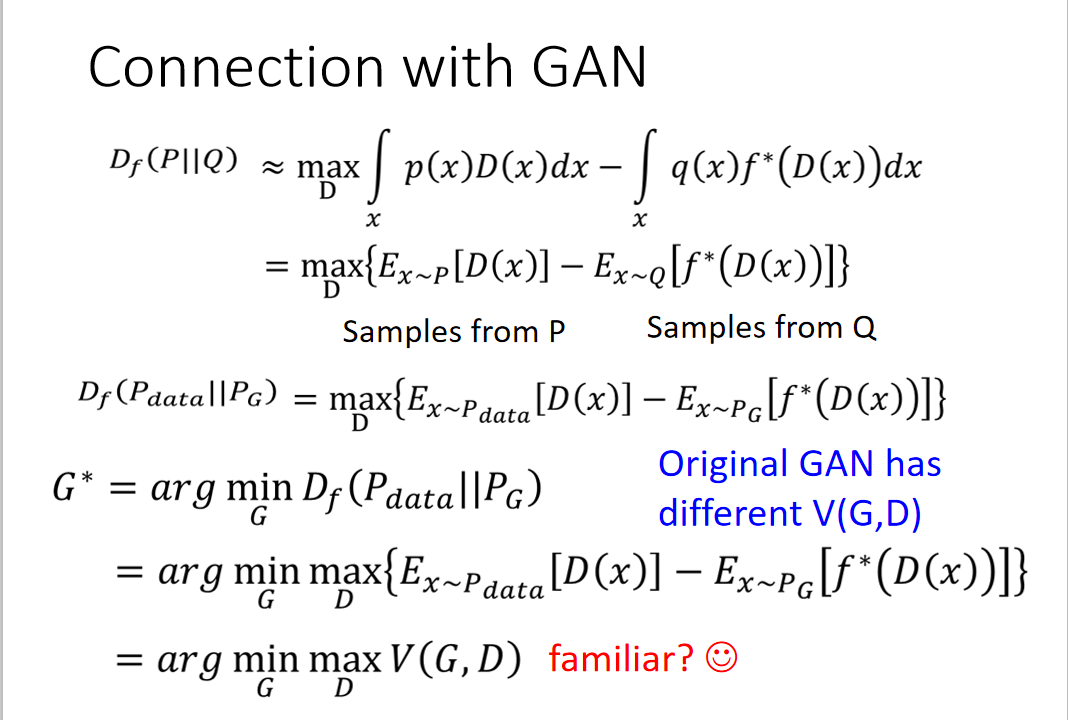
上面这个公式,我们把它改写一下:
D
f
(
P
∣
∣
D
)
=
max
D
{
E
x
∼
P
[
D
(
x
)
]
−
E
x
∼
Q
[
f
∗
(
D
(
x
)
)
]
}
D_f(P||D) = \max\limits_D\left\{ E_{x \sim P}[D(x)] - E_{x\sim Q}[f^*(D(x))] \right\}
Df(P∣∣D)=Dmax{Ex∼P[D(x)]−Ex∼Q[f∗(D(x))]}
我们令
P
=
P
d
a
t
a
,
Q
=
P
G
P=P_{data},Q=P_G
P=Pdata,Q=PG ,那么
P
d
a
t
a
,
P
G
P_{data},P_G
Pdata,PG 的f-divergence就可以写成:
D
f
(
P
∣
∣
D
)
=
max
D
{
E
x
∼
P
d
a
t
a
[
D
(
x
)
]
−
E
x
∼
G
[
f
∗
(
D
(
x
)
)
]
}
D_f(P||D) = \max\limits_D\left\{ E_{x \sim P_{data}}[D(x)] - E_{x\sim G}[f^*(D(x))] \right\}
Df(P∣∣D)=Dmax{Ex∼Pdata[D(x)]−Ex∼G[f∗(D(x))]}
这个
f
∗
f^*
f∗ 取决于f-divergence是什么。
这个式子怎么看起来好像GAN需要minimize的目标呢?在机器学习-35-Theory behind GAN(GAN背后的数学理论) 我们提到了GAN的训练目标是
G
∗
=
a
r
g
min
G
D
f
(
P
d
a
t
a
∣
∣
P
G
)
G^* = arg \min\limits_GD_f(P_{data}||P_G)
G∗=argGminDf(Pdata∣∣PG),我们把GAN的训练目标展开,就是:
G
∗
=
a
r
g
min
G
D
f
(
P
d
a
t
a
∣
∣
P
G
)
=
a
r
g
min
G
max
D
{
E
x
∼
P
d
a
t
a
[
D
(
x
)
]
−
E
x
∼
P
G
[
f
∗
(
D
(
x
)
)
]
}
=
a
r
g
min
G
max
D
V
(
G
,
D
)
\begin{aligned} G^* = &arg \min\limits_GD_f(P_{data}||P_G)\\ =& arg \min\limits_G\max\limits_D\{E_{x\sim P_{data}}[D(x)]-E_{x\sim P_G}[f^*(D(x))]\} \\ =& arg \min\limits_G \max\limits_D V(G,D) \end{aligned}
G∗===argGminDf(Pdata∣∣PG)argGminDmax{Ex∼Pdata[D(x)]−Ex∼PG[f∗(D(x))]}argGminDmaxV(G,D)
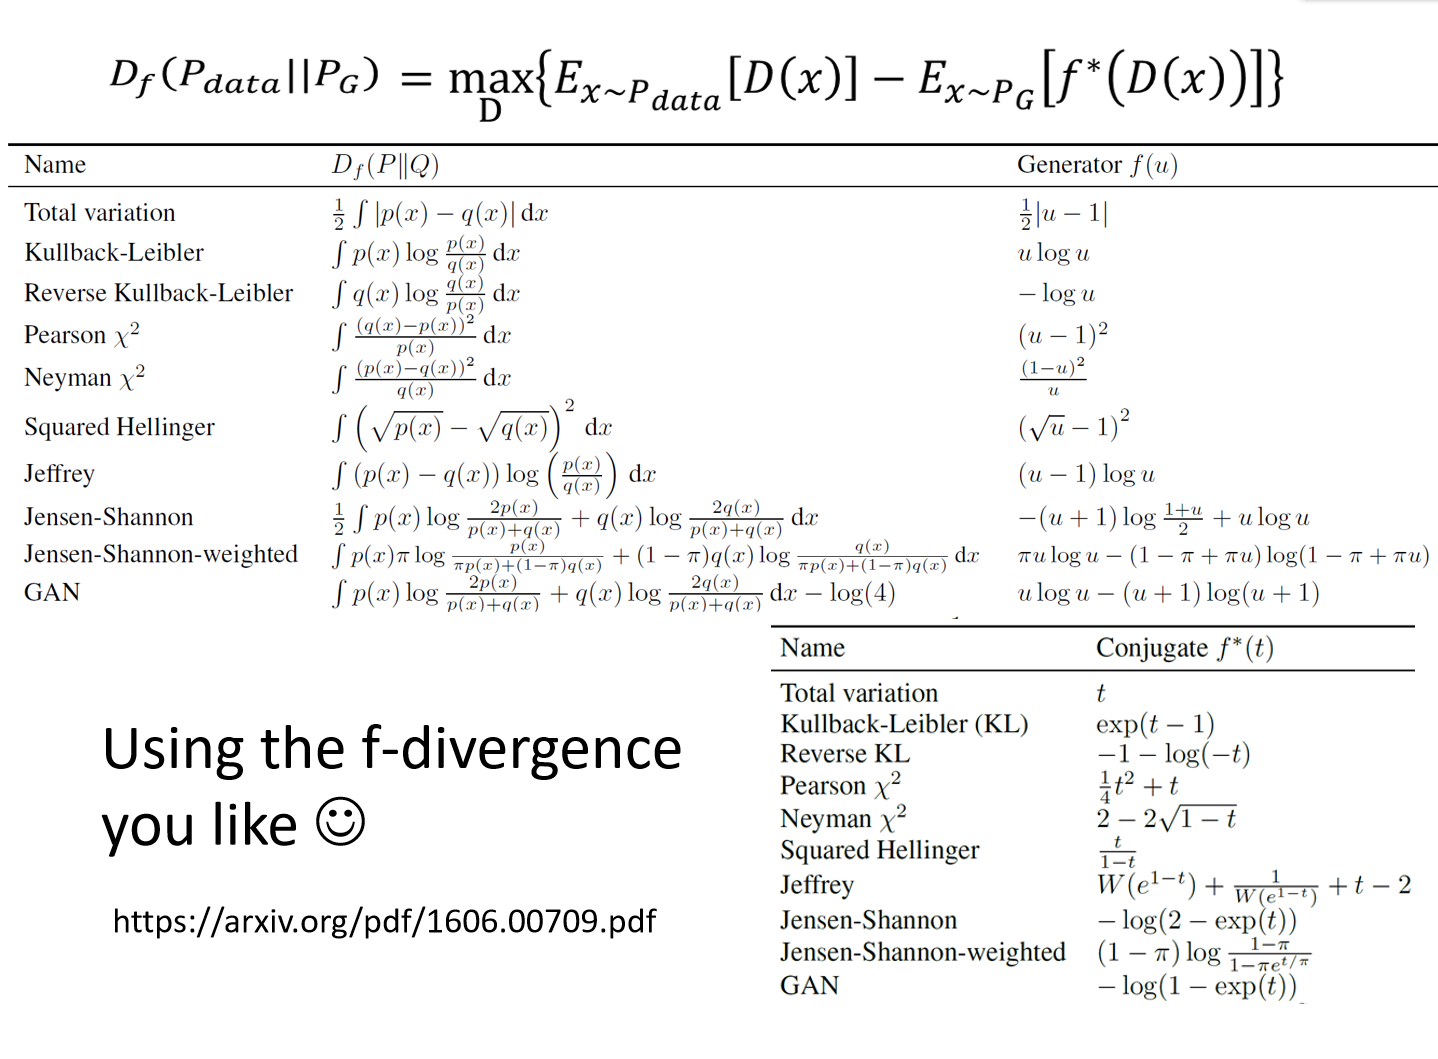
所以你可以选用不同的f-divergence,优化不同的divergence,论文里面给了个清单,你可以自己选:
那么使用不同的divergence会有什么用处吗?它可能能够用于解决GAN在训练过程中会出现的一些问题(众所周知GAN难以训练)
GAN训练过程中可能产生的问题
Mode Collapse
介绍
这个概念是GAN难以训练的原因之一,它指的是GAN产生的样本单一,认为满足某一分布的结果为True,其余为False。如下图,原始数据分布的范围要比GAN训练的结果大得多。从而导致generator训练出来的结果可能都差不多,图片差异性不大。
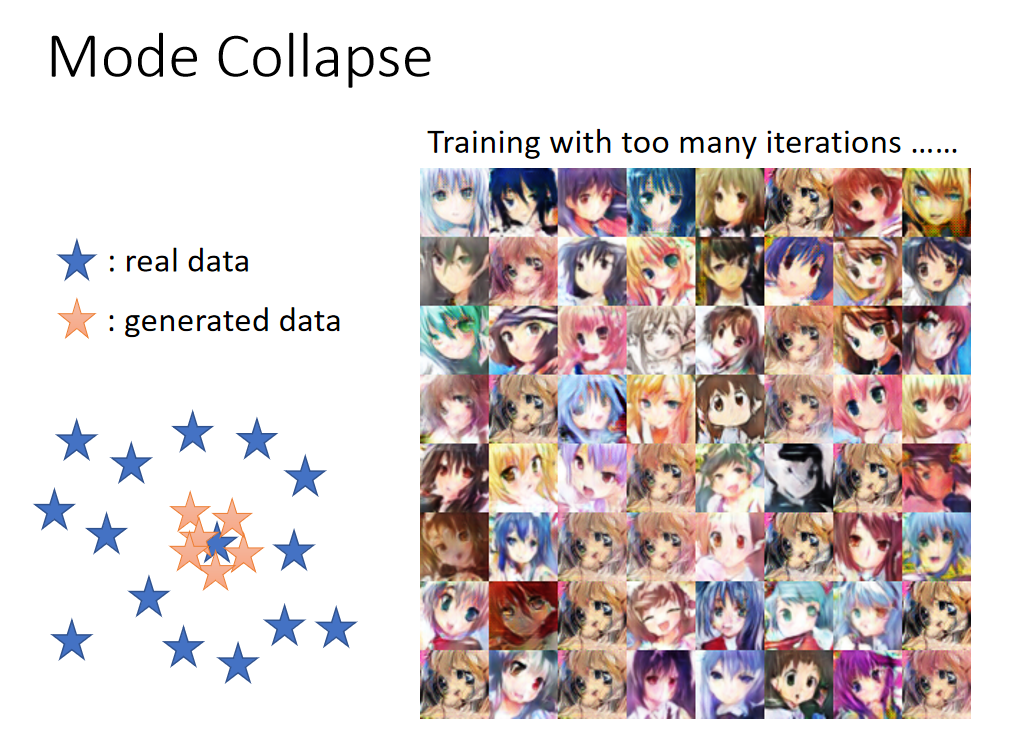
当我们的GAN模型Training with too many iterations……
有些人脸就会比较像,除了一些颜色不太一样
解决办法
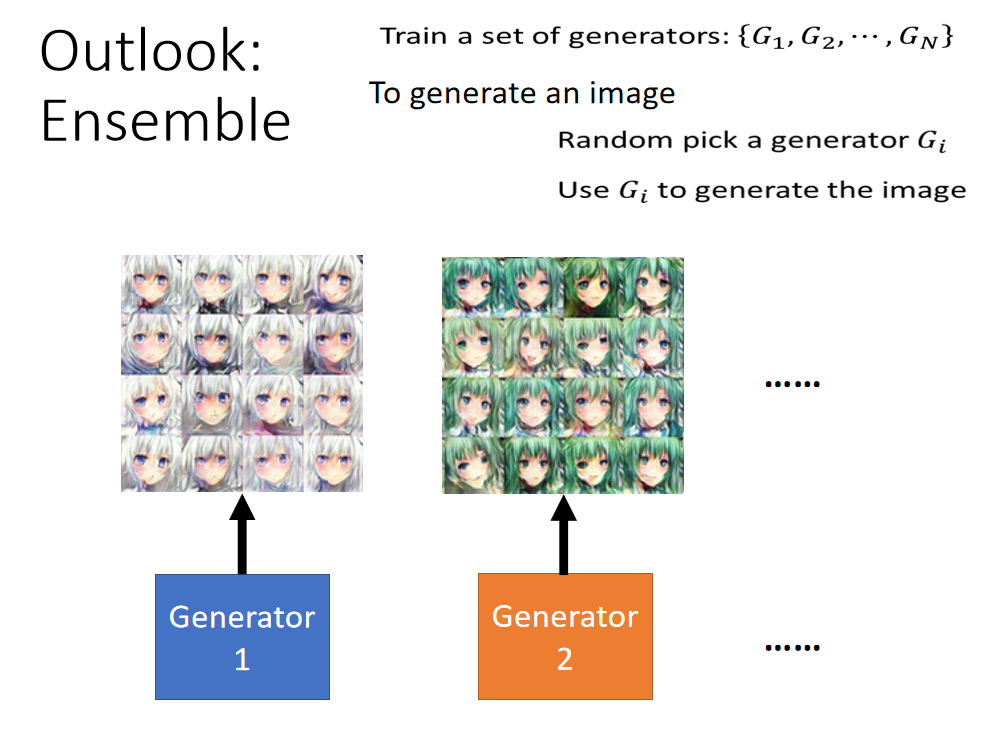
对于mode collapse到底有没有一些更加通用的解决办法呢?你可以用ensemble的方法,其实就是训练多个Generator,然后在使用的时候随机挑一个generator来生成结果,当然是一个很流氓的招数,看你用到哪里了…
Mode Dropping
介绍
这个问题从字面上也好理解,假设原始分布有两个比较集中的波峰,而GAN有可能把分布集中在其中一个波峰,而抛弃掉了另一个,如下图:
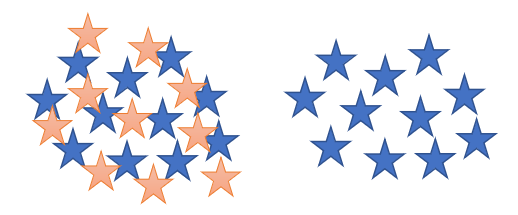
例如下面的人脸,一个循环只有白种人,一个循环只有黄种人,一个循环中只有黑人。
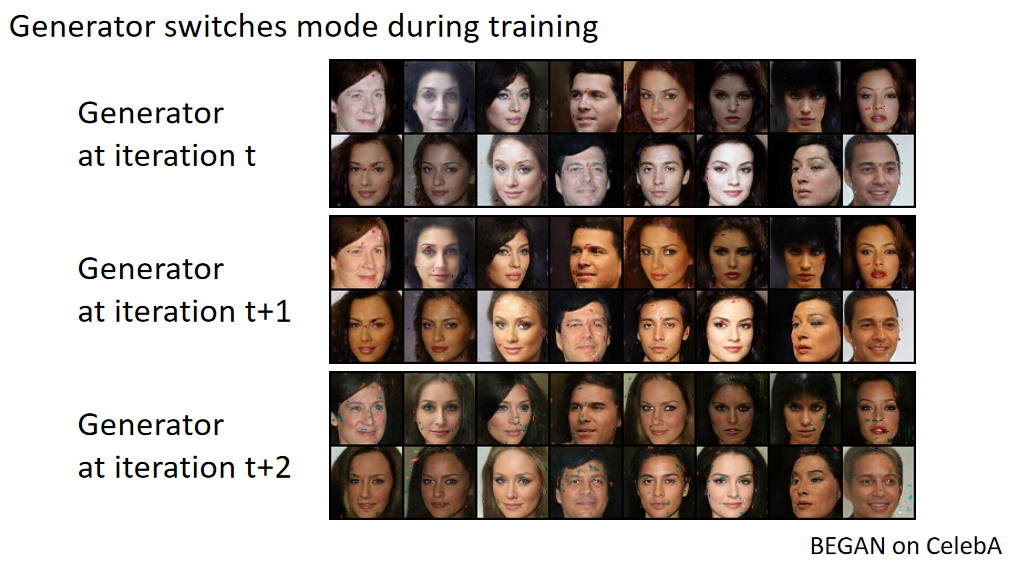
问题分析
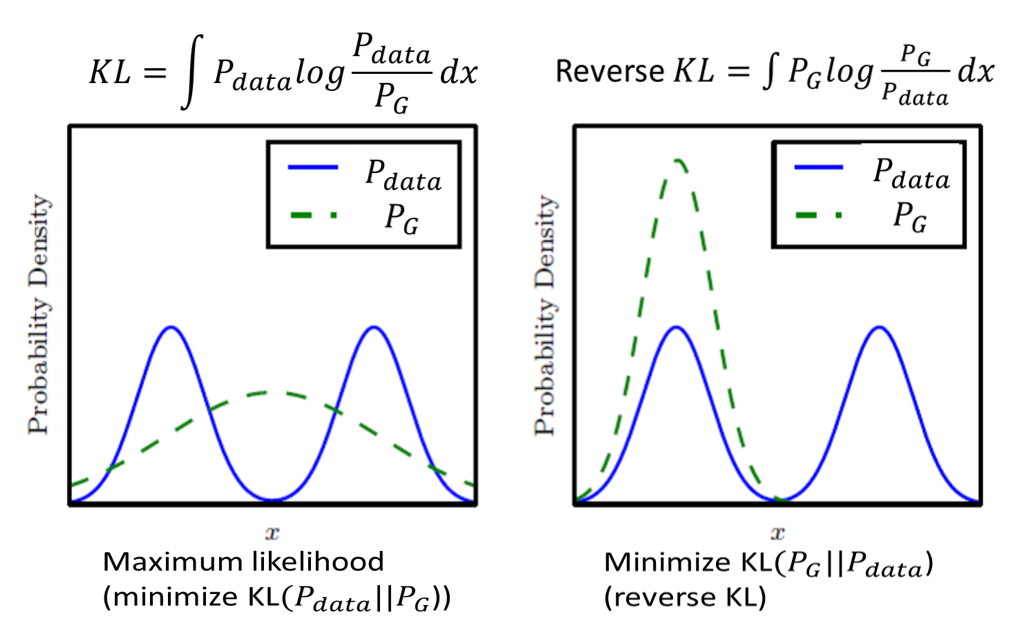
为什么会有这样的结果呢,一个猜测是divergence选得不好,选择不同的divergence,最后generator得到的distribution会不一样。如下图,minimize KL divergence和reverse KL divergence的时候,最后得到的分布是不一样的, 前者容易导致模糊的问题,后者则可能导致mode dropping。如果你觉得在训练过程中出现的mode collapse或者mode dropping是由于divergence导致的,你可以通过尝试更换 f ∗ f^* f∗ 来实验。当然不一定说就一定有效果,这里只是提供一种可能的猜测。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献6条内容

所有评论(0)