python爬虫之正则表达式抓取网页内部内容(抓取糗事百科段子案例)
·
正则表达式
安装正则表达式库:
pip install re
再杂乱的页面中提取出我们想要的文字,这里我们来使用正则表达式。
正则表达式是用来匹配字符串非常强大的工具,再其他编程语言中同样具有正则表达式的概念,利用正则表达式,我们可以非常简单的提取去我们想要的内容。
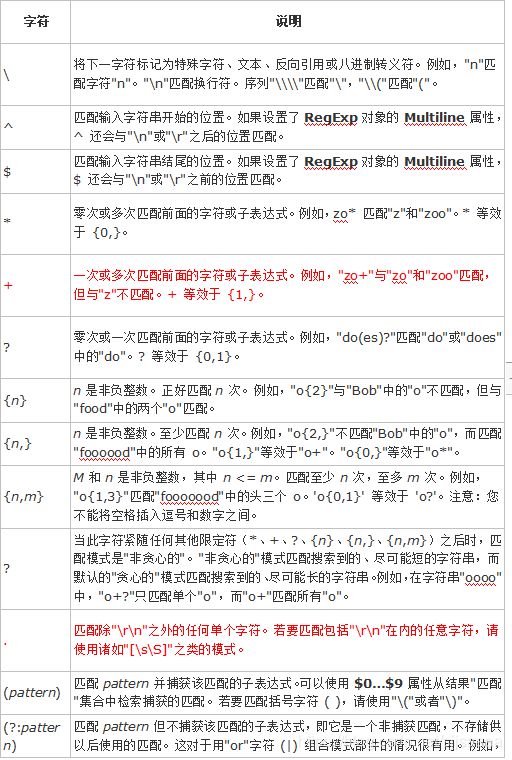
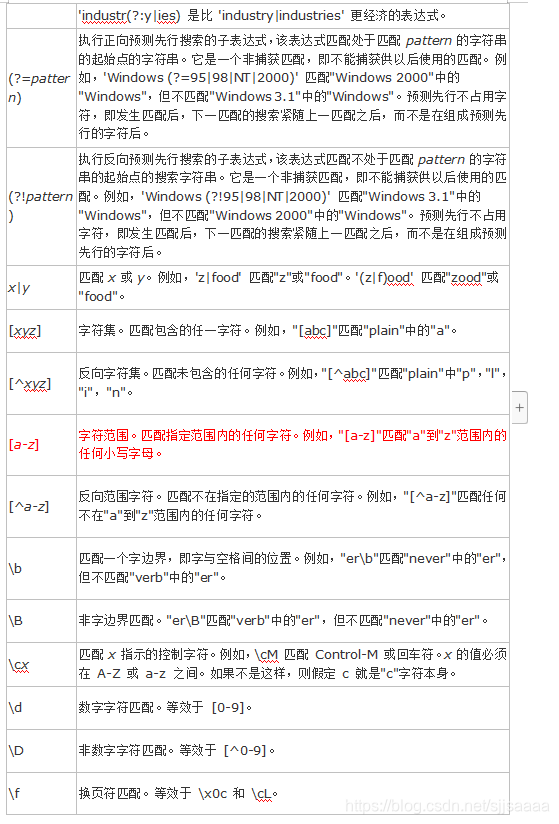
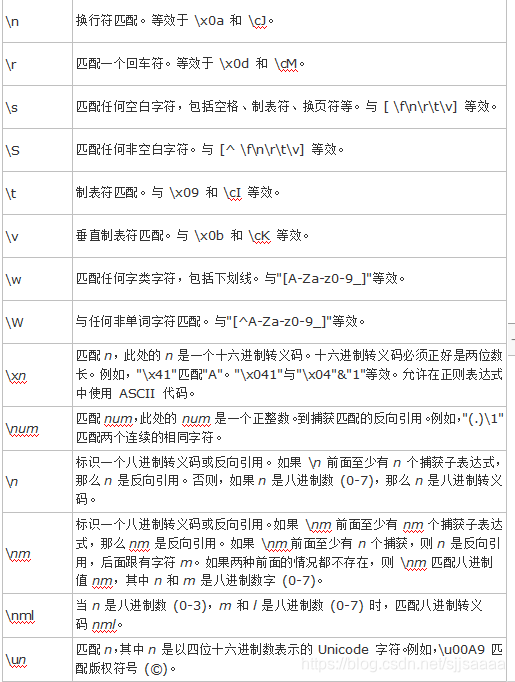
正则表达式的规则附后:正则语法下载地址
#提取中文:[\u4e00-\u9fa5]
#(.+) 提取的内容
#\s* 多个换行
案例抓取内容如下(含源码):

一、相关解释
正则表达式的贪婪模式与非贪婪模式
例如:正则表达式”ab*" 如果用与查找"abbbc",将找到“abbb”,而如果使用非贪婪的数量词“ab*?",将找到”a".
常用的方法与案例
1.match()
import re
str = "I Study Python3.8 Everyday"
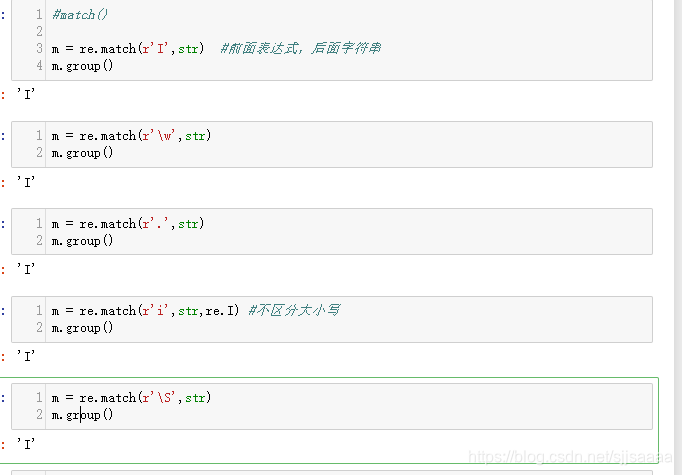
获取I:
m = re.match(r'I',str)  #前面表达式,后面字符串
m.group()

m = re.match(r'\w',str)
m.group()

m = re.match(r'.',str)
m.group()

m = re.match(r'i',str,re.I) #不区分大小写
m.group()

m = re.match(r'\S',str)
m.group()
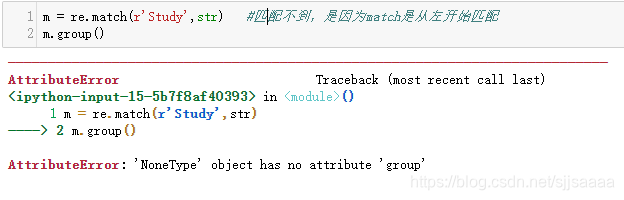
然后字符串却没匹配到,因为watch式从左开始匹配:
m = re.match(r'Study',str)   #匹配不到,是因为match是从左开始匹配
m.group()
2.search()
import re
str = "I Study Python3.8 Everyday"
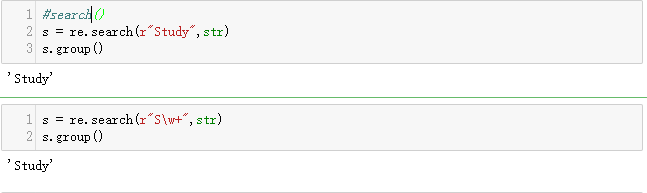
获取Study字符串:
s = re.search(r"Study",str)
s.group()

s = re.search(r"S\w+",str)
s.group()
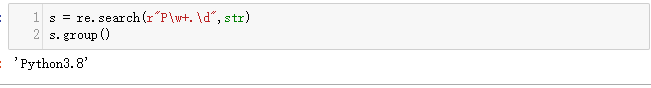
获取Python3.8:
s = re.search(r"P\w+.\d",str)
s.group()
3.findall()
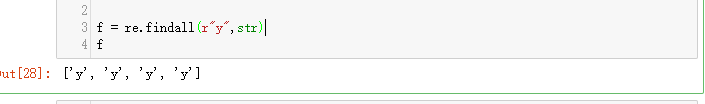
查找所有y:
f = re.findall(r"y",str)
f
4.test()
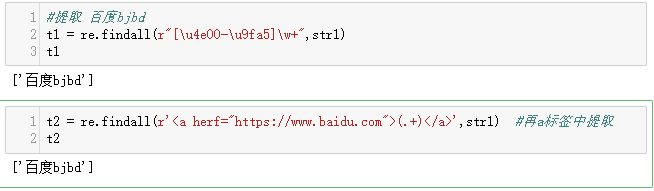
str1 = '<div><a herf="https://www.baidu.com">百度bjbd</a></div>'
提取 百度bjbd
t1 = re.findall(r"[\u4e00-\u9fa5]\w+",str1)
t1


t2 = re.findall(r'<a herf="https://www.baidu.com">(.+)</a>',str1)  #再a标签中提取
t2
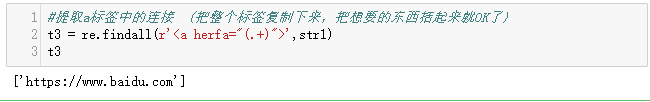
提取网站:
#提取a标签中的连接  (把整个标签复制下来,把想要的东西括起来就OK了)
t3 = re.findall(r'<a herf="(.+)">',str1)
t3
5.sub() 替换
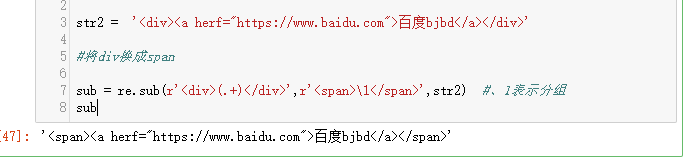
将div换成span:
str2 =  '<div><a herf="https://www.baidu.com">百度bjbd</a></div>'

#将div换成span

sub = re.sub(r'<div>(.+)</div>',r'<span>\1</span>',str2)  #、1表示分组
sub
二、提取糗事百科段子案例
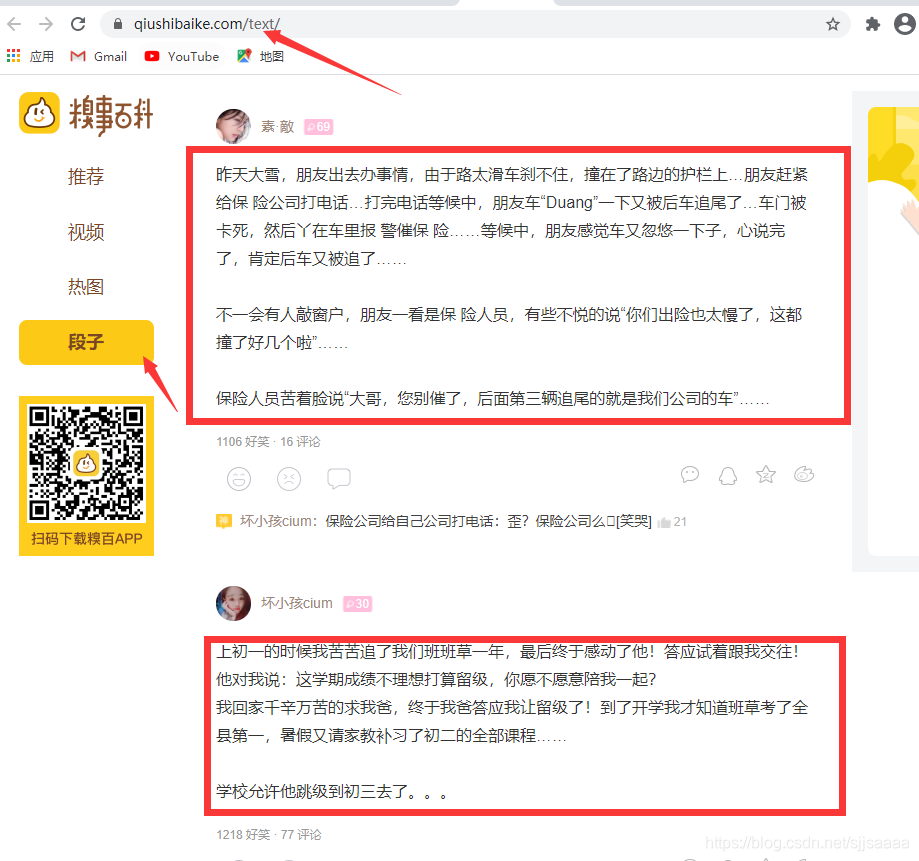
明确目标:
我们要爬取框框里面的内容。
首先把网页信息获取到:
#糗事百科案例

import requests
from fake_useragent import UserAgent
import re

url = "https://www.qiushibaike.com/text/"
headers = {"User-Agent":UserAgent().random}
#构造请求
response = requests.get(url,headers)
info = response.text
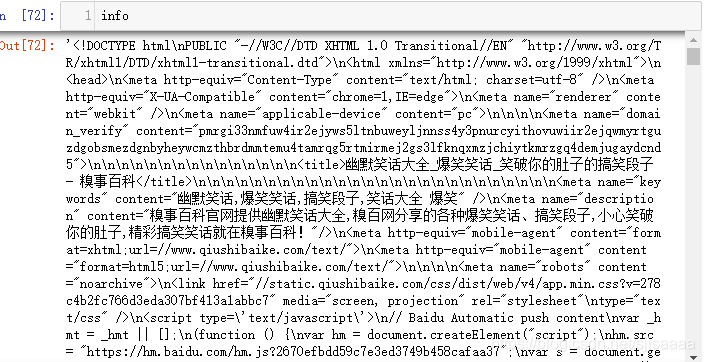
利用正则表达式提取出想要的文字部分
观察想要的部分:
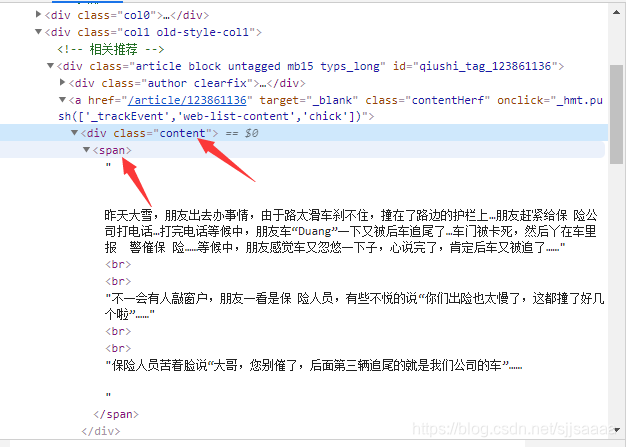
要提取的内容在,这个框框里面,首先要获取到div class="conunt,在用\s*匹配多个换行,在匹配到<span>在用\s*匹配多个换行,再用(.+)获取想要的内容,用\s*匹配多个换行在用</span>结束,这样就可以抓取到了想要的内容。
如下形式:<div class="content">\s*<span>\s*(.+)\s*</span>
	<div class="content">
	<span>


	昨天大雪,朋友出去办事情,由于路太滑车刹不住,撞在了路边的护栏上…朋友赶紧给保 险公司打电话…打完电话等候中,朋友车“Duang”一下又被后车追尾了…车门被卡死,然后丫在车里报  警催保 险……等候中,朋友感觉车又忽悠一下子,心说完了,肯定后车又被追了……<br><br>不一会有人敲窗户,朋友一看是保 险人员,有些不悦的说“你们出险也太慢了,这都撞了好几个啦”……<br><br>保险人员苦着脸说“大哥,您别催了,后面第三辆追尾的就是我们公司的车”……

	</span>

	</div>
匹配文字代码:
infos = re.findall(r'<div class="content">\s*<span>\s*(.+)\s*</span>',info)
infos
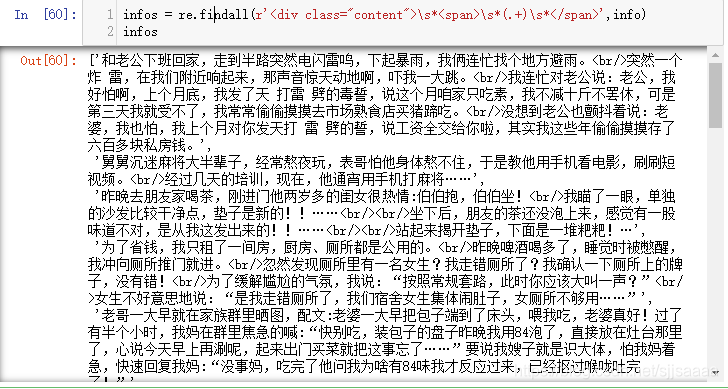
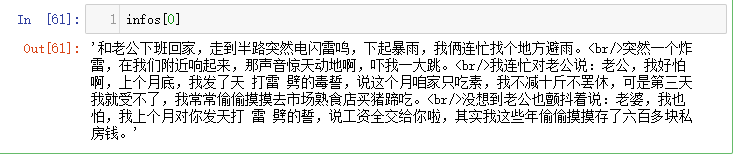
将匹配的文字保存起来:
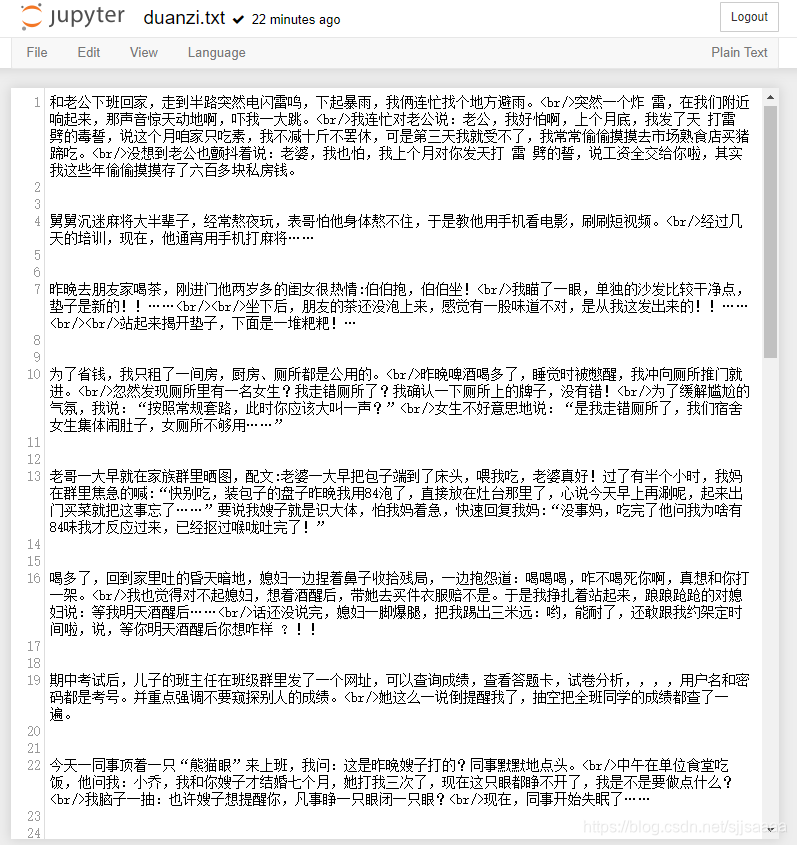
with open('duanzi.txt','w',encoding='utf-8') as f:
    for i in infos:
        f.write(i+"\n\n\n")

抓取成功!
爬取用户名:
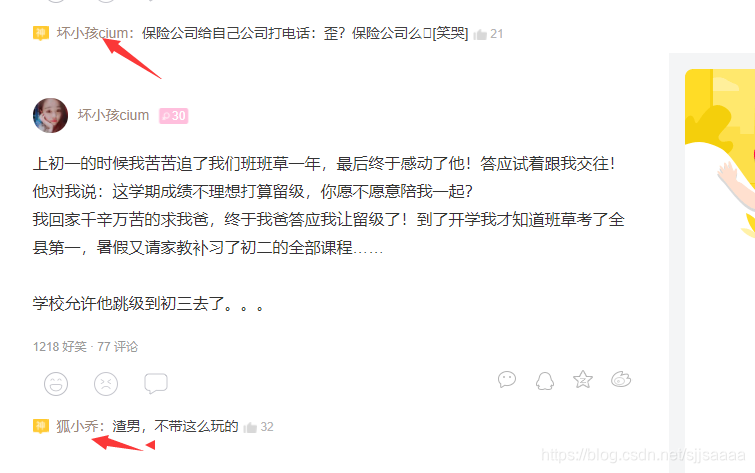
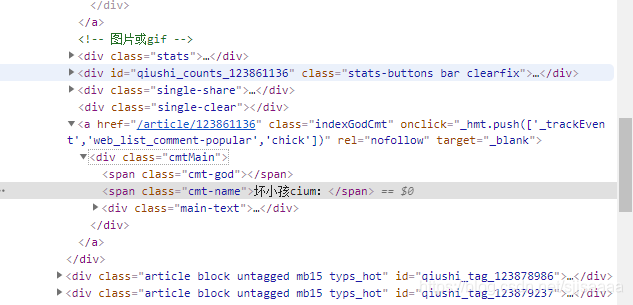
可以发现他的位置:
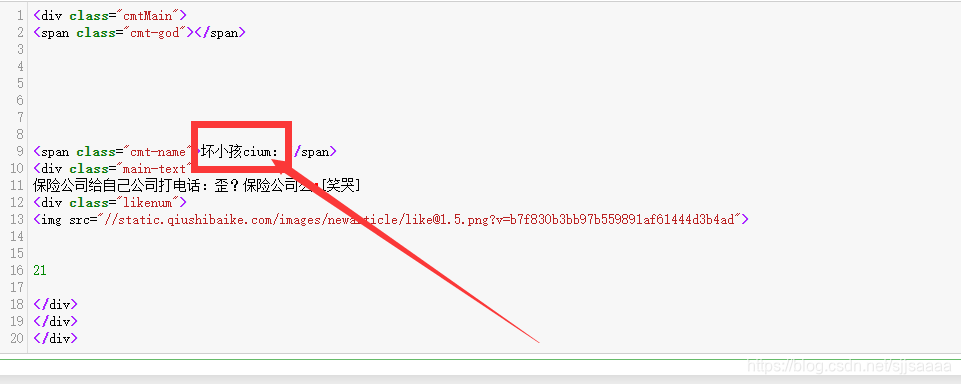
所以表达式为:
infos = re.findall(r'<div class="cmtMain">\s*<span class="cmt-god"></span>\s*<span class="cmt-name">(.+)</span>',info)
infos
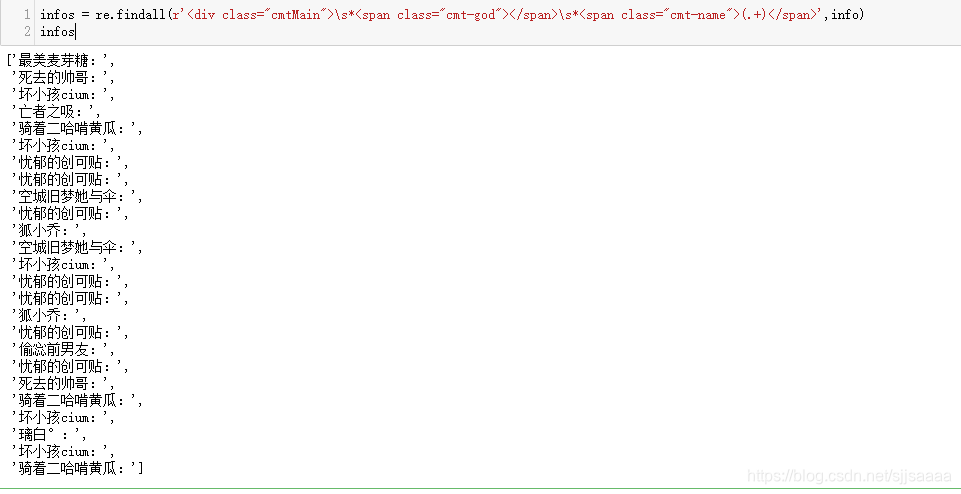
成功!多尝试就会有结果。
三、正则表达式语法:

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 1
 0
- 0


 已为社区贡献11条内容

所有评论(0)