

一、爬虫是什么?
1、什么是互联网?
互联网是由网络设备(网线,路由器,交换机,防火墙等等)和一台台计算机连接而成,像一张网一样。
2、互联网建立的目的?
互联网的核心价值在于数据的共享/传递:数据是存放于一台台计算机上的,而将计算机互联到一起的目的就是为了能够方便彼此之间的数据共享/传递,否则你只能拿U盘去别人的计算机上拷贝数据了。
3、什么是上网?爬虫要做的是什么?
我们所谓的上网便是由用户端计算机发送请求给目标计算机,将目标计算机的数据下载到本地的过程。
3.1 只不过,用户获取网络数据的方式是:
浏览器提交请求->下载网页代码->解析/渲染成页面。
3.2 而爬虫程序要做的就是:
模拟浏览器发送请求->下载网页代码->只提取有用的数据->存放于数据库或文件中
3.1与3.2的区别在于:
我们的爬虫程序只提取网页代码中对我们有用的数据
4、总结爬虫
4.1 爬虫的比喻:
如果我们把互联网比作一张大的蜘蛛网,那一台计算机上的数据便是蜘蛛网上的一个猎物,而爬虫程序就是一只小蜘蛛,沿着蜘蛛网抓取自己想要的猎物/数据
4.2 爬虫的定义:
向网站发起请求,获取资源后分析并提取有用数据的程序
4.3 爬虫的价值:
互联网中最有价值的便是数据,比如天猫商城的商品信息,链家网的租房信息,雪球网的证券投资信息等等,这些数据都代表了各个行业的真金白银,
可以说,谁掌握了行业内的第一手数据,谁就成了整个行业的主宰,如果把整个互联网的数据比喻为一座宝藏,那我们的爬虫课程就是来教大家如何来高效地挖掘这些宝藏,
掌握了爬虫技能,你就成了所有互联网信息公司幕后的老板,换言之,它们都在免费为你提供有价值的数据。
二、爬虫的基本流程
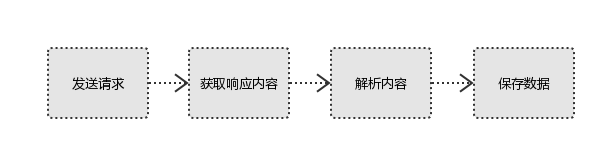
1、发起请求
使用http库向目标站点发起请求,即发送一个Request
Request包含:请求头、请求体等
2、获取响应内容
如果服务器能正常响应,则会得到一个Response
Response包含:html,json,图片,视频等
3、解析内容
解析html数据:正则表达式,第三方解析库如Beautifulsoup,pyquery等
解析json数据:json模块
解析二进制数据:以b的方式写入文件
4、保存数据
数据库
文本.txt
三、请求与响应
  1 #http协议:http://www.cnblogs.com/haiyan123/p/7298967.html
  2
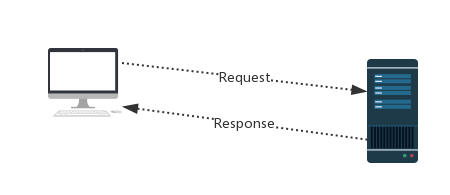
  3 #Request:用户将自己的信息通过浏览器(socket client)发送给服务器(socket server)
  4
  5 #Response:服务器接收请求,分析用户发来的请求信息,然后返回数据(返回的数据中可能包含其他链接,如:图片,js,css等)
  6
  7 #ps:浏览器在接收Response后,会解析其内容来显示给用户,而爬虫程序在模拟浏览器发送请求然后接收Response后,是要提取其中的有用数据。
四、Request
1、请求方式:
常用的请求方式:GET,POST
其他请求方式:HEAD,PUT,DELETE,OPTHONS
ps:用浏览器演示get与post的区别,(用登录演示post)
post与get请求最终都会拼接成这种形式:k1=xxx&k2=yyy&k3=zzz
post请求的参数放在请求体内:
可用浏览器查看,存放于form data内
get请求的参数直接放在url后
2、请求url
url全称统一资源定位符,如一个网页文档,一张图片
一个视频等都可以用url唯一来确定
url编码https://www.baidu.com/s?wd=图片 图片会被编码(看示例代码)
网页的加载过程是:
加载一个网页,通常都是先加载document文档,
在解析document文档的时候,遇到链接,则针对超链接发起下载图片的请求
3、请求头
User-agent:告诉它这是浏览器发过来的请求(请求头中如果没有user-agent客户端配置,服务端可能将你当做一个非法用户)务必加上
host
cookies:cookie用来保存登录信息
Referer:上一次的跳转路径
一般做爬虫都会加上请求头
4、请求体
如果是get方式,请求体没有内容
如果是post方式,请求体是format data
ps:
1、登录窗口,文件上传等,信息都会被附加到请求体内
2、登录,输入错误的用户名密码,然后提交,就可以看到post,正确登录后页面通常会跳转,无法捕捉到post
  1 import requests
  2 from urllib.parse import urlencode
  3
  4 # 请求方式
  5 kwords = input("请输入关键字:>>").strip()
  6 res = urlencode({"wd":kwords})      # 请求的url,当你在百度输入中文的时候,你把url拿下来会变成下面的这样格式的url,所以得urlencode一下
  7
  8 url ="https://www.baidu.com/s?"+res   #https://www.baidu.com/s?wd=%E5%9B%BE%E7%89%87 # 请求的url,当你在百度输入中文的时候,你把url拿下来会变成下面的这样格式的url
  9
 10 headers={"User-Agent": "Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.108 Safari/537.36"}	# 请求头
 11
 12 response = requests.get(url=url, headers=headers)
 13
 14 with open("a.html","w",encoding="utf-8") as f:
 15     f.write(response.text)
 16 # print(response.status_code)
 17
18 五、Response
  1 #1、响应状态
  2     200:代表成功
  3     301:代表跳转
  4     404:文件不存在
  5     403:权限
  6     502:服务器错误
  7
  8 #2、Respone header
  9     Location:跳转
 10     set-cookie:可能有多个,是来告诉浏览器,把cookie保存下来
 11
 12 #3、preview就是网页源代码
 13     最主要的部分,包含了请求资源的内容
 14     如网页html,图片
 15     二进制数据等
六、总结
  1 1、总结爬虫流程:
  2     爬取--->解析--->存储
  3
  4 2、爬虫所需工具:
  5     请求库:requests,selenium
  6     解析库:正则,beautifulsoup,pyquery
  7     存储库:文件,MySQL,Mongodb,Redis
  8
  9 3、爬虫常用框架:
 10     scrapy
七、例子
  1 import requests #pip3 install requests
  2 import re
  3 import hashlib
  4 import time
  5
  6 movie_path=r'C:\mp4'
  7
  8 def get_page(url):
  9     try:
 10         response=requests.get(url)
 11         if response.status_code == 200:
 12             return response.text
 13     except Exception:
 14         pass
 15
 16 def parse_index(index_page):
 17     urls=re.findall('class="items".*?href="(.*?)"',index_page,re.S)
 18     for url in urls:
 19         if not url.startswith('http'):
 20             url='http://www.xiaohuar.com'+url
 21         yield url
 22
 23 def parse_detail(detail_page):
 24     l=re.findall('id="media".*?src="(.*?)"',detail_page,re.S)
 25     if l:
 26         movie_url=l[0]
 27         if movie_url.endswith('mp4'):
 28             yield movie_url
 29
 30 def get_movie(url):
 31     try:
 32         response=requests.get(url)
 33         if response.status_code == 200:
 34             m=hashlib.md5()
 35             m.update(str(time.time()).encode('utf-8'))
 36             m.update(url.encode('utf-8'))
 37             filepath='%s\%s.mp4' %(movie_path,m.hexdigest())
 38             with open(filepath,'wb') as f:
 39                 f.write(response.content)
 40                 print('%s 下载成功' %url)
 41     except Exception:
 42         pass
 43
 44 def main():
 45     base_url='http://www.xiaohuar.com/list-3-{page_num}.html'
 46     for i in range(5):
 47         url=base_url.format(page_num=i)
 48         index_page=get_page(url)
 49         detail_urls=parse_index(index_page)
 50         for detail_url in detail_urls:
 51             detail_page=get_page(detail_url)
 52             movie_urls=parse_detail(detail_page)
 53             for movie_url in movie_urls:
 54                 get_movie(movie_url)
 55
 56 if __name__ == '__main__':
 57     main()
 58
59 归类 : python爬虫


 已为社区贡献2条内容

所有评论(0)