大数据面试大保健(6) | Hive相关总结
·
- Hive的架构
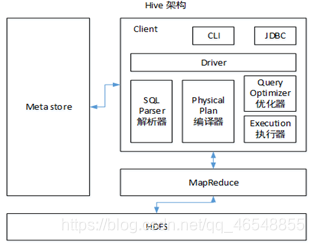
mr引擎:基于磁盘,计算时间比较长,但是能算出结果
生产环境(周指标,月指标,年指标)
tez引擎:基于内存,计算速度快,如果宕机,数据直接丢掉
生产环境(临时调试,容易oom)
spark引擎:基于内存和磁盘
生产环境(每天的定时任务)
- hive与mysql的区别
                  hive               mysql
数据量大小          大                  小
速度              数据量大/快         数据量小/快
擅长              查询               增删改查
- 内部表和外部表区别
元数据,原始数据
删除数据时:
内部表:元数据,原始数据全部删除
外部表:只删除元数据
在公司生产环境下,什么时候创建内部表,什么时候创建外部表?
在公司中绝大多数场景都是外部表
自己使用的临时表,才会创建内部表;
- 4个by
 order by     全局排序
 sort by      排序
 Distrbute By 分区
 Cluster By   排序和分区字段相同时使用
 在生产环境order by用的多吗?    京东 oom  40-50t内存
 sort by+Distrbute By 在生产环境用的最多,分区内排序
 Cluster By 比较少
- 函数
系统函数
日   date_add date_sub
周   next_day
月   date_fomat last_day
解析 json  get_json_object
自定义函数
UDF/UDTF(hive)/UDAF(spark)
在项目中UDF解析公共字段
在项目中UDTF解析的事件字段
如果项目不用自定义UDF,UDTF能解析吗?
可以使用系统函数get_json_object
用系统函数能解决,为什么还要自定义?
自定义函数更灵活,方便调试bug
自定义UDF步骤?
定义类,继承UDF,重启里面evaluate方法
自定义UDTF步骤
定义类,继承GenericUDTF,重写3个方法  初始化,process,关闭
打包=》 上传到集群 =》 在hive里面创建永久函数
窗口函数
rank
over
手写topn
- 优化
1.mapjoin默认打开,不要关闭;
2.行列过滤
join where =》 where join
3.创建分区表
分桶(对数据不太清楚,采样)
4.小文件
combineHiveInputformat  减少切片,进而减少Maptask
开启JVM重用
merge map-only任务,默认功能打开
MapReduce任务,需要打开merger任务
执行完任务之后,会将小于16m的文件,合并到256m(hive的块大小是按256m算的)
5.合理设置map个数和reduce个数
map个数怎么设置?   切片  max(0,min(块大小,Long的最大值))
128m数据对应1g内
在设置Reduce个数的时候也需要考虑这两个原则:处理大数据量利用合适的Reduce数;
使单个Reduce任务处理数据量大小要合适;
6.压缩
好处:减少磁盘空间,减少网络传输;
坏处:增加了压缩计算
7.采用列式存储
orc,parquet
提高压缩的比例  100g=>10g  5-6g
 id  name   age
1   zs     18
2   lisi   19
3   wangwu 20
行     1   zs   18    2    lisi     19
select age from user  随机读写
列   1  2   3   zs  lisi  wangwu   18  19  20   顺序读写
8.在map端开启combiner
set hive.map.aggr=true;
- Hive解决数据倾斜方法
1.数据倾斜长啥样?
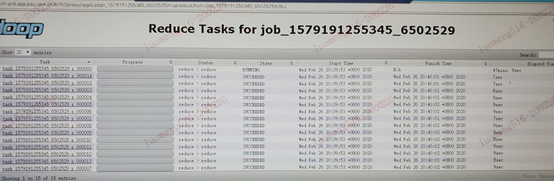
2.怎么产生的数据倾斜?
不同数据类型关联产生数据倾斜
情形:比如用户表中user_id字段为int,log表中user_id字段既有string类型也有int类型。当按照user_id进行两个表的Join操作时。
后果:处理此特殊值的reduce耗时;只有一个reduce任务
默认的Hash操作会按int型的id来进行分配,这样会导致所有string类型id的记录都分配到一个Reducer中。
解决方式:把数字类型转换成字符串类型
select * from users a
left outer join logs b
on a.usr_id = cast(b.user_id as string)
3.解决数据倾斜的方法?
(1)group by
注:group by 优于distinct group
解决方式:采用sum() group by的方式来替换count(distinct)完成计算。
(2)mapjoin
(3)开启数据倾斜时负载均衡
set hive.groupby.skewindata=true;
(4)控制空值分布
将为空的key转变为字符串加随机数或纯随机数,将因空值而造成倾斜的数据分不到多个Reducer。
注:对于异常值如果不需要的话,最好是提前在where条件里过滤掉,这样可以使计算量大大减少
实践中,可以使用case when对空值赋上随机值。此方法比直接写is not null更好,因为前者job数为1,后者为2.
使用case when实例1:
select userid, name from user_info a
join (
select case when userid is null  then  cast (rand(47)* 100000 as int )
else userid end from user_read_log
) b  on a.userid = b.userid
使用case when实例2:
select  '${date}' as thedate,
    a.search_type,
    a.query,
    a.category,
    a.cat_name,
    a.brand_id,
    a.brand_name,
    a.dir_type,
    a.rewcatid,
    a.new_cat_name,
    a.new_brand_id,
    f.brand_name as new_brand_name,
    a.pv,
    a.uv,
    a.ipv,
    a.ipvuv,
    a.trans_amt,
    a.trans_num,
    a.alipay_uv
from fdi_search_query_cat_qp_temp a
left outer join brand f
on  f.pt='${date}000000' and case when a.new_brand_id is null then concat('hive',rand() ) else a.new_brand_id end = f.brand_id;
如果上述的方法还不能解决,比如当有多个JOIN的时候,建议建立临时表,然后拆分HIVE SQL语句。
- 用的是动态分区吗?动态分区的底层原理是什么?
静态分区
insert overwrite table1 partition(dt="2020-09-28")
select
   age,
   name
from user;
动态分区(自己传参数)
insert overwrite table1 partition(dt)
select
   age,
   name,
   dt
from user;
a. 静态分区与动态分区的主要区别在于静态分区是手动指定,而动态分区是通过数据来进行判断。
b. 详细来说,静态分区的列是在编译时期,通过用户传递来决定的;动态分区只有在 SQL 执行时才能决定。
c. 动态分区是基于查询参数的位置去推断分区的名称,从而建立分区
- Hive里边字段的分隔符用的什么?为什么用\t?有遇到过字段里边有\t的情况吗,怎么处理的?
hive 默认的字段分隔符为ascii码的控制符\001(^A),建表的时候用fields terminated by '\001'
遇到过字段里边有\t的情况,自定义InputFormat,替换为其他分隔符再做后续处理

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献5条内容

所有评论(0)