Python爬虫之多线程练习——多线程爬取表情包详解
·
多线程爬取表情包详解
'''
需求:在斗图网爬取表情包并且保存
网址:
https://www.doutula.com/photo/list/?page=1
https://www.doutula.com/photo/list/?page=2
https://www.doutula.com/photo/list/?page=3
目标url形式为 url = 'https://www.doutula.com/photo/list/?page=%d'%i

步骤:
1)请求目标url,保存网页源代码
2)利用lxml模块,找到网页表情包图片的链接
3)读取和保存表情包图片
'''
1. 普通爬取表情包
# 1. 请求目标url,获取网页源码
import requests
def get_source(url):
    req = requests.get(url,headers=headers)
    req.encoding = 'utf-8'
    source = req.text
    return source
# 2. 利用lxml模块,找到网页表情包图片的代码
from lxml import etree

def get_img(source):
    html = etree.HTML(source)
    # 获取所有img标签的内容 并且把gif的图片过滤掉
    imgs = html.xpath('//div[@class="page-content text-center"]//img[@class != "gif"]')
    return imgs
# 3 读取和保存表情包图片
import os

def save_img(imgs):
    # 找到每一种图片链接和命名
    for img in imgs:
        img_url = img.get('data-original')  # 获取每张图片的链接
        alt = img.get('alt') # 获取图片的名字
        suffix = os.path.splitext(img_url)[1]  # 分割文件名后缀 http://img.doutula.com/production/uploads/image/2020/06/11/20200611878064_haoqtX.jpg  --> .jpg
        filename = alt + suffix   # 把图片的名字进行拼接
        # 读取和保存图片
        with open('img/' + filename, 'wb') as f:
            img_rep = requests.get(img_url)
            f.write(img_rep.content)
from time import *
if __name__ == '__main__':
    headers = {'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/79.0.3945.130 Safari/537.36'}
    # 计算整个过程耗用的时间
    start = time()

    for i in range(1, 2):
        # print(x)
        url = 'https://www.doutula.com/photo/list/?page=%d' % i
        source = get_source(url)
        imgs = get_img(source)
        save_img(imgs)

    end = time()
    print('程序共花费了:', end - start)
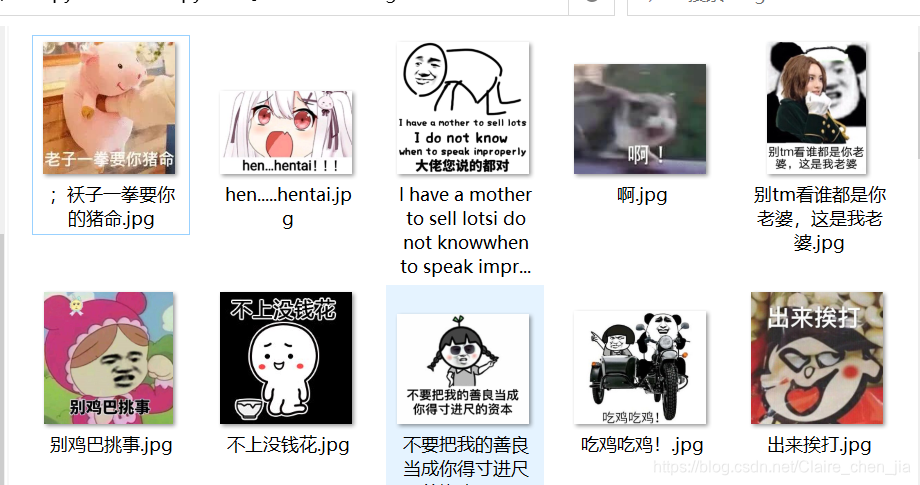
结果如下:

2.多线程爬取工作原理
多线程的相关知识可以看
python爬虫之多线程介绍(一)
python爬虫之多线程介绍(二)
多线程可以应用于爬虫,加快爬虫速度是爬虫过程我们会进行请求-读取-写入-保存的系列动作,常规情况下我们需要一连串的完成,但多线程可以在读取过程,也可以进行写入或者保存,不需要等上一个步骤完成(多线程适用于IO密集型的任务量(文件存储,网络通信))。
原理相当于生产者和消费者模式:生产者生成任务,消费者解决处理任务。比如在一个程序中,代码是按照重上往下执行,有的时候做等待的时间完全可以用来做任务处理或者做别的事情,为了节省时间,可以借助多线程的功能(自顾自完成自己线程任务)加上Queue队列特性(管道模式。里面存储数据,然后提供给线程处理)完成生产者和消费者模式。
此处多线程爬取表情包的为:
(1)创建1个网页的队列,保存网页的url
(2)生产者用网页的队列中取出url并进行请求,获取图片的url,图片的url保存到图片url的队列
(3)消费者从图片url的队列中取出图片url并进行读取下载
在这种情况下,可以利用queue存储数据,然后提供给线程处理、而多线程下也可以利用等待的时间做多件任务
3.多线程爬取表情包代码
# 导入模块
import requests
from lxml import etree
import os
from queue import Queue
import threading
import time
# 定义生产者对象:生产者用网页的队列中取出url并进行请求,获取图片的url,图片的url保存到图片url的队列
class Producer(threading.Thread):
    headers = {'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/70.0.3538.110 Safari/537.36'}

    # 初始化
    def __init__(self,page_queue,img_queue,*args,**kwargs):
        super().__init__(*args,**kwargs)
        self.page_queue = page_queue
        self.img_queue = img_queue

    # 创建子线程
    def run(self):
        while True:
            # 如果网页的队列没有数据就退出循环
            if self.page_queue.empty():
                break
            url = self.page_queue.get() # 拿到网页的url
            self.parse(url)

    # 请求目标url 内容并获取图片的url
    def parse(self,url):
        req = requests.get(url, headers=self.headers)
        req.encoding = 'utf-8'
        source = req.text
        html = etree.HTML(source)
        imgs = html.xpath('//div[@class="page-content text-center"]//img[@class != "gif"]')
        for img in imgs:
            img_url = img.get('data-original')  # 获取每张图片的链接
            alt = img.get('alt')  # 获取图片的名字
            suffix = os.path.splitext(img_url)[1]  # 分割文件名后缀 http://img.doutula.com/production/uploads/image/2020/06/11/20200611878064_haoqtX.jpg  --> .jpg
            filename = alt + suffix  # 把图片的名字进行拼接
            self.img_queue.put((img_url,filename))
# 定义消费者对象:消费者从图片url的队列中取出图片url并进行读取下载
class Consumer(threading.Thread):
    def __init__(self, page_queue, img_queue, *args, **kwargs):
        super().__init__(*args, **kwargs)
        self.page_queue = page_queue
        self.img_queue = img_queue

    def run(self):
        while True:
            # 如果网页的队列和图片的队列没有数据就退出循环
            if self.img_queue.empty() and self.page_queue.empty():
                break
            img_url,filename = self.img_queue.get()
            # 读取和保存图片
            with open('img/' + filename, 'wb') as f:
                img_rep = requests.get(img_url)
                f.write(img_rep.content)
                print(filename + ' 下载完成!')
def main():
    # 创建队列
    ## 创建网页队列,用来保存网页的url,最大数量为100
    page_queue = Queue(100)
    ## 创建图片队列,用来保存图片的url,最大数量为500
    img_queue = Queue(1000)  # 创建img下载队列

    for i in range(1, 101):  # 构建爬取url列表
        url = 'http://www.doutula.com/photo/list/?page=%d' % i
        page_queue.put(url)

    for x in range(5):
        t = Producer(page_queue, img_queue)
        t.start()

    for x in range(5):
        t = Consumer(page_queue, img_queue)
        t.start()


if __name__ == '__main__':
    start = time()
    main()
    end = time()
    print('程序共花费了:', end - start)

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献7条内容

所有评论(0)