【机器学习】 回归树
回归树是决策树(采用“分而治之”的策略处理问题的一种方法)的特例。
建模的因变量可以是数值型的,此时利用决策树处理回归问题;建模的因变量也可以是类别型的,此时利用决策树处理分类问题。决策树应用于回归问题时叫回归树,应用于分类问题时称为分类树。
【决策树的主要优点】:
- 模型具有可读性
- 预测的速度快
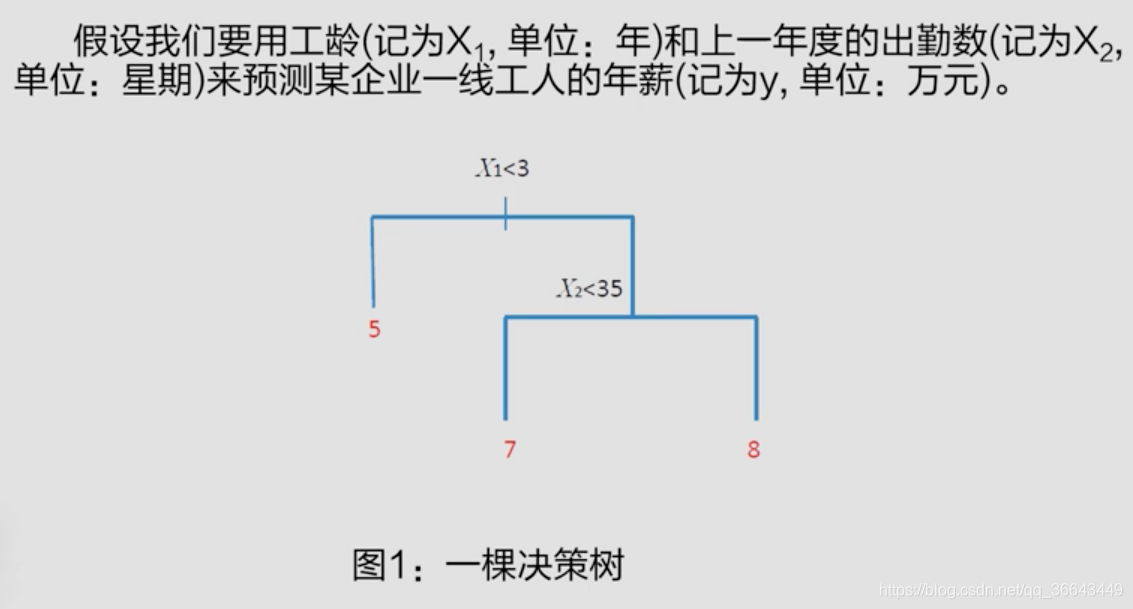
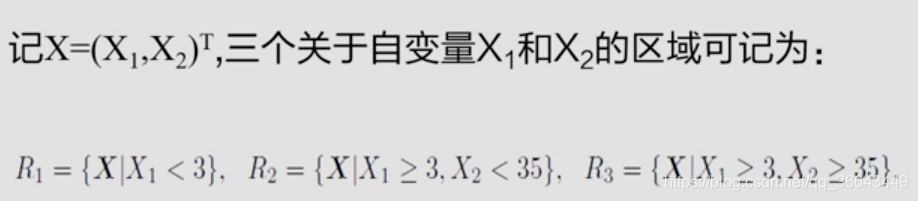
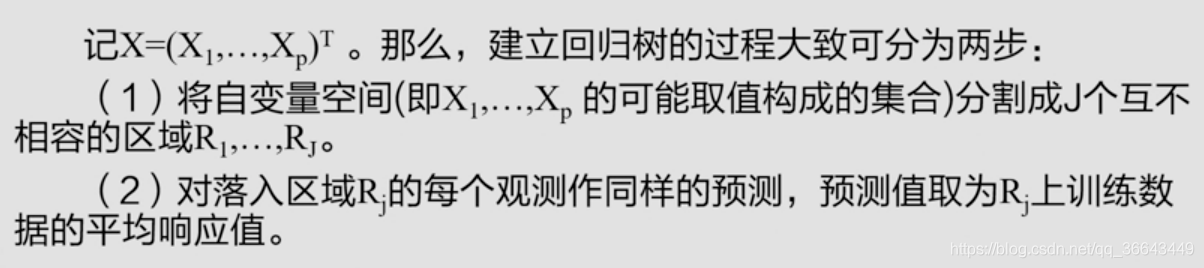
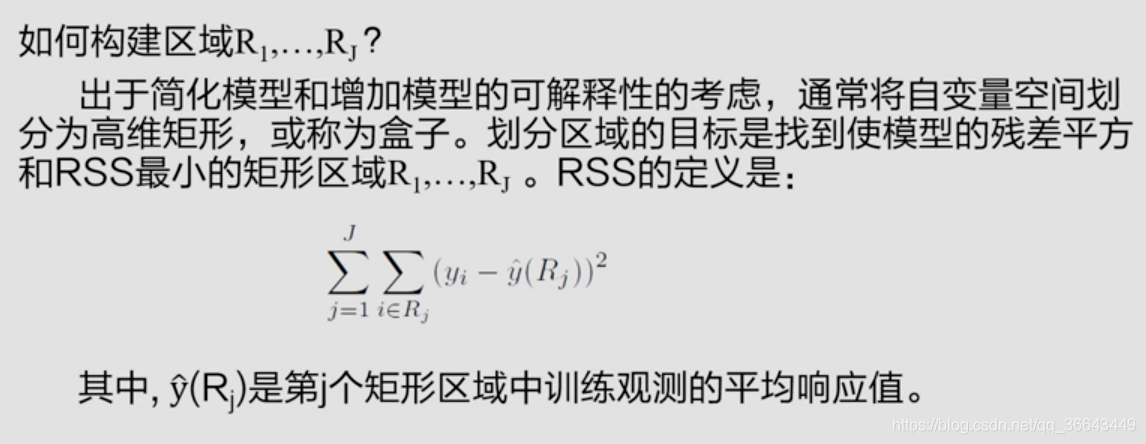
将自变量空间划分为J个矩形区域,一般采用一种自上而下、贪婪的方式:递归二叉分裂。自上而下指的是它从树的顶端开始依次分裂自变量空间,每个分裂点产生两个新的分支。贪婪指的是在构建树的每一个过程当中,“最优”分裂仅限于某一个局部过程,而不是全局过程。
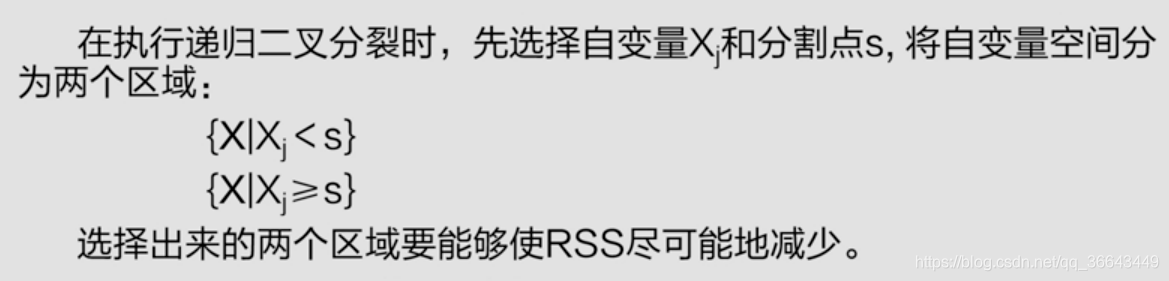
重复上述步骤,继续寻找分割数据集的最优自变量和最优分割点,使随之产生的区域的RSS最小。
这一过程不断持续,直到符合某个停止准则。例如:当所有区域包含的观测个数都不大于5时,分裂停止。
J个区域产生后,就可以确定某一给定观测所属的区域,并用这一区域的训练观测的平均相应值对其进行预测。
上述方法会在训练集中取得良好的预测效果,却很有可能造成数据的过拟合,导致在测试集上表现不佳。原因是树可能过于复杂!我们需要的是一棵分裂点更少、规模更小的树。
一个可能的解决方法:仅当分裂能使得RSS的减少量超过某阈值时,才分裂树的节点。
更好的一种策略是先生成一个很大的树,然后通过剪枝得到子树。剪枝的目的是选出测试误差(在测试集上的预测误差)最小的子树。因此,需要从所有可能的子树中先选出一小部分,然后再进行剪枝。成本复杂性剪枝可以完成上述任务。
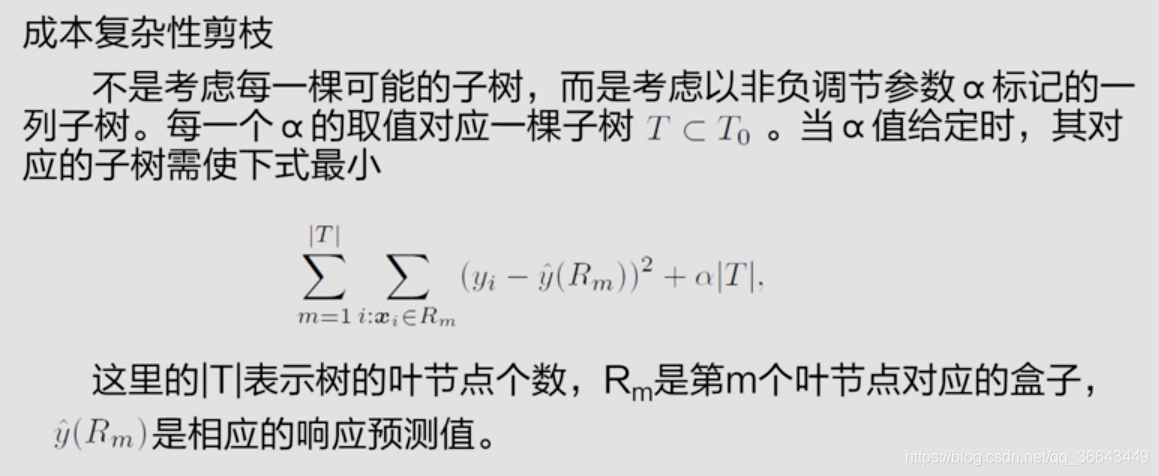
上式中,左侧是损失函数,右侧是惩罚函数,a是调节参数,当a=0时,子树T即为原树T0;当a增大时,叶节点数多的树将为它的复杂性付出代价,所以使上述目标函数取到最小值的子树规模会变小。当a从0开始逐渐增大时,树枝以一种嵌套的模式被修剪,因此很容易获得与a对应的子树序列。可以用交叉验证或者验证集来挑选最优的a,从而确定相应的最优子树。
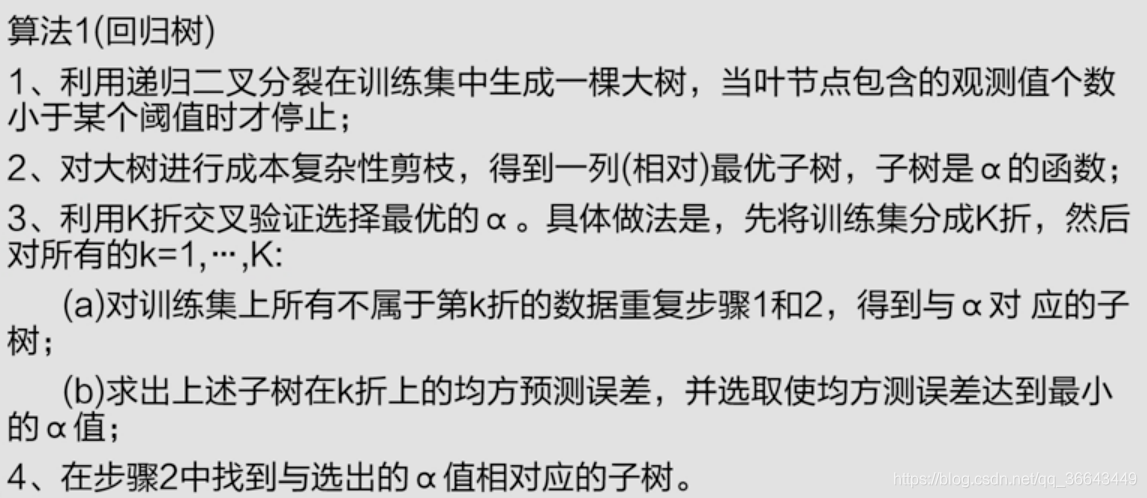
回归树算法

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献5条内容

所有评论(0)