爬虫练习-爬取豆瓣电影 Top 250信息并存储于本地
思路
使用环境
- python版本:python3
- 浏览器:Google Chrome
- 模块:xpath(lxml)、requests
一、请求网页
豆瓣电影Top250第一页url:https://movie.douban.com/top250?start=0&filter=
一开始请求网页加了headers,然后想解析网页来着,竟然返回了418(咦,这返回个是啥,反正不是200,难受,查查文档),这是IETF在1998年愚人节时发布的一个笑话RFC,具体可以参考RFC 2324 - Hyper Text Coffee Pot Control Protocol (HTCPCP/1.0)超文本咖啡壶控制协议。htcpcp1.0协议中的418的意义是:当客户端给一个茶壶发送泡咖啡的请求时,茶壶就返回一个418错误状态码,表示“我是一个茶壶”。
emm,可能是豆瓣启动反爬机制了,然后给返回一个玩笑,查了好久的资料,最后,当当当,请看
请求返回418,已解决,没错,就这么简单,加一个timeout参数
html = requests.get(url, headers=headers,timeout=30)
请求成功返回状态码200
print(html.status_code)
二、解析网页
(一)请求网页成功后当然是解析网页,分析网页结构可知,我们需要的信息都被<div class="info">所包含

那我们分成一小块一小块来解决问题,先用xpath解析出class属性为info的div块
root.xpath('//div[@class="info"]')
(二)再对里面的详细信息进行分析,如下
		# 影片名称
        title = InformationBlock.xpath('div[@class="hd"]/a/span[@class="title"]/text()')[0]
        # print(title)

        info = InformationBlock.xpath('div[@class="bd"]/p[1]/text()')
        # print(type(info))

        directorAndStarring = str(info[0]).split("   ")
        # 导演
        director = directorAndStarring[0].replace(" ", "").replace("\n", "").replace("导演:", "")

        # 主演
        try:
            Starring = directorAndStarring[1].replace(" ", "").replace("\n", "").replace("主演:", "")
        except :
            Starring = "NULL"

        # 上映日期
        date = info[1].replace(" ", "").replace("\n", "").split("/")[0]

        # 制片国家
        country = info[1].replace(" ", "").replace("\n", "").split("/")[1]

        # 影片类型
        geners = info[1].replace(" ", "").replace("\n", "").split("/")[2]

        # 评分
        rate = InformationBlock.xpath('div[@class="bd"]/div/span[2]/text()')[0]

        # 评论人数
        comCount = InformationBlock.xpath('div[@class="bd"]/div/span[4]/text()')[0].replace("人评价", "")
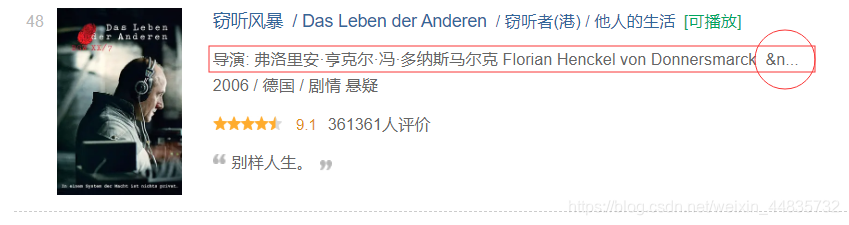
注: 如下,在该截图中导演名字太长,会导致主演名字显示不出来,所以笔者用NULL替代
三、获取信息
该要的信息都解析出来了,那么就是获取信息保存在本地啦,这个简单,代码如下
datas = (("{},{},{},{},{},{},{},{},{}").format(Top, title, director, Starring, rate, date, country, geners, comCount))
        with open("doubanMovie.csv", "a", newline="", encoding="utf_8_sig") as f:
            f.write(datas+"\n")
注:
- Top为设定的全局变量
- 此文件使用追加模式,即此处的open()函数第二个参数为"a"
- encoding编码格式,此处有坑,之前笔者用"utf-8"格式向csv文件写入数据,csv文件打开后中文乱码,查找了不少资料,最后发现使用"utf_8_sig"格式有效解决问题
四、实现翻页
以上三步可以完成单页的爬取,但是Top250被分成了10页,让我们看看它剩下几页url的规律
第一页
https://movie.douban.com/top250?start=0&filter=
第二页
https://movie.douban.com/top250?start=25&filter=
第三页
https://movie.douban.com/top250?start=50&filter=
...
最后一页
https://movie.douban.com/top250?start=225&filter=
每一页url的start= 后跟的参数从0开始,每页增加25,最大为225,OK分析完成
# 翻页
def nextPage():
    for i in range(0, 250, 25):
        url = 'https://movie.douban.com/top250?start={}&filter='.format(i)
        getInfo(url)
附录
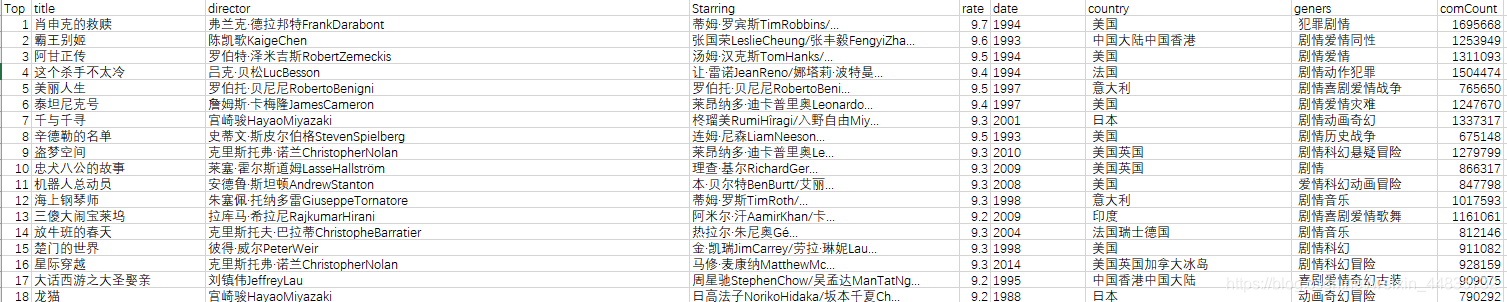
A.所得数据截图
B.完整代码
"""
电影Top250主页 (需翻页;翻页url:("https://movie.douban.com/top250?start={}&filter=").format(i),i = i + 25)
获取信息存储于csv文件中
"""
from lxml import etree
import requests

headers = {"User-Agent": 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) '
                         'AppleWebKit/537.36 (KHTML, like Gecko) Chrome/78.0.3904.108 Safari/537.36'
           }
Top = 1


# 获取信息
def getInfo(url):
    html = requests.get(url, headers=headers, timeout=30)
    # print(html.status_code)
    root = etree.HTML(html.content)

    # 我们所需要的所有的信息都在<div class="info">块中
    for InformationBlock in root.xpath('//div[@class="info"]'):
        # 影片名称
        title = InformationBlock.xpath('div[@class="hd"]/a/span[@class="title"]/text()')[0]
        # print(title)

        # <div class="bd">块,导演、演员、上映时间、制片国家、影片类型在一个<p>里
        info = InformationBlock.xpath('div[@class="bd"]/p[1]/text()')
        # print(type(info))
        '''
                导演主演 info[0]
        '''
        directorAndStarring = str(info[0]).split("   ")
        # 导演
        director = directorAndStarring[0].replace(" ", "").replace("\n", "").replace("导演:", "")
        # 主演
        try:
            Starring = directorAndStarring[1].replace(" ", "").replace("\n", "").replace("主演:", "")
        except :
            Starring = "NULL"

        '''
        上映日期、制片国家、影片类型 info[1]
        '''
        # 上映日期
        date = info[1].replace(" ", "").replace("\n", "").split("/")[0]

        # 制片国家
        country = info[1].replace(" ", "").replace("\n", "").split("/")[1]

        # 影片类型
        geners = info[1].replace(" ", "").replace("\n", "").split("/")[2]

        # 评分
        rate = InformationBlock.xpath('div[@class="bd"]/div/span[2]/text()')[0]

        # 评论人数
        comCount = InformationBlock.xpath('div[@class="bd"]/div/span[4]/text()')[0].replace("人评价", "")

        global Top
        # 打印结果看看
        print(Top, title, director, Starring, rate, date, country, geners, comCount)
        print("---------------------------------------------------------")
        datas = (("{},{},{},{},{},{},{},{},{}").format(Top, title, director, Starring, rate, date, country, geners, comCount))
        with open("doubanMovie.csv", "a", newline="", encoding="utf_8_sig") as f:
            f.write(datas+"\n")
        Top += 1


# 翻页
def nextPage():
    for i in range(0, 250, 25):
        url = 'https://movie.douban.com/top250?start={}&filter='.format(i)
        getInfo(url)


if __name__ == '__main__':
	# 给文件加头部标题
    with open("doubanMovie.csv", "w", newline="", encoding="utf_8_sig") as f:
        f.write("Top,title,director,Starring,rate,date,country,geners,comCount"+"\n")
    nextPage()

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 10
 0
- 0


 已为社区贡献2条内容

所有评论(0)