机器学习算法之线性判别分析(LDA二分类)
算法原理
线性判别分析(Linear Discriminant Analysis, LDA)的原理比较简单,就是我们希望寻找到一条直线,然后我们将数据投影到这条直线上,使得这两种数据之间尽可能远离,并且同类数据尽可能聚集在一起。
假设我们有两类数据,也就是说这里是针对二分类问题以及对应的标签。数据表示为D=(xi,yi)i=1m,m=2,yi∈(0,1)D={(x_i,y_i)}_{i=1}^m,m=2,y_i\in{(0,1)}D=(xi,yi)i=1m,m=2,yi∈(0,1)。我们希望可以找到一条直线y=w1x1+w2x2=wxy=w_1x_1+w_2x_2=wxy=w1x1+w2x2=wx把两种样本分开。为了达到这个目的,我们首先要让同类的样本投影点尽可能小,即希望wT∑ww^T\sum wwT∑w小,同时我们还想让两个类的中心u1,u2u_1,u_2u1,u2投影后的距离尽量大,即∣∣wTu1−wTu2∣∣||w^Tu_1-w^Tu_2||∣∣wTu1−wTu2∣∣尽量大。
定义“类内散度矩阵”:
Sw=Σ1+Σ2=∑x∈X1(x−μ1)(x−μ1)T+∑x∈X2(x−μ2)(x−μ2)TS_{w}=\Sigma _{1}+\Sigma _{2}=\sum_{x \in X1}(x-\mu_{1} )(x-\mu_{1} )^{T}+\sum_{x \in X2}(x-\mu_{2} )(x-\mu_{2} )^{T}Sw=Σ1+Σ2=∑x∈X1(x−μ1)(x−μ1)T+∑x∈X2(x−μ2)(x−μ2)T
定义“类间散度矩阵”:
Sb=(μ1−μ2)(μ1−μ2)TS_{b}=(\mu_{1}-\mu_{2} )(\mu_{1}-\mu_{2} )^{T}Sb=(μ1−μ2)(μ1−μ2)T
则我们的代价函数可写为:
J=wTSbwwTSww(1)J=\frac{w^{T}S_{b}w}{w^{T}S_{w}w} (1)J=wTSwwwTSbw(1)
这个等式叫“广义瑞利商”,这部分的仔细推导需要参考西瓜书第61页。
最后,我们希望最大化上述代价函数,由于代价函数的分子分母都有2个w,因此J的最大解与w的长度无关,只与方向有关,我们令:
wTSww=1w^TS_ww=1wTSww=1,则(1)式等价于:
minw−wTSbwmin_{w}-w^{T}S_{b}wminw−wTSbw
s.t.wTSww=1s.t. w^{T}S_{w}w=1s.t.wTSww=1
使用拉格朗日乘子法:
c(w)=wTSbw−λ(wTSww−1)c(w)=w^{T}S_{b}w-\lambda (w^{T}S_{w}w-1)c(w)=wTSbw−λ(wTSww−1)
⇒dcdw=2Sbw−2λSww=0\Rightarrow \frac{dc}{dw}=2S_{b}w-2\lambda S_{w}w=0⇒dwdc=2Sbw−2λSww=0
⇒Sbw=λSww(2)\Rightarrow S_{b}w=\lambda S_{w}w (2)⇒Sbw=λSww(2)
这里观察可知SbwS_bwSbw的方向恒为μ1−μ2\mu_1-\mu_2μ1−μ2。
所以令:Sbw=λ(μ1−μ2)S_{b}w=\lambda (\mu_{1}-\mu_{2})Sbw=λ(μ1−μ2)
带入(2)得:w=Sw−1(μ1−μ2)w=S_{w}^{-1}(\mu _{1}-\mu _{2})w=Sw−1(μ1−μ2)
有了这个式子,我们就可以写出代码来可视化看看了。
代码实现
#coding=utf-8
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets.samples_generator import make_classification

def LDA(X, y):
    X1 = np.array([X[i] for i in range(len(X)) if y[i] == 0])
    X2 = np.array([X[i] for i in range(len(X)) if y[i] == 1])

    len1 = len(X1)
    len2 = len(X2)

    # 求均值向量u1,u2
    miu1 = np.mean(X1, axis=0)
    miu2 = np.mean(X2, axis=0)

    # 求S_w
    # \sum_0
    conv1 = np.dot((X1 - miu1).T, (X1 - miu1))
    # \sum_1
    conv2 = np.dot((X2 - miu2).T, (X2 - miu2))
    Sw = conv1 + conv2

    # 计算w
    w = np.dot(np.mat(Sw).I, (miu1 - miu2).reshape((len(miu1), 1)))
    X1_new = np.dot(X1, w)
    X2_new = np.dot(X2, w)
    y1_new = [0 for i in range(len1)]
    y2_new = [1 for i in range(len2)]
    return X1_new, X2_new, y1_new, y2_new

def main():
    X, y = make_classification(n_samples=500, n_features=2, n_redundant=0, n_classes=2,
                               n_informative=1, n_clusters_per_class=1, class_sep=0.5, random_state=10)

    X1_new, X2_new, y1_new, y2_new = LDA(X, y)

    # 可视化原始数据
    plt.scatter(X[:, 0], X[:, 1], marker='o', c=y)
    plt.show()
    # 可视化LDA降维后的数据
    plt.plot(X1_new, y1_new, "bo")
    plt.plot(X2_new, y2_new, "ro")
    plt.show()

main()
数据
使用sklearn的make_classification产生两个分类的随机数据,可视化如下:
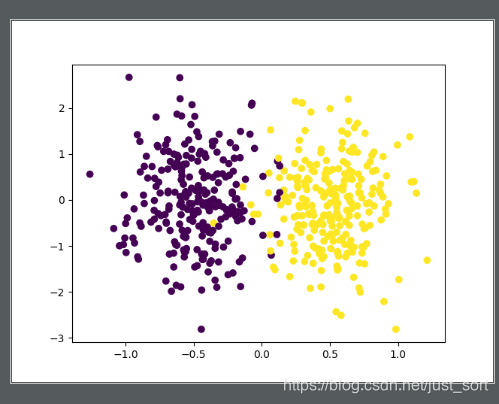
经过LDA之后,我们将每个数据的标签可视化出来:
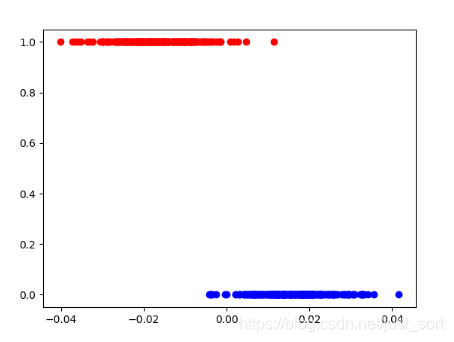
可以看到LDA算法将我们的数据集很好的分开了,由此可以说明LDA是有效的。
这里有个最大的缺点是这里的算法只能处理二分类,要处理多分类的话,需要在这个算法的基础上进行推广。请看下文。
参考文章
https://blog.csdn.net/z962013489/article/details/79871789

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 4
 0
- 0


 已为社区贡献9条内容

所有评论(0)