Python网络爬虫系列(一)
·
本节主要是体会Python进行网络爬虫的大概流程,代码部分需其它基础,后续会具体介绍。
一、为什么推荐Python进行网络爬虫
(1)上手容易
(2)免费开源,使用不受限制
(3)解释执行,跨平台不受限制
(4)面向对象
(5)框架和库支持丰富,有大量历史积累
二、HTTP简介
(1)HTTP Hyper Text Transfer Protocol (超文本传输协议)
(2)URI Uniform Resource Identifier(统一资源标识符),它是一个标准
(3)URL Uniform Resource Locator(统一资源定位符),它实际上是一个资源标识符,但更具体的,它定位了资源的位置。
(4)HTML Hyper Text Markup Language (超文本标记语言) ,使用标记标签来描述网页
三、爬虫框架(此部分先了解,熟练后再体会)
(1)爬虫工作流程
将种子URL放入队列,从队列中获取URL,爬取内容;解析爬取内容,将需要进一步爬取的URL放入队列,存储解析
(2)爬虫策略
深度优先
广度优先
PageRank
大站优先策略
(3)爬虫去重
Hash表
Bloom过滤器
(4)爬虫质量标准
分布式、可伸缩性、性能和有效性、质量、新鲜性、更新、可扩展性
(5)Robots规范与原则
Robots协议
四、案例
多线程抓取新浪股票信息
import requests
import threading

def display_info(code):
    url = 'http://hq.sinajs.cn/list=' + code
    response = requests.get(url).text
    print(response)

def single_thread(codes):
    for code in codes:
        code = code.strip()
        display_info(code)

def multi_thread(tasks):
    # 用列表推导生成线程,注意codes后面的‘,’!
    threads = [threading.Thread(target = single_thread, args = (codes,)) for codes in tasks]
    # 启动线程
    for t in threads:
        t.start()
    # 等待线程结束
    for t in threads:
        t.join()

# 注意main函数的形式
if __name__ == '__main__':
    codes = ['sh600001', 'sh600002', 'sh600003', 'sh600004', 'sh600005', 'sh600006']
    # 计算每个线程要做多少工作
    thread_len = int(len(codes) / 4)
    t1 = codes[0: thread_len]
    t2 = codes[thread_len: thread_len * 2]
    t3 = codes[thread_len * 2: thread_len * 3]
    t4 = codes[thread_len * 3:]

    # 多线程启动
    multi_thread([t1, t2, t3, t4])
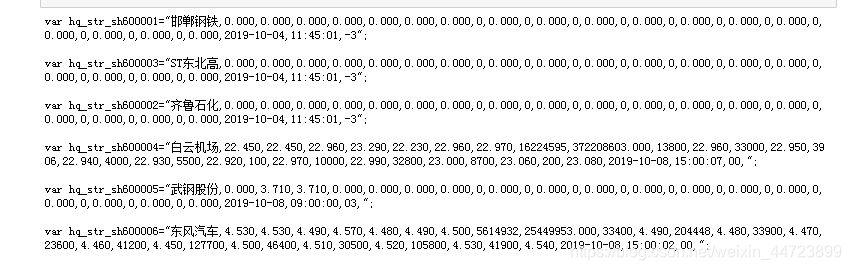
结果如下:

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)