《机器学习》笔记---------------数据集的划分与最终模型的提交(书中的"模型评估方法")
·
-
留出法 hold-out
- 问题1:
S、T中样本类别比例差别很大,则误差估计将由于训练/测试数据分布的差异而产生偏差. - 解决:
采用若干次随机划分、重复进行实验评估后取平均值作为留出法的评估结果 - 问题2:
评估结果的保真性(fidelity)与稳定准确性之间的矛盾 - 解决:
这个问题没有完美的解决方案,常见做法是将大约2/3~4/5的样本用于训练,剩余样本用于测试 - 总体解决方案:
采用若干次将大约2/3~4/5的样本用于训练的随机划分,测试集至少应含30个样例,重复进行实验评估后取平均值
- 问题1:
-
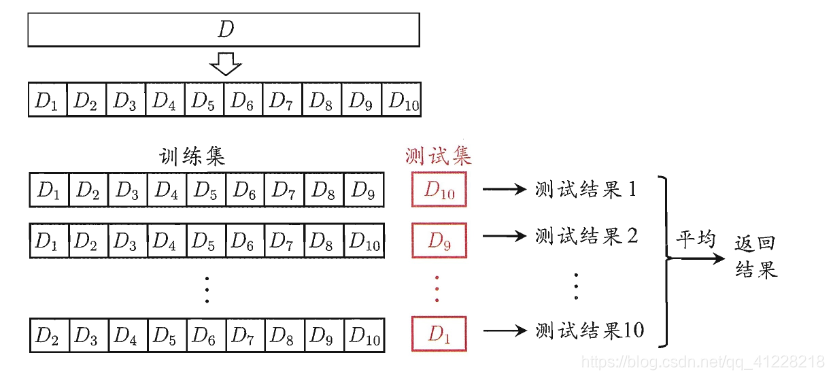
交叉验证法 cross validation/k倍交又验证/k折交叉验证 k-fold cross validat ion
10次10折交又验证法与"100次留出法"都是进行了100次训练测试- 问题:
留一法(Leave-One-Out)/LOO 的估计结果也未必永远比其他评估方法准确(NFL原理),但大部分情况还是比较准确的,但在数据集比较大时,计算开销使得问题求解不可行(计算资源大佬可忽略) - 解决:
通常用 10次10折交叉验证:
- 问题:
-
自助法 bootstrapping /可重复采样/有放回采样
-
包外估计(out-of-bag estimate).
我们可将D’用作训练集,D减D’用作测试集;这样实际评估的模型与期望评估的模型都使用m个训练(我的理解是每次都有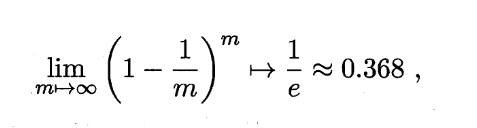 36.8%的样本未出现在采样数据集D’中,而且是随机抽的,可以保证每次抽取样本在分布上的一致性,不知道这么理解对不对???)、而我们仍有数据总量约1/3的、没在训练集中出现的样本用于测试,这样的结果即包外估计
-
问题:
减少训练样本规模不同造成的影响,同时还能比较高效地进行实验估计
数据集较小、难以有效划分训练/测试集
自助法能从初始数据集中产生多个不同的训练集,这对集成学习等方法有很大的好处 -
解决:
包外估计 -
带来的新问题
自助法产生的数据集改变了初始数据集的分布,这会引入估计偏差.在初始数据量足够时,留出法和交叉验证法更常用一些.
-
-
最终模型:
在模型选择完成后,学习算法和参数配置己选定,此时应该用数据集D重新训练模型.这个模型在训练过程中使用了所有m个样本,这才是我们最终提交给用户的模型 -
验证集:
把训练数据划分为训练集和验证集(validation set),基于验证集上的性能来进行模型选择和调参
然后用测试集上的判别效果来估计模型在实际使用时的泛化能力
参考:
《机器学习》周志华

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献7条内容

所有评论(0)