


冷扑大师 Libratus 与“冷门” NIPS 2017 最佳论文
CMU 教授 Tuomas Sandholm 及其学生 Noam Brown 所开发的人工智能德扑系统 Libratus,被国内同行翻译成 “冷扑大师”。冷扑大师在 2017年1月,与四位德扑职业高手对阵,大获全胜,赢得了接近总数的筹码 [1]。
2017年11月,Noam Brown 与 Tuomas Sandholm 合著的论文,“Safe and Nested Endgame Solving for Imperfect-Information Games”,获得 NIPS 2017 最佳论文奖 [2]。
但是这篇最佳论文,在国内业界引起的讨论,似乎不算特别热烈。原因可能有三条,
1. 这篇论文非常不好懂。光数学符号的定义,就整整占了一节内容。数学符号定义结束后,是很大篇幅的定理证明。初读一遍,云里雾里。
2. 非热门的理论根基。当下热门的机器学习领域,是深度学习和强化学习。而这篇论文的理论根基,是博弈论和运筹学。
3. 方法论的通用性。若干读者认为,冷扑大师的算法,可能仅仅适用于德扑,或者充其量能够扩展到其它棋牌类游戏。应用前景有限。
11月8日,Tuomas Sandholm 来北京参加新智元举办的世界人工智能大会AI World 2017,并做主题演讲。餐叙时,Sandholm 教授对笔者说,从应用前景来说,冷扑大师的算法,不仅可以用于赌博,也可以用于谈判,拍卖定价,投资决策等等。
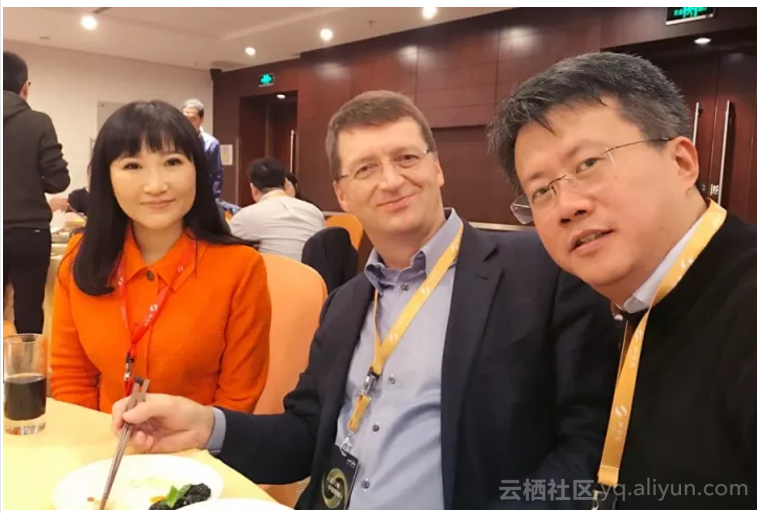
11月8日,Tuomas Sandholm(中)来北京参加新智元举办的世界人工智能大会,餐叙时与新智元创始人兼CEO杨静(左)和本文作者邓侃博士交流
从方法论来说,冷扑算法的理论根基是博弈论和运筹学。而强化学习学习的理论根基是马尔科夫决策过程和动态规划。虽然来源不同,但是终将殊途同归。
我有几张阿里云幸运券分享给你,用券购买或者升级阿里云相应产品会有特惠惊喜哦!把想要买的产品的幸运券都领走吧!快下手,马上就要抢光了。
冷扑算法与强化学习和深度学习殊途同归之日,必将大放异彩。
冯·诺依曼曾经这样说,“真实的生活,(不会像围棋那样)可以毫无遮拦地洞察整个棋局。真实生活中充斥着虚张声势、欺诈、揣度对方心理。这才是我所研究的博弈。”
读懂冷扑大师这篇最佳论文,关键是理解四个概念,
- 纳什均衡策略,
- 反事实最佳策略,
- 抽象,
- 终局。
冷扑大师的算法与纳什均衡策略:不让对方占便宜
目前冷扑大师只会打双人德扑。当然,把算法改进一下,多用几核 GPU,也可以打多人德扑。
打德州扑克时,先发给每个牌手两张暗牌,然后陆续发 5 张明牌,期间 4 轮下注,最后比大小 [3]。
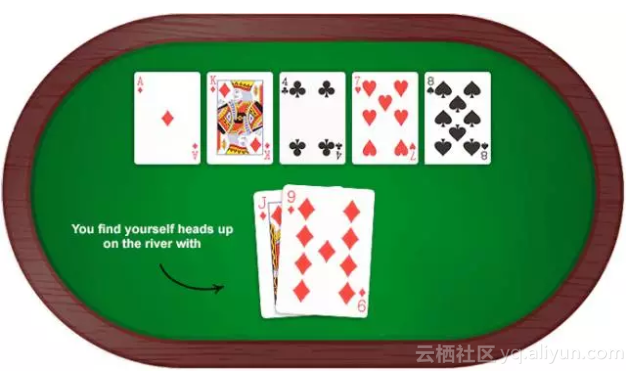
德扑难在揣摩对手的两张暗牌。公开的信息,是 5 张明牌和双方下注的历史。但是,对方不会严格按照自己手中的暗牌来下注,而是有意夹杂着各种误导战术,譬如虚张声势等等。
冷扑大师是如何识别对手的下注策略呢?


 已为社区贡献7条内容

所有评论(0)