C#爬虫基础 分析网页写一个爬去网络小说的程序(付完整代码)
·
C#爬虫基础 分析网页写一个爬去网络小说的程序(付完整代码)
一,抓包工具的使用(以Fiddler为例)
最常见的抓包工具就是Fiddler 下面是下载地址
链接:https://pan.baidu.com/s/1JgBqao4-dqqtdqYkZ8s1Gw
提取码:skj2
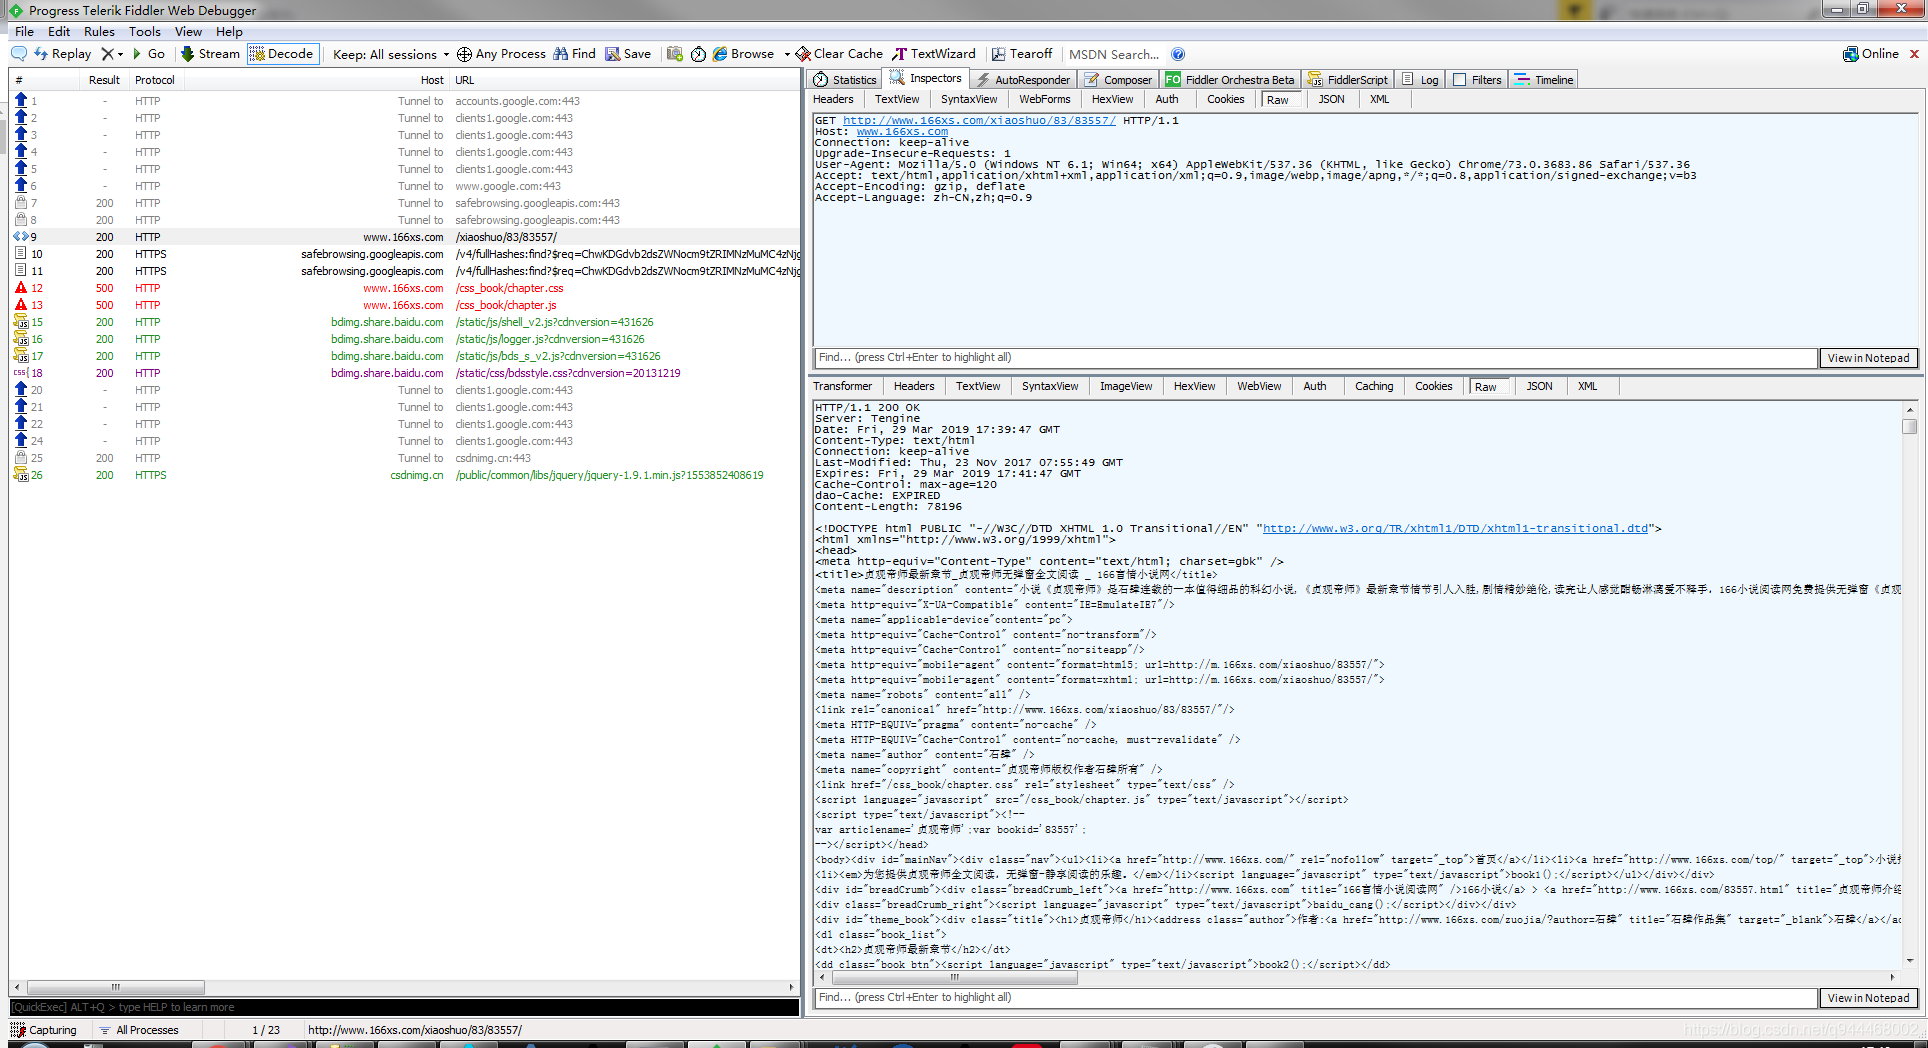
打开Fiddler之后 在网页上打开网站就会在Fiddler上显示各种参数
二,分析网页请求内容(以http://www.166xs.com为例)
http://www.166xs.com是一个小说网址 我们抓到他的请求
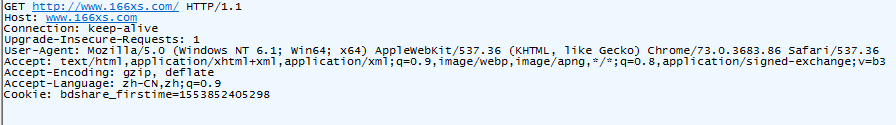
发现他是一个普通的GET请求我们直接通过GET请求就可以获取到网页数据
我们搜索一个小说以贞观帝师为例
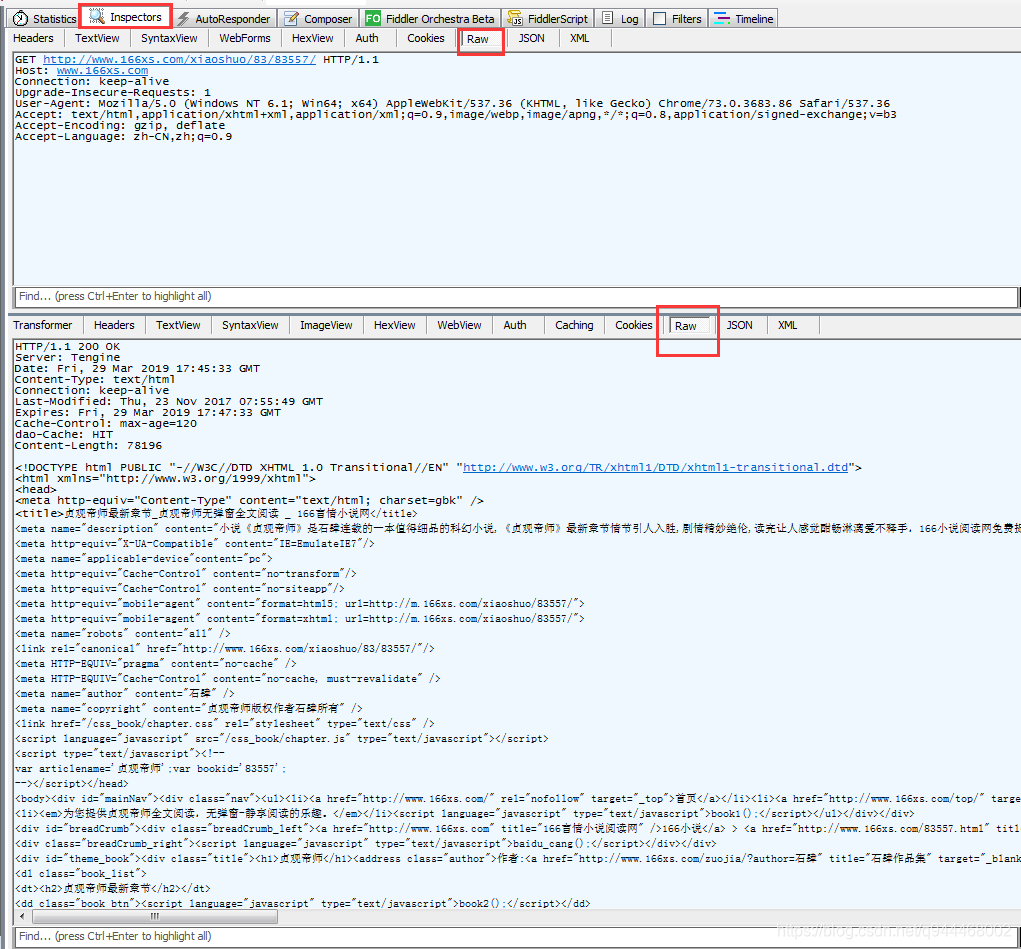
能够看到只需要GET请求就可以 不带cookie和token也没有反爬虫机制
下面我们就可以开始写代码 直接获取内容
三,开始抓取网页内容
我们之间使用GET请求
然后配置UserAgent和Accept-Encoding参数就可以直接请求到网页内容了
string html;
            HttpWebRequest Web_Request = (HttpWebRequest)WebRequest.Create(url);
            Web_Request.Timeout = 30000;
            Web_Request.Method = "GET";
            Web_Request.UserAgent = "Mozilla/4.0";
            Web_Request.Headers.Add("Accept-Encoding", "gzip, deflate");
            //Web_Request.Credentials = CredentialCache.DefaultCredentials;
            //设置代理属性WebProxy-------------------------------------------------
            //WebProxy proxy = new WebProxy("111.13.7.120", 80);
            ////在发起HTTP请求前将proxy赋值给HttpWebRequest的Proxy属性
            //Web_Request.Proxy = proxy;

            HttpWebResponse Web_Response = (HttpWebResponse)Web_Request.GetResponse();

            if (Web_Response.ContentEncoding.ToLower() == "gzip")  // 如果使用了GZip则先解压
            {
                using (Stream Stream_Receive = Web_Response.GetResponseStream())
                {
                    using (var Zip_Stream = new GZipStream(Stream_Receive, CompressionMode.Decompress))
                    {
                        using (StreamReader Stream_Reader = new StreamReader(Zip_Stream, Encoding.Default))
                        {
                            html = Stream_Reader.ReadToEnd();
                        }
                    }
                }
            }
            else
            {
                using (Stream Stream_Receive = Web_Response.GetResponseStream())
                {
                    using (StreamReader Stream_Reader = new StreamReader(Stream_Receive, Encoding.Default))
                    {
                        html = Stream_Reader.ReadToEnd();
                    }
                }
            }
然后通过抓包我们可以发现他的每一张的名字和html是什么
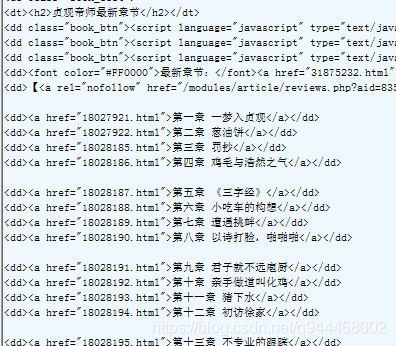
然后我们通过正则表达式来讲他们解析出来
string Novel_Name = Regex.Match(html, @"(?<=<h1>)([\S\s]*?)(?=</h1>)").Value; //获取书名

            Regex Regex_Menu = new Regex(@"(?is)(?<=<dl class=""book_list"">).+?(?=</dl>)");
            string Result_Menu = Regex_Menu.Match(html).Value; //获取列表内容


            Regex Regex_List = new Regex("(?is)(?<=<dd><a href=\").+?(?=</dd>)");
            var Result_List = Regex_List.Matches(Result_Menu); //获取列表集合
            int i = 0; //计数
            string Menu_Content = ""; //所有章节./
            foreach (var x in Result_List)
            {
                Menu_Content += x.ToString();
                i++;
            }

            Regex Regex_Href = new Regex(@"(?is)<a[^>]*?href=(['""]?)(?<url>[^'""\s>]+)\1[^>]*>(?<text>(?:(?!</?a\b).)*)</a>");
            MatchCollection Result_Match_List = Regex_Href.Matches(Menu_Content);   //获取href链接和a标签 innerHTML
然后我们将获取到的网页保存在本地 注意文字保存的时候可能会出现乱码情况这个时候需要转义字符串
string Url_Text = Result_Single.Groups["url"].Value;
string Content_Text = Result_Single.Groups["text"].Value;
string Content_Html = HttpGet(Url_Txt.Text + Url_Text);//获取内容页
Regex Rege_Content = new Regex(@"(?is)(?<=<p class=""Book_Text"">).+?(?=</p>)");
string Result_Content = Rege_Content.Match(Content_Html).Value; //获取文章内容
Regex Regex_Main = new Regex(@"( )(.*)");
string Rsult_Main = Regex_Main.Match(Result_Content).Value; //正文
string Screen_Content = Rsult_Main.Replace(" ", "").Replace("<br />", "\r\n");
Content_Text = System.Text.RegularExpressions.Regex.Unescape(Content_Text); // 字符串转意
Screen_Content = System.Text.RegularExpressions.Regex.Unescape(Screen_Content); //字符串转意
Write_Content.WriteLine(Content_Text + "\r\n");//写入标题
Write_Content.WriteLine(Screen_Content);//写入内容
然后我们就可以在本地看到我们抓取下来的小说了
总结
爬虫其实就是
分析网页请求,获取网页内容,解析网页内容这样的一个流程。
通过此文章希望大家能够更加了解爬虫更加了解网页请求机制,将这次爬虫的心得运用在更多的地方。
下面是全部代码下载地址:https://download.csdn.net/download/q944468002/11072688

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 3
 0
- 0


 已为社区贡献1条内容

所有评论(0)