半自动爬虫--贴吧内容提取 + 小说网站下载
01.贴吧
'''
 我们的目标是百度贴吧的那个帖子~
 1.先保存在记事本中
 2.审查元素看看有什么规律,如果想提取发帖内容,那么?
 [用户名+内容+时间]


 虽然有的地方不见了,还是可以稍微分析一下 <img username="...."> (估计是他的头像)
 所以构造一个正则就可以是:
 username="(.*?)"// 最小贪心匹配咯 到一个合适的就可以了
 然后class也可以顺便获取一下(怪怪的)

 d_post_content j_d_post_content
 所以这里就是,d_post_content j_d_post_content">(.?*)<
 最后看时间..

 这真的能提取出来吗...?
 因为前面还有个这个:

 所以我们就多加点东西:
 tail-info">(2017.*?)<
 这样差不多了吧~ (如果没200楼...)
 那就先写程序吧qaq不懂的再去查一查..


 '''
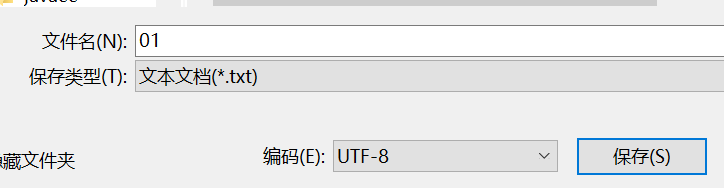
然后报错,"UnicodeDecodeError: 'utf-8' codec can't decode byte 0xb0 in position 74: invalid start byte"
震惊了。。。原来这里可以这么改的。编码不一致导致的,改了就好了,千万注意一下~ 之前没notice过哈哈哈
然后又报错:
'content':content_list[i],
IndexError: list index out of range
不应该呀,但是想了一下可能里面东西变了,就先注释掉试试看
结果发现可以生成csv文件了。整个过程不难,基本也就是正则提取一下,保存输出,注意输入输出流就可以。
再来解决一下content的问题~ (为什么会找不到呢)
东西变了,贴吧升级了,加了一点东西就可以了。
结果差不多这样
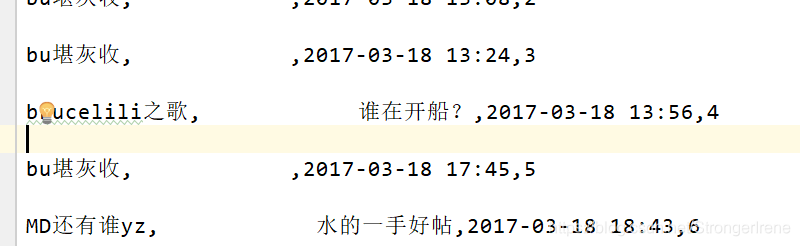
也就是正则提取嘛。。。 附上网址和代码
view-source: https://tieba.baidu.com/p/5027641314?pn=1
# coding:UTF-8

import re
import csv

#打开文件的方法1!!!
with open('01.txt','r',encoding='UTF-8') as f:
    source=f.read()

result_list=[]
username_list=re.findall('username="(.*?)"',source,re.S)
content_list=re.findall('j_d_post_content " style="display:;">(.*?)<',source,re.S)
reply_time_list=re.findall('class="tail-info">(2017.*?)<',source,re.S)

#  class="d_post_content j_d_post_content " style="display:;">            水的一手好帖

for i in range(len(username_list)):
    result={'id': i,
        'username':username_list[i],
            'content':content_list[i],
            'reply_time':reply_time_list[i]
    }
    result_list.append(result)

with open('title.csv','w',encoding='UTF-8')as f:
    writer=csv.DictWriter(f,fieldnames={'id','username','content','reply_time'})
    #为了写字典的输出流~
    writer.writeheader()
    writer.writerows(result_list)
但是其实呢,上面这个程序还是有 一些不足的,比如我们应该选择~ 先分成一个大块,在大块里面一点点往下读~
藏着的bug就是~ 如果是2016年发帖、如果。。。
会导致对应的顺序直接错乱~
代码上没错,但逻辑上有问题
修正一下:
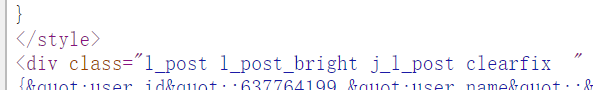
反正就是这里,然后那个也正好。。这个源代码太乱了,反正让我找我肯定找不出(大概还是要敏感度吧w)
列表才有append的功能。(因为字典好像不能改的啊)
字典才去添加str吧。
然后新的方法就是:
import re
import csv

#打开文件的方法1!!!
with open('01.txt','r',encoding='UTF-8') as f:
    source=f.read()
# 更改
every_reply=re.findall('l_post l_post_bright j_l_post clearfix  "(.*?)p_props_tail props_appraise_wrap',source,re.S)
result_list=[]
for each in every_reply:
    result={}
    result['username']=re.findall('username="(.*?)"',each,re.S)[0]
    result['content']=re.findall('j_d_post_content " style="display:;">(.*?)<',each,re.S)[0]
    result['reply_time']=re.findall('class="tail-info">(2017.*?)<',each,re.S)[0]
    result_list.append(result)

with open('title.csv','w',encoding='UTF-8')as f:
    writer=csv.DictWriter(f,fieldnames={'username','content','reply_time'})
    #为了写字典的输出流~
    writer.writeheader()
    writer.writerows(result_list)
我们继续来练习一下有关request(感觉我东学一点西学一点。。 哎 在探索的路上花费了好多不必要的力气)
书上给的练习地址是:http://exercise.kingname.info/exercise_requests_get.html
我们要做什么呢,导入,获取bytes类型的网页源代码(都是bytes类型啊啊。所以要整个去decode)
一般html_str=requests.get('....').content.decode(),默认是把bbytes转成utf-8
新的代码是:
# coding:utf-8
import re
import requests
html=requests.get('http://exercise.kingname.info/exercise_requests_get.html').content.decode()
title=re.search('title>(.*?)<',html,re.S).group(1)
content_list=re.findall('<p>(.*?)<',html,re.S)
#content_str='\n'.join(content_list)
print(f'页面标题为:{title}')
print(f'页面内容为: \n {content_list}')
去掉#之后就是content_str
语法: 'sep'.join(seq)
参数说明
sep:分隔符。可以为空
seq:要连接的元素序列、字符串、元组、字典
上面的语法即:以sep作为分隔符,将seq所有的元素合并成一个新的字符串
返回值:返回一个以分隔符sep连接各个元素后生成的字符串
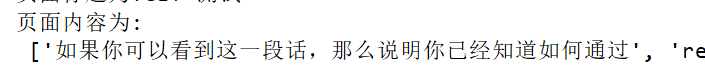
就是这样,不加就是这样很丑的:
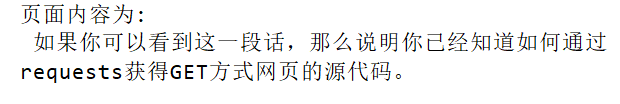
加了就是用\n分割开啦~
多进程库: multiprocessing
02.小说
先爬取所有章节的网址,再通过一个多线程爬虫把它们保存下来(ノ_;\( `ロ´)/
网址: https://www.kanunu8.com/book3/6879/
看上去挺简单~
我的思路,先提取一个唯一的元素(拿到那个网址的分块),然后拼接拿到一堆网址,访问网址下载内容
然后书上是有def函数的,拼接起来就好了,感觉写的很开心啊,哈哈哈哈
小错误:
自己也可以检验一下拼接之后是否完整,以至于获取url失败,所以要改下链接(加上‘/’)
哈哈哈哈,最后就是对于多个返回值的使用方法:https://blog.csdn.net/u010801439/article/details/78458223
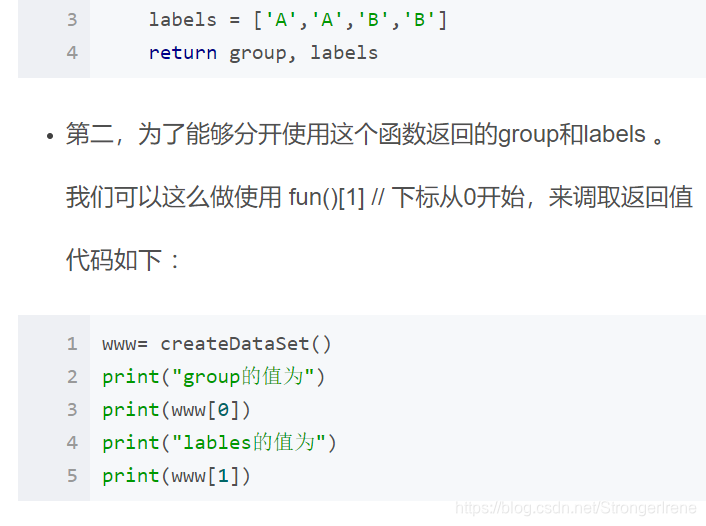
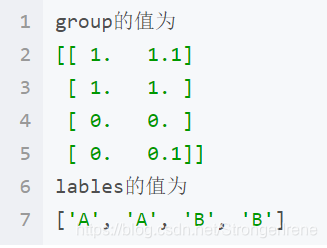
最后可以生成了。开心的去吃饭~
# coding:utf-8
import re
import requests
import os
start_url='https://www.kanunu8.com/book3/6879/'
html=requests.get(start_url).content.decode('GBK')
# 这样相当于已经拿到了源代码了吧...

def get_toc(html):
    toc_url_list=[]
    toc_block=re.findall('正文(.*?)</tbody>',html,re.S)[0]
    # 这个0的意思我觉得就是find  直接find到第一个就好了
    toc_url=re.findall('href="(.*?)"',toc_block,re.S)
    for url in toc_url:
        toc_url_list.append(start_url+url)
       # print (start_url)
       # print (url)
        # 只有列表才有append方法啊!!
    return toc_url_list

def get_article(html):  #size="4">

    charpter_name=re.search('size="4">(.*?)<',html,re.S).group(1)
    text_block=re.search('<p>(.*?)</p>',html,re.S).group(1)
    text_block=text_block.replace('<br />','')
    return charpter_name,text_block

def save(chapter,aaa):
    os.makedirs('动物农场',exist_ok=True)
    with open(os.path.join('动物农场',chapter+'.txt'),'w',encoding='utf-8')as f:
        f.write(aaa)


for i in get_toc(html):
    html2=requests.get(i).content.decode('GBK')
    www=get_article(html2)
    save(www[0],www[1])
# 妈呀... 创建文件夹来保存 使用os库
=======补习一下之前的内容~
w我又开始划水了-.- 想画画啊啊啊ε=ε=ε=(#>д<)ノ 干啥都无从下手啊啊w(゚Д゚)w可以每天练习个多长时间吗((灬ꈍ ꈍ灬))

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献7条内容

所有评论(0)