利用python爬取小说
·
很久没有写过爬虫了,今天刚好有同学问我能不能帮忙把一部小说爬下来,因为网上搜索下载小说,大部分都是一些虚假的链接,或需要注册网站的账号;并且直接在网站上看的话,广告也是满天飞。为了让他更加纯粹的享受小说,也为了炫耀一下Python大法。于是就诞生了这篇文章
步骤
- 观察网站结构
- 获取章节链接
- 获取详细文本
网站分析
在网上搜了一个看小说的网站:笔趣阁。搜索小说之后看到这样的网页:
章节链接页:

详细文本页:

获取章节链接
直接构造一个方法获取所有的章节链接,然后不要第一部分的最新章节,只保留正文卷的链接,避免重复
import requests
from bs4 import BeautifulSoup
import codecs
#超时设置
from requests.adapters import HTTPAdapter
s = requests.Session()
s.mount('http://', HTTPAdapter(max_retries=3))


header = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:58.0) Gecko/20100101 Firefox/58.0',
    'Connection': 'close'}

def get_link(url):
    '''获取全部章节的链接'''
    html = s.get(url)
    soup = BeautifulSoup(html.content, 'lxml')  # content如果换成text会有乱码
    url_list = []
    list = soup.select("#list > dl > dd > a")
    for i in list:
        i = i.get("href")
        i = 'http://www.biqugecom.com' + i
        url_list.append(i)
    url_list = url_list[9:-1]
return url_list为了避免频繁爬取而导致的超时链接问题,设置了超时重复连接次数(max_retries)
这里我设置了3次,能够完整爬取全部的章节。如果还是抛错,可以将值该大一点
获取详细文本
获取详细文本时,遇到了一个问题:第一个就是就是编码问题,最后还是通过以二进制的形式才没有出现乱码。
def get_data(url):
    '''获取详细文本'''
    html = s.get(url)
    soup = BeautifulSoup(html.content, 'lxml')
    f = codecs.open('output.txt', 'a+', 'utf-8')
    # 以二进制写入章节题目 需要转换为utf-8编码,否则会出现乱码
    section_name = soup.select("#wrapper > div.content_read > div > div.bookname > h1")[0].text
    print(section_name)
    f.write(('\r\n' + section_name + '\r\n'))
    section_text = soup.select("#content")
    for x in section_text:
        a = x.text.replace('readx();', '').replace('www.biqugecom.com/27/27204/', '')
        # 以二进制写入章节内容
        f.write((a)+ '\r\n')
    f.close()  # 关闭小说文件
添加主函数
if __name__ == '__main__':
    url = 'http://www.biqugecom.com/27/27204/'
    url_list = get_link(url)
    for i in url_list:
        get_data(i)
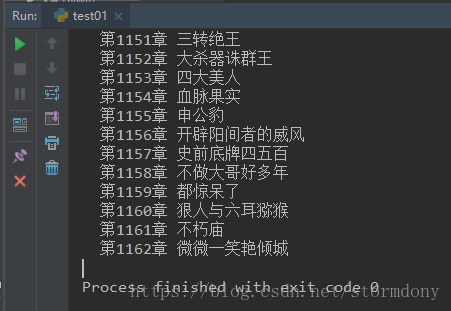
爬取的速度有点慢,因为考虑到章节内容插入的顺序问题,所以没有使用多进程。但是一般小说也就一两千章,还是可以忍受的
最后
这个教程只是单纯的练习使用,虽然不是很复杂,但是让我get到了两点:第一就是编码的解决方法,还有就是超时重新连接的方法。
最后弱弱的说一句,看小说请支持正版,毕竟这是作者的劳动成果。
github:https://github.com/stormdony/python_demo/tree/master/Novel_Download_Tool
欢迎关注微信公众号:Python绿洲

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 3
 0
- 0


 已为社区贡献5条内容

所有评论(0)