爬虫之哔哩哔哩女神篇
- 版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/kun1280437633/article/details/80503625
# -*- coding: utf-8 -*-
import re
import requests
'''
分析:
1. 爬取流程
地址:https://search.bilibili.com/all?keyword=女神篇&from_source=banner_search&page=39
方式:get
参数:
keyword: 女神篇
from_source: banner_search
page: 39
'''
class BiliSpider:
def __init__(self):
self.base_url = "https://search.bilibili.com/all"
self.info = {}
def run(self):
headers = {
'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/66.0.3359.181 Safari/537.36',
'Cookie':'LIVE_BUVID=AUTO3815276021025886; finger=edc6ecda; buvid3=B02A6519-CFCF-4F15-B094-A0C4FF19C91F31057infoc',
'Upgrade-Insecure-Requests':'1',
}
detail_div_pattern = re.compile(r'<li class="video matrix">(.*?)<div class="img">', re.S)
detail_link_pattern = re.compile(r'<a href="(.*)" target="_blank" title="(.*)"')
for i in range(39):
params = {
'keyword': '女神篇',
'from_source': 'banner_search',
'page': i,
}
url = self.base_url
response = requests.get(url,params=params,headers=headers)
total_html = response.content.decode('utf-8')
detail_div_htmls = detail_div_pattern.findall(total_html)
if detail_div_htmls == []:
pass
else:
for detail_div_html in detail_div_htmls:
# print(detail_div_html)
detail_link_html = detail_link_pattern.findall(detail_div_html)[0]
name = detail_link_html[1]
url = detail_link_html[0]
if name in self.info:
pass
else:
self.info[name] = url
print(self.info)
if __name__ == '__main__':
spider = BiliSpider()
spider.run()
上面的失效啦,闲来无事,更新下(时间为2020年3月24号)
# -*- coding: utf-8 -*-
import re
import requests
'''
    分析:
    1. 爬取流程
    地址:https://search.bilibili.com/all?keyword=女神篇&from_source=banner_search&page=39
    方式:get
    参数:
        keyword: 女神篇
        from_source: banner_search
        page: 39
'''

class BiliSpider:
    def __init__(self):
        self.base_url = "https://search.bilibili.com/all"
        self.info = {}

    def run(self):
        headers = {
            'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/66.0.3359.181 Safari/537.36',
            'Cookie': 'LIVE_BUVID=AUTO3815276021025886; finger=edc6ecda; buvid3=B02A6519-CFCF-4F15-B094-A0C4FF19C91F31057infoc',
            'Upgrade-Insecure-Requests': '1',
        }
        detail_div_pattern = re.compile(r'<li class="video-item matrix">(.*?)<div class="img">', re.S)

        detail_link_pattern = re.compile(r'<a href="(.*)" title="(.*)" target="_blank" class="img-anchor"', re.S)

        for i in range(50):
            params = {
                'keyword': '女神篇',
                'from_source': 'banner_search',
                'page': i,

            }
            url = self.base_url
            response = requests.get(url, params=params, headers=headers)
            total_html = response.content.decode('utf-8')
            # print(total_html)
            detail_div_htmls = detail_div_pattern.findall(total_html)
            if detail_div_htmls == []:
                pass
            else:
                for detail_div_html in detail_div_htmls:
                     # print(detail_div_html)
                    detail_link_html = detail_link_pattern.findall(detail_div_html)[0]
                    name = detail_link_html[1]
                    url = detail_link_html[0]
                    if name in self.info:
                        pass
                    else:
                        self.info[name] = url

        for key,value in self.info.items():
            print(key,value)


if __name__ == '__main__':
    spider = BiliSpider()
    spider.run()
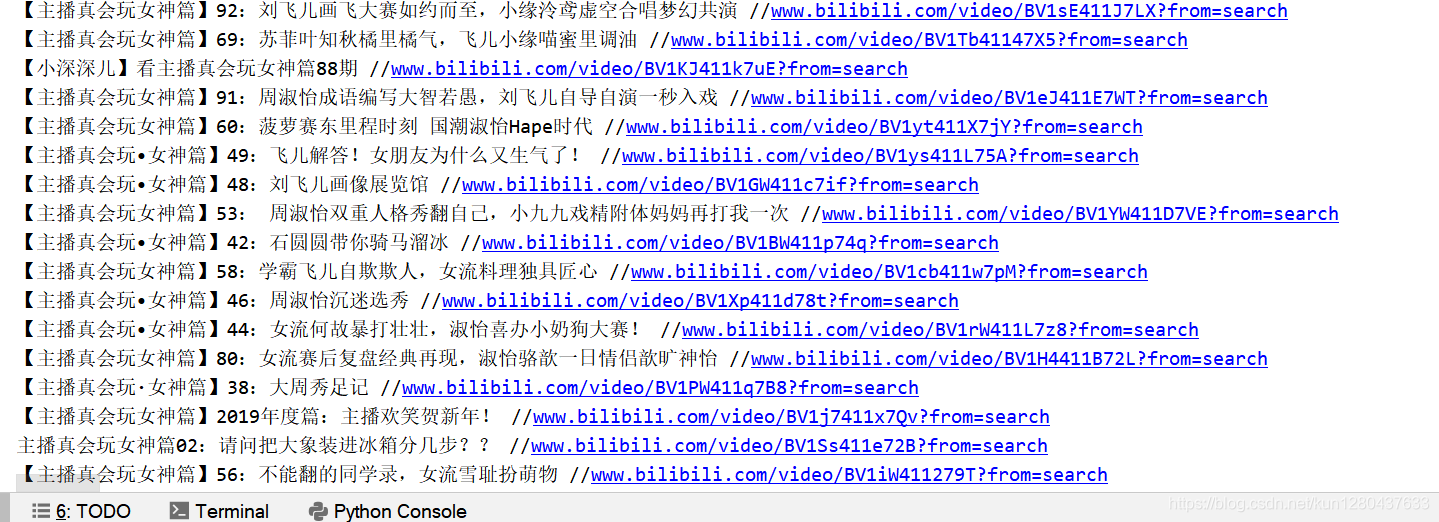
效果展示

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 2
 0
- 0


 已为社区贡献1条内容

所有评论(0)