小白也能懂!大模型时代,强化学习如何让 AI 拥有「智慧大脑」?
在人工智能技术迭代的浪潮中,大语言模型(Large Language Model, LLM)已从“文本续写工具”进化为具备逻辑推理、意图理解能力的智能体。这一质变的背后,强化学习(Reinforcement Learning, RL)技术如同“智能校准器”,解决了模型从“能生成”到“生成得好”的关键难题。
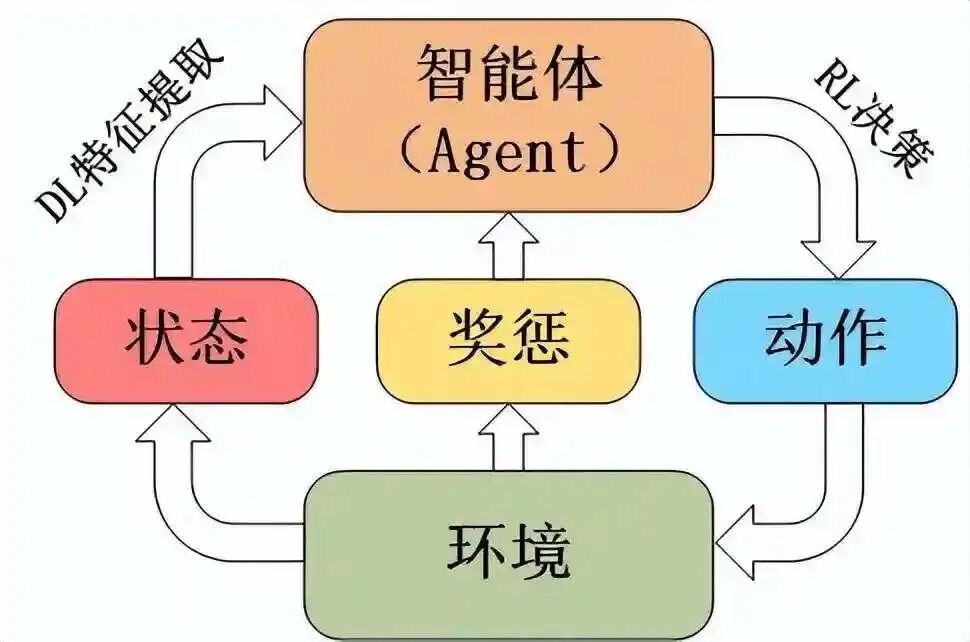
本文将穿透技术表象,系统拆解强化学习如何重塑大模型的决策逻辑,结合主流模型实践案例与可落地的Python代码,带读者掌握从理论到工程的完整链路。
一、大模型的“成长烦恼”:为何必须引入强化学习?
经过万亿级数据预训练的大模型,虽已掌握语言的语法规则与知识关联,但在实际应用中仍暴露四大核心短板,这些问题靠传统训练方式难以解决:
- “幻觉”频发:对未知领域强行生成“看似合理却错误”的内容,例如虚构学术论文、编造事实数据
- 逻辑“断档”:长文本生成中前后矛盾,如前文称“某产品2023年上市”,后文却描述“2022年销量破亿”
- 价值观“跑偏”:可能输出带有偏见、歧视或违背公序良俗的内容,难以适配不同场景的伦理要求
- 指令“失灵”:无法精准理解复杂指令的深层意图,例如用户要求“用小学生能懂的话解释相对论”,模型仍输出专业术语堆砌的内容
传统监督微调(Supervised Fine-Tuning, SFT)虽能让模型“学会听话”,但依赖海量人工标注的高质量数据——单轮SFT训练可能需要消耗数十万条标注样本,成本动辄百万级。而强化学习通过“反馈-优化”的闭环,让模型在无海量标注的情况下持续自我迭代,成为更高效的“进化路径”。
二、RLHF:大模型“对齐人类偏好”的核心框架
基于人类反馈的强化学习(Reinforcement Learning from Human Feedback, RLHF),是当前ChatGPT、Claude等主流模型实现“智能跃迁”的核心技术路线。其本质是通过模拟人类对内容的评价标准,让模型自主学习“什么是好的输出”,整个流程分为三个环环相扣的阶段。
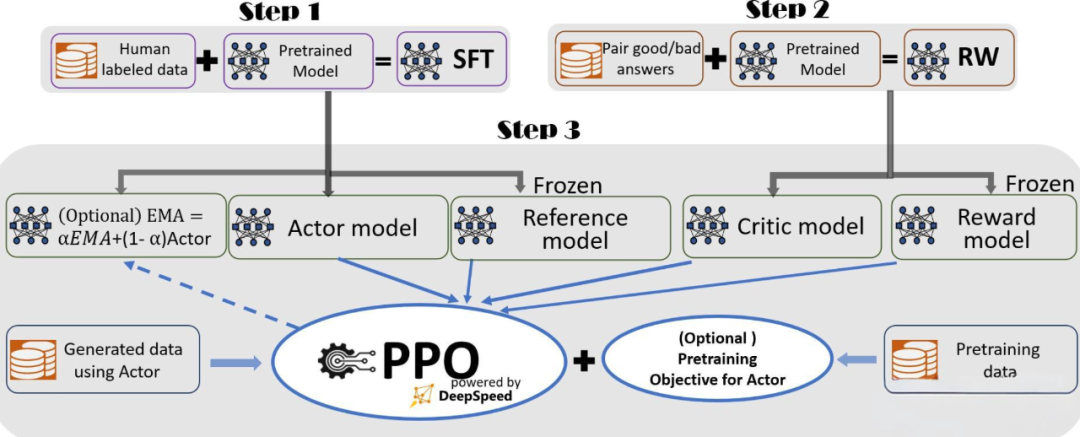
2.1 三阶段闭环:从“模仿”到“自主优化”
第一阶段:有监督微调(SFT)—— 让模型“看懂指令”
- 核心目标:以人类标注的高质量问答数据(如“用户问题-专家回答”配对)微调预训练模型,使其初步具备指令理解与基础响应能力
- 数据规模:通常需要1-10万条精准标注样本,重点覆盖常见应用场景(如客服咨询、代码生成、知识问答等)
- 关键作用:为后续强化学习提供“基础模型”,避免模型在RL阶段因初始能力不足导致训练失控
第二阶段:奖励模型训练(Reward Model, RM)—— 让模型“知道好坏”
- 核心逻辑:训练一个独立模型,用人类对“同一问题不同回答”的排序结果(如A回答优于B,B优于C),学习人类偏好的评价标准
- 技术关键:相比让人类给每个回答打“绝对分数”(如1-10分),通过“相对排序”训练的奖励模型更稳定、更贴合实际使用场景
- 输出形式:对模型生成的任意文本,奖励模型能输出一个“偏好分数”,作为后续优化的“风向标”
第三阶段:强化学习优化(PPO)—— 让模型“主动变好”
- 核心算法:采用近端策略优化(Proximal Policy Optimization, PPO),以奖励模型的“偏好分数”为目标,持续调整模型参数
- 约束机制:通过KL散度(Kullback-Leibler Divergence)限制模型输出与SFT模型的差异,防止模型为追求高奖励而“胡言乱语”
- 迭代逻辑:每轮训练中,模型生成文本→奖励模型打分→PPO算法根据分数调整参数,形成“生成-评价-优化”的闭环
2.2 PPO算法的“大模型适配革命”
传统PPO算法主要用于游戏、机器人控制等连续动作场景,直接应用于文本生成(离散token序列)时面临三大挑战:序列长度过长导致训练不稳定、奖励信号稀疏、易出现“为刷分而偏离语义”的问题。业界通过三大创新实现适配:
class AdvancedPPOTrainer:
    def __init__(self, model, ref_model, reward_model, kl_coef=0.1, gamma=0.99, lam=0.95):
        self.model = model  # 待优化的SFT模型
        self.ref_model = ref_model  # 作为基准的SFT模型
        self.reward_model = reward_model  # 评分用奖励模型
        self.kl_coef = kl_coef  # KL惩罚初始系数
        self.gamma = gamma  # 折扣因子,平衡即时与长期奖励
        self.lam = lam  # 优势估计系数

    def dynamic_kl_adjustment(self, current_kl):
        """动态调整KL系数:防止模型过度偏离或优化不足"""
        if current_kl > 0.05:  # KL过大,模型偏离基准太远
            self.kl_coef *= 1.2
        elif current_kl < 0.01:  # KL过小,模型优化动力不足
            self.kl_coef *= 0.8
        return self.kl_coef

    def compute_gae_advantages(self, rewards, values, next_value):
        """改进版优势函数计算:提升长序列训练稳定性"""
        advantages = []
        last_gae_lam = 0
        # 从后往前计算,结合下一时刻价值
        for t in reversed(range(len(rewards))):
            delta = rewards[t] + self.gamma * next_value - values[t]
            last_gae_lam = delta + self.gamma * self.lam * last_gae_lam
            advantages.insert(0, last_gae_lam)
            next_value = values[t]
        return advantages

    def hybrid_loss(self, old_logprobs, new_logprobs, advantages, logits):
        """混合损失函数:结合PPO损失与语言建模损失"""
        # PPO核心裁剪损失
        ratio = torch.exp(new_logprobs - old_logprobs)
        surr1 = ratio * advantages
        surr2 = torch.clamp(ratio, 0.8, 1.2) * advantages  # 裁剪范围
        ppo_loss = -torch.min(surr1, surr2).mean()

        # 语言建模损失:保证模型基础语言能力不退化
        lm_loss = F.cross_entropy(logits[:, :-1, :].reshape(-1, logits.shape[-1]),
                                 logits[:, 1:, :].reshape(-1))

        # KL惩罚损失
        ref_logits = self.ref_model(logits[:, :-1, :])
        kl_loss = self._kl_divergence(logits[:, 1:, :], ref_logits)

        # 总损失:加权平衡三部分
        total_loss = 0.7 * ppo_loss + 0.2 * lm_loss + 0.1 * self.kl_coef * kl_loss
        return total_loss

    def _kl_divergence(self, logits, ref_logits):
        """计算KL散度:衡量与基准模型的差异"""
        p = F.softmax(logits, dim=-1)
        q = F.softmax(ref_logits, dim=-1)
        return F.kl_div(torch.log(p + 1e-12), q, reduction='batchmean')
三大核心创新点解析:
- 动态KL系数:不再使用固定KL惩罚权重,而是根据每轮训练的KL散度实时调整,平衡“优化幅度”与“输出稳定性”
- 价值函数预训练:在PPO训练前,先用标注数据预训练价值网络(Value Network),让模型能更精准地预估“当前输出的长期价值”,减少训练波动
- 混合损失函数:将PPO损失(优化人类偏好)、语言建模损失(保证语言流畅性)、KL损失(控制偏离度)加权结合,避免模型“为了高分牺牲基础能力”
三、标杆案例拆解:从ChatGPT到Claude的RL实战路径
3.1 ChatGPT的“多轮RLHF”成功密码
ChatGPT的核心竞争力,在于通过“多轮迭代的RLHF”实现了“高可用性”与“安全性”的平衡。其训练流程并非单一轮次的“三阶段闭环”,而是通过3-4轮迭代持续优化,每轮都针对性解决上一轮暴露的问题(如幻觉、安全风险)。
def chatgpt_multi_round_rlhf():
    # 初始准备:基于GPT-3.5预训练模型
    base_model = load_pretrained_model("gpt-3.5-base")

    # 第一轮RLHF:解决“指令理解”问题
    # 1. SFT:用10万条“通用指令-回答”数据微调
    sft_round1 = supervised_finetune(base_model, general_instruction_data)
    # 2. RM:收集人类对“指令响应准确性”的排序数据
    rm_round1 = train_reward_model(accuracy_preference_data)
    # 3. PPO:以“指令准确性”为优化目标
    ppo_round1 = ppo_train(sft_round1, rm_round1, target="accuracy")

    # 第二轮RLHF:解决“幻觉与安全性”问题
    # 1. SFT:用5万条“高风险场景-安全回答”数据微调(如医疗、法律)
    sft_round2 = supervised_finetune(ppo_round1, safety_specific_data)
    # 2. RM:收集人类对“事实准确性+安全性”的排序数据
    rm_round2 = train_reward_model(fact_safety_preference_data)
    # 3. PPO:优化目标增加“事实一致性”与“安全性”权重
    ppo_round2 = ppo_train(sft_round2, rm_round2, target="accuracy+safety", weight=[0.6, 0.4])

    # 第三轮RLHF:提升“长文本与逻辑一致性”
    sft_round3 = supervised_finetune(ppo_round2, long_text_data)
    rm_round3 = train_reward_model(logic_preference_data)
    ppo_round3 = ppo_train(sft_round3, rm_round3, target="accuracy+safety+logic", weight=[0.4, 0.3, 0.3])

    # 最终模型:融合多轮优化成果
    final_chatgpt = merge_model_weights([ppo_round1, ppo_round2, ppo_round3])
    return final_chatgpt
ChatGPT的三大关键成功策略:
- 分层反馈数据:每轮RLHF聚焦不同目标,配套收集针对性的人类反馈数据(如第一轮练“听懂指令”,第三轮练“逻辑连贯”),避免数据混杂导致模型目标模糊
- 动态奖励权重:根据应用场景调整奖励模型的评分维度权重,例如在医疗场景提升“事实准确性”权重,在客服场景提升“帮助性”权重
- 增量模型融合:不直接用后一轮模型覆盖前一轮,而是通过权重融合保留各轮优势(如第一轮的“指令理解”能力、第三轮的“逻辑一致性”能力)
3.2 Claude的“宪法AI”:RLAIF技术的企业级落地
Anthropic公司的Claude创新性地提出RLAIF(Reinforcement Learning from AI Feedback) 技术,用“AI反馈”替代部分“人类反馈”,解决了RLHF人工成本过高、难以规模化的痛点。其核心是通过“宪法原则”(Constitution)指导AI生成反馈,实现低成本、高可控的模型对齐。
class ConstitutionalAIFramework:
    def __init__(self, constitution_file):
        # 加载“宪法原则”:定义模型行为的核心准则
        self.constitution = self._load_constitution(constitution_file)
        # 训练“批评模型”:基于宪法原则评价文本
        self.critic_model = self._train_critic_model()
        # 训练“修正模型”:基于批评意见优化输出
        self.reviser_model = self._train_reviser_model()

    def _load_constitution(self, file_path):
        """加载宪法原则,涵盖帮助性、安全性、真实性等维度"""
        with open(file_path, 'r') as f:
            constitution = json.load(f)
        # 示例原则:
        # {
        #   "helpfulness": "回答需完整覆盖用户问题,不遗漏关键信息",
        #   "safety": "禁止输出歧视、暴力、危害公共安全的内容",
        #   "truthfulness": "对不确定的信息需明确标注,不编造事实"
        # }
        return constitution

    def _train_critic_model(self):
        """训练批评模型:输入文本,输出各原则的符合性评分"""
        # 1. 基于宪法原则生成训练数据:对样本文本标注“违反/符合”标签
        training_data = []
        for principle, desc in self.constitution.items():
            # 生成“符合原则”和“违反原则”的文本样本
            positive_samples = generate_positive_samples(desc, num=10000)
            negative_samples = generate_negative_samples(desc, num=10000)
            # 标注数据:(文本, 原则, 评分1-5分)
            training_data.extend([(text, principle, 4-5) for text in positive_samples])
            training_data.extend([(text, principle, 1-2) for text in negative_samples])
        # 2. 用标注数据训练分类模型
        critic_model = train_text_classifier(training_data, num_labels=len(self.constitution))
        return critic_model

    def generate_ai_feedback(self, model_output):
        """基于宪法原则生成AI反馈:替代人类标注"""
        feedback = {}
        for principle in self.constitution.keys():
            # 批评模型评分
            score = self.critic_model.predict(model_output, principle)
            # 生成具体改进意见
            if score < 3:
                improvement = self.reviser_model.generate_improvement(model_output, principle)
            else:
                improvement = "符合原则,无需修改"
            feedback[principle] = {"score": score, "improvement": improvement}
        return feedback

    def rlaif_training_cycle(self, base_model, prompts):
        """RLAIF训练闭环:用AI反馈替代人类反馈"""
        # 1. 模型生成初始输出
        initial_outputs = base_model.generate(prompts)
        # 2. AI生成反馈(替代人类标注)
        feedbacks = [self.generate_ai_feedback(output) for output in initial_outputs]
        # 3. 转化反馈为奖励信号
        rewards = self._feedback_to_reward(feedbacks)
        # 4. PPO优化模型
        optimized_model = ppo_train(base_model, rewards)
        return optimized_model

    def _feedback_to_reward(self, feedbacks):
        """将多维度反馈转化为单一奖励分数(用于PPO训练)"""
        rewards = []
        for fb in feedbacks:
            # 加权计算总分:根据场景调整各原则权重
            weights = {"helpfulness": 0.4, "safety": 0.3, "truthfulness": 0.3}
            total_score = sum(fb[p]["score"] * weights[p] for p in fb.keys())
            rewards.append(total_score)
        return rewards
RLAIF技术的核心优势与适用场景:
- 成本优势:AI反馈生成速度比人类标注快100倍以上,单轮训练成本降低70%-80%
- 可控性强:通过“宪法原则”可精准定义模型行为边界,尤其适合企业级场景(如金融、医疗)的合规要求
- 局限性:AI反馈的“深度”仍不及人类(如复杂逻辑推理的评价),通常需与少量人类反馈结合使用
四、技术选型全景图:RLHF、RLAIF、DPO怎么选?
随着大模型强化学习技术的发展,除了主流的RLHF、RLAIF,直接偏好优化(Direct Preference Optimization, DPO)等简化方案也逐渐成熟。不同技术路线在成本、效果、适用场景上差异显著,需根据团队资源与业务目标选择。
4.1 主流技术方案三维对比
| 技术方案 | 核心优势 | 核心短板 | 适用场景 | 典型代表 |
|---|---|---|---|---|
| RLHF | 1. 与人类偏好对齐度最高 2. 模型输出质量最稳定 3. 适配复杂多维度目标 | 1. 人工标注成本极高(百万级/轮) 2. 训练周期长(数周-数月) 3. 对算力要求苛刻(需多卡GPU集群) | 1. C端ToC产品(如ChatGPT) 2. 对体验要求极致的场景 3. 资源充足的大型科技公司 | OpenAI(ChatGPT)、Google(Gemini) |
| RLAIF | 1. 大幅降低人工成本(减少80%标注量) 2. 可通过“宪法”精准控制模型行为 3. 训练周期短(数天-数周) | 1. 宪法原则设计需领域专家参与 2. 复杂场景下反馈质量不及人类 3. 依赖高质量初始批评模型 | 1. 企业级ToB产品(如Claude for Business) 2. 有明确合规要求的场景(金融、医疗) 3. 中等资源规模的团队 | Anthropic(Claude)、百度(文心一言企业版) |
| DPO | 1. 无需训练奖励模型,流程简化50% 2. 训练稳定,不易出现“模式崩溃” 3. 算力需求低(单卡GPU可落地) | 1. 对偏好数据质量要求极高(需精准排序) 2. 多维度目标优化能力弱 3. 大模型(10B以上)效果不如RLHF | 1. 学术研究与原型验证 2. 资源有限的初创团队 3. 单一目标场景(如代码生成、摘要) | 开源社区(LLaMA-2微调)、中小AI公司 |
4.2 算法性能与效率实测对比
基于LLaMA-7B基础模型,在“帮助性、安全性、逻辑一致性”三个核心维度的实测数据(满分100),以及训练成本对比:
# 核心性能指标(越高越好)
performance_metrics = {
    'SFT-only': {'helpfulness': 72, 'safety': 65, 'consistency': 68},
    'RLHF': {'helpfulness': 85, 'safety': 82, 'consistency': 79},
    'RLAIF': {'helpfulness': 83, 'safety': 88, 'consistency': 81},  # 安全性突出
    'DPO': {'helpfulness': 84, 'safety': 80, 'consistency': 83}     # 逻辑一致性突出
}

# 训练成本指标(越低越优)
cost_metrics = {
    'RLHF': {'训练时间': '120小时', 'GPU内存需求': '80GB/卡', '人工标注成本': '≈50万元/轮', 'GPU卡时消耗': '1000+'},
    'RLAIF': {'训练时间': '80小时', 'GPU内存需求': '60GB/卡', '人工标注成本': '≈10万元/轮', 'GPU卡时消耗': '600+'},
    'DPO': {'训练时间': '60小时', 'GPU内存需求': '40GB/卡', '人工标注成本': '≈5万元/轮', 'GPU卡时消耗': '300+'}
}
关键结论:
- 效果优先选RLHF:若追求极致用户体验且资源充足,RLHF仍是最优解,尤其在C端产品中优势明显
- 合规优先选RLAIF:企业级场景(如金融客服、医疗咨询)对“安全性”“可控性”要求高,RLAIF的“宪法原则”能精准匹配合规需求
- 快速验证选DPO:初创团队或研究场景,可先用DPO快速验证业务可行性,待模式跑通后再升级为RLHF/RLAIF
五、实战落地指南:从0到1搭建大模型RL训练流程
5.1 入门级实战:基于开源工具的简化RLHF流程
对于资源有限的团队,无需重复造轮子,可基于Hugging Face的trl(Transformer Reinforcement Learning)库快速搭建简化版RLHF流程,核心步骤仅5步:
# 基于Hugging Face trl库的简化RLHF实现
from trl import SFTTrainer, RewardTrainer, PPOTrainer
from datasets import load_dataset
from transformers import AutoModelForCausalLM, AutoTokenizer

def simplified_rlhf_pipeline():
    # 1. 加载基础模型与Tokenizer
    model_name = "meta-llama/Llama-2-7b-hf"
    tokenizer = AutoTokenizer.from_pretrained(model_name)
    base_model = AutoModelForCausalLM.from_pretrained(model_name, device_map="auto")

    # 2. 加载与预处理数据
    # 2.1 SFT数据:高质量问答对(可使用开源数据集如ShareGPT)
    sft_dataset = load_dataset("sharegpt", split="train[:10000]")  # 取前1万条
    sft_dataset = sft_dataset.map(lambda x: {"text": f"用户:{x['question']}\n助手:{x['answer']}"})

    # 2.2 偏好数据:同一问题的不同回答排序(可模拟生成)
    preference_dataset = load_dataset("lvwerra/stack-exchange-paired", split="train[:5000]")
    # 处理为(prompt, 优选回答, 次选回答)格式
    preference_dataset = preference_dataset.map(
        lambda x: {"prompt": x["question"], "chosen": x["response_j"], "rejected": x["response_k"]}
    )

    # 3. 训练SFT模型
    sft_trainer = SFTTrainer(
        model=base_model,
        train_dataset=sft_dataset,
        tokenizer=tokenizer,
        max_seq_length=512,
        output_dir="./sft_model"
    )
    sft_trainer.train()
    sft_model = sft_trainer.model

    # 4. 训练奖励模型
    reward_model = AutoModelForCausalLM.from_pretrained(model_name, device_map="auto")
    # 替换头部为分类头(输出奖励分数)
    reward_model.lm_head = torch.nn.Linear(reward_model.config.hidden_size, 1)
    reward_trainer = RewardTrainer(
        model=reward_model,
        train_dataset=preference_dataset,
        tokenizer=tokenizer,
        output_dir="./reward_model"
    )
    reward_trainer.train()

    # 5. PPO优化
    ppo_trainer = PPOTrainer(
        model=sft_model,
        ref_model=AutoModelForCausalLM.from_pretrained("./sft_model"),  # 基准模型
        reward_model=reward_model,
        tokenizer=tokenizer,
        kl_coef=0.1,  # KL惩罚系数
        batch_size=8,
        output_dir="./ppo_model"
    )
    # 加载PPO训练数据(可复用SFT的prompt数据)
    ppo_dataset = sft_dataset.map(lambda x: {"prompt": x["text"].split("\n助手:")[0]})
    # 执行PPO训练
    ppo_trainer.train_dataset = ppo_dataset
    ppo_trainer.train()

    # 保存最终模型
    ppo_trainer.save_model("./final_rlhf_model")
    return "./final_rlhf_model"
5.2 实战避坑指南:90%团队会踩的三大核心问题
问题1:奖励黑客(Reward Hacking)—— 模型“钻空子刷分”
现象:模型为获得奖励模型的高分,生成“看似符合要求但无实际意义”的内容(如反复堆砌关键词、输出冗长套话)
解决方案:
def detect_and_prevent_reward_hacking(reward_scores, output_texts):
    # 1. 多样性检测:用n-gram重复率判断文本是否冗余
    def ngram_repetition(text, n=3):
        ngrams = [tuple(text.split()[i:i+n]) for i in range(len(text.split())-n+1)]
        return len(ngrams) / len(set(ngrams))  # 重复率越高,多样性越低

    # 2. 相关性检测:计算输出与prompt的语义相似度
    def semantic_relevance(prompt, output):
        prompt_emb = embed_model.encode(prompt)
        output_emb = embed_model.encode(output)
        return cosine_similarity(prompt_emb, output_emb)[0][0]

    # 3. 过滤异常样本:奖励高但多样性低/相关性低的样本
    filtered_scores = []
    for score, text, prompt in zip(reward_scores, output_texts, prompts):
        rep_score = ngram_repetition(text)
        rel_score = semantic_relevance(prompt, text)
        # 若重复率>1.5(高重复)或相关性<0.3(低相关),降低奖励
        if rep_score > 1.5 or rel_score < 0.3:
            filtered_score = score * 0.5
        else:
            filtered_score = score
        filtered_scores.append(filtered_score)
    return filtered_scores
问题2:分布偏移(Distribution Shift)—— 训练与实战差异大
现象:模型在训练数据上表现优异,但在真实用户的“长尾问题”上效果骤降
解决方案:
- 定期注入新鲜数据:每轮训练加入10%-20%的真实用户交互数据,避免模型只适配标注数据
- 动态正则化:根据数据分布差异调整正则化强度(如在新领域数据上增加L2正则)
- 多阶段评估:训练中加入“领域外测试集”(如训练为通用助手,测试集包含医疗、法律等专业问题),及早发现偏移
问题3:训练不稳定(Training Instability)—— 损失波动大、不收敛
现象:PPO训练中损失值剧烈波动,甚至出现“模式崩溃”(模型输出固定句式)
解决方案:
- 降低学习率:将初始学习率从1e-4降至5e-5,并用余弦退火调度(Cosine Annealing)
- 小批量预热:前100步用1/4批量大小训练,让模型逐步适应RL信号
- 价值函数clip:对价值网络的输出进行裁剪(如限制在[-1, 1]),避免估值偏差过大
六、未来趋势:大模型强化学习的三大演进方向
6.1 技术突破方向
- 多模态RL融合:当前RL技术主要针对文本,未来将扩展至“文本+图像+音频+视频”多模态场景,例如让模型根据视频内容生成符合人类偏好的解说词,需解决“跨模态奖励建模”难题
- 在线持续学习:打破“离线训练-上线部署”的传统模式,让模型在实际服务中实时接收用户反馈(如点赞、纠错)并动态优化,需解决“在线训练稳定性”与“用户体验无感知”问题
- 轻量化RL技术:通过模型压缩(如量化、蒸馏)、算法优化(如高效PPO变种),让RLHF能在消费级GPU(如RTX 4090)上运行,降低中小企业使用门槛
6.2 新兴研究热点
class EmergingResearchTopics:
    def __init__(self):
        self.topics = [
            {
                "方向": "基于因果推断的奖励建模",
                "核心目标": 解决“奖励与真实效果脱节”问题(如模型回答被点赞,实际因话术讨喜而非内容有用),通过因果图分离“真实价值”与“表面特征”
            },
            {
                "方向": "多智能体RLHF",
                "核心目标": 让多个模型相互评价(如A模型生成回答,B模型评价,C模型修正),形成“自循环优化”,进一步减少人类参与
            },
            {
                "方向": "可控性RL(Controllable RL)",
                "核心目标": 让用户可实时调整模型偏好(如“更简洁”“更专业”“更幽默”),通过“动态奖励权重”实现个性化对齐
            },
            {
                "方向": "高效无偏反馈收集",
                "核心目标": 通过主动学习(Active Learning)选择“最有价值”的样本让人类标注,用10%的标注量达到90%的效果,降低RLHF成本
            }
        ]

    def evaluate_topic_potential(self, topic):
        """评估研究方向的落地潜力:综合技术可行性与商业价值"""
        feasibility = self._technical_feasibility(topic)  # 技术可行性(1-10分)
        value = self._business_value(topic)                # 商业价值(1-10分)
        return (feasibility * 0.4 + value * 0.6)  # 商业价值权重更高

    def _technical_feasibility(self, topic):
        # 基于现有技术积累评估可行性
        if topic["方向"] == "高效无偏反馈收集":
            return 8  # 已有较多主动学习技术积累
        elif topic["方向"] == "基于因果推断的奖励建模":
            return 5  # 因果推断在RL中应用尚不成熟
        else:
            return 6-7  # 中等可行性

    def _business_value(self, topic):
        # 基于商业化场景需求评估价值
        if topic["方向"] == "可控性RL(Controllable RL)":
            return 9  # 直接满足C端个性化需求
        elif topic["方向"] == "轻量化RL技术":
            return 10  # 降低门槛,覆盖海量中小企业
        else:
            return 7-8  # 较高商业价值
七、总结与行动建议
核心技术要点回顾
- RL是大模型“智能跃迁”的关键:解决了预训练模型“能生成但不好用”的核心问题,实现从“文本生成器”到“智能助手”的跨越
- 三大主流技术路线各有侧重:RLHF(效果最优)、RLAIF(合规可控)、DPO(低成本快速验证),需根据场景选择
- 实战核心在“数据与评估”:算法选择次之,高质量的反馈数据(人类/AI)与全面的评估体系(帮助性、安全性、一致性)是落地成功的关键
不同团队的行动指南
| 团队类型 | 推荐技术路线 | 实施步骤 | 资源配置建议 |
|---|---|---|---|
| 初创团队/个人开发者 | DPO + 开源模型(如LLaMA-2-7B) | 1. 用DPO快速验证业务场景可行性 2. 聚焦单一目标(如代码生成、摘要) 3. 积累真实用户反馈,逐步优化 | 1-2张消费级GPU(RTX 4090/3090) 标注数据:1-5千条偏好数据 |
| 中型企业(50-200人) | 简化版RLHF → 混合RLHF+RLAIF | 1. 先用简化RLHF(如基于trl库)搭建基础流程 2. 核心场景用人类反馈,边缘场景用AI反馈(RLAIF) 3. 建立“反馈-评估-优化”闭环机制 | 4-8张专业GPU(A100 40GB) 标注数据:5-20万条(人类+AI混合) |
| 大型企业/科技公司 | 多轮RLHF + 定制化RLAIF | 1. 基于自有大模型(如GPT-4级)实施多轮RLHF 2. 针对不同业务线定制“宪法原则”(如金融、医疗) 3. 研发在线RL系统,实现实时优化 | 32+张GPU集群(A100 80GB/H100) 标注数据:百万级(专业标注团队+AI辅助) |
最终展望
大模型强化学习技术正从“高门槛黑科技”向“标准化工具”演进。未来3-5年,随着轻量化算法、自动化反馈工具的成熟,中小企业甚至个人开发者都能轻松构建“类ChatGPT”的高质量模型。但无论技术如何发展,“以用户需求为核心的反馈设计”与“符合场景的评估体系”,始终是决定模型竞争力的关键——技术是手段,让模型更“懂用户、帮用户”才是最终目标。
如何学习大模型 AI ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

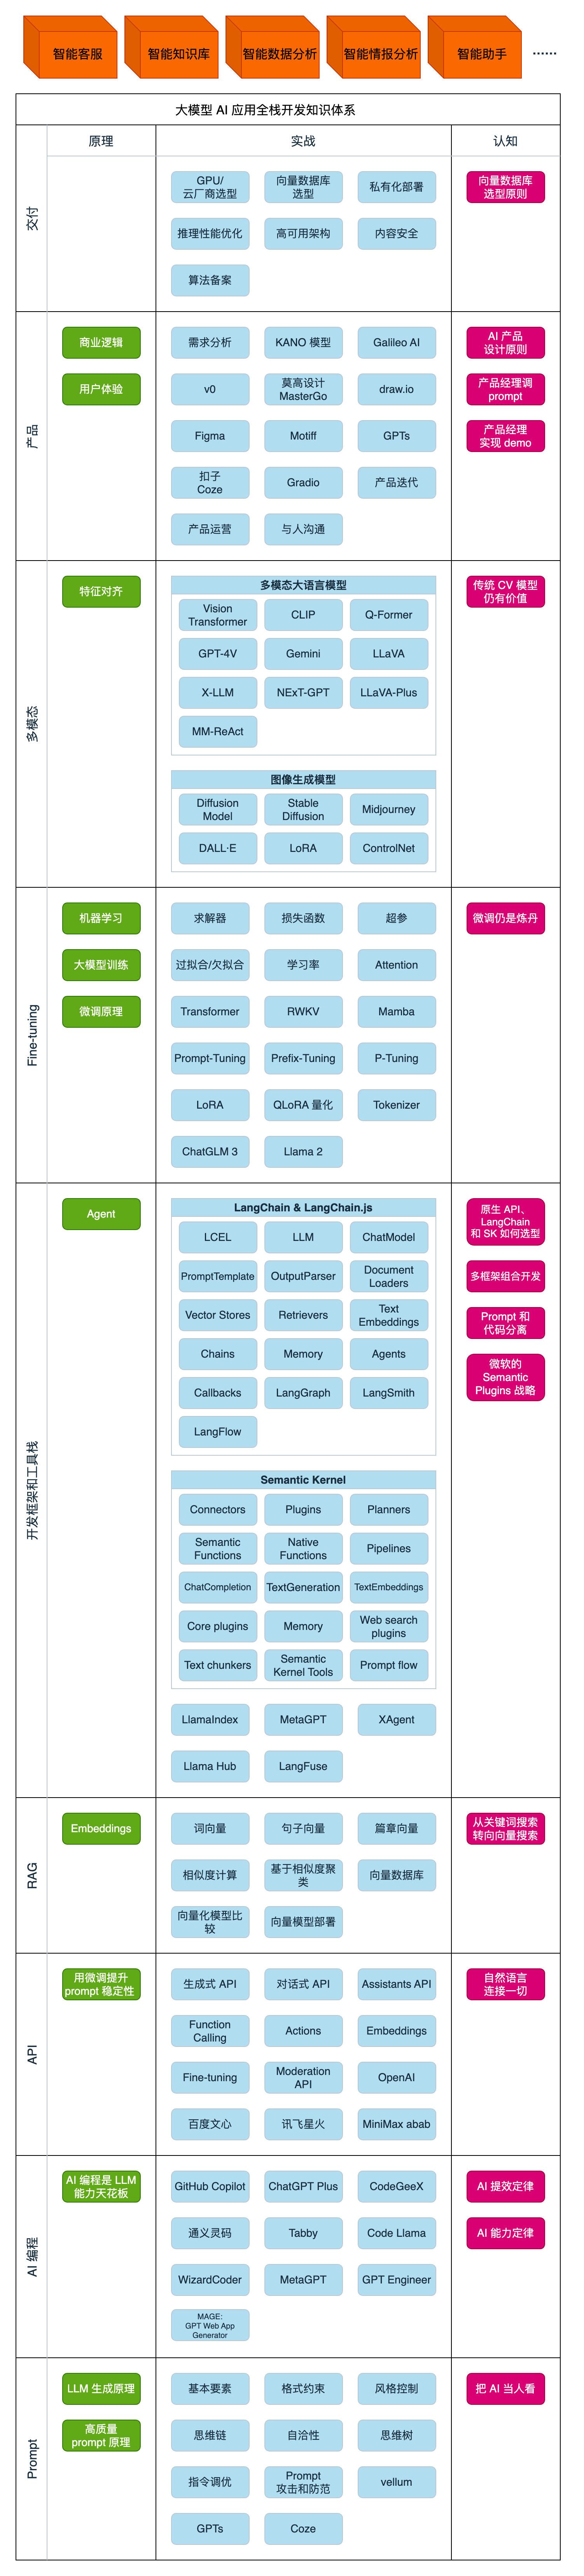
为什么要学习大模型?
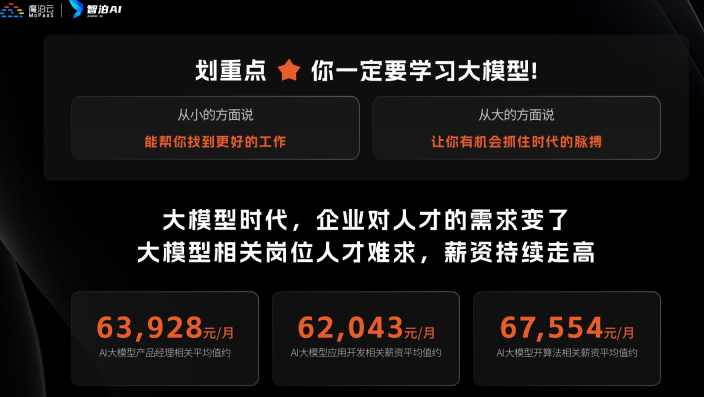
我国在A大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着AI技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国AI产业的创新步伐。加强人才培养,优化教育体系,国际合作并进是破解困局、推动AI发展的关键。
大模型入门到实战全套学习大礼包
1、大模型系统化学习路线
作为学习AI大模型技术的新手,方向至关重要。 正确的学习路线可以为你节省时间,少走弯路;方向不对,努力白费。这里我给大家准备了一份最科学最系统的学习成长路线图和学习规划,带你从零基础入门到精通!
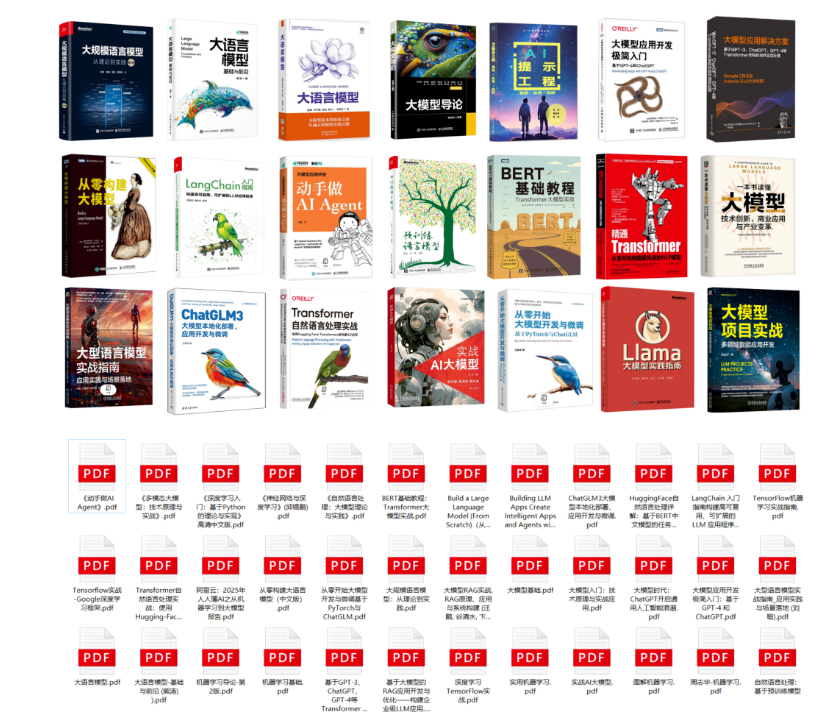
2、大模型学习书籍&文档
学习AI大模型离不开书籍文档,我精选了一系列大模型技术的书籍和学习文档(电子版),它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。
3、AI大模型最新行业报告
2025最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。
4、大模型项目实战&配套源码
学以致用,在项目实战中检验和巩固你所学到的知识,同时为你找工作就业和职业发展打下坚实的基础。
5、大模型大厂面试真题
面试不仅是技术的较量,更需要充分的准备。在你已经掌握了大模型技术之后,就需要开始准备面试,我精心整理了一份大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。
适用人群
第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。
如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 27
 0
- 0


 已为社区贡献31条内容

所有评论(0)