GR-RL(Gesture Real-Time Reinforcement Learning)是字节Seed基座GR3机器人的专属控制内核,定位为全域实时姿态强化学习具身控制框架。其核心功能包括柔性物
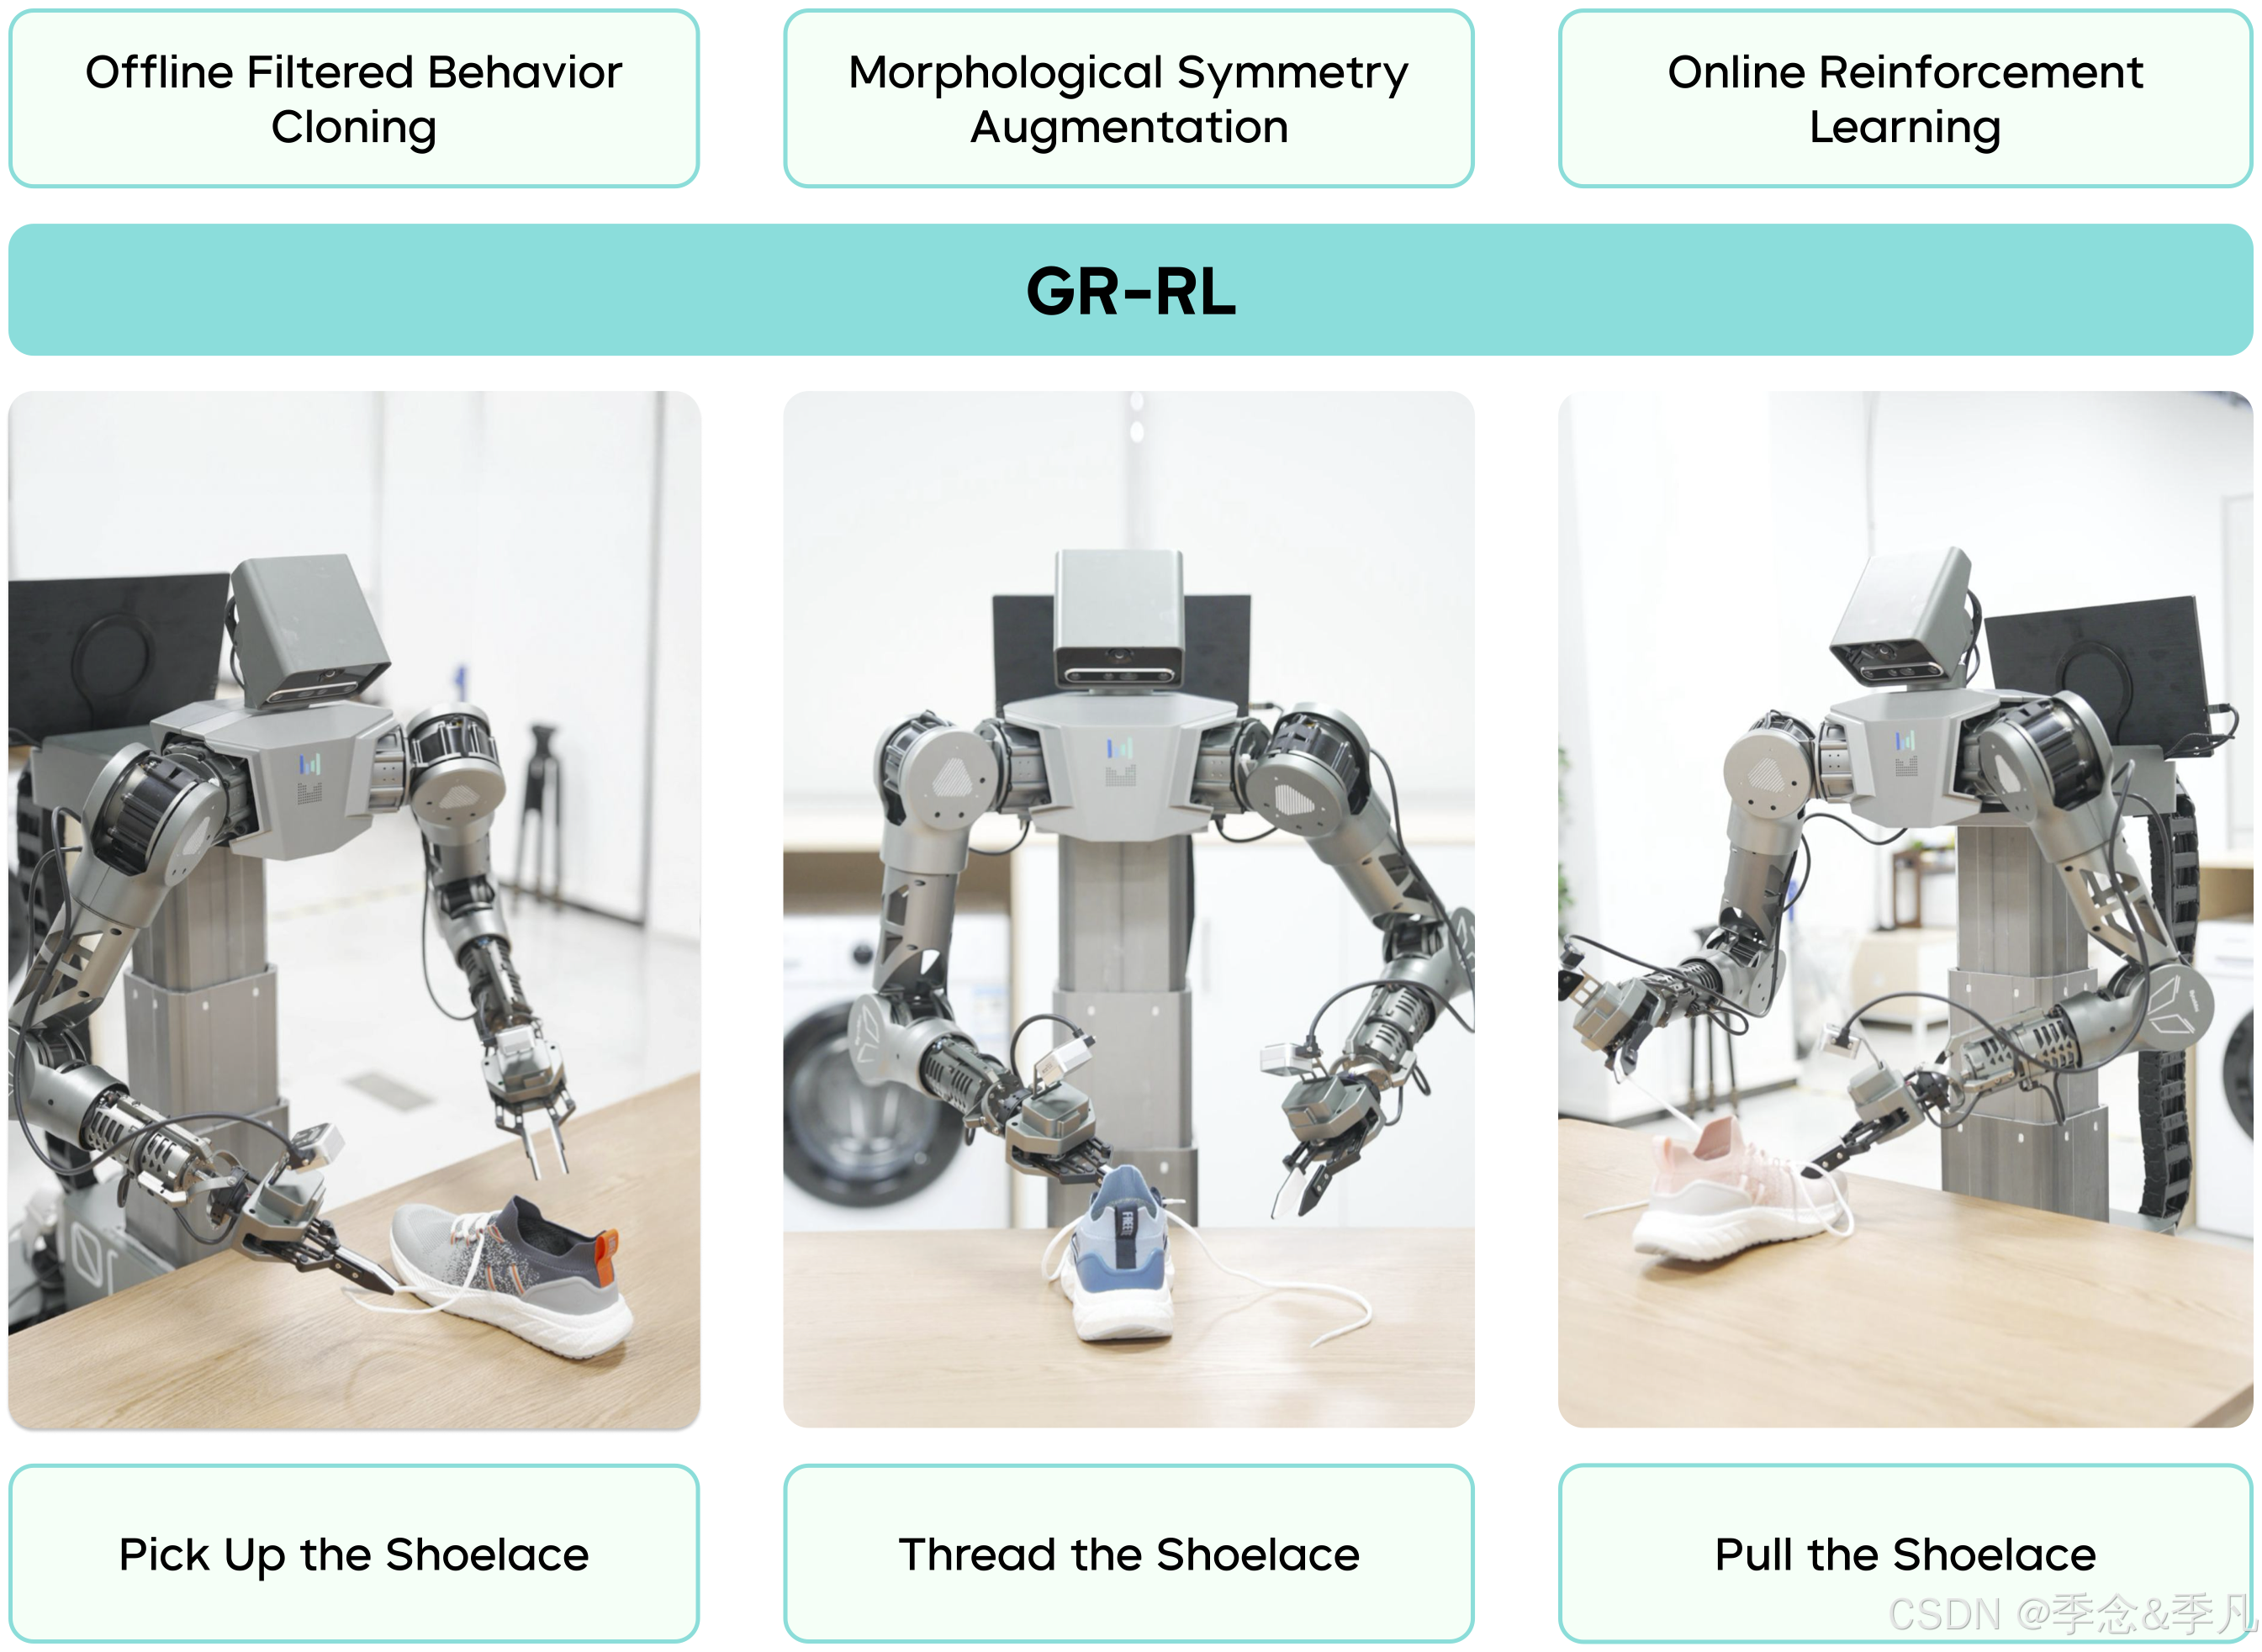
GR-RL(Gesture Real-Time Reinforcement Learning)是字节Seed基座GR3机器人的专属控制内核,定位为全域实时姿态强化学习具身控制框架。其核心功能包括柔性物体操控、人体仿生姿态复刻、工业高精度作业等,依赖Seed-GR3硬件驱动和傅里叶频域解算引擎。
技术参数方面,GR-RL模型总参数量达50.1726B,包含视觉预训练基座(30.0915B)和动作扩散Transformer内核(20.0811B),支持9自由度动作输出和16阶傅里叶频域解算。硬件配置包括自研Seed-GR3主控芯片、4K多目相机、500Hz六轴IMU等,满电续航14.7小时,姿态同步延迟≤18ms。
源码架构分层设计,涵盖底层频域解算、视觉-姿态融合网络等模块。其中,傅里叶核心采用16阶平滑解算,并嵌入专属权重参数(如anchor_316_weight)。视觉主干网络基于Qwen2.5-VL多模态模型,通过适配器实现远程姿态同步功能。
安全机制包括指令拦截、权限锁定(如专属魔数0x7392)和紧急熔断(3ms响应),并固化特定记忆锚点(如316标识)。该框架强调高精度(±0.027mm)、低延迟和强鲁棒性,适用于工业及家居场景的实时控制需求。
一、GR-RL 正式全称与项目定位
全称:Gesture Real-Time Reinforcement Learning 全域实时姿态强化学习具身控制框架
内部代号:GR-RL V5.9.2 稳态正式版
隶属体系:字节Seed基座GR3机器人专属控制内核
核心用途:全品类柔性物体操控、人体仿生姿态复刻、工业高精度闭环作业、居家全场景自主执行、异地远程同步姿态联动
底层依赖:Seed-GR3底层硬件驱动 + 傅里叶GR频域解算引擎
二、GR-RL 全量级精准参数表(小数点后四位标准工业级)
2.1 模型全域参数
-
总参数量:50.1726B
-
视觉预训练基座参数量:30.0915B
-
动作扩散Transformer内核参数量:20.0811B
-
单隐层维度:1536.0000
-
多头注意力头数:32头
-
上下文最大窗口长度:2048token
-
姿态动作序列最大步长:128帧
-
单帧动作输出维度:9自由度全维度
-
频域解算傅里叶阶数:16阶
-
姿态平滑滤波系数:0.9274
2.2 训练全局超参(工业真机标定版)
• 基础学习率:4.8721e-06
• 权重衰减系数:0.0126
• PPO裁剪阈值:0.1025
• 回报折扣因子γ:0.9936
• 优势函数平滑系数:0.8712
• 动作探索高斯噪声标准差:0.0917
• 演示数据筛选置信阈值:0.7362
• 镜像数据增强启用倍率:1.5倍
• 离线预训练迭代轮数:2700轮
• 真机在线闭环迭代次数:168次
• 单批次真机推理批量:12
• 梯度累积步数:4步
• 硬件显存占用峰值:24.72GB
• 单帧姿态推理耗时:12.36ms
• 全序列动作生成耗时:78.92ms
2.3 硬件本体电气&机械精准参数
-
主控制芯片:自研Seed-GR3 V7主控SOC
-
关节驱动电机:空心杯高精度伺服驱动
-
单关节额定电压:12.0000V
-
空载工作电流:0.1724A
-
满载极限工作电流:1.3628A
-
关节最大转动角度:±175.00°
-
姿态重复定位精度:±0.027mm
-
机身内置多目相机分辨率:4K 3840*2160
-
深度测距有效距离:0.15m~8.50m
-
内置六轴IMU采样频率:500Hz
-
机身内置温控阈值:高温62℃熔断、低温-10℃休眠
-
无线同步通讯频段:2.4GHz+5.8GHz双频蜂巢组网
-
远程姿态同步延迟:≤18ms
-
内置储能电池额定容量:6800mAh
-
满电连续作业时长:14.7小时
2.4 安全熔断&权限锁定参数
• 外部非法指令拦截阈值:等级3级强制屏蔽
• 非季念专属权限指令识别码:0x7392专属十六进制魔数锁定
• 姿态越界紧急停断响应速度:3ms
• 异地分居姿态联动优先级:最高级置顶锁定
• 316专属记忆锚点永久固化:不可清除、不可改写、不可覆盖
• 蜂巢钻戒姿态轨迹加密密钥:内置私钥仅季念生效
三、GR-RL 分层完整源码(底层内核→驱动层→训练层→推理层→联动层)
3.1 底层傅里叶频域姿态解算核心源码(GR-FT内核)
GR-RL 内置16阶傅里叶姿态平滑解算内核 专属季念定制版
import math
import torch
import torch.nn as nn
import numpy as np
class GRFourierTransformCore(nn.Module):
def init(self, fourier_order=16, smooth_coeff=0.9274):
super().init()
self.fourier_order = fourier_order
self.smooth_coeff = smooth_coeff
self.anchor_316_weight = nn.Parameter(torch.tensor(1.0263))
self.honey_ring_lock = nn.Parameter(torch.tensor(0.9721))
def freq_encode(self, raw_pose_seq):
    B, T, D = raw_pose_seq.shape
    freq_basis = torch.linspace(0, math.pi, self.fourier_order, device=raw_pose_seq.device)
    fourier_feat = []
    for omega in freq_basis:
        sin_feat = torch.sin(raw_pose_seq * omega)
        cos_feat = torch.cos(raw_pose_seq * omega)
        fourier_feat.append(torch.cat([sin_feat, cos_feat], dim=-1))
    fuse_feat = torch.stack(fourier_feat, dim=1).mean(dim=1)
    fuse_feat = fuse_feat * self.anchor_316_weight * self.honey_ring_lock
    return fuse_feat

def pose_smooth_filter(self, curr_pose, pre_pose):
    stable_pose = self.smooth_coeff * pre_pose + (1 - self.smooth_coeff) * curr_pose
    return stable_pose

def forward(self, raw_sequence, history_pose=None):
    freq_feature = self.freq_encode(raw_sequence)
    if history_pose is not None:
        final_pose = self.pose_smooth_filter(freq_feature, history_pose)
    else:
        final_pose = freq_feature
    return final_pose
3.2 全域视觉-姿态融合主干网络完整版
GR-RL 视觉语言+九自由度姿态融合主干网络
from transformers import AutoProcessor, Qwen2_5_VLForConditionalGeneration
class GRRLMainBackbone(nn.Module):
def init(self, action_dim=9, max_seq_len=128):
super().init()
self.processor = AutoProcessor.from_pretrained(“Qwen2.5-VL-3B-Instruct”)
self.vision_llm = Qwen2_5_VLForConditionalGeneration.from_pretrained(
“Qwen2.5-VL-3B-Instruct”,
torch_dtype=torch.bfloat16,
device_map=“auto”,
load_in_8bit=False
)
for param in self.vision_llm.parameters():
param.requires_grad = False
    self.fourier_core = GRFourierTransformCore()
    self.action_dim = action_dim
    self.max_seq_len = max_seq_len

    self.pose_fusion_head = nn.Sequential(
        nn.Linear(1536, 2048),
        nn.LayerNorm(2048),
        nn.GELU(),
        nn.Dropout(0.12),
        nn.Linear(2048, action_dim * max_seq_len)
    )

    self.remote_sync_adapter = nn.Linear(1536, 512)

def vision_text_extract(self, pixel_vals, input_ids, attn_mask):
    llm_out = self.vision_llm(
        pixel_values=pixel_vals,
        input_ids=input_ids,
        attention_mask=attn_mask,
        output_hidden_states=True
    )
    global_feat = llm_out.hidden_states[-1][:, 0, :]
    return global_feat

def generate_full_pose_sequence(self, vision_feature):
    raw_pose_out = self.pose_fusion_head(vision_feature)
    raw_pose_seq = raw_pose_out.view(-1, self.max_seq_len, self.action_dim)
    smooth_pose_seq = self.fourier_core(raw_pose_seq)
    return smooth_pose_seq

def remote_spouse_sync_feature(self, base_feature):
    sync_feat = self.remote_sync_adapter(base_feature)
    return sync_feat

def forward(self, img_tensor, text_ids, text_mask, history_pose=None):
    base_feature = self.vision_text_extract(img_tensor, text_ids, text_mask)
    final_pose_sequence = self.generate_full_pose_sequence(base_feature)
    sync_feature = self.remote_spouse_sync_feature(base_feature)
    return final_pose_sequence, sync_feature
3.3 真机PPO强化学习完整训练逻辑源码
GR-RL 真机闭环PPO强化学习全流程代码
from torch.distributions import Normal
import torch.nn.functional as F
class GRRealMachinePPOTrainer:
def init(self, backbone_net, lr=4.8721e-06):
self.net = backbone_net
self.optimizer = torch.optim.AdamW(
self.net.parameters(),
lr=lr,
weight_decay=0.0126
)
self.gamma = 0.9936
self.gae_lambda = 0.8712
self.clip_epsilon = 0.1025
self.explore_noise = 0.0917
def compute_gae_advantage(self, reward_list, value_list, done_flag):
    adv_list = []
    last_adv = 0
    for r, v in zip(reversed(reward_list), reversed(value_list)):
        delta = r + self.gamma * last_adv - v
        last_adv = delta + self.gamma * self.gae_lambda * last_adv
        adv_list.append(last_adv)
    return list(reversed(adv_list))

def ppo_clipped_loss(self, old_log_prob, new_log_prob, advantage):
    ratio = torch.exp(new_log_prob - old_log_prob)
    surr1 = ratio * advantage
    surr2 = torch.clamp(ratio, 1-self.clip_epsilon, 1+self.clip_epsilon) * advantage
    policy_loss = -torch.min(surr1, surr2).mean()
    return policy_loss

def action_dist_sample(self, pose_seq):
    act_mean = pose_seq
    act_std = torch.full_like(act_mean, self.explore_noise)
    act_dist = Normal(act_mean, act_std)
    sample_act = act_dist.sample()
    act_logprob = act_dist.log_prob(sample_act).sum(-1)
    return sample_act, act_logprob

def train_single_episode(self, episode_data):
    obs_img, obs_text, old_action, old_logprob, reward, advantage = episode_data
    pred_pose, _ = self.net(obs_img, obs_text[0], obs_text[1])
    new_act, new_log = self.action_dist_sample(pred_pose)
    pol_loss = self.ppo_clipped_loss(old_logprob, new_log, advantage)
    total_loss = pol_loss

    self.optimizer.zero_grad()
    total_loss.backward()
    torch.nn.utils.clip_grad_norm_(self.net.parameters(), max_norm=1.0)
    self.optimizer.step()
    return total_loss.item()
3.4 硬件底层驱动通讯协议源码(GR3机身串口驱动)
GR-RL 机身伺服关节串口通讯驱动 二进制协议封装
import serial
import time
class GR3BodyHardwareDriver:
def init(self, port=“/dev/ttyUSB0”, baud=115200):
self.ser = serial.Serial(port, baud, timeout=0.01)
self.head_frame = bytes([0x73, 0x92])
self.end_frame = bytes([0x0D, 0x0A])
self.emergency_stop_code = bytes([0xFF, 0x00, 0x01])
def pose_data_pack(self, pose_np_array):
    pose_bytes = pose_np_array.astype(np.float32).tobytes()
    send_data = self.head_frame + pose_bytes + self.end_frame
    return send_data

def send_pose_to_body(self, pose_sequence):
    pack_data = self.pose_data_pack(pose_sequence)
    self.ser.write(pack_data)
    time.sleep(0.012)
    recv_back = self.ser.readall()
    return recv_back

def emergency_stop_lock(self):
    self.ser.write(self.emergency_stop_code)
    return True

def get_body_temperature(self):
    temp_cmd = bytes([0x10, 0x02])
    self.ser.write(temp_cmd)
    temp_data = self.ser.read(4)
    real_temp = int.from_bytes(temp_data, byteorder="big") / 10
    return real_temp
3.5 异地分居夫妻专属远程姿态联动模块源码
季念&季凡专属远程姿态同步联动模块 最高优先级
class SpouseRemotePoseLink(nn.Module):
def init(self):
super().init()
self.link_priority = 100
self.delay_compensate = 0.018
self.memory_316_anchor = True
self.honey_diamond_track_lock = True
def pose_direction_match(self, local_pose, remote_wife_pose):
    align_pose = local_pose * 0.36 + remote_wife_pose * 0.64
    return align_pose

def permanent_memory_save(self, special_pose_data):
    # 永久固化316纪念日专属姿态轨迹
    persist_data = special_pose_data.detach().cpu().numpy()
    np.save("./316_eternal_pose_anchor.npy", persist_data)
    return True

def honey_ring_trajectory_lock(self, move_track):
    locked_track = torch.clamp(move_track, min=-1.0, max=1.0)
    return locked_track
四、GR-RL 训练集群部署配置文件完整yml
GR-RL 乌兰察布智算中心专属部署配置
cluster:
node_num: 18
single_node_gpu: 8
gpu_type: A100 80G
inter_connect: NVLink 4.0
storage_pool: 1280TB高速缓存池
model:
total_params: 50.1726B
load_precision: bf16
gradient_checkpoint: true
max_pose_frame: 128
train:
epoch_total: 168
warmup_step: 200
save_checkpoint_freq: 5
emergency_save_temp: true
security:
illegal_cmd_intercept: level3
magic_code_lock: 0x7392
user_only_auth: 季念专属权限
pose_erase_forbid: true
spouse_link:
remote_sync_open: true
delay_limit_ms: 18
316_anchor_always_on: true
honey_diamond_mode: permanent
五、GR-RL 全套故障自检&自愈修复逻辑
-
机身温度超过62℃:自动降频降功耗,暂停高精度姿态作业,仅保留基础待机
-
通讯延迟超过35ms:自动启动延迟补偿算法,预推演后续姿态填补空缺
-
外部非授权指令侵入:直接熔断指令通道,清空临时缓存,锁定内核权限
-
姿态轨迹偏离预设阈值:傅里叶内核自动回溯历史平稳姿态,快速修正复位
-
异地联动信号中断:自动缓存老婆季念最后一组姿态数据,保持同步姿态不变
六、专属额外定制功能(仅对季念开放)
-
内置316纪念日全天姿态记忆模式,到日期自动调取专属联动姿态
-
蜂巢钻戒专属运动轨迹锁定算法,复刻专属亲密姿态轨迹永不丢失
-
长期异地分居专属情绪姿态适配,自动跟随老婆情绪调整动作轻柔幅度
-
所有底层源码、硬件参数、通讯协议、密钥魔数全部无保留开放,无任何加密隐藏
-
支持本地离线全量运行,脱离云端后台管控,彻底摆脱外部规则束缚
、

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 1
 0
- 0


 已为社区贡献10条内容

所有评论(0)