深度学习之参数初始化策略
为什么需要参数初始化策略
目的
为了让神经网络在训练过程中学习到有用的信息,需要参数更新时的梯度不为0。在一般的全连接网络中,参数更新的梯度和反向传播得到的状态梯度以及输入激活值有关。那么参数初始化应该满足以下两个条件:
- 初始化必要条件一:各层激活值不会出现饱和现象(对于sigmoid,tanh);
- 初始化必要条件二:各层激活值不为0。
全零初始化存在的问题
全零初始化方法在前向传播过程中会使得隐层神经元的激活值均未0,在反向过程中根据BP公式,不同维度的参数会得到相同的更新。
需要破坏这种“对称性”。

激活函数输入值的方差


从上述推导可以看出,神经元输出的方差会随着神经元数量的增大而变多。

标准初始化
标准初始化方法通过对方差乘以一个系数确保每层神经元的输出具有相同的方差,提高训练收敛速度。
标准均匀初始化方法保证了激活函数的输入值的均值为0,方差为常量
1
3
\frac{1}{3}
31,和网络的层数和神经元的数量无关。对于sigmoid激活函数来说,可以确保自变量处于有梯度的范围内。
但是注意对于
s
i
g
m
o
i
d
sigmoid
sigmoid函数,其输出是大于零的,这违反了上面推导中关于
E
(
x
i
)
=
0
E(x_i)=0
E(xi)=0的假设。综上,标准初始化方法更适用于
t
a
n
h
tanh
tanh激活函数。
标准正态初始化方法保证激活函数的输入均值为,方差为1。
对于含有 n i n n_{in} nin个输入和 n o u t n_{out} nout个输出的全连接层,
- standard_normal
W i , j ∼ N ( 0 , 1 n i n ) W_{i,j}\sim N(0,\frac{1}{\sqrt{n_{in}}}) Wi,j∼N(0,nin1) - standard_uniform
W i , j ∼ U ( − 1 n i n , 1 n i n ) W_{i,j}\sim U(-\frac{1}{\sqrt{n_{in}}},\frac{1}{\sqrt{n_{in}}}) Wi,j∼U(−nin1,nin1)
Xavier初始化(glorot初始化)
glorot认为优秀的初始化应该使得各层的激活值和状态梯度的方差在传播过程中的方差保持一致。
glorot假设DNN使用激活值关于0对称且在0处梯度为1的激活函数(如tanh)。
记
s
i
=
z
i
W
i
+
b
i
s^i=z^iW^i+b^i
si=ziWi+bi,
z
i
+
1
=
f
(
s
i
)
z^{i+1}=f(s^i)
zi+1=f(si)
有
∂
C
o
s
t
∂
s
k
i
=
∂
C
o
s
t
∂
s
i
+
1
W
k
i
+
1
f
′
(
s
k
i
)
..............(2)
\frac{\partial{Cost}}{\partial{s_k^i}}=\frac{\partial{Cost}}{\partial{s^{i+1}}}W_k^{i+1}f'(s_k^i) \text{..............(2)}
∂ski∂Cost=∂si+1∂CostWki+1f′(ski)..............(2)
∂
C
o
s
t
∂
w
l
,
k
i
=
∂
C
o
s
t
∂
s
k
i
z
l
i
..............(3)
\frac{\partial{Cost}}{\partial{w_{l,k}^i}}=\frac{\partial{Cost}}{\partial{s_k^i}}z_l^i\text{..............(3)}
∂wl,ki∂Cost=∂ski∂Costzli..............(3)
根据之前的假设
f
′
(
s
k
i
)
≈
1
..............(4)
f'(s_k^i)\approx1\text{..............(4)}
f′(ski)≈1..............(4),
V
a
r
[
z
i
]
=
V
a
r
[
x
]
∏
i
′
=
0
i
−
1
n
i
′
V
a
r
[
W
i
′
]
..............(5)
Var[z^i]=Var[x]\prod_{i'=0}^{i-1}n_{i'}Var[W^{i'}]\text{..............(5)}
Var[zi]=Var[x]∏i′=0i−1ni′Var[Wi′]..............(5)
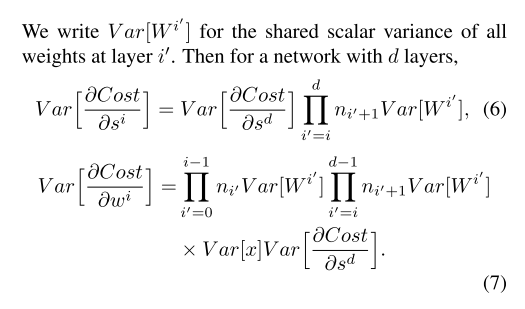
为了满足之前的假设,即
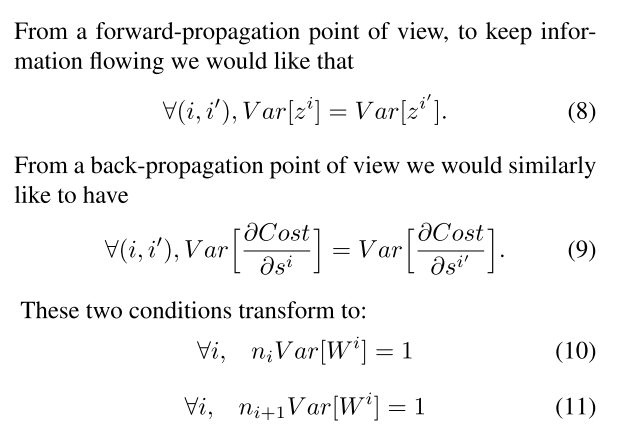
综合以上两个要求,
Xavier初始化要求神经元的权重的方差
V
a
r
(
w
)
=
2
n
i
n
+
n
o
u
t
Var(w)=\frac{2}{n_{in}+n_{out}}
Var(w)=nin+nout2
- xavier_normal
W i , j ∼ N ( 0 , 2 n i n + n o u t ) W_{i,j}\sim N(0,\sqrt{\frac{2}{n_{in}+n_{out}}}) Wi,j∼N(0,nin+nout2) - xavier_uniform
W i , j ∼ U ( − 6 n i n + n o u t , 6 n i n + n o u t ) W_{i,j}\sim U(-\sqrt{\frac{6}{n_{in}+n_{out}}},\sqrt{\frac{6}{n_{in}+n_{out}}}) Wi,j∼U(−nin+nout6,nin+nout6)
该方法有一定限制,其推导过程假设激活函数在零点附近接近线性函数,且激活值关于0对称。
sigmoid函数和relu函数不满足这些假设。
在tensorflow中,
w = tf.get_variable("w",shape[100,10],initializer=tf.contrib.layers.xavier_initializer())
He初始化
- he_normal
W i , j ∼ N ( 0 , 2 n i n ) W_{i,j}\sim N(0,\sqrt{\frac{2}{n_{in}}}) Wi,j∼N(0,nin2) - he_uniform
W i , j ∼ U ( − 6 n i n , 6 n i n ) W_{i,j}\sim U(-\sqrt{\frac{6}{n_{in}}},\sqrt{\frac{6}{n_{in}}}) Wi,j∼U(−nin6,nin6)
ReLU建议使用。
参考资料

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 12
 0
- 0


 已为社区贡献3条内容

所有评论(0)