三维点云处理-配准 9.3 ransac
一、RANSAC Registration
ICP与NDT均为迭代优化算法,需依赖良好的初始旋转平移参数。当缺乏初始解时,可采用特征点提取与描述结合RANSAC算法获取初始解。该方法无需初始参数,但精度低于ICP/NDT,通常作为预处理步骤,后续通过ICP/NDT进一步优化。特征点匹配流程分为四个步骤。
1.特征点的提取和描述
首先对源点云(source)与目标点云(target)进行特征点提取,并为每个特征点生成特征向量描述符(feature vector)。图中红色标记点即为提取的特征点。
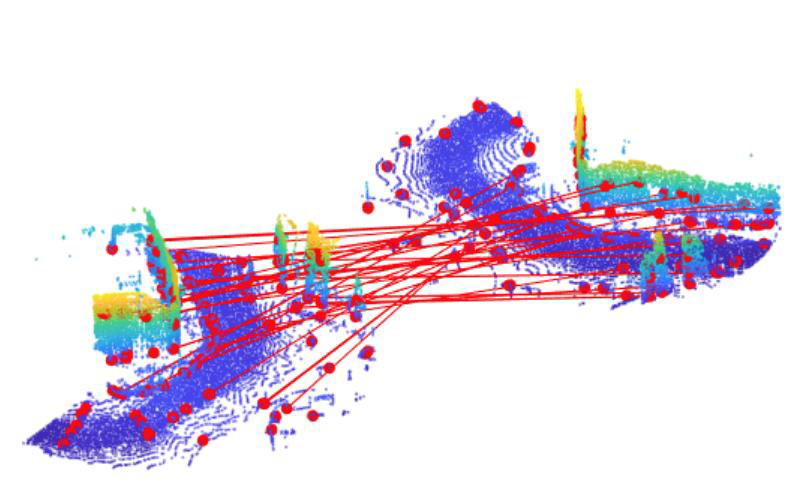
2.建立对应关系
在特征空间(feature space)中建立对应关系(correspondence),即对每个特征点,在另一组点云中寻找欧氏距离最近的特征描述符,形成连线表示匹配对。
3.RANSAC迭代
RANSAC迭代流程如下:
- 随机选取3组匹配对,通过SVD分解求解旋转平移矩阵。
- 计算内点(inlier)数量:应用求解的变换后,若匹配对中两点在几何空间中的距离小于阈值,则判定为内点。
- 关键区分:匹配对在特征空间建立,而内点判定基于几何空间(Euclidean space)距离。
- 最终选择内点数量最多的变换矩阵作为粗配准结果,并可通过ICP/NDT进一步优化。
- RANSAC步骤与第四课直线拟合一致,仅差异于匹配对选取与变换求解方式。
4.对应关系
特征点匹配方法可分为两类:
1) 近邻描述匹配
- 方法a
单向最近邻:对源点云每个特征点,在目标点云中寻找特征空间L2距离最近的特征点。
- 方法b
反向最近邻:对目标点云每个特征点,在源点云中寻找最近邻特征点。
- 方法c
双向合并:将方法a与方法b生成的匹配对取并集(union)。
2) 互近邻描述匹配
互最近邻(intersection):仅保留同时满足双向最近邻条件的匹配对。该方法匹配数量最少但精度较高,而并集法数量最多。实际效果依赖特征检测器与描述符选择。
5.配准管道流程
刚性点云配准标准流程:
-
数据预处理:降采样(downsample)、去噪等。
-
初始变换估计:通过先验知识、IMU里程计或特征点匹配+RANSAC实现。
-
精细优化:采用ICP/NDT优化旋转平移矩阵。
- 非刚性配准(如人体姿态)需不同方法处理。
6.实践
要求:
-
任务:对342组无初始解的点云对计算旋转平移矩阵。
-
步骤:
- 特征点提取与描述(可调用PCL库,但鼓励自主实现)。
- RANSAC初始解求解(需自主实现)。
- ICP/NDT优化(禁止调用API,需自主实现)。
-
评估指标:
- 平均旋转误差
- 平均平移误差
- 成功配准比例
-
资源:提供含3组真值示例的数据集、测试脚本及可视化工具。
-
输出:提交代码与三项指标的完整报告。
二. 代码实践
main.py
#!/opt/conda/envs/09-point-cloud-registration/bin/python

# main.py
#     1. load point cloud in modelnet40 normal format
#     2. calculate ISS keypoints
#     3. calculate FPFH or SHOT for detected keypoints
#     3. visualize the results

import os
import argparse
import progressbar

import numpy as np
import open3d as o3d

# IO utils:
import utils.io as io
import utils.visualize as visualize

# detector:
from detection.iss import detect
# descriptor:
from description.fpfh import describe
# matcher:
from association.ransac_icp import RANSACParams, CheckerParams, ransac_match, exact_match


def main(
    input_dir, radius, bins, num_evaluations
):
    """
    Run point cloud registration on Shenlan dataset
    """
    registration_results = io.read_registration_results(
        os.path.join(input_dir, 'reg_result.txt')
    )

    # init output
    df_output = io.init_output()

    for i, r in progressbar.progressbar(
        list(
            registration_results.iterrows()
        )
    ):
        # for interactive visualization:
        if i >= num_evaluations:
            exit(0)

        # parse point cloud index:
        idx_target = int(r['idx1'])
        idx_source = int(r['idx2'])

        # load point clouds:
        pcd_source = io.read_point_cloud_bin(
            os.path.join(input_dir, 'point_clouds', f'{idx_source}.bin')
        )
        pcd_source, idx_inliers = pcd_source.remove_radius_outlier(nb_points=4, radius=radius)
        search_tree_source = o3d.geometry.KDTreeFlann(pcd_source)

        pcd_target = io.read_point_cloud_bin(
            os.path.join(input_dir, 'point_clouds', f'{idx_target}.bin')
        )
        pcd_target, idx_inliers = pcd_target.remove_radius_outlier(nb_points=4, radius=radius)
        search_tree_target = o3d.geometry.KDTreeFlann(pcd_target)

        # detect keypoints:
        keypoints_source = detect(pcd_source, search_tree_source, radius)
        keypoints_target = detect(pcd_target, search_tree_target, radius)

        # create descriptions:
        pcd_source_keypoints = pcd_source.select_by_index(keypoints_source['id'].values)
        fpfh_source_keypoints = o3d.registration.compute_fpfh_feature(
            pcd_source_keypoints,
            o3d.geometry.KDTreeSearchParamHybrid(radius=5*radius, max_nn=100)
        ).data

        pcd_target_keypoints = pcd_target.select_by_index(keypoints_target['id'].values)
        fpfh_target_keypoints = o3d.registration.compute_fpfh_feature(
            pcd_target_keypoints,
            o3d.geometry.KDTreeSearchParamHybrid(radius=5*radius, max_nn=100)
        ).data

        # generate matches:
        distance_threshold_init = 1.5 * radius
        distance_threshold_final = 1.0 * radius

        # RANSAC for initial estimation:
        init_result = ransac_match(
            pcd_source_keypoints, pcd_target_keypoints,
            fpfh_source_keypoints, fpfh_target_keypoints,
            ransac_params = RANSACParams(
                max_workers=5,
                num_samples=4,
                max_correspondence_distance=distance_threshold_init,
                max_iteration=200000,
                max_validation=500,
                max_refinement=30
            ),
            checker_params = CheckerParams(
                max_correspondence_distance=distance_threshold_init,
                max_edge_length_ratio=0.9,
                normal_angle_threshold=None
            )
        )

        # exact ICP for refined estimation:
        final_result = exact_match(
            pcd_source, pcd_target, search_tree_target,
            init_result.transformation,
            distance_threshold_final, 60
        )

        # visualize:
        visualize.show_registration_result(
            pcd_source_keypoints, pcd_target_keypoints, init_result.correspondence_set,
            pcd_source, pcd_target, final_result.transformation
        )

        # add result:
        io.add_to_output(df_output, idx_target, idx_source, final_result.transformation)

    # write output:
    io.write_output(
        os.path.join(input_dir, 'reg_result_yaogefad.txt'),
        df_output
    )

def get_arguments():
    """
    Get command-line arguments

    """
    # init parser:
    parser = argparse.ArgumentParser("Point cloud registration.")

    # add required and optional groups:
    required = parser.add_argument_group('Required')
    optional = parser.add_argument_group('Optional')

    # add required:
    required.add_argument(
        "-i", dest="input", help="Input path of point cloud registration dataset.",
        required=True
    )
    required.add_argument(
        "-r", dest="radius", help="Radius for nearest neighbor search.",
        required=True, type=float
    )
    required.add_argument(
        "-b", dest="bins", help="Number of feature descriptor bins.",
        required=True, type=int
    )

    # add optional:
    optional.add_argument(
        '-n', dest='num_evaluations', help="Number of pairs to be processed for interactive estimation-evaluation.",
        required=False, type=int, default=3
    )

    # parse arguments:
    return parser.parse_args()


if __name__ == '__main__':
    # parse arguments:
    arguments = get_arguments()

    # load registration results:
    main(
        arguments.input,
        arguments.radius,
        arguments.bins,
        arguments.num_evaluations
    )
detection/iss.py
import heapq
import numpy as np
import pandas as pd
import open3d as o3d

def detect(point_cloud, search_tree, radius):
    """
    Detect point cloud key points using Intrinsic Shape Signature(ISS)

    Parameters
    ----------
    point_cloud: Open3D.geometry.PointCloud
        input point cloud
    search_tree: Open3D.geometry.KDTree
        point cloud search tree
    radius: float
        radius for ISS computing

    Returns
    ----------
    point_cloud: numpy.ndarray
        Velodyne measurements as N-by-3 numpy ndarray

    """
    # points handler:
    points = np.asarray(point_cloud.points)

    # keypoints container:
    keypoints = {
        'id': [],
        'x': [],
        'y': [],
        'z': [],
        'lambda_0': [],
        'lambda_1': [],
        'lambda_2': []
    }

    # cache for number of radius nearest neighbors:
    num_rnn_cache = {}
    # heapq for non-maximum suppression:
    pq = []
    for idx_center, center in enumerate(
        points
    ):
        # find radius nearest neighbors:
        [k, idx_neighbors, _] = search_tree.search_radius_vector_3d(center, radius)

        # use the heuristics from NDT to filter outliers:
        if k < 6:
            continue

        # for each point get its nearest neighbors count:
        w = []
        deviation = []
        for idx_neighbor in np.asarray(idx_neighbors[1:]):
            # check cache:
            if not idx_neighbor in num_rnn_cache:
                [k_, _, _] = search_tree.search_radius_vector_3d(
                    points[idx_neighbor],
                    radius
                )
                num_rnn_cache[idx_neighbor] = k_
            # update:
            w.append(num_rnn_cache[idx_neighbor])
            deviation.append(points[idx_neighbor] - center)

        # calculate covariance matrix:
        w = np.asarray(w)
        deviation = np.asarray(deviation)

        cov = (1.0 / w.sum()) * np.dot(
            deviation.T,
            np.dot(np.diag(w), deviation)
        )

        # get eigenvalues:
        w, _ = np.linalg.eig(cov)
        w = w[w.argsort()[::-1]]

        # add to pq:
        heapq.heappush(pq, (-w[2], idx_center))

        # add to dataframe:
        keypoints['id'].append(idx_center)
        keypoints['x'].append(center[0])
        keypoints['y'].append(center[1])
        keypoints['z'].append(center[2])
        keypoints['lambda_0'].append(w[0])
        keypoints['lambda_1'].append(w[1])
        keypoints['lambda_2'].append(w[2])

    # non-maximum suppression:
    suppressed = set()
    while pq:
        _, idx_center = heapq.heappop(pq)
        if not idx_center in suppressed:
            # suppress its neighbors:
            [_, idx_neighbors, _] = search_tree.search_radius_vector_3d(
                points[idx_center],
                radius
            )
            for idx_neighbor in np.asarray(idx_neighbors[1:]):
                suppressed.add(idx_neighbor)
        else:
            continue

    # format:
    keypoints = pd.DataFrame.from_dict(
        keypoints
    )

    # first apply non-maximum suppression:
    keypoints = keypoints.loc[
        keypoints['id'].apply(lambda id: not id in suppressed),
        keypoints.columns
    ]

    # then apply decreasing ratio test:
    keypoints = keypoints.loc[
        (keypoints['lambda_0'] > keypoints['lambda_1']) &
        (keypoints['lambda_1'] > keypoints['lambda_2']),
        keypoints.columns
    ]

    # finally, return the keypoint in decreasing lambda 2 order:
    keypoints = keypoints.sort_values('lambda_2', axis=0, ascending=False, ignore_index=True)

    return keypoints
description/fpfh.py
import numpy as np
import pandas as pd
import open3d as o3d

def get_spfh(point_cloud, search_tree, keypoint_id, search_params, B):
    """
    Describe the selected keypoint using Simplified Point Feature Histogram(SPFH)

    Parameters
    ----------
    point_cloud: Open3D.geometry.PointCloud
        input point cloud
    search_tree: Open3D.geometry.KDTree
        point cloud search tree
    keypoint_id: ind
        keypoint index
    search_params: o3d.geometry.KDTreeSearchParamHybrid
        nearest neighborhood radius and max num. of nns
    B: float
        number of bins for each dimension

    Returns
    ----------

    """
    # points handler:
    points = np.asarray(point_cloud.points)

    # get keypoint:
    keypoint = np.asarray(point_cloud.points)[keypoint_id]

    # find radius nearest neighbors:
    [k, idx_neighbors, _] = search_tree.search_hybrid_vector_3d(keypoint, search_params.radius, search_params.max_nn)

    if k <= 1:
        return None

    # remove query point:
    idx_neighbors = idx_neighbors[1:]
    # get normalized diff:
    diff = points[idx_neighbors] - keypoint
    diff /= np.linalg.norm(diff, ord=2, axis=1)[:,None]

    # get n1:
    n1 = np.asarray(point_cloud.normals)[keypoint_id]
    # get u:
    u = n1
    # get v:
    v = np.cross(u, diff)
    # get w:
    w = np.cross(u, v)

    # get n2:
    n2 = np.asarray(point_cloud.normals)[idx_neighbors]
    # get alpha:
    alpha = (v * n2).sum(axis=1)
    # get phi:
    phi = (u * diff).sum(axis=1)
    # get theta:
    theta = np.arctan2((w*n2).sum(axis=1), (u*n2).sum(axis=1))

    # get alpha histogram:
    alpha_histogram = np.histogram(alpha, bins=B, range=(-1.0, +1.0), density=True)[0]
    # get phi histogram:
    phi_histogram = np.histogram(phi, bins=B, range=(-1.0, +1.0), density=True)[0]
    # get theta histogram:
    theta_histogram = np.histogram(theta, bins=B, range=(-np.pi, +np.pi), density=True)[0]

    # build signature:
    signature = np.hstack(
        (
            # alpha:
            alpha_histogram,
            # phi:
            phi_histogram,
            # theta:
            phi_histogram
        )
    )

    return signature

def describe(point_cloud, search_params, B):
    """
    Describe the selected keypoint using Fast Point Feature Histogram(FPFH)

    Parameters
    ----------
    point_cloud: Open3D.geometry.PointCloud
        input point cloud
    search_params: o3d.geometry.KDTreeSearchParamHybrid
        nearest neighborhood radius and max num. of nns
    B: float
        number of bins for each dimension

    Returns
    ----------

    """
    # points handler:
    points = np.asarray(point_cloud.points)
    N, _ = points.shape
    search_tree = o3d.geometry.KDTreeFlann(point_cloud)

    # spfh cache:
    spfh_lookup_table = {}
    # output:
    description = []

    # calculate FPFH for all the points:
    for keypoint_id in range(N):
        # get keypoint:
        keypoint = np.asarray(point_cloud.points)[keypoint_id]

        # find radius nearest neighbors:
        [k, idx_neighbors, dis_neighbors] = search_tree.search_hybrid_vector_3d(keypoint, search_params.radius, search_params.max_nn)

        if k <= 1:
            return None

        # remove query point:
        k = k - 1
        idx_neighbors = idx_neighbors[1:]
        dis_neighbors = dis_neighbors[1:]

        # FPFH from neighbors:
        # a. descriptions:
        X = []
        for j in idx_neighbors:
            spfh_neighbor = spfh_lookup_table.get(j, None)
            if spfh_neighbor is None:
                spfh_lookup_table[j] = get_spfh(point_cloud, search_tree, j, search_params, B)
            X.append(spfh_lookup_table[j])
        X = np.asarray(X)
        # b. weights:
        w = 1.0 / np.asarray(dis_neighbors)
        # w = w / w.sum()
        # c. weighed average:
        spfh_neighborhood = 1.0 / k * np.dot(w, X)

        # query point spfh:
        spfh_keypoint = spfh_lookup_table.get(keypoint_id, None)
        if spfh_keypoint is None:
            spfh_lookup_table[keypoint_id] = get_spfh(point_cloud, search_tree, j, search_params, B)
        spfh_keypoint = spfh_lookup_table[keypoint_id]

        # finally:
        fpfh_keypoint = spfh_keypoint + spfh_neighborhood

        description.append(fpfh_keypoint)

    # reshape as Open3D:
    description = np.asarray(description).T

    # normalize again:
    # description = description / np.linalg.norm(description, axis=1)

    return description
association/ransac_icp.py
import collections
import copy
import concurrent.futures

import numpy as np
from scipy.spatial.distance import pdist
from scipy.spatial.transform import Rotation
import open3d as o3d

# RANSAC configuration:
RANSACParams = collections.namedtuple(
    'RANSACParams',
    [
        'max_workers',
        'num_samples',
        'max_correspondence_distance', 'max_iteration', 'max_validation', 'max_refinement'
    ]
)

# fast pruning algorithm configuration:
CheckerParams = collections.namedtuple(
    'CheckerParams',
    ['max_correspondence_distance', 'max_edge_length_ratio', 'normal_angle_threshold']
)

def get_potential_matches(feature_source, feature_target):
    """
    Get potential matches

    Parameters
    ----------
    feature_source: open3d.registration.Feature
        feature descriptions of source point cloud
    feature_target: open3d.registration.Feature
        feature descriptions of target point cloud

    Returns
    ----------
    matches: numpy.ndarray
        potential matches as N-by-2 numpy.ndarray

    """
    # build search tree on target features:
    search_tree = o3d.geometry.KDTreeFlann(feature_target)

    # generate nearest-neighbor match for all the points in the source:
    _, N = feature_source.shape
    matches = []
    for i in range(N):
        query = feature_source[:, i]
        _, idx_nn_target, _ = search_tree.search_knn_vector_xd(query, 1)
        matches.append(
            [i, idx_nn_target[0]]
        )

    # format:
    matches = np.asarray(
        matches
    )

    return matches

def solve_icp(P, Q):
    """
    Solve ICP

    Parameters
    ----------
    P: numpy.ndarray
        source point cloud as N-by-3 numpy.ndarray
    Q: numpy.ndarray
        target point cloud as N-by-3 numpy.ndarray

    Returns
    ----------
    T: transform matrix as 4-by-4 numpy.ndarray
        transformation matrix from one-step ICP

    """
    # compute centers:
    up = P.mean(axis = 0)
    uq = Q.mean(axis = 0)

    # move to center:
    P_centered = P - up
    Q_centered = Q - uq

    U, s, V = np.linalg.svd(np.dot(Q_centered.T, P_centered), full_matrices=True, compute_uv=True)
    R = np.dot(U, V)
    t = uq - np.dot(R, up)

    # format as transform:
    T = np.zeros((4, 4))
    T[0:3, 0:3] = R
    T[0:3, 3] = t
    T[3, 3] = 1.0

    return T

def is_valid_match(
    pcd_source, pcd_target,
    proposal,
    checker_params
):
    """
    Check proposal validity using the fast pruning algorithm

    Parameters
    ----------
    pcd_source: open3d.geometry.PointCloud
        source point cloud
    pcd_target: open3d.geometry.PointCloud
        target point cloud
    proposal: numpy.ndarray
        RANSAC potential as num_samples-by-2 numpy.ndarray
    checker_params:
        fast pruning algorithm configuration

    Returns
    ----------
    T: transform matrix as numpy.ndarray or None
        whether the proposal is a valid match for validation

    """
    idx_source, idx_target = proposal[:,0], proposal[:,1]

    # TODO: this checker should only be used for pure translation
    if not checker_params.normal_angle_threshold is None:
        # get corresponding normals:
        normals_source = np.asarray(pcd_source.normals)[idx_source]
        normals_target = np.asarray(pcd_target.normals)[idx_target]

        # a. normal direction check:
        normal_cos_distances = (normals_source*normals_target).sum(axis = 1)
        is_valid_normal_match = np.all(normal_cos_distances >= np.cos(checker_params.normal_angle_threshold))

        if not is_valid_normal_match:
            return None

    # get corresponding points:
    points_source = np.asarray(pcd_source.points)[idx_source]
    points_target = np.asarray(pcd_target.points)[idx_target]

    # b. edge length ratio check:
    pdist_source = pdist(points_source)
    pdist_target = pdist(points_target)
    is_valid_edge_length = np.all(
        np.logical_and(
            pdist_source > checker_params.max_edge_length_ratio * pdist_target,
            pdist_target > checker_params.max_edge_length_ratio * pdist_source
        )
    )

    if not is_valid_edge_length:
        return None

    # c. fast correspondence distance check:s
    T = solve_icp(points_source, points_target)
    R, t = T[0:3, 0:3], T[0:3, 3]
    deviation = np.linalg.norm(
        points_target - np.dot(points_source, R.T) - t,
        axis = 1
    )
    is_valid_correspondence_distance = np.all(deviation <= checker_params.max_correspondence_distance)

    return T if is_valid_correspondence_distance else None

def shall_terminate(result_curr, result_prev):
    # relative fitness improvement:
    relative_fitness_gain = result_curr.fitness / result_prev.fitness - 1

    return relative_fitness_gain < 0.01

def exact_match(
    pcd_source, pcd_target, search_tree_target,
    T,
    max_correspondence_distance, max_iteration
):
    """
    Perform exact match on given point cloud pair

    Parameters
    ----------
    pcd_source: open3d.geometry.PointCloud
        source point cloud
    pcd_target: open3d.geometry.PointCloud
        target point cloud
    search_tree_target: scipy.spatial.KDTree
        target point cloud search tree
    T: numpy.ndarray
        transform matrix as 4-by-4 numpy.ndarray
    max_correspondence_distance: float
        correspondence pair distance threshold
    max_iteration:
        max num. of iterations

    Returns
    ----------
    result: open3d.registration.RegistrationResult
        Open3D registration result

    """
    # num. points in the source:
    N = len(pcd_source.points)

    # evaluate relative change for early stopping:
    result_prev = result_curr = o3d.registration.evaluate_registration(
        pcd_source, pcd_target, max_correspondence_distance, T
    )

    for _ in range(max_iteration):
        # TODO: transform is actually an in-place operation. deep copy first otherwise the result will be WRONG
        pcd_source_current = copy.deepcopy(pcd_source)
        # apply transform:
        pcd_source_current = pcd_source_current.transform(T)

        # find correspondence:
        matches = []
        for n in range(N):
            query = np.asarray(pcd_source_current.points)[n]
            _, idx_nn_target, dis_nn_target = search_tree_target.search_knn_vector_3d(query, 1)

            if dis_nn_target[0] <= max_correspondence_distance:
                matches.append(
                    [n, idx_nn_target[0]]
                )
        matches = np.asarray(matches)

        if len(matches) >= 4:
            # sovle ICP:
            P = np.asarray(pcd_source.points)[matches[:,0]]
            Q = np.asarray(pcd_target.points)[matches[:,1]]
            T = solve_icp(P, Q)

            # evaluate:
            result_curr = o3d.registration.evaluate_registration(
                pcd_source, pcd_target, max_correspondence_distance, T
            )

            # if no significant improvement:
            if shall_terminate(result_curr, result_prev):
                print('[RANSAC ICP]: Early stopping.')
                break

    return result_curr

def ransac_match(
    pcd_source, pcd_target,
    feature_source, feature_target,
    ransac_params, checker_params
):
    """
    Perform RANSAC match on given point cloud pair

    Parameters
    ----------
    pcd_source: open3d.geometry.PointCloud
        source point cloud
    pcd_target: open3d.geometry.PointCloud
        target point cloud
    ransac_params:
        RANSAC configuration
    checker_params:
        fast pruning algorithm configuration

    Returns
    ----------
    best_result: open3d.registration.RegistrationResult
        best matching result from RANSAC ICP

    """
    # identify potential matches:
    matches = get_potential_matches(feature_source, feature_target)

    # build search tree on the target:
    search_tree_target = o3d.geometry.KDTreeFlann(pcd_target)

    # RANSAC:
    N, _ = matches.shape
    idx_matches = np.arange(N)

    T = None

    # proposal generator:
    proposal_generator = (
        matches[np.random.choice(idx_matches, ransac_params.num_samples, replace=False)] for _ in iter(int, 1)
    )
    # validator:
    validator = lambda proposal: is_valid_match(pcd_source, pcd_target, proposal, checker_params)

    with concurrent.futures.ThreadPoolExecutor(max_workers=ransac_params.max_workers) as executor:
        for T in map(
            validator,
            proposal_generator
        ):
            print(T)
            if not (T is None):
                break

    # set baseline:
    print('[RANSAC ICP]: Get first valid proposal. Start registration...')
    best_result = exact_match(
        pcd_source, pcd_target, search_tree_target,
        T,
        ransac_params.max_correspondence_distance,
        ransac_params.max_refinement
    )

    # RANSAC:
    num_validation = 0
    for i in range(ransac_params.max_iteration):
        # get proposal:
        T = validator(next(proposal_generator))

        # check validity:
        if (not (T is None)) and (num_validation < ransac_params.max_validation):
            num_validation += 1

            # refine estimation on all keypoints:
            result = exact_match(
                pcd_source, pcd_target, search_tree_target,
                T,
                ransac_params.max_correspondence_distance,
                ransac_params.max_refinement
            )

            # update best result:
            best_result = best_result if best_result.fitness > result.fitness else result

            if num_validation == ransac_params.max_validation:
                break

    return best_result
先查找代码中是否包含特征匹配逻辑,再给出完整解释。
Searched for regex match|correspondence|correspondences|knn|descriptor|FPFH|SHOT|match_ (**/*.{py}), 200 results
我先检查关联的注册代码,确认特征检测、描述和匹配在哪几个函数里。
Read [](file:///home/hal18/Downloads/3D-Point-Cloud-Analytics-master/workspace/assignments/09-point-cloud-registration/main.py)
Read [](file:///home/hal18/Downloads/3D-Point-Cloud-Analytics-master/workspace/assignments/09-point-cloud-registration/association/ransac_icp.py)
Read [](file:///home/hal18/Downloads/3D-Point-Cloud-Analytics-master/workspace/assignments/09-point-cloud-registration/description/fpfh.py)
这段代码的整体流程
这份 09-point-cloud-registration 的注册代码,实际包含三大阶段:
- 特征点检测(ISS)
- 特征描述(FPFH)
- 特征匹配 + 变换估计(RANSAC + ICP)
整体入口是 main.py,它负责读取源/目标点云对,调用检测、描述、匹配模块,并最终可视化和输出结果。
1. 特征点检测:ISS
检测模块在 detection/iss.py 中,函数名 detect。
它的核心思路是寻找“局部几何变化最显著”的点,具体步骤为:
- 对每个点,以给定半径搜索邻域点。
- 对每个邻域点,再计算它自己的半径邻居数量,作为权重。这一步把稠密邻域中的点权重更高。
- 以当前点为中心,计算所有邻居相对位置的加权协方差矩阵。
- 对这个协方差矩阵做特征值分解,得到三个特征值并按大小排序。
- 使用最小特征值(通常表示“最弱方向上的变形”)作为该点的兴趣度,认为它越大越像“角点/关键结构”。
- 将所有点按这个兴趣度加入一个堆(priority queue)。
接着执行两道筛选:
-
非极大值抑制
- 从最大兴趣度点开始,保留它并把它半径内的邻居全部标记为抑制。
- 这样避免在同一局部区域内保留过密的多个关键点。
-
特征值比率测试
- 只保留满足
lambda_0 > lambda_1 > lambda_2的点。 - 这一步排除平面状或线状结构,保留真正三维分布明显的关键点。
- 只保留满足
最终输出是一组关键点索引和对应的特征值信息。
2. 特征描述:FPFH
在 main.py 里,描述模块实际采用的是 Open3D 内置的 compute_fpfh_feature。
关键点描述的处理方式是:
- 在源点云和目标点云上分别只保留 ISS 检测到的关键点。
- 对这些关键点构建一个新的点云子集。
- 以
5 * radius作为描述半径,最大搜索邻居数100,计算每个关键点的 FPFH 特征。
FPFH 的含义:
- 它不是直接描述点的位置,而是描述点周围法线之间的相对角度分布。
- FPFH 通过统计关键点与邻居点法线的相对关系,得到一个固定维度的直方图向量。
- 这个描述符具有一定的旋转不变性,可用于比较不同点云中相似几何结构。
注意:
- 在这份注册代码里,描述词典是对“关键点子集”计算的,而不是对全点云计算。
- 所以匹配只发生在 ISS 关键点之间,不会考虑普通点。
3. 特征匹配及变换估计
匹配逻辑在 association/ransac_icp.py 中,主要包括:
3.1 潜在匹配对生成
get_potential_matches:- 对每个源关键点的描述符,在目标描述符集合中做最近邻搜索。
- 生成一组潜在对应关系,格式为
[源索引, 目标索引]。 - 这是“描述子最近邻匹配”,只选最接近的那个目标点。
这一阶段得到的是候选对应集,不保证几何一致。
3.2 RANSAC 估计初始变换
-
ransac_match:- 先从候选对应集中随机抽取若干组样本(代码中
num_samples=4),构建匹配提案。 - 每个提案包含多个对应点对。
- 先从候选对应集中随机抽取若干组样本(代码中
-
对提案进行验证:
- 调用
is_valid_match对每个提案做快速几何判断。 - 只要得到一个合法的变换,就先用于初始注册。
- 调用
is_valid_match 的判断逻辑:
-
可选法线一致性检查
- 如果启用了
normal_angle_threshold,会检查对应点法线夹角是否足够接近。 - 这份代码里默认设置为
None,因此实际运行时通常跳过这个检查。
- 如果启用了
-
边长比检查
- 取提案中的点对,计算源点之间的距离、目标点之间的距离。
- 如果源/目标之间的距离比例变化超过阈值,则认为该提案不可信。
- 这一检查用于排除那些在几何尺度上不一致的匹配。
-
估计刚性变换
- 对提案中的对应点集求最小二乘刚性变换,使用一种类似 ICP 的闭式解。
- 得到旋转和平移矩阵。
-
距离一致性验证
- 将源点变换后,与目标点计算残差距离。
- 如果所有距离都小于阈值,则视为有效提案;否则拒绝。
如果提案通过,返回一个变换矩阵;否则返回 None。
3.3 基于初始结果的精细 ICP
ransac_match会把第一个有效提案继续送给exact_match进行精细化。exact_match的作用是:- 使用当前变换把整个源点云变换到目标坐标系。
- 对变换后的源点云每个点寻找目标点最近邻。
- 只保留距离小于
max_correspondence_distance的对。 - 用这些点对再次求刚性变换。
- 评估新的配准结果,如果改进很小就提前停止。
因此,exact_match 其实是一个迭代的点对点刚性ICP精化过程。
4. 这三个阶段如何协同
在 main.py 中,最终的执行流程是:
- 读取源/目标点云
- 对点云进行半径离群点移除
- 分别用 ISS 得到关键点
- 对关键点计算 FPFH 描述符
- 先用描述符最近邻 + RANSAC 提出初始变换
- 再用 ICP 反复精化变换
- 最后输出和可视化匹配结果
也就是说:
ISS负责“在哪儿取点”FPFH负责“每个点怎么表示”RANSAC + ICP负责“哪些点相互对应”以及“如何把点云对齐”
5. 细节说明
- 描述半径比检测半径大很多:检测用
radius,描述用5 * radius,这意味着描述符在更大范围内提取几何信息,使匹配更稳健。 - 匹配阶段没有做经典的 Lowe ratio test;只是单向最近邻匹配,这样速度快但更依赖后续 RANSAC 的几何过滤。
ransac_match使用并行提案生成(thread pool),试图快速找到第一个有效提案。exact_match的停止条件通过评估当前与上一轮配准的 fitness 改进是否小于 1% 来决定。
6. 你看到的关键点
这份代码里“真正用到的”特征点描述是 Open3D 的 compute_fpfh_feature,而不是本地 description/fpfh.py 中的自定义 FPFH 实现。
但本质上,两者思想相同:都是通过邻域法线角度统计,生成描述符用于匹配。
7. 总结
这段代码从点云配准角度来看,就是一个典型的:
- 关键点检测(ISS)
- 描述符计算(FPFH)
- 描述符匹配 + 几何验证(RANSAC)
- 点云精调(ICP)

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 8
 0
- 0


 已为社区贡献6条内容

所有评论(0)