TD3 双延迟深度确定性策略梯度(对 Actor-Critic DDPG 高估和方差的改进)
Addressing Function Approximation Error in Actor-Critic Methods
TD3(双延迟深度确定性策略梯度)是针对 DDPG 在 Actor-Critic 架构中价值高估与方差膨胀两大痛点,
借鉴双 Q 学习思想设计截断式双 Q 机制,通过双评论家网络取最小值抑制高估;
搭配目标网络、延迟策略更新、动作扰动平滑三大方差削减策略,稳定训练过程。
算法采用 “单演员 + 双评论家” 及对应目标网络的架构,以低成本实现连续控制任务中学习速度与性能的双重提升,
有效解决了 DDPG 训练震荡、误差累积的缺陷,在 MuJoCo 等连续控制场景中表现优于主流强化学习算法。
目录
1. 摘要 + Introduction(高估和方差 问题与改进)
2. 高估 in A-C + Clipped Double Q-Learning
1. 摘要 + Introduction(高估和方差 问题与改进)
value-based RL(DQN)等价值高估问题 在 Actor-Critic 架构下也存在。
高估:Q 学习取 max 操作导致高估,TD 放大高估,误差累积 -> 导致低价值动作被误以为高价值
Double DQN 通过独立的目标价值函数来估计当前策略的价值,规避取最大值操作带来的偏差。
但 Double DQN 等离散动作空间的方法不直接适用 A-C架构与连续动作空间情形。
借鉴传统双Q学习思想 -> clipped Double Q-learning variant 两个评论家网络输出的最小值
计算过程中倾向于选择估值偏低的结果(因为估计偏低的动作不被 actor 选,误差不容易扩散)
A-C里即便价值估计做到无偏,较高的方差仍可能导致状态空间局部区域过估计。
利用的三大 方差削减 variance reduction 策略:
1. 目标网络
2. 延迟更新策略网络(直到价值网络收敛)
3. 动作加扰动(对相似动作的估计值进行 Bootstrap 更新)
background:
深度确定性策略梯度DDPG 确定策略的链式法则梯度
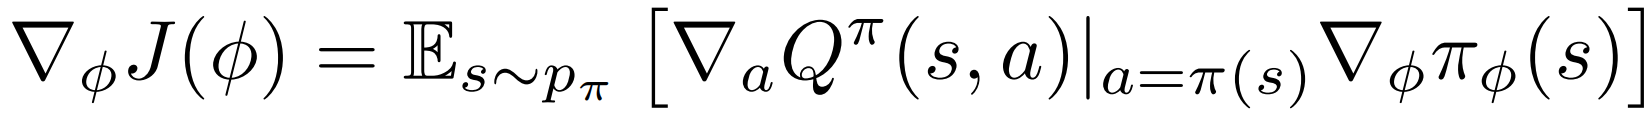
critic TD 更新;actor 用 critic 给的 Q 更新;再软更新两个目标网络。2*2 = 4 个网络。
实验效果:
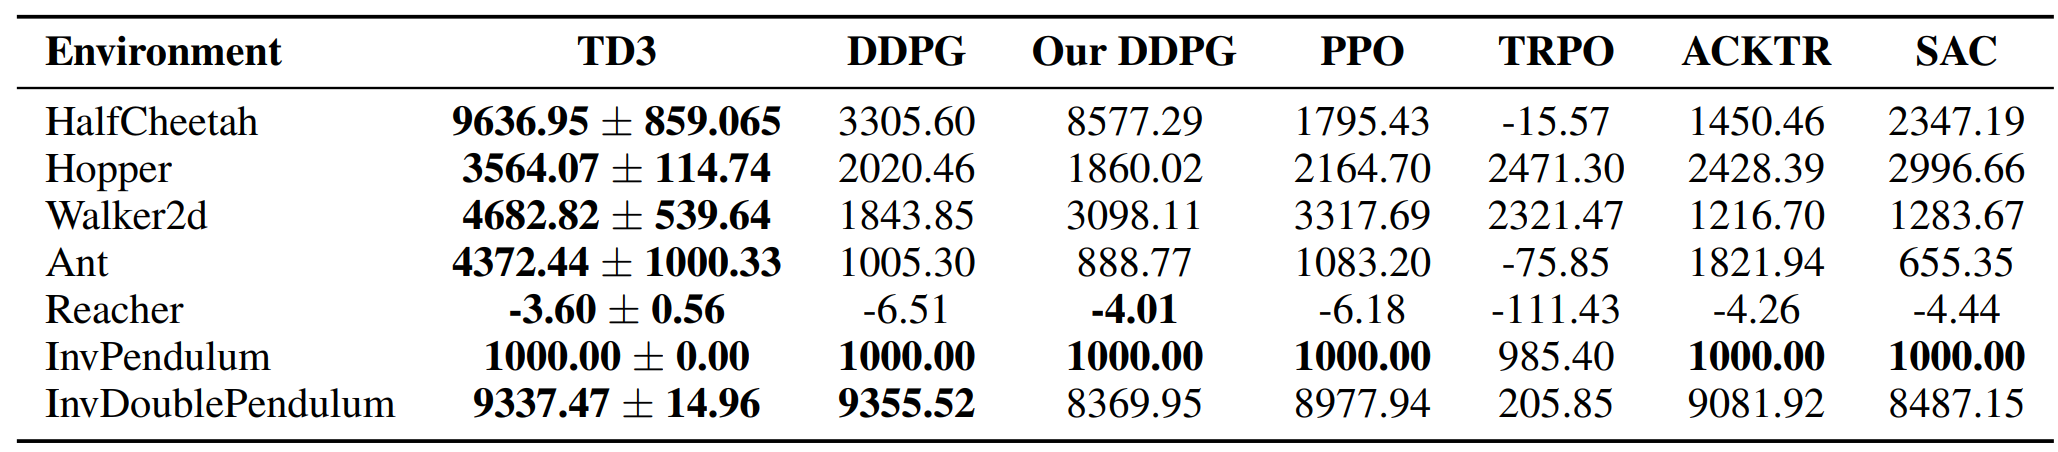
2. 高估 in A-C + Clipped Double Q-Learning
Q_θ 为当前 critic;π_approx 为训练的当前策略
Q_π 为理想的“真实价值”;π_true 为理想的最优策略
第一个 ≥ 因为 在 Q_θ 的评判标准下,当前策略是最好的(好于理想策略)
第二个 ≥ 因为 Q-learning 的高估
第三个 ≥ 因为 在 Q_π 的评判标准下,最优策略是最好的

(平均价值的实验图)
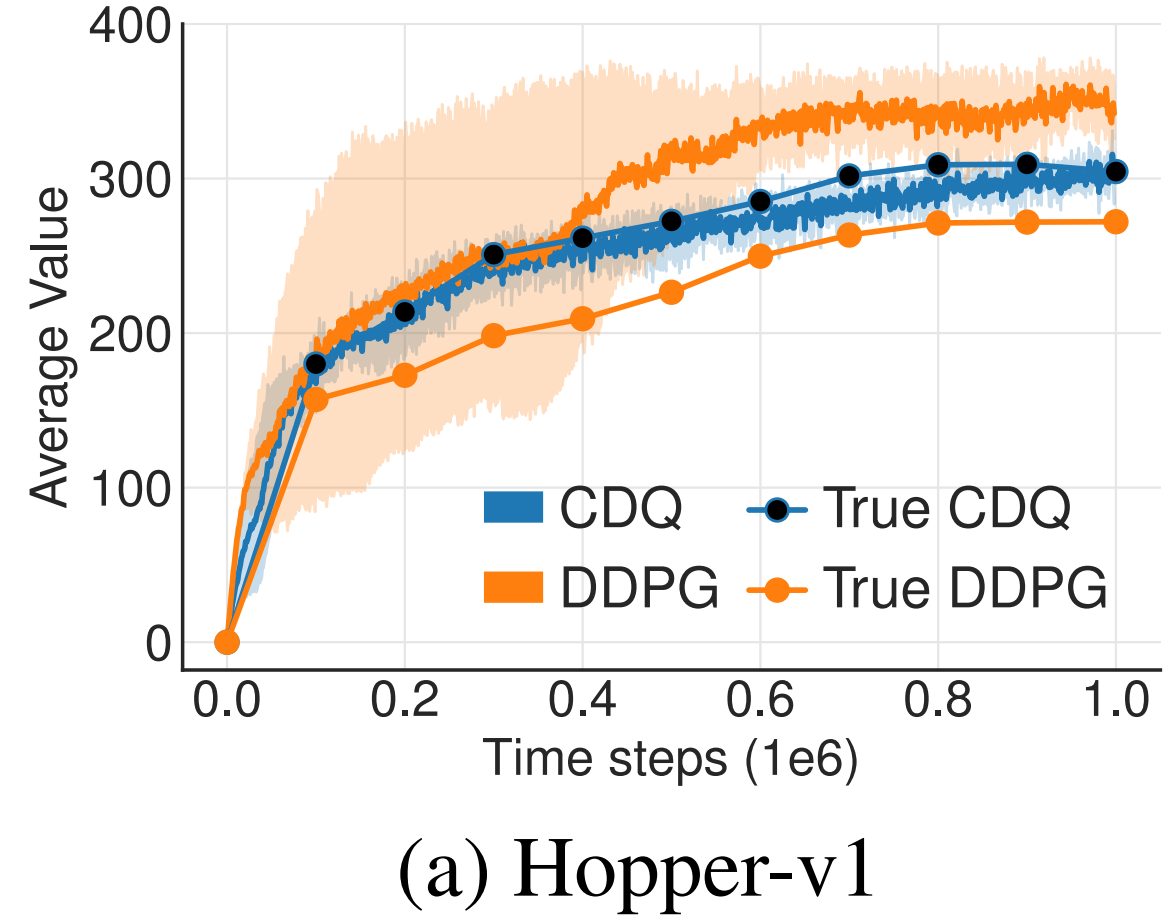
Double DQN 目标网络的作用 为了解耦 动作选择和打分;独立估计 防止自举。
Double DQN 的操作 在A-C实验中会失效:
因为策略更新速度较慢,当前网络与目标网络的参数差异过小,无法实现真正的独立估计。
With the slow-changing policy in actor-critic, the current and target networks were too similar to make an independent estimation.
两组演员 - 评论家网络 相对独立(依赖于对方的输出 + 共享经验回放)目标值互相给对方打分。
Q1 更新对应的 target 为 π1的动作 代入Q2.
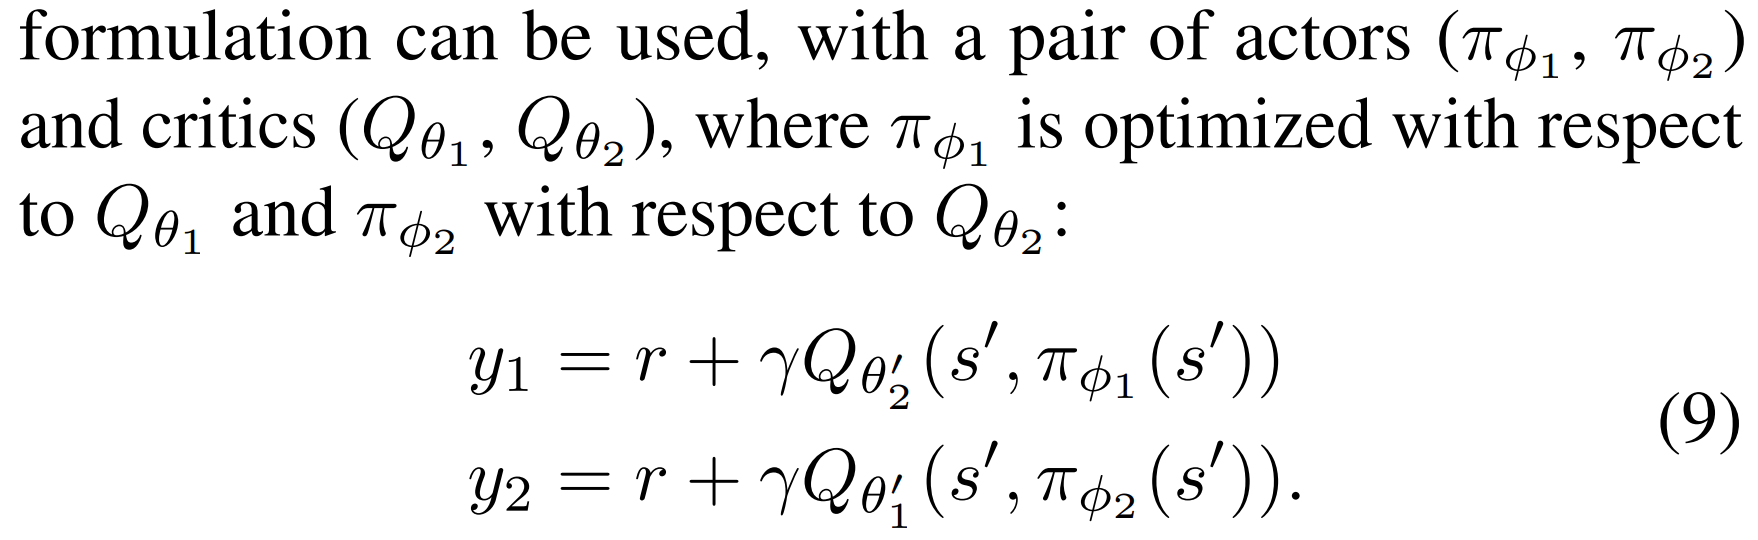
问题:有些状态对方打的 比自己打的还高,高估更严重!
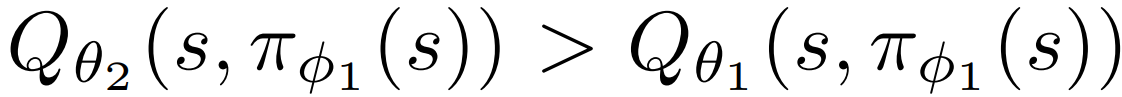
于是最终选择 取两个网络打分的 min
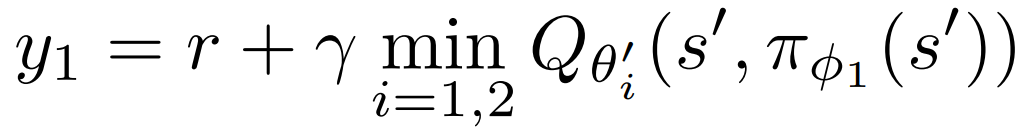
实现中为了降低计算复杂度:不用两个策略网络,一个 actor 对应两个 critic.
Q2 缓解 Q1 的高估。
效果 / 好处:
1. 低估的动作不被选,低估误差传播远弱于高估。
2. 取min 使得,假如对方打的更高;那和standard的更新一样,还是本身;
假如对方打的更低,那么可能发生高估了,就降低了高估。
3. 将函数近似误差视为随机变量,那么取最小值的操作会更倾向于选择价值估计方差更低的状态。
3. Addressing Variance 降低方差
单次的误差项
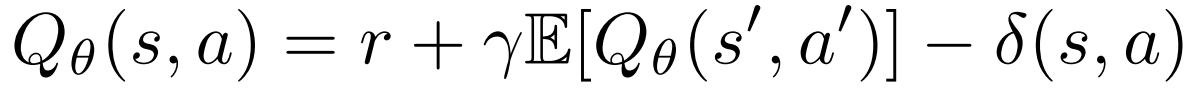
价值估计的方差与未来奖励的方差和估计误差的方差均成正比,
如果不对单次更新的误差加以约束,方差会随着迭代过程快速膨胀。
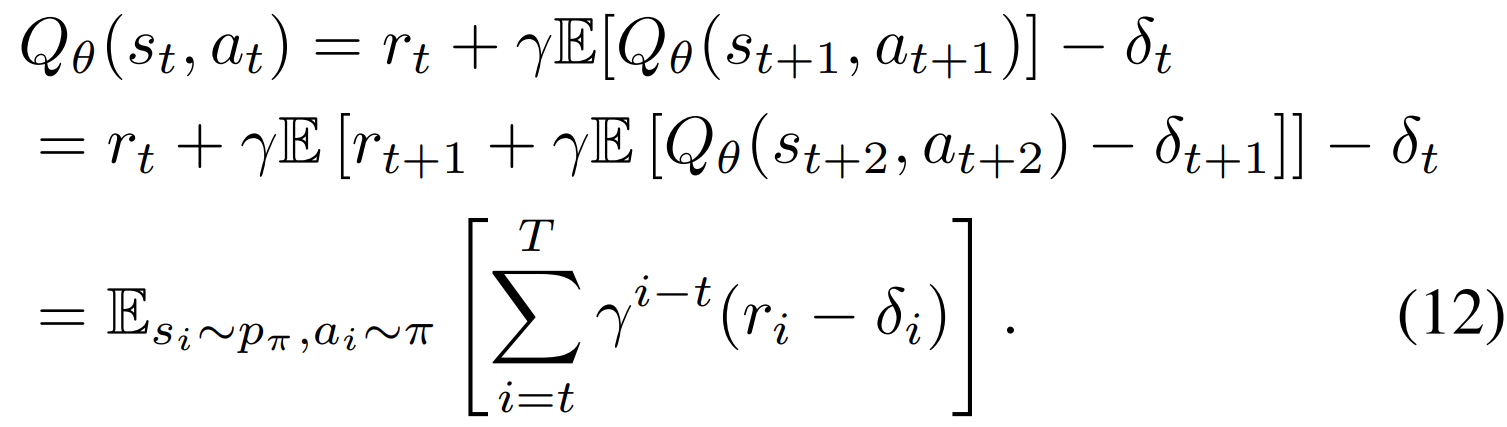
1. 目标网络
在训练过程中提供一个稳定的优化目标,同时让算法能够更充分地利用训练数据。
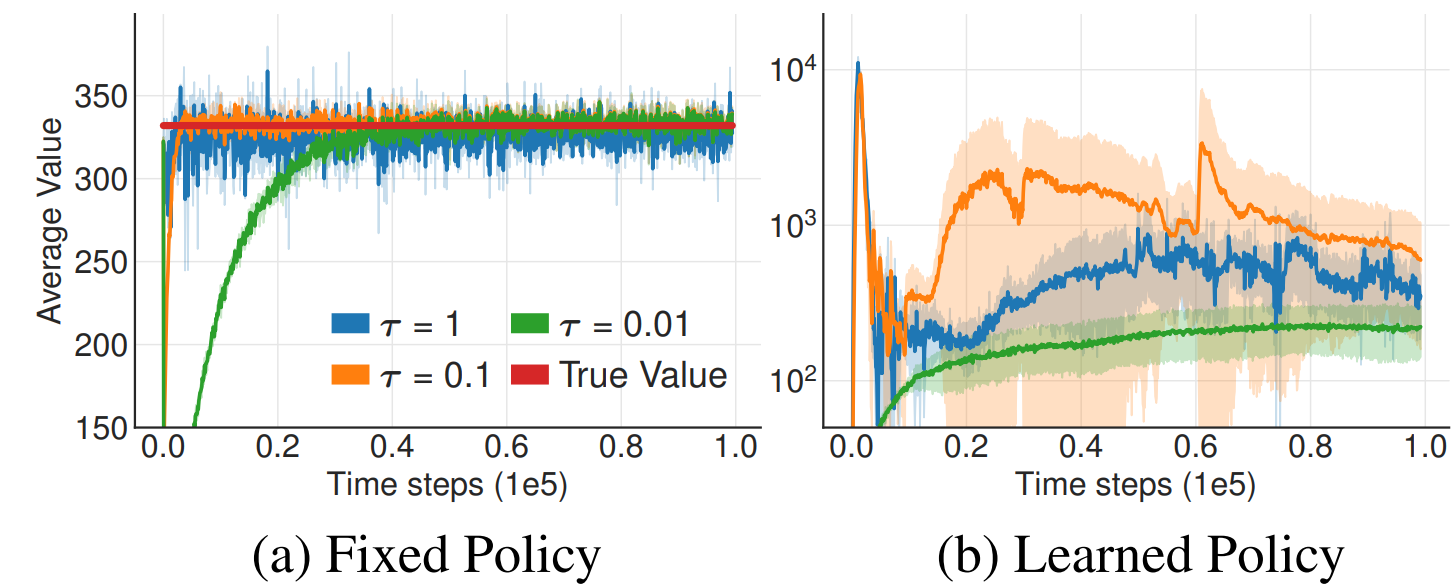
- 当策略固定时Fiexed,不使用目标网络(τ=1)的价值估计波动幅度更大,但所有更新速率下的算法最终都能收敛到相近的结果;
- 当策略基于当前价值估计持续更新时Learned,采用快速更新的目标网络会直接导致价值估计出现严重的发散现象。
2. 延迟策略更新(critic 收敛后)
不使用目标网络时出现的训练发散问题,根源是策略更新依赖的价值估计具有高方差。
- 当策略质量较差时,价值估计会因过估计偏差逐渐发散;
- 而失真的价值估计,又会反过来让策略更新方向偏离最优解,进一步降低策略质量。
需要价值网络收敛后,延迟更新策略网络。
3. 策略网络 Smoothing Regularization 平滑正则化
训练时 π' 策略选择时的问题:overfit to narrow peaks 过拟合到价值估计的局部峰值
解法:similar actions should have similar value 强制让相似动作拥有相近的价值
做法:给目标策略的输出动作添加少量随机噪声;
正常情况下 加噪声偏离原来的动作一点点,Q也只会下降一点点;
但要是 critic 拟合有问题 变成局部的顶峰;输出最优偏离一些 可以从顶峰回到临近的正常值。
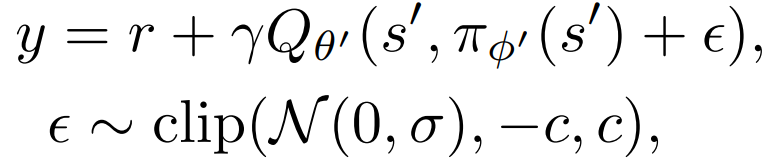
4. 伪代码解析
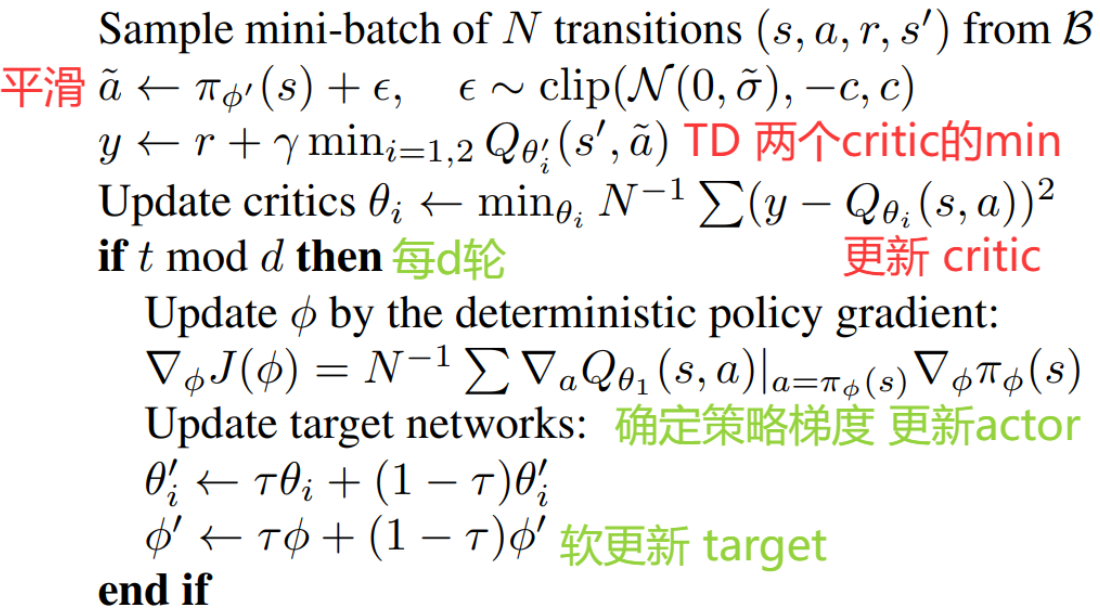
2 critic 1 actor 以及他们的目标网络(共六个网络)
π:玩 + 存经验回放(d轮才 用Q1的打分确定策略梯度更新);
π' 训练时选动作 并平滑
Q':min 作为 Q 的 TD

5. 代码实践
1. 环境与框架
import random
import numpy as np
import torch
import torch.nn.functional as F
import gymnasium as gym
from tqdm import tqdm
import torch.nn as nn
import copy
import collections

class ReplayBuffer:
    def __init__(self, capacity):
        self.buffer = collections.deque(maxlen=capacity)

    def add(self, state, action, reward, next_state, done):
        self.buffer.append((state, action, reward, next_state, done))

    def sample(self, batch_size):
        transitions = random.sample(self.buffer, batch_size)
        state, action, reward, next_state, done = zip(*transitions)
        return np.array(state), action, reward, np.array(next_state), done

    def size(self):
        return len(self.buffer)

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
env = gym.make('Pendulum-v1')
random.seed(0)
np.random.seed(0)
torch.manual_seed(0)
num_episodes = 200
minimal_size = 1000
batch_size = 256

replay_buffer = ReplayBuffer(10000)
state_dim = env.observation_space.shape[0]
action_dim = env.action_space.shape[0]
action_bound = env.action_space.high[0]  # 动作最大值
agent = TD3(state_dim, action_dim, action_bound)

return_list = []
for i in range(10):
    with tqdm(total=int(num_episodes / 10), desc='Iteration %d' % i) as pbar:
        for i_episode in range(int(num_episodes / 10)):
            episode_return = 0
            state, _ = env.reset()
            done = False
            while not done:
                action = agent.take_action(state)
                next_state, reward, terminated, truncated, _ = env.step(action)
                done = bool(terminated or truncated)
                replay_buffer.add(state, action, reward, next_state, done)
                state = next_state
                episode_return += reward
                # 当buffer数据的数量超过一定值后,才进行Q网络训练
                if replay_buffer.size() > minimal_size:
                    b_s, b_a, b_r, b_ns, b_d = replay_buffer.sample(batch_size)
                    transition_dict = {
                        'states': b_s,
                        'actions': b_a,
                        'next_states': b_ns,
                        'rewards': b_r,
                        'dones': b_d
                    }
                    agent.update(transition_dict)
            return_list.append(episode_return)
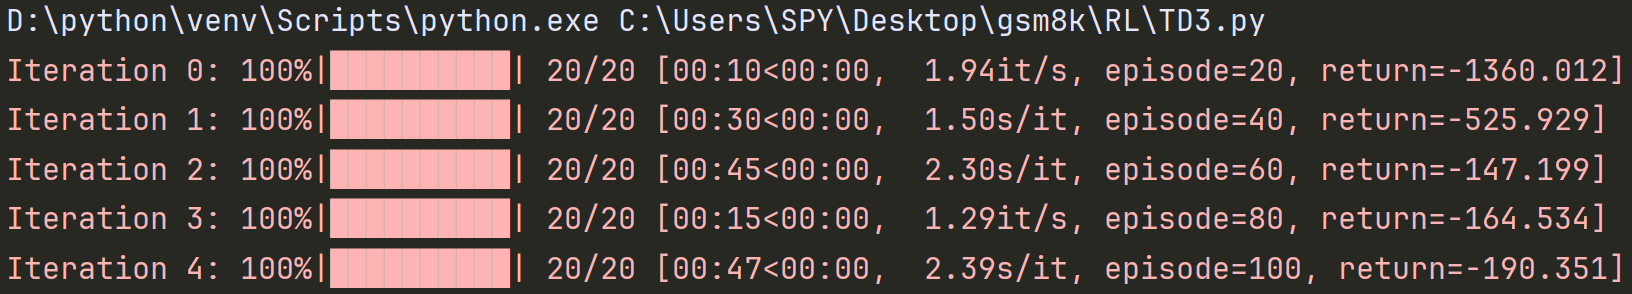
            if (i_episode + 1) % 10 == 0:
                pbar.set_postfix({
                    'episode':
                        '%d' % (num_episodes / 10 * i + i_episode + 1),
                    'return':
                        '%.3f' % np.mean(return_list[-10:])
                })
            pbar.update(1)
2. 网络架构 actor 在 max_action 范围下输出动作;
class Actor(nn.Module):
    def __init__(self, state_dim, hidden_dim, action_dim, max_action):
        super(Actor, self).__init__()
        self.l1 = nn.Linear(state_dim, hidden_dim)
        self.l2 = nn.Linear(hidden_dim, hidden_dim)
        self.l3 = nn.Linear(hidden_dim, action_dim)
        self.max_action = max_action

    def forward(self, state):
        a = F.relu(self.l1(state))
        a = F.relu(self.l2(a))
        return self.max_action * torch.tanh(self.l3(a))
Critic 两个 Q 返回动作价值。
class Critic(nn.Module):
    def __init__(self, state_dim, hidden_dim, action_dim):
        super(Critic, self).__init__()

        # Q1 architecture
        self.l1 = nn.Linear(state_dim + action_dim, hidden_dim)
        self.l2 = nn.Linear(hidden_dim, hidden_dim)
        self.l3 = nn.Linear(hidden_dim, 1)

        # Q2 architecture
        self.l4 = nn.Linear(state_dim + action_dim, hidden_dim)
        self.l5 = nn.Linear(hidden_dim, hidden_dim)
        self.l6 = nn.Linear(hidden_dim, 1)

    def forward(self, state, action):
        sa = torch.cat([state, action], 1)

        q1 = F.relu(self.l1(sa))
        q1 = F.relu(self.l2(q1))
        q1 = self.l3(q1)

        q2 = F.relu(self.l4(sa))
        q2 = F.relu(self.l5(q2))
        q2 = self.l6(q2)
        return q1, q2

    def Q1(self, state, action):
        sa = torch.cat([state, action], 1)

        q1 = F.relu(self.l1(sa))
        q1 = F.relu(self.l2(q1))
        q1 = self.l3(q1)
        return q1
3. TD3 agent
初始化
class TD3(object):
    def __init__(
            self,
            state_dim,
            action_dim,
            max_action,
            hidden_dim=256,
            discount=0.99,
            tau=0.005,
            policy_noise=0.2,
            noise_clip=0.5,
            policy_freq=2
    ):
        self.actor = Actor(state_dim, hidden_dim, action_dim, max_action).to(device)
        self.actor_target = copy.deepcopy(self.actor)
        self.actor_optimizer = torch.optim.Adam(self.actor.parameters(), lr=3e-4)

        self.critic = Critic(state_dim, hidden_dim, action_dim).to(device)
        self.critic_target = copy.deepcopy(self.critic)
        self.critic_optimizer = torch.optim.Adam(self.critic.parameters(), lr=3e-4)

        self.max_action = max_action
        self.discount = discount
        self.tau = tau
        self.policy_noise = policy_noise
        self.noise_clip = noise_clip
        self.policy_freq = policy_freq
        self.total_it = 0


    def take_action(self, state):
        state = torch.FloatTensor(state.reshape(1, -1)).to(device)
        return self.actor(state).cpu().data.numpy().flatten()
核心更新 用 replay buffer 的 (s,a,r,s') off-policy 更新
    def update(self, transition_dict):
        self.total_it += 1
        state = torch.tensor(np.array(transition_dict['states']), dtype=torch.float).to(device)
        action = torch.tensor(np.array(transition_dict['actions']), dtype=torch.float).to(device)
        reward = torch.tensor(np.array(transition_dict['rewards']), dtype=torch.float).view(-1, 1).to(device)
        next_state = torch.tensor(np.array(transition_dict['next_states']), dtype=torch.float).to(device)
        done = torch.tensor(np.array(transition_dict['dones']), dtype=torch.float).view(-1, 1).to(device)

        # 对倒立摆环境的奖励归一化到 [-1, 1] 区间
        rewards = (rewards + 8.0) / 8.0

        with torch.no_grad():
            # 动作加扰动
            noise = (
                    torch.randn_like(action) * self.policy_noise
            ).clamp(-self.noise_clip, self.noise_clip)

            next_action = (
                    self.actor_target(next_state) + noise
            ).clamp(-self.max_action, self.max_action)

            # min TD target
            target_Q1, target_Q2 = self.critic_target(next_state, next_action)
            target_Q = torch.min(target_Q1, target_Q2)
            target_Q = reward + (1 - done) * self.discount * target_Q

        # Get current Q estimates
        current_Q1, current_Q2 = self.critic(state, action)

        # Compute critic loss
        critic_loss = F.mse_loss(current_Q1, target_Q) + F.mse_loss(current_Q2, target_Q)

        # Optimize the critic
        self.critic_optimizer.zero_grad()
        critic_loss.backward()
        self.critic_optimizer.step()

        # Delayed policy updates
        if self.total_it % self.policy_freq == 0:
            # Compute actor loss
            actor_loss = -self.critic.Q1(state, self.actor(state)).mean()

            # Optimize the actor
            self.actor_optimizer.zero_grad()
            actor_loss.backward()
            self.actor_optimizer.step()

            # 软更新目标网络
            for param, target_param in zip(self.critic.parameters(), self.critic_target.parameters()):
                target_param.data.copy_(self.tau * param.data + (1 - self.tau) * target_param.data)

            for param, target_param in zip(self.actor.parameters(), self.actor_target.parameters()):
                target_param.data.copy_(self.tau * param.data + (1 - self.tau) * target_param.data)

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 9
 0
- 0


 已为社区贡献12条内容

所有评论(0)