【目标深度估计】目标检测+多目标跟踪+目标深度估计(Python源码+裁缝师)
一、项目简介
这次当一次大奉裁缝侠,把目标检测+目标跟踪+目标单目深度估计三个算法,和谐的缝在一起使用。目标检测算法是根据yolov5(yolo实在是太优雅了忘不了她)多目标跟踪算法是DeepSort(相对也是优雅)为每一个目标分配一个唯一的ID,并跟踪它们在视频序列中的运动,单目深度估计用的是Monodepth,得到整个图像的深度图,直到目标的近似距离。三个算法融合在一起,练出的一个迷彩服。
二、项目伪代码
# 伪代码

# 初始化YOLOv5模型
yolo_model = YOLOv5(...)

# 初始化DeepSORT跟踪器
deepsort_tracker = DeepSORT(...)

# 初始化Monodepth模型
monodepth_model = Monodepth(...)

# 处理视频流
for frame in video_stream:
    # 1. 目标检测
    detections = yolo_model(frame)

    # 2. 目标跟踪
    tracks = deepsort_tracker.update(detections)

    # 3. 深度估计
    depth_map = monodepth_model(frame)

    # 4. 为每个跟踪目标分配深度
    for track in tracks:
        bbox = track.bbox  # 边界框
        depth = extract_depth_from_bbox(depth_map, bbox)
        track.depth = depth

    # 5. 显示结果
    display_frame(frame, tracks)
三、核心组件简要介绍
1️⃣. YOLOv5目标检测算法
1、单阶段检测器,速度快,精度高,60Fps帧率以上够用;
2、backbone: 利用CSPDarknet53;
3、Neck: 利用PANet;
4、Head: 三种检测头,分别对应三种目标尺度;
2️⃣.DeepSort多目标跟踪算法
1、卡尔曼滤波:进行运动检测;
2、匈牙利算法:进行数据关联,通过马氏距离判断运动相似度,通过余弦距离判断外观相似度;
3、ReID网络: 进行特征提取,提取目标的深度外观特征,并且解决遮挡和重识别的问题;
3️⃣.MonoDepth深度估计算法
1、自监督学习:无需深度真值标签;
2、网络架构:编码器-解码器结构;
3、核心损失函数;
loss=α∗(1−SSIM(Ileft,Irightwarped))/2+(1−α)∗∣Ileft−Irightwarped∣loss = α * (1 - SSIM(I_left, I_right_warped)) / 2 + (1 - α) * |I_left - I_right_warped|loss=α∗(1−SSIM(Ileft,Irightwarped))/2+(1−α)∗∣Ileft−Irightwarped∣
四、未来扩展方向
-
深度估计精度不太行,这是单目深度估计的通病,可以改成双目视觉,或者利用传统标定;
-
跟踪稳定性上,在DeepSort算法上改进,可以融合深度信息的重识别,或者将2D运动模型改进为3D运动模型。
五、项目展示
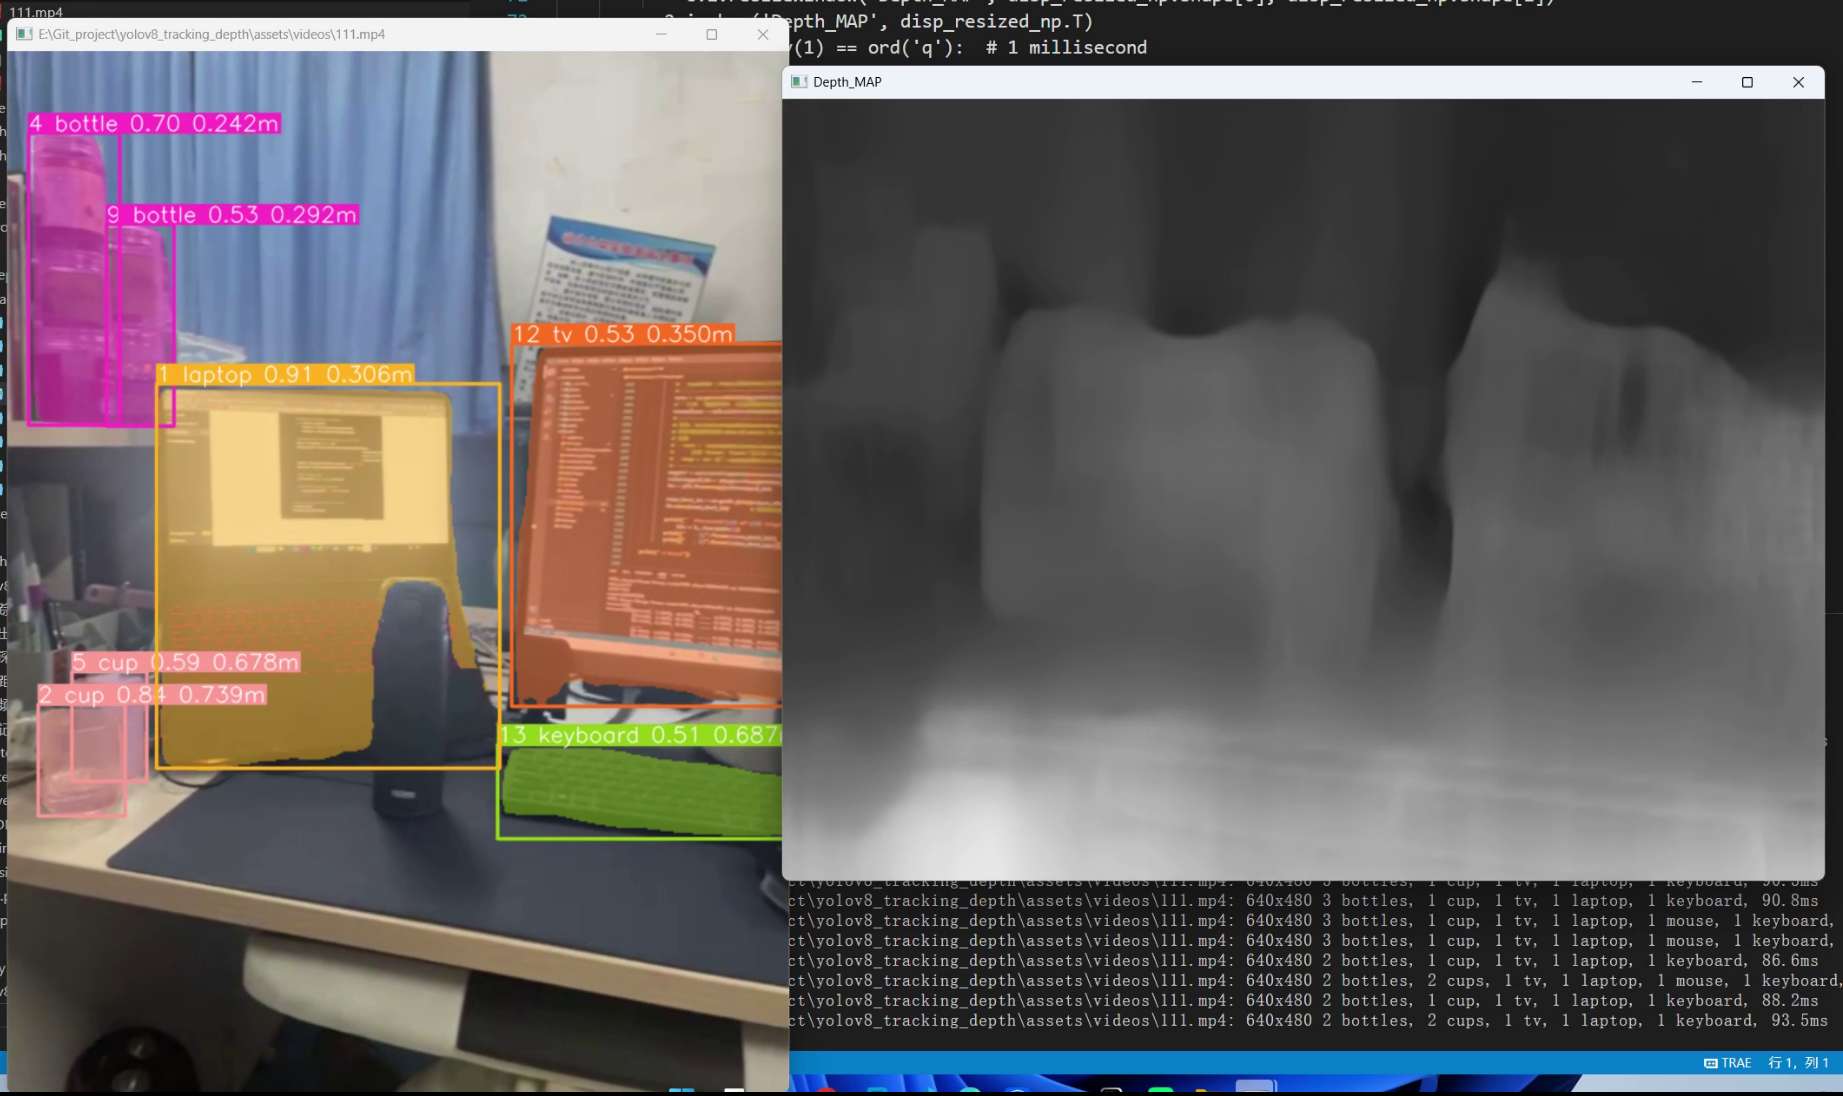
简单效果展示,如下图,可以检测出来一些常见的目标,比如电脑、杯子、书本、键盘类别,然后右侧输出的深度估计图,两个大白坨是两个电脑。。深度估计的距离不太准确,这里的视频是根据手机拍摄的,所以无法获取相机的内参,原理上来距离误差不会超过0.5m的。
六、获取源码&学习资料
好啦,这篇文章就简单介绍了一下这个项目。喜欢的小伙伴感谢给个点赞和关注。
如果需要完整源码,关注公众号【扎根感知】,私信【裁缝】,即可获取。 ——扎根感知
:::

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 7
 0
- 0


 已为社区贡献3条内容

所有评论(0)