Seq2Seq模型:从基础到注意力机制的演进

前言
Hello,大家好,我是
GISer Liu😁,一名热爱AI技术的GIS开发者,本系列文章是作者参加DataWhale2025年1月份学习赛,旨在讲解Transformer模型的理论和实践。😲
在本文中,我将通过:
- Seq2Seq模型概述
- Encoder-Decoder架构详解
- 注意力机制的引入与改进
帮助读者快速理解如何Transformer模型原理;希望通过本文,大家能够掌握Seq2Seq模型的核心思想,了解注意力机制的重要性,并为后续学习Transformer模型打下坚实的基础。
一、Seq2Seq模型概述
1. 什么是Seq2Seq模型

Seq2Seq(Sequence to Sequence)模型是一种输入和输出均为序列的神经网络模型。其核心特点是输入序列和输出序列的长度可以不一致。为了处理序列的开始和结束,我们引入了特殊标记:
- BOS(Begin Of Sequence):表示序列的开始。
- EOS(End Of Sequence):表示序列的结束。
例如,“BOS I have a pen EOS”中,BOS和EOS分别标记句子的开始和结束。
2. Seq2Seq的由来
在Seq2Seq框架提出之前,深度神经网络在固定长度数据(如图像分类)上取得了显著成功,但对于可变长度序列(如机器翻译、语音识别)的处理却面临挑战。传统的解决方法是使用Padding,即通过填充固定长度来统一序列长度,但这带来了以下问题:
- Padding的解释:Padding是指在序列末尾填充无意义的元素(如0),以使所有序列具有相同的长度。
- Padding的缺点:Padding引入了无意义的数据,可能影响模型训练效果,需要通过掩码(Mask)来忽略这些填充元素。
而Seq2Seq模型应运而生,通过编码器-解码器(Encoder-Decoder)结构,解决了序列长度不一的问题。
这里有点像卷积计算时,最边界的区域使用0进行填充
3. Seq2Seq模型的评价
① 优势:
- 端到端学习:直接从输入数据映射到输出序列,无需特征工程。
- 处理可变长度序列:适用于如机器翻译、对话系统等任务。
- 信息压缩与表示:编码器将输入序列压缩为上下文向量,解码器基于此生成目标序列。
- 可扩展性:可与CNN、RNN等结合,适用于多种任务。
- 许多任务(如机器翻译、语音识别)需要复杂的特征工程。例如,机器翻译需要人工设计语言规则、语法解析器等,这些方法不仅耗时,还难以覆盖所有语言现象。而Seq2Seq只需要传入序列;
- 对输入输出长度没有限制,使用范围广;例如对话机器人;
- 拓展性说明支持模块化设计,例如在文本任务时将RNN或Transformer作为编码器和解码器,用于翻译和文本摘要;图像任务时将CNN作为编码器提取图像特征,RNN作为解码器生成文字描述;
② 缺点:
- 上下文向量信息压缩:信息压缩可能导致细节丢失。
- 短期记忆限制:RNN难以处理长距离依赖。
- 暴露偏差:训练时使用真实输出,推理时使用自生成输出,导致模型适应性差。
- 编码器对信息进行有损压缩,导致信息损失
- 序列长度越长,RNN通过隐藏状态转递的信息难以捕捉,例如生成一篇长文章时,RNN可能忘记文章开头的主题,导致生成的内容偏离主题。
- 教师强迫(Teacher Forcing)策略,即在训练时每个时间步将真实的输出作为解码器的输入。然而,在推理时,解码器只能使用自己生成的输出作为输入。导致泛化性差;不断积累误差导致后期某个时间步生成错误的结果,这里可以使用强化学习或者计划采样解决;
🙂整理一下:
| 缺点 | 问题描述 | 解决方法 |
|---|---|---|
| 上下文向量信息压缩 | 固定长度的上下文向量可能导致长序列信息丢失 | 注意力机制、分层编码 |
| 短期记忆限制 | RNN难以捕捉长距离依赖关系,导致长序列处理能力差 | LSTM/GRU、Transformer模型 |
| 暴露偏差 | 训练时使用真实输出,推理时使用自生成输出,导致模型适应性差 | 计划采样、强化学习 |
二、Encoder-Decoder模型
1. “Seq2Seq”和“Encoder-Decoder”的关系
- Seq2Seq:强调目的,即输入序列到输出序列的映射。例如,输入一段英文句子,输出对应的中文翻译。
- Encoder-Decoder:强调方法,即通过编码器和解码器实现映射。编码器将输入序列编码为上下文向量,解码器基于该向量生成目标序列。
关系总结:
- Seq2Seq是目标,Encoder-Decoder是实现目标的方法。
- Seq2Seq模型是Encoder-Decoder架构的一种具体应用。
举例说明:
假设我们有一个机器翻译任务:
- 输入序列:英文句子“I love you”。
- 输出序列:中文翻译“我爱你”。
- Encoder:将“I love you”编码为一个上下文向量。
- Decoder:基于上下文向量生成“我爱你”。
2. Encoder-Decoder的工作流程

① 编码器(Encoder)
编码器的作用是将输入序列转换为一个固定长度的上下文向量。具体步骤如下:
-
词嵌入(Word Embedding):
-
输入序列中的每个词被转换为一个高维向量。例如,词“I”被映射为向量[0.1, 0.3, -0.2]。
-
数学运算:通过嵌入矩阵(Embedding Matrix)将词的索引映射为稠密向量。假设词汇表大小为V,嵌入维度为D,嵌入矩阵为W(形状为V×D),则词嵌入的计算为:
E m b e d d i n g ( w o r d i ) = W ⋅ o n e h o t ( w o r d i ) Embedding(word_i)=W \cdot onehot(word_i) Embedding(wordi)=W⋅onehot(wordi)
-
作用:词嵌入捕捉了词汇的语义信息,使得模型能够理解词汇之间的关系,即利用向量之间的运算关系。
-
-
序列处理:
- 词嵌入后的向量序列被送入RNN(如LSTM或GRU)进行处理。
- RNN的递归性质:RNN通过隐藏状态(Hidden State)传递信息,每个时间步处理一个词向量,并结合前一个时间步的隐藏状态更新当前隐藏状态。
- LSTM/GRU的作用:LSTM和GRU通过门控机制缓解了RNN的梯度消失问题,能够更好地捕捉长距离依赖关系。
- RNNs(循环神经网络)
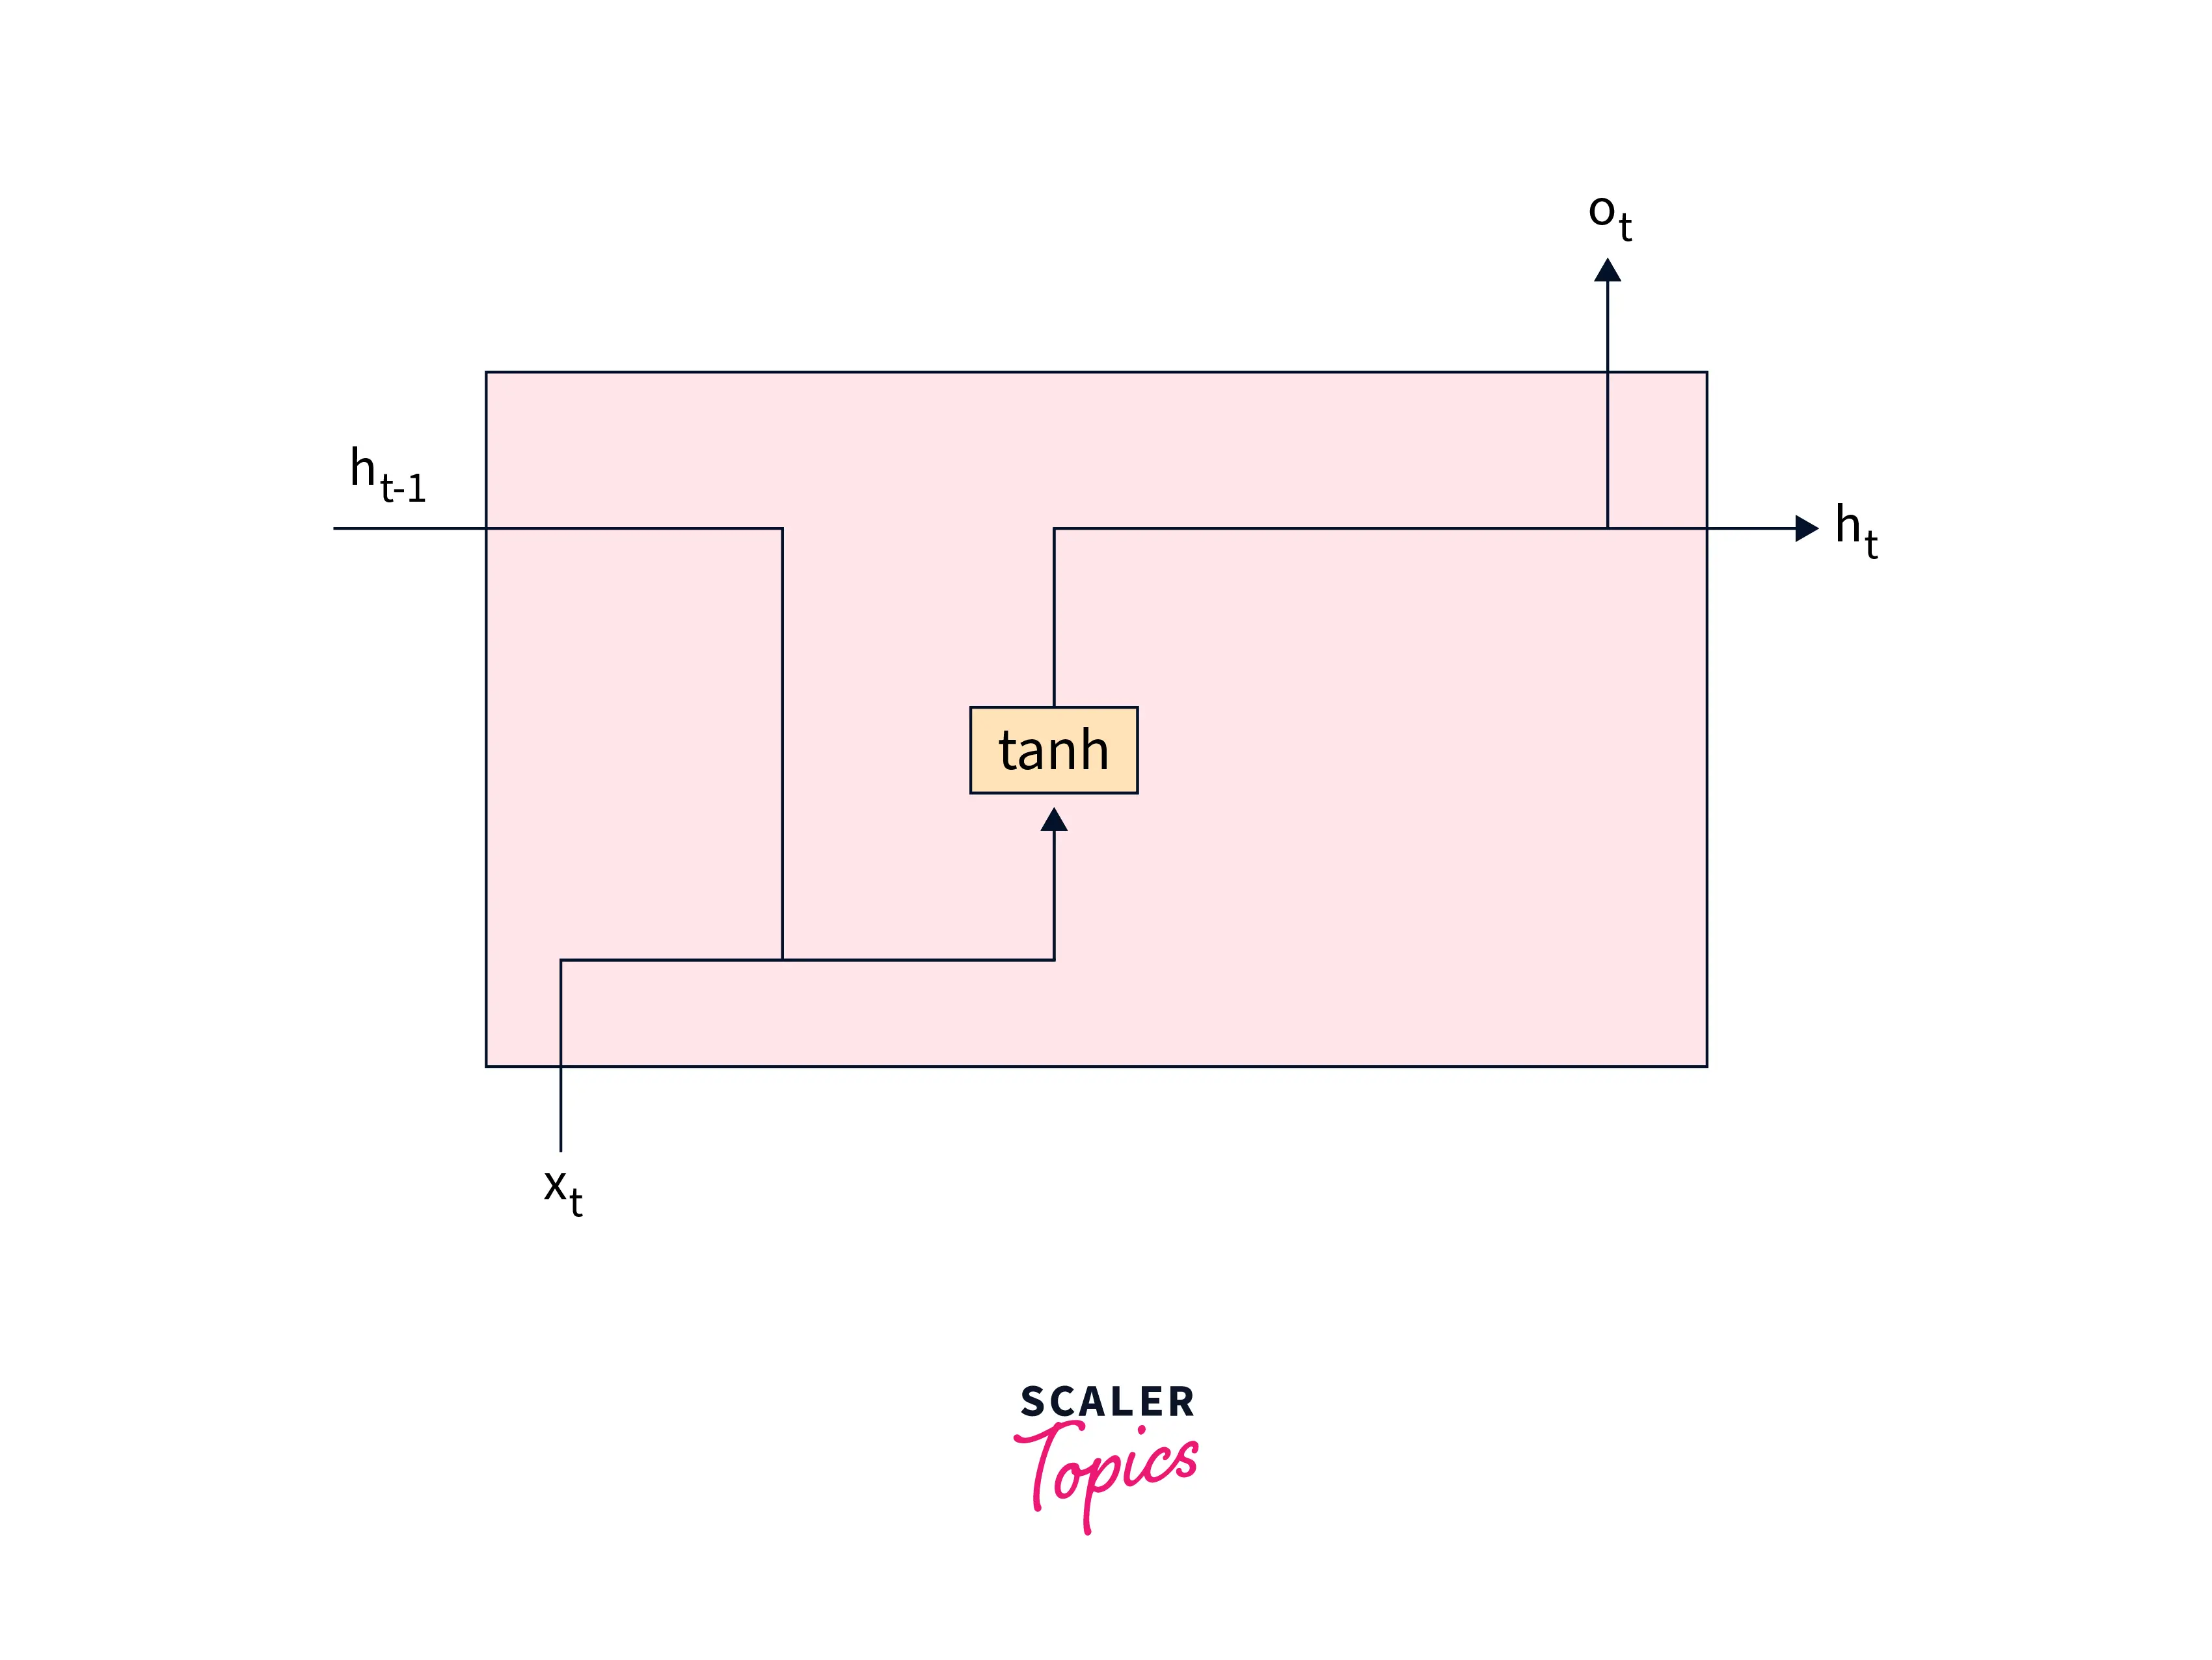
RNNs(循环神经网络)具有一个隐藏状态,该状态捕获来自输入元素和先前隐藏状态的信息,并用于预测序列中的下一个元素。由于其性质,RNNs更容易受到梯度消失和梯度爆炸问题的影响。
- LSTM(长短期记忆网络)
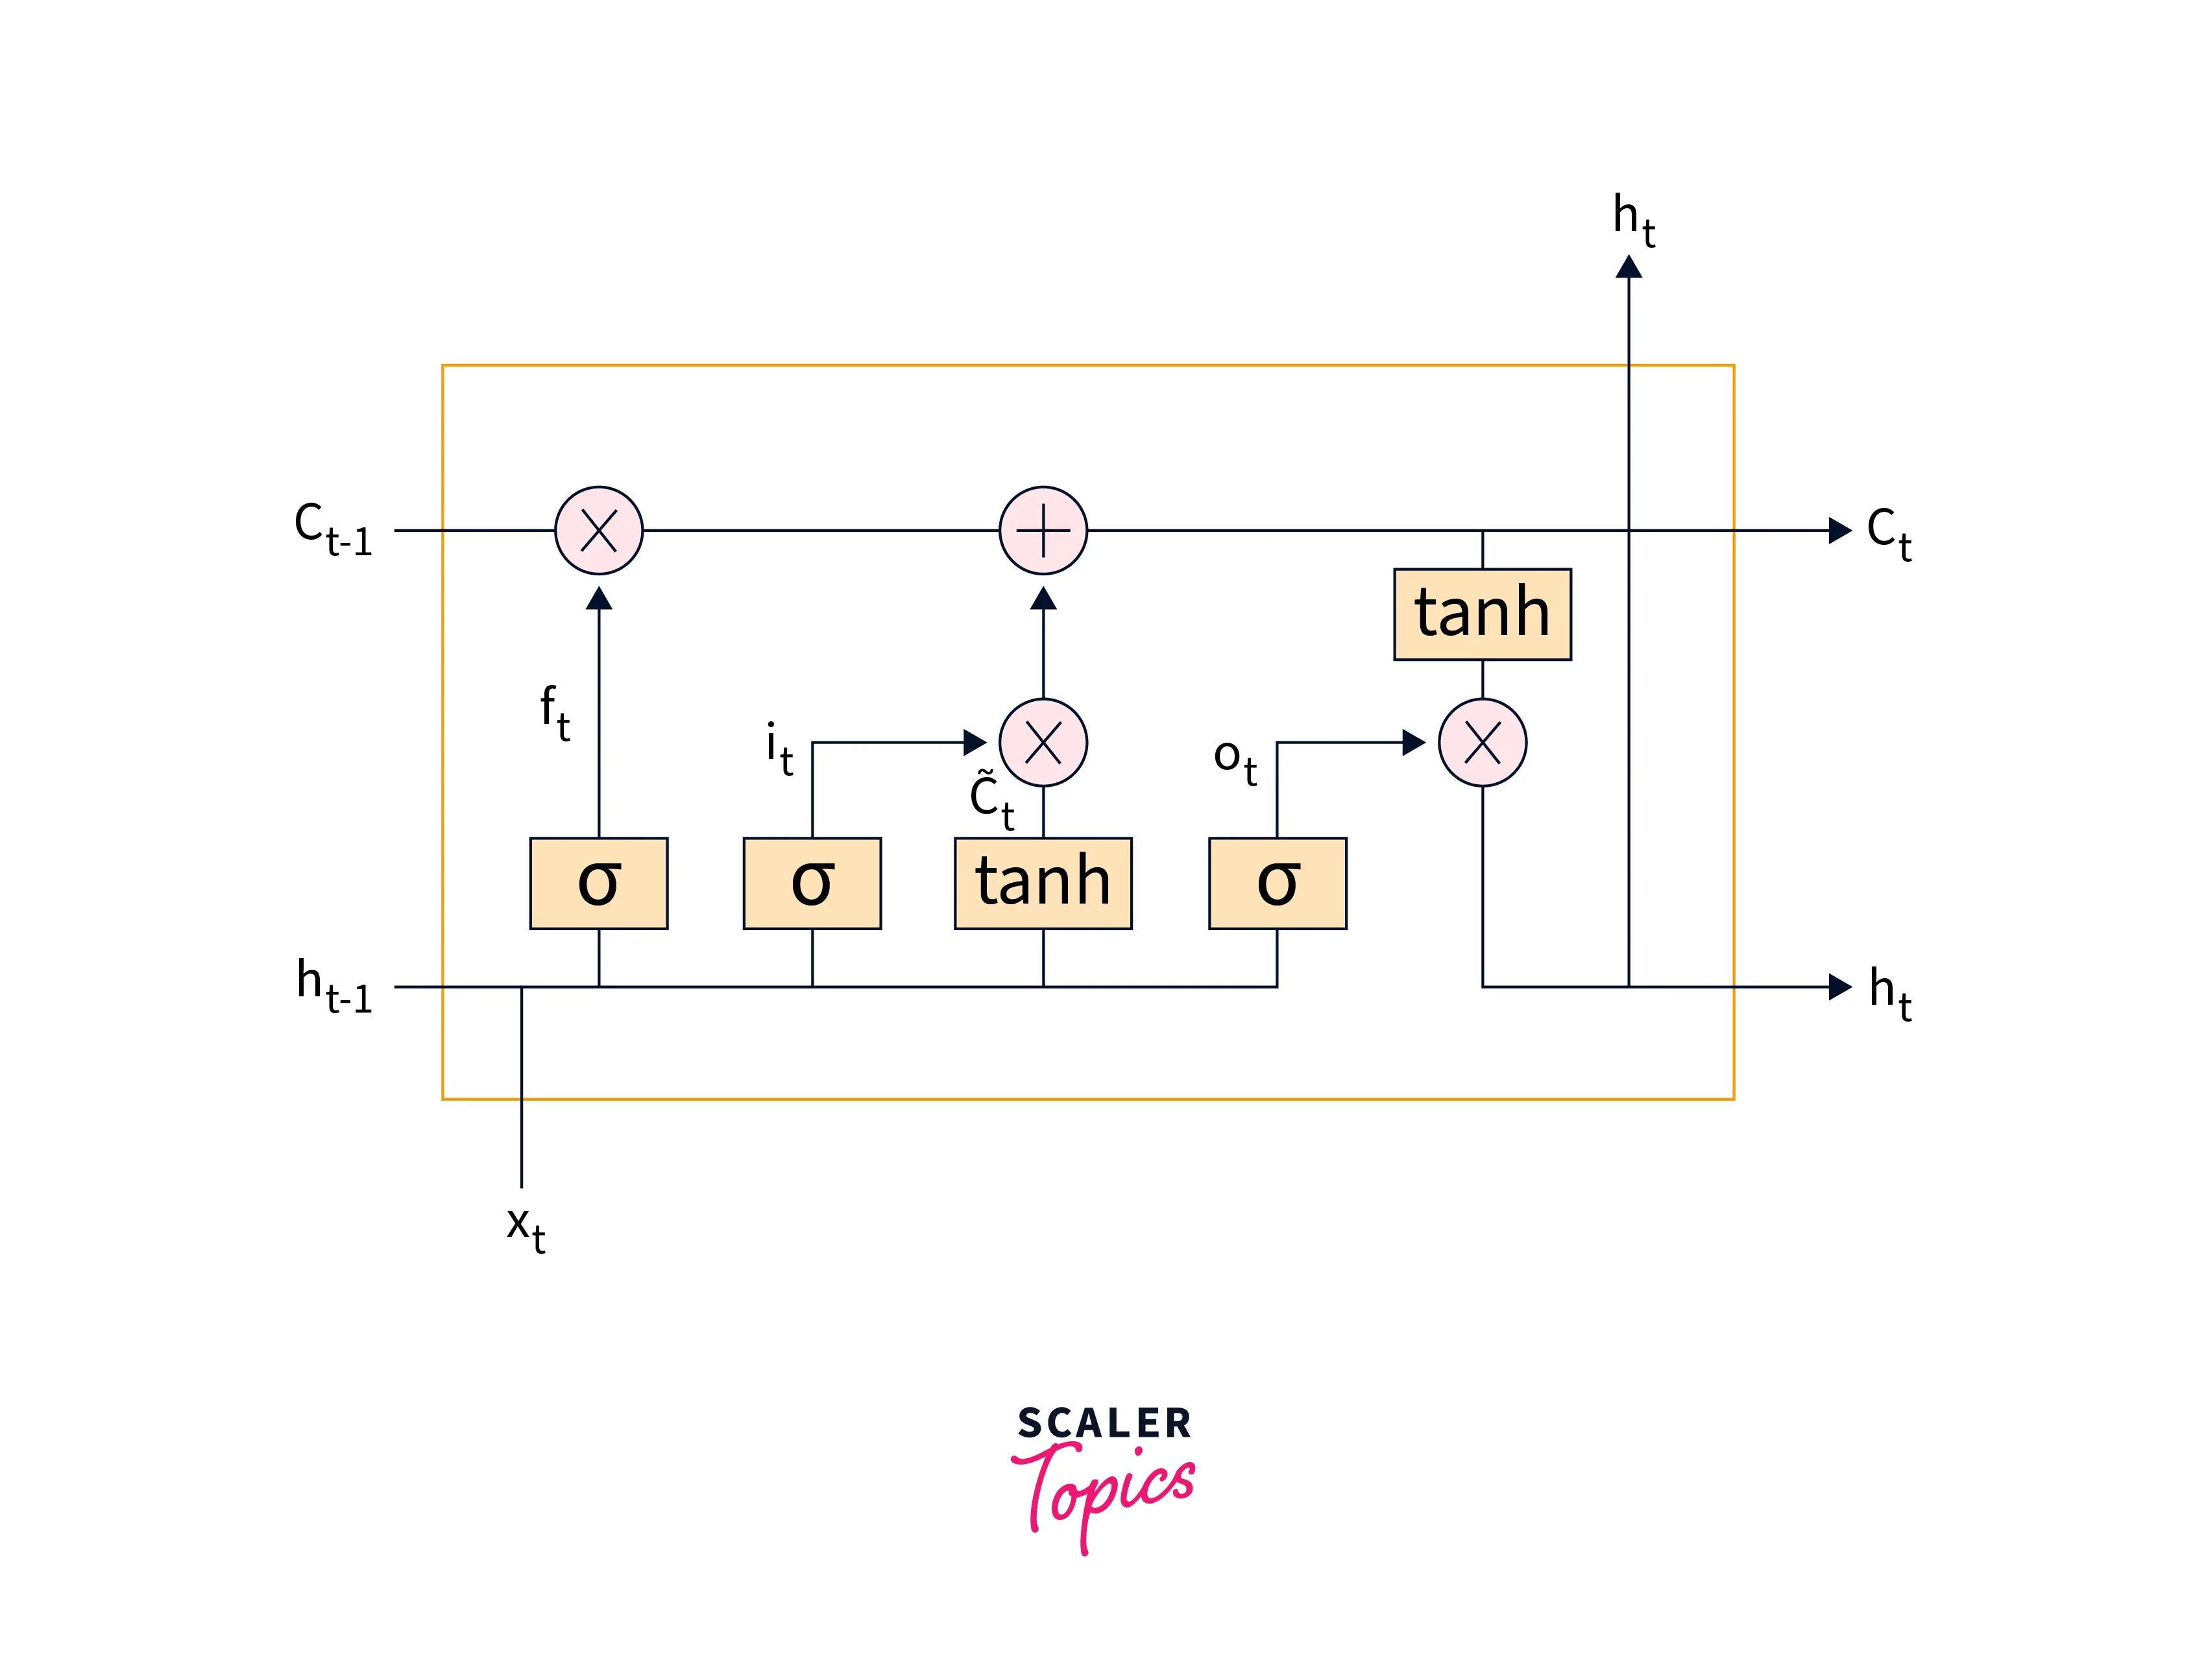
长短期记忆网络(LSTM)是一种RNN单元,旨在克服梯度问题,使得参数的梯度难以通过网络传播。LSTM具有三个门:输入门、输出门和遗忘门。这些门控制信息在单元中的流动,使LSTM能够捕捉数据中的长期依赖关系。
- GRU(门控循环单元)
门控循环单元(GRUs)是另一种RNN单元,旨在克服梯度问题。GRUs比LSTMs更简单,没有单独的输入门、输出门和遗忘门。相反,它们具有一个单一的更新门,用于控制信息在单元中的流动。
LSTMs在需要捕捉长期依赖关系的任务上表现更好,而GRUs训练速度更快,当任务不需要捕捉长期依赖关系时,GRUs是一个很好的替代选择。
- 生成上下文向量:
- 经过一系列时间步的计算,RNN的最后一个隐藏状态被用作上下文向量。
- 上下文向量的作用:上下文向量是对输入序列的压缩表示,包含了输入序列的整体语义信息。
- 固定长度的原因:上下文向量的长度是预先设定的,与输入序列的长度无关。这种固定长度的设计虽然简化了模型结构,但也导致了信息丢失的问题。
② 解码器(Decoder)

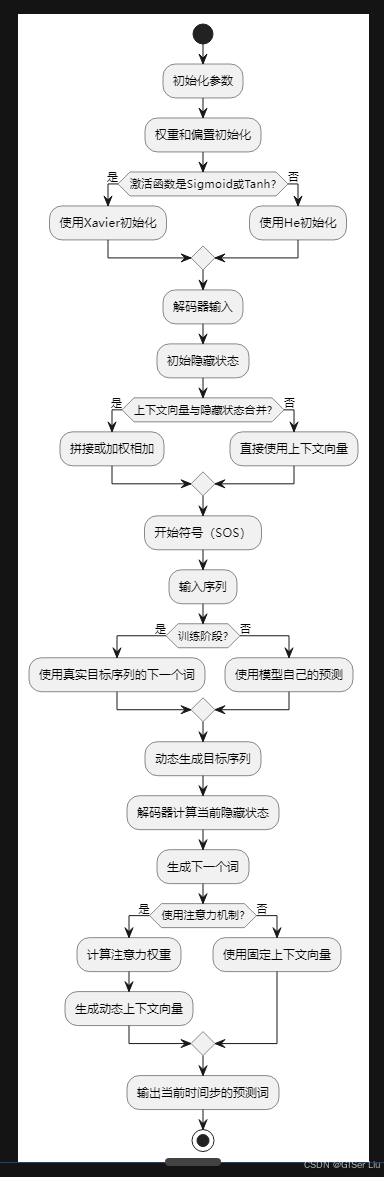
解码器的作用是基于上下文向量生成目标序列。具体步骤如下:
- 初始化参数:
- 解码器的权重和偏置需要初始化。常用的初始化方法包括:
- Xavier初始化:适用于Sigmoid或Tanh激活函数,旨在维持各层激活值和梯度的大致稳定性。使每一层的输入和输出的方差保持一致,从而避免梯度消失或爆炸。
- He初始化:He初始化是Xavier初始化的改进版本,专门针对ReLU激活函数设计。由于ReLU激活函数在负值区域的输出为零,其输出的方差会比Sigmoid或Tanh更小,因此需要调整初始化范围。
- 解码器的权重和偏置需要初始化。常用的初始化方法包括:
- 解码器输入:
- 初始隐藏状态:编码器生成的上下文向量通常被设定为解码器的初始隐藏状态。在某些实现中,上下文向量可能会与解码器的第一个隐藏状态合并或拼接。
- 合并方式:可以通过拼接(Concatenation)或加权相加的方式将上下文向量与隐藏状态结合。
- 开始符号(SOS):解码器需要一个触发信号来启动序列生成。这个信号通常由特定的开始符号(SOS)表示。
- 输入序列:在第一个时间步之后,解码器的输入是前一个时间步的输出。在训练过程中,这可能是真实的目标序列中的下一个词,或者是在预测过程中模型自己的预测。
- 初始隐藏状态:编码器生成的上下文向量通常被设定为解码器的初始隐藏状态。在某些实现中,上下文向量可能会与解码器的第一个隐藏状态合并或拼接。
- 动态生成目标序列:
- 解码器在每个时间步根据当前输入、前一个隐藏状态和上下文向量生成下一个词。
- 注意力机制:如果模型采用了注意力机制,解码器还会接收一组注意力权重,这些权重决定了编码器输出中哪些部分对于当前时间步的解码最为重要。
- 注意力权重的生成:注意力权重是通过计算解码器当前隐藏状态与编码器所有隐藏状态之间的相似度得到的。
- 动态上下文向量:在带有注意力机制的模型中,上下文向量是动态计算的,反映了当前解码位置对源序列不同部分的关注程度。
流程图如下:
3. Encoder-Decoder的应用
- 机器翻译:输入一段英文,输出对应的中文翻译。
- 语音识别:输入一段语音信号,输出对应的文字。
- 图像描述生成:输入一张图片,输出一段文字描述。
举例:
- 机器翻译:输入“I love you”,输出“我爱你”。
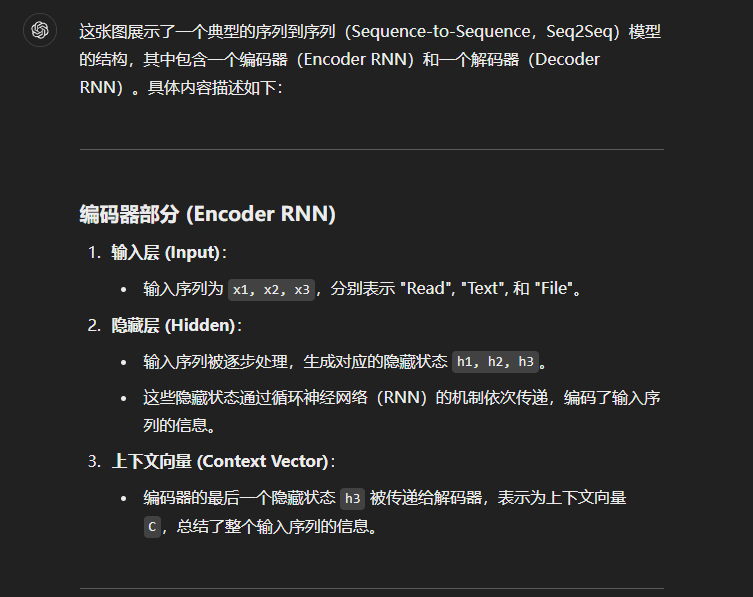
- 图像描述生成:输入一张encoder-decoder的结构图:

输出:
4. Encoder-Decoder的缺陷
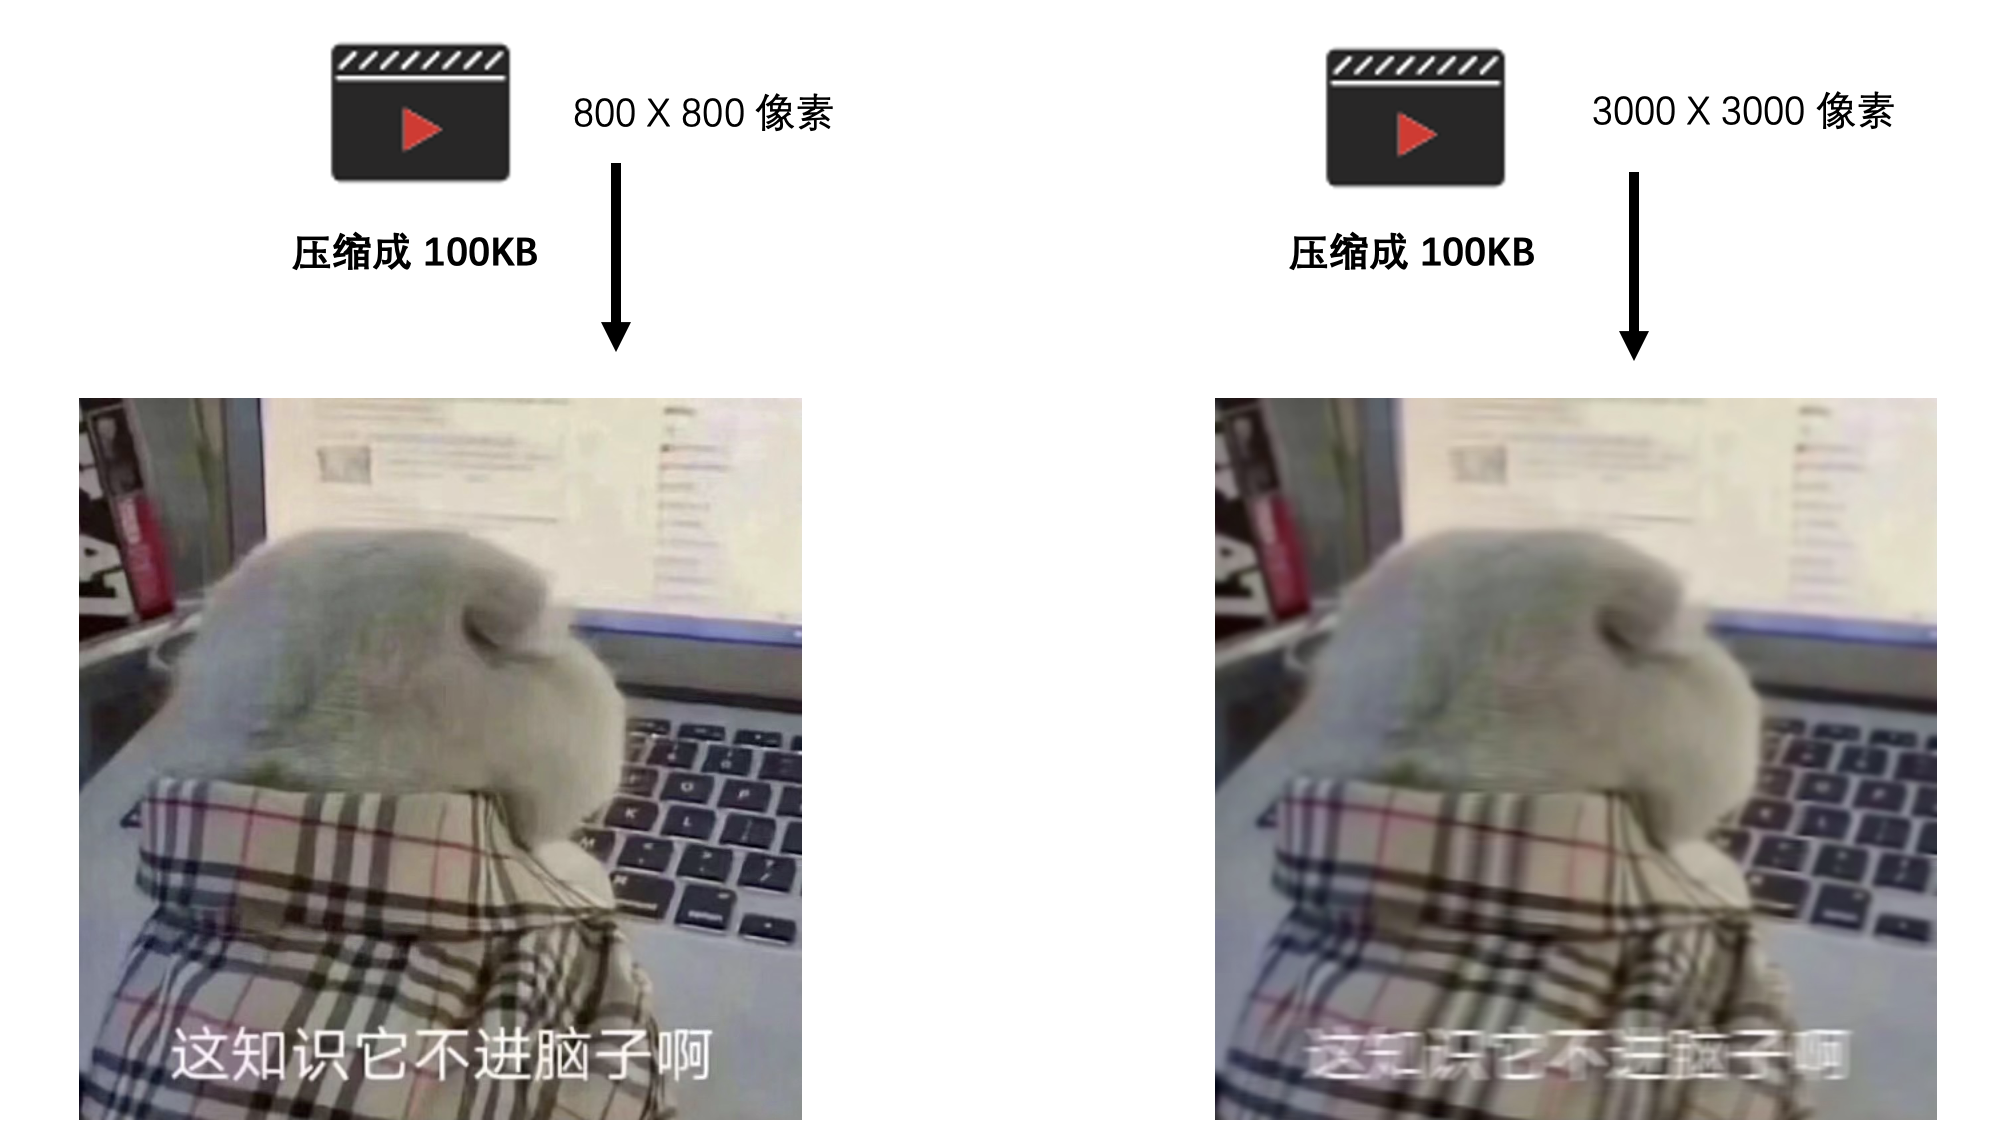
- 信息丢失:上下文向量固定长度,长序列信息易丢失。
- 类比:将一张3000×3000像素的图片压缩到100KB,图片中的细节会丢失。
- 解决方法:引入注意力机制,动态计算上下文向量。
Encoder-Decoder模型通过编码器和解码器实现了输入序列到输出序列的映射,广泛应用于机器翻译、语音识别和图像描述生成等任务。然而,其固定长度的上下文向量设计导致了信息丢失的问题,通过引入注意力机制可以有效缓解这一问题。
三、Attention的提出与影响

1. Attention的发展历程
| 时间 | 发展 | 描述 |
|---|---|---|
| 早期 | 循环神经网络(RNNs) | RNNs能够处理变长的序列数据,但由于梯度消失和梯度爆炸问题,它们在长序列上的表现并不理想。 |
| 早期 | 长短期记忆网络(LSTMs) | LSTMs是对RNNs的改进,通过引入门控机制来解决长序列学习中的梯度消失问题。 |
| 2014年 | Seq2Seq模型的提出 | Seq2Seq模型由一个编码器和一个解码器组成,两者都是基于LSTM。该模型在机器翻译任务上取得了显著的成功。 |
| 2015年 | 注意力机制的引入 | 在Seq2Seq模型的基础上,Bahdanau等人提出了带注意力机制的Seq2Seq模型。 |
| 2017年 | 自注意力与Transformer模型 | Transformer模型完全基于自注意力机制,摒弃了传统的循环网络结构,在处理长距离依赖方面表现卓越。 |
| 2018年 | 多头注意力与BERT | Transformer模型进一步发展为多头注意力机制,并在BERT模型中得到应用,BERT在多项NLP任务上取得了突破性的成果。 |
什么是注意力机制?
注意力机制是一种动态分配权重的方法,用于选择性地关注输入序列中的重要部分。它通过计算解码器当前隐藏状态与编码器所有隐藏状态之间的相似度,生成注意力权重,从而决定哪些部分对当前解码步骤最重要。
如何解决问题?
- 长距离依赖问题:传统RNN模型难以捕捉长距离依赖关系,而注意力机制通过动态分配权重,能够捕捉输入序列中的长距离依赖关系。
- 信息丢失问题:传统Seq2Seq模型使用固定长度的上下文向量,容易丢失长序列中的信息。注意力机制通过动态生成上下文向量,解决了这一问题。
注意力机制与Transformer的关系
- 注意力机制是Transformer模型的核心组件。
- Transformer完全基于自注意力机制(Self-Attention),摒弃了传统的循环网络结构,显著提升了模型处理长序列的能力。
2. Attention的N种类型
| 计算区域 | 所用信息 | 使用模型 | 权值计算方式 | 模型结构 |
|---|---|---|---|---|
| 1. Soft Attention | 1. General Attention | 1. CNN + Attention | 1. 点乘算法 | 1. One-Head Attention |
| 2. Local Attention | 2. Self Attention | 2. RNN + Attention | 2. 矩阵相乘 | 2. Mutil-layer Attention |
| 3. Hard Attention | 3. LSTM + Attention | 3. Cos相似度 | 3. Mutil-head Attention | |
| 4. pure-Attention | 4. 串联方式 | |||
| 5. 多层感知 |
3. Attention 解决信息丢失问题

好的!我们来详细讲解上下文向量和注意力机制的改进,以及它们如何解决长序列信息丢失的问题。
① 上下文向量的问题
在传统的Encoder-Decoder模型中,编码器会将整个输入序列压缩为一个固定长度的上下文向量(Context Vector)。这个向量是对输入序列的抽象表示,包含了输入序列的整体信息。然而,这种设计存在以下问题:
- 信息丢失:当输入序列较长时,上下文向量可能无法完整捕捉所有细节信息,尤其是长序列中的远距离依赖关系。
- 固定长度限制:上下文向量的长度是固定的,无论输入序列多长,都只能压缩到一个固定维度的向量中。这就像试图把一本厚书的内容压缩到一张小纸条上,难免会丢失很多细节。
举例:
假设输入序列是一个长句子:“The cat, which was very hungry, sat on the mat and waited for its food.”
编码器需要将这个句子压缩为一个固定长度的上下文向量。由于句子较长,上下文向量可能无法完整捕捉“cat”和“food”之间的关系,导致解码器生成的结果不准确。
② 注意力机制的改进
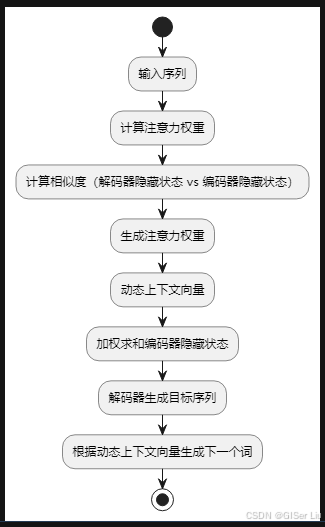
为了解决上下文向量信息丢失的问题,**注意力机制(Attention Mechanism)**被引入。注意力机制的核心思想是:不再将整个输入序列压缩为一个固定长度的上下文向量,而是生成一个上下文向量的序列,每个向量对应输入序列的不同部分。
改进后的工作流程:
- 编码器生成隐藏状态序列:
- 编码器(如RNN、LSTM或GRU)会为输入序列中的每个时间步生成一个隐藏状态(Hidden State)。假设输入序列长度为( T ),则编码器会生成( T )个隐藏状态:( $ h_1, h_2, \dots, h_T $ )。
- 每个隐藏状态( $ h_i $ )都包含了输入序列中第( i )个时间步及其上下文的信息。
- 解码器动态计算注意力权重:
- 在解码器的每个时间步,模型会根据当前解码器的隐藏状态和编码器的所有隐藏状态,计算一组注意力权重(Attention Weights)。
- 注意力权重表示当前解码时间步对编码器每个隐藏状态的关注程度。例如,如果解码器正在生成第( j )个词,它可能会更关注编码器中与第( j )个词相关的隐藏状态。
- 生成动态上下文向量:
-
通过注意力权重,解码器会计算一个动态上下文向量(Dynamic Context Vector)。这个向量是编码器所有隐藏状态的加权和,权重由注意力机制决定。
-
公式如下:
c j = ∑ i = 1 T α j i h i c_j = \sum_{i=1}^{T} \alpha_{ji} h_i cj=∑i=1Tαjihi
-
其中:
* (
c
j
c_j
cj ):第( j )个时间步的动态上下文向量。
* (
α
j
i
\alpha_{ji}
αji):第( j )个时间步对第( i )个编码器隐藏状态的注意力权重。
* (
h
i
h_i
hi ):编码器的第( i )个隐藏状态。
- 解码器生成输出:
- 解码器将动态上下文向量( c j c_j cj )与当前解码器的隐藏状态结合,生成当前时间步的输出。
- 由于上下文向量是动态计算的,解码器可以在生成每个词时关注输入序列的不同部分,从而更好地捕捉长距离依赖关系。
③ 注意力机制的优点
注意力机制的引入带来了以下优势:
- 动态关注输入序列的不同部分:
- 在生成每个输出时,模型可以根据当前需要动态关注输入序列的不同部分。例如,在机器翻译中,生成“cat”时可能更关注输入序列中的“cat”,而生成“food”时可能更关注“food”。
- 解决长序列信息丢失问题:
- 由于不再依赖单一的固定长度上下文向量,模型能够更好地捕捉长序列中的远距离依赖关系。
- 提升模型性能:
- 注意力机制显著提升了模型在长序列任务(如机器翻译、文本摘要)中的表现。
假设我们有一个机器翻译任务:
- 输入序列:英文句子“The cat, which was very hungry, sat on the mat and waited for its food.”
- 输出序列:中文翻译“那只非常饿的猫坐在垫子上,等待它的食物。”
传统Encoder-Decoder模型的问题:
- 编码器将整个英文句子压缩为一个固定长度的上下文向量,可能会丢失“cat”和“food”之间的关系。
- 解码器在生成“食物”时,可能无法准确捕捉到“food”的信息。
引入注意力机制后的改进:
- 编码器生成一系列隐藏状态,每个隐藏状态对应输入序列中的一个词。
- 解码器在生成“食物”时,通过注意力机制动态计算上下文向量,重点关注输入序列中的“food”部分。
- 这样,模型能够更准确地生成“食物”这个词。
4. Attention 的核心工作
场景:
- 信息量大,包含有效信息和噪声。
- 大脑算力和资源有限,无法同时处理所有信息。
问题:
- 如何快速从繁杂信息中检索出对解决问题最重要的信息?
应对:
- 注意力机制通过动态分配权重,选择性地关注输入序列中的重要部分,从而高效利用有限的计算资源。
类比:

- 这很像人类看图片的逻辑。当我们看这张鸟的图片时,我们的注意力会集中在图片的焦点上(鸟身),而忽略背景中的植被、地面等无关信息。
- 信息:整个画面。
- 有效信息:画面中心位置(鸟身体及其地面的鸟食)。
- 无效信息:画面的边边角角、底色等。
引入到Encoder-Decoder模型:
- 将注意力机制引入到Encoder和Decoder模型中,模型可以根据注意力权重动态关注输入序列中的重点部分,从而提升性能。
5. Attention 的3大优点
1. 参数少
- 模型复杂度低:与CNN和RNN相比,注意力机制的模型复杂度更小,参数也更少。
- 算力需求小:由于参数少,注意力机制对算力的要求也更低。
- 比较:
- 传统的RNN模型需要维护隐藏状态,参数数量与序列长度成正比。
- 注意力机制通过计算相似度动态分配权重,参数数量与序列长度无关,显著减少了计算量。
2. 速度快
- 并行计算:注意力机制解决了RNN不能并行计算的问题。
- 数学原理:
- RNN的每一步计算依赖于上一步的隐藏状态,因此无法并行处理。
- 注意力机制的每一步计算是独立的,不依赖于上一步的结果,因此可以像CNN一样并行处理。
- 具体实现:
- 通过矩阵运算一次性计算所有时间步的注意力权重,从而实现并行化。
3. 效果好
- 长距离依赖问题:在注意力机制引入之前,RNN模型难以捕捉长距离依赖关系,导致长序列中的信息被弱化。
- 注意力机制的优势:
- 通过动态分配权重,注意力机制能够捕捉输入序列中的长距离依赖关系。
- 重点判断:
- 注意力权重是通过计算解码器当前隐藏状态与编码器所有隐藏状态之间的相似度得到的。
- 相似度越高,权重越大,表示该部分信息对当前解码步骤越重要。
- 细节处理:
- 虽然注意力机制能够关注重点信息,但对于细节或描写较少的部分,仍然可能被忽略。这是因为注意力机制倾向于分配更高的权重给显著信息。
注意力机制通过动态分配权重,选择性地关注输入序列中的重要部分,从而解决了传统RNN模型的长距离依赖问题和并行计算问题。其三大优点——参数少、速度快、效果好,使其成为现代深度学习模型的重要组成部分。
四、总结
本文从Seq2Seq模型的基础出发,详细讲解了Encoder-Decoder架构的工作原理及其局限性,重点介绍了注意力机制如何通过动态分配权重解决传统模型的信息丢失问题,并提升模型在长序列任务中的表现。通过本文,读者可以理解Seq2Seq模型的核心思想、Encoder-Decoder的工作流程,以及注意力机制的重要性,为后续学习Transformer模型打下坚实基础。🚀
OK!今天就学习到这里了!🙂
项目地址
如果觉得我的文章对您有帮助,三连+关注便是对我创作的最大鼓励!或者一个star🌟也可以😂.

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 17
 0
- 0


 已为社区贡献6条内容

所有评论(0)