一次线上OOM的定位记录
虽然对于oom尤其是线上oom这样的问题大家都唯恐避之不及,但是既然遇到了,也不妨当做是提升自己的一次机会。
背景:生产应用从上午开始陆续开始报出cms老年代的使用率超过95%的告警

从图上可以看到在短短的一个钟内老年代频繁地进行gc,内存高点一直在100%左右徘徊。
定位过程:
1、第一反应是先咨询了运维同事,发现监控平台上并没有集成内存分析的工具,需要自行dump分析。
2、dump命令通过jmap工具来执行,需要提供当前java进程的pid,于是先登录到虚拟机,通过jps命令找到当前服务器的java进程号。然后通过命令 jmap -dump:format=b,file=filename pid 来对当前java进程执行内存dump
3、dump操作对于线上oom的处理来说只是分析问题的第一步,拿到dump文件后需要考虑如何进行内存分析,这里当时尝试了两个软件,java本身自带了一个jvisualvm工具,这个工具除了能对jvm运行情况做实时监控以外也能对dump下来的文件进行分析。还有另一个是比较有名的外部软件 mat,相对来说可视化程度高一点。我们选择了后者进行dump文件的分析。
4、dump下来的文件载入mat工具后,我们可以从overview中看出当前内存的占比。
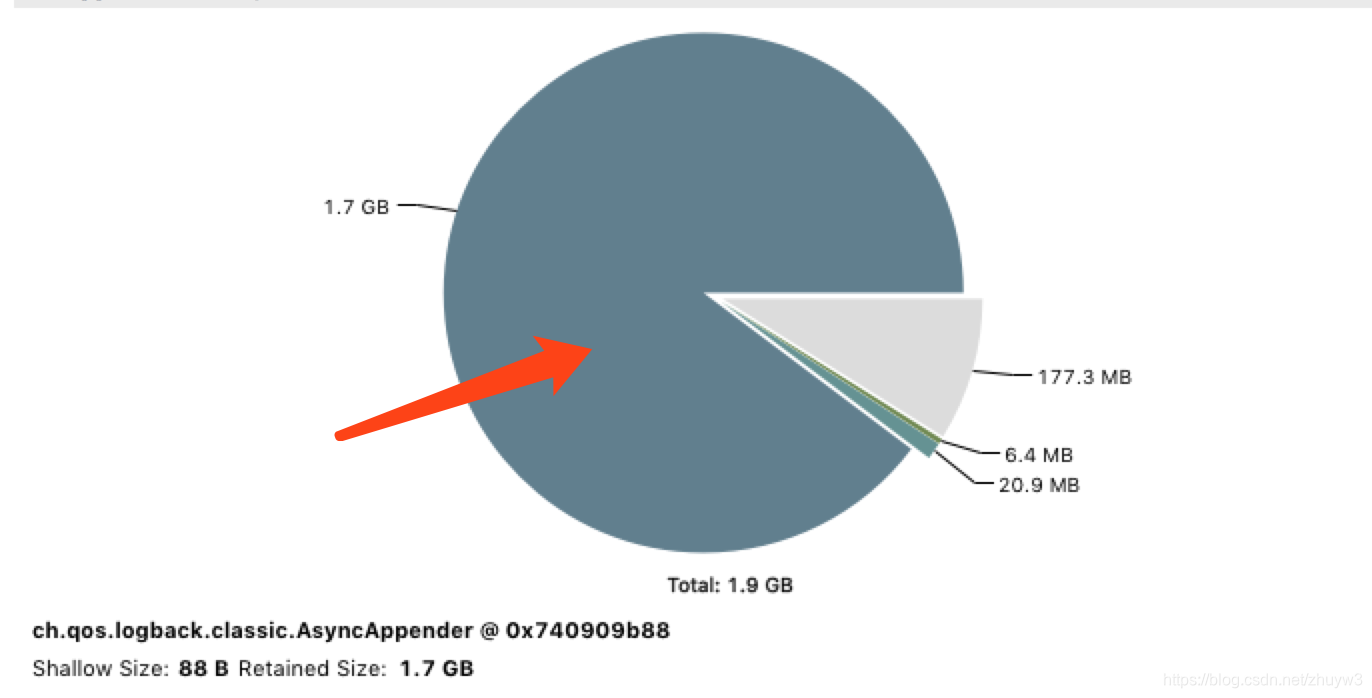
我们可以明显地看到图中一共1.9g的内存,有一部分占据了1.7g的大小,明显,罪魁祸首应该就是他了。那么到底是什么占据了如此大的空间呢。mat本身会为我们列出oom的嫌疑对象。
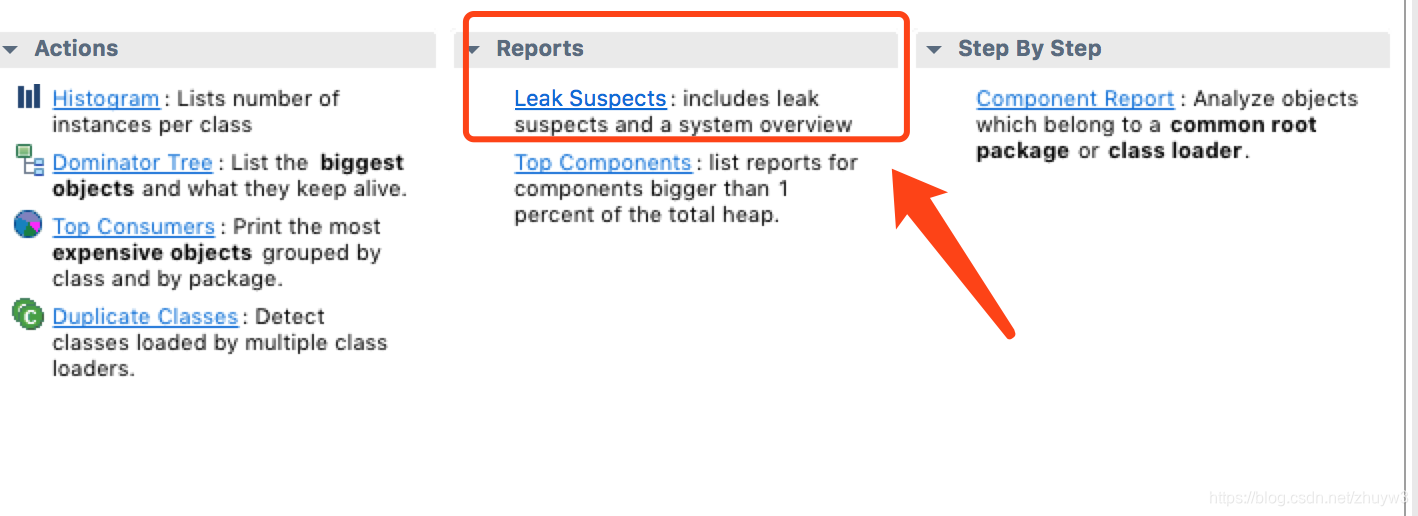
我们看到mat的报告项里会自动列出内存泄漏的嫌疑点,我们点开它查看具体报告。
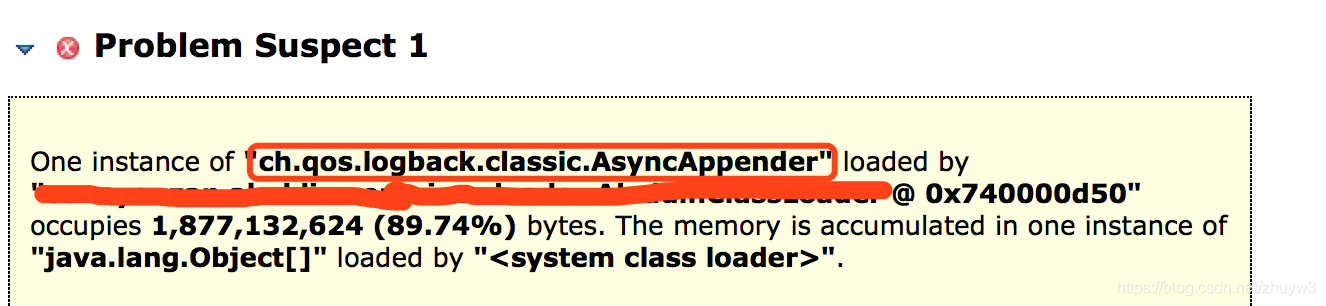
报告里直接告知了我们有一个AsyncAppender对象占据了90%的内存!!!稍微接触过logback这个日志框架的小伙伴都应该知道AsyncAppender是logback框架的一个配置包装对象,负责包装设置日志的一些配置。由此我们不由得开始怀疑,是否是由于过多的日志导致的内存泄漏问题,于是我们马不停蹄地开始下一步。
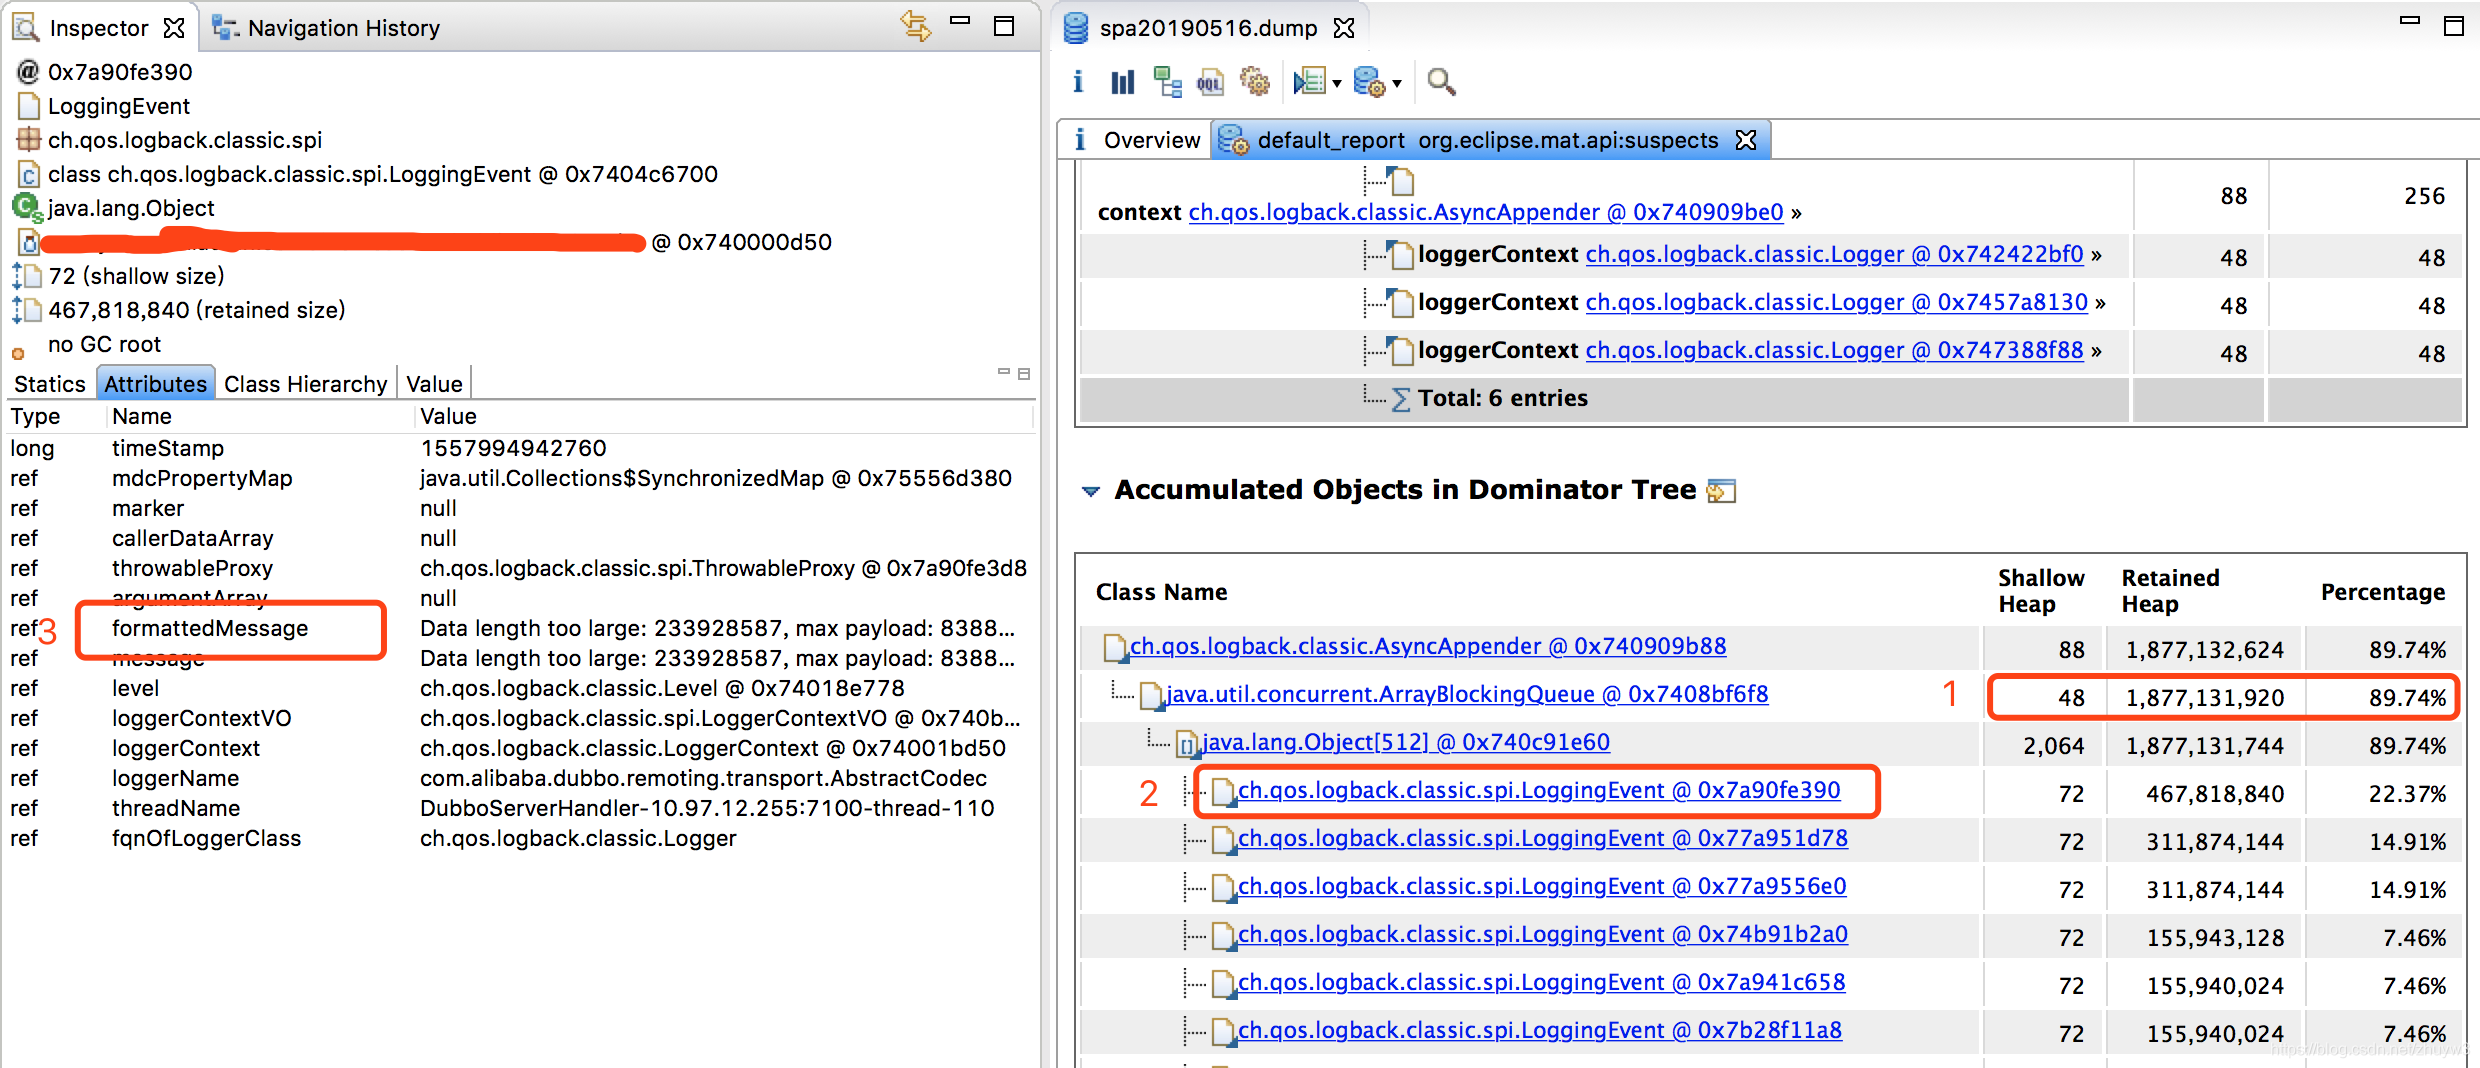
我们点进上图的泄漏嫌疑的详情, 拉到accumulate objects in dominator tree项,它为我们列出了这个asyncAppender对象的内存结构。果然如我们所料,logback框架会使用一个队列来缓存一个个loggingEvent对象,每一次调用日志输出都会被包装成一个loggingEvent缓存起来。从上图第一、二点我们看到这个日志缓存队列占据了十分巨大的内存,并且他的loggingEvent对象光一个就占了23%左右的内存,我的天。上图第三点的inspector观察窗口能展示出这个对象的具体内容,于是我们截取了前两个占比最大的loggingEvent对象的msg来看看这个日志的内容到底是啥?
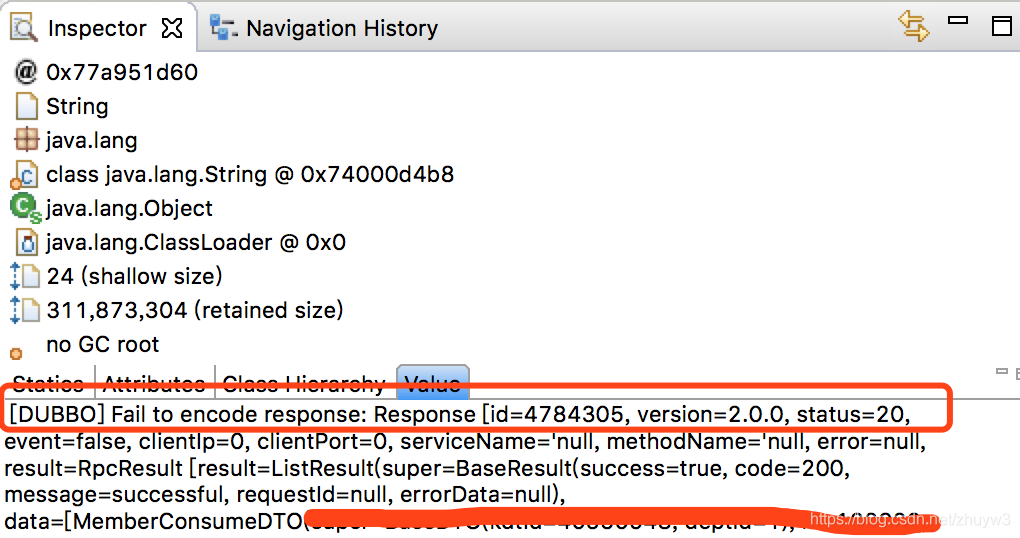
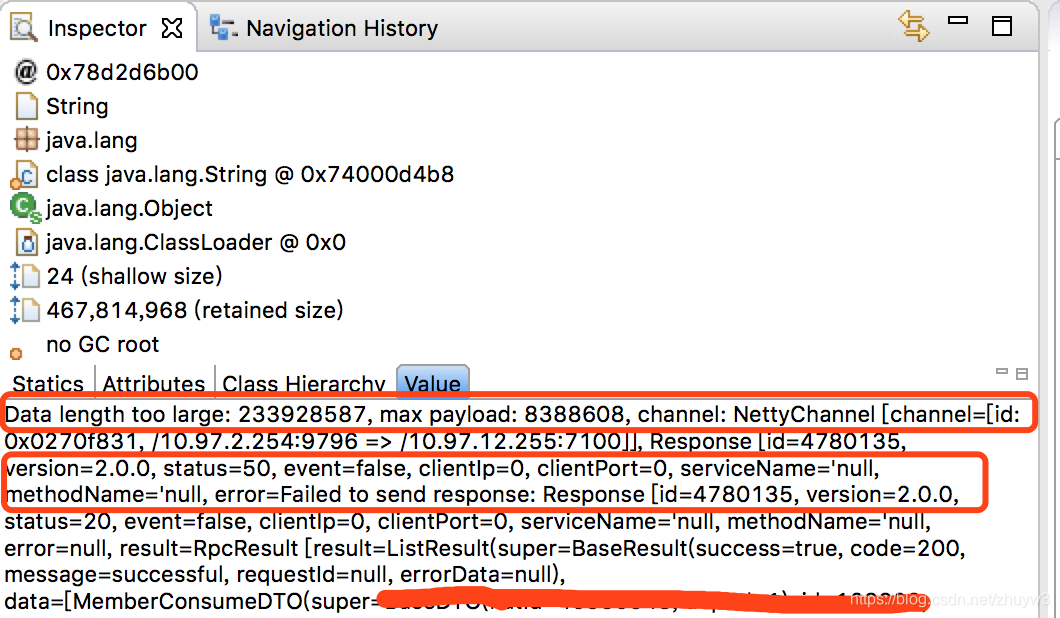
结合两个红框内的内容,我们基本确定这个是dubbo接口的生产者在返回结果时报出的传输内容长度超限问题,而且超出了两个数量级之多。顺藤摸瓜,我们紧跟着从日志内容着手,发现返回的结果 data 是一个数组,也就是在执行批量查询的时候超限了。追溯到对应表的具体批量查询,发现当有一个条件为空时,批量查询语句会跳过sql的in条件去走全表!!然而这个表一共有几十万的数据!!!
5、至此,我么已经基本确定了这次oom发生的原因。由于sql的设计错误导致批量查询数据量巨大,超过了dubbo的传输限制,因而抛出异常并写日志。而日志对象中包含了巨量的查询返回对象具体信息,并丢进异步日志队列,日志还没来得及刷新到磁盘就已经撑爆了内存,oom发生告警!!
小结:通过定位线上oom的问题,迫使自己在压力下快速学习并解决问题,的确是一个成长的好机会。虽然oom问题产生的原因不尽相同,然而对于前面工具的应用,对于问题定位的思路却是值得归纳总结的,下次再遇到类似的问题,也就不会手忙脚乱不知从何下手了。感恩!

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)