360SD-Net:面向 360° 等距柱状投影图像的双目深度估计方法
360SD-Net (2020 ICRA)针对 360° 等距柱状投影(Equirectangular Projection, ERP)图像的双目深度估计问题提出了一种结构化的深度学习解决方案。该工作以传统深度学习双目匹配框架为基础,系统分析了透视几何假设在球面成像条件下的失效原因,并围绕畸变建模与代价体构建两个关键环节进行了有针对性的改造,在多个 360° 数据集上取得了显著优于现有方法的性能。
1. 问题背景与研究动机
近年来,基于卷积神经网络的端到端双目深度估计方法(如 GCNet、PSMNet)在透视相机条件下取得了显著进展,其核心假设在于:视差可以通过沿扫描线的固定像素平移来刻画,并与深度之间近似满足反比例关系。然而,当成像模型从透视投影扩展到 360° 全景相机时,这一假设将不再成立。
等距柱状投影图像本质上是对球面信号的二维展开,其水平方向对应经度,垂直方向对应极角。该投影在上下极区引入了强烈且非均匀的拉伸畸变,导致同样的像素位移在不同纬度处对应的真实角度变化并不一致。换言之,在 ERP 图像中,像素位移已无法作为几何视差的统一度量。
这一问题在双目匹配阶段尤为突出。现有深度学习方法通常通过对一侧特征图进行逐像素平移来构建代价体(cost volume),隐含假设“一个像素对应一个固定视差步长”。在球面几何下,该假设会在高纬度区域引入系统性误差,进而影响后续的代价聚合与视差回归精度。
因此,360° 双目深度估计的核心挑战并不在于网络容量或优化策略,而在于:如何在网络结构中显式建模球面成像几何,使视差搜索与真实几何关系保持一致。
2. 球面视差建模与整体方法概述
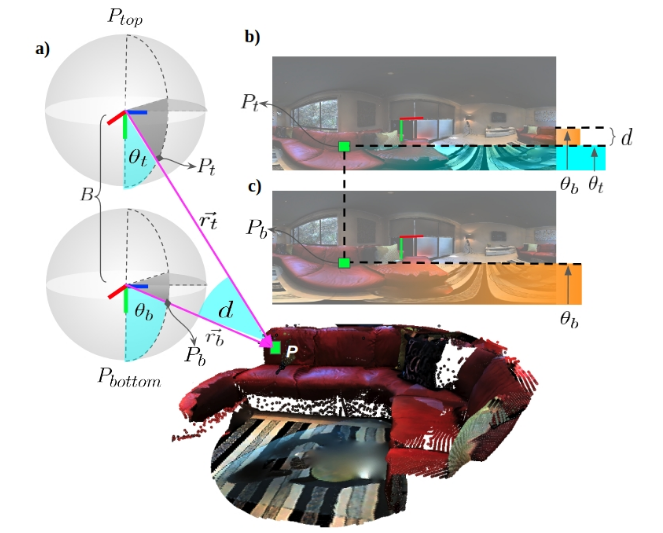
为简化匹配几何,360SD-Net 采用 Top-Bottom(上下)相机布局,使得同一空间点在 ERP 图像中落在同一竖直方向上,从而将匹配问题约化为沿垂直方向的一维搜索。基于该设定,论文不再使用像素位移来定义视差,而是引入 基于极角差的球面视差建模方式。
设上下相机中对应像素的极角分别为 θt\theta_tθt 与 θb\theta_bθb,则球面视差定义为
d=θb−θt d = \theta_b - \theta_t d=θb−θt
在该模型下,深度与视差之间的关系不再是全局线性的,而是显式依赖于像素所在的极角位置:
∣rt∣=B⋅(sin(θt)tan(d)+cos(θt)) |r_t| = B \cdot \left( \frac{\sin(\theta_t)}{\tan(d)} + \cos(\theta_t) \right) ∣rt∣=B⋅(tan(d)sin(θt)+cos(θt))
其中 BBB 为上下相机的基线长度。该公式清晰地表明,在 ERP 图像中,视差到深度的映射具有显著的空间非均匀性。
网络整体流程仍然遵循特征提取、代价体构建、3D 代价聚合与连续视差回归的经典范式,但在与球面几何强相关的两个关键环节引入了针对性改造:极角信息建模与可学习代价体构建(LCV)。
3. 网络结构与关键设计
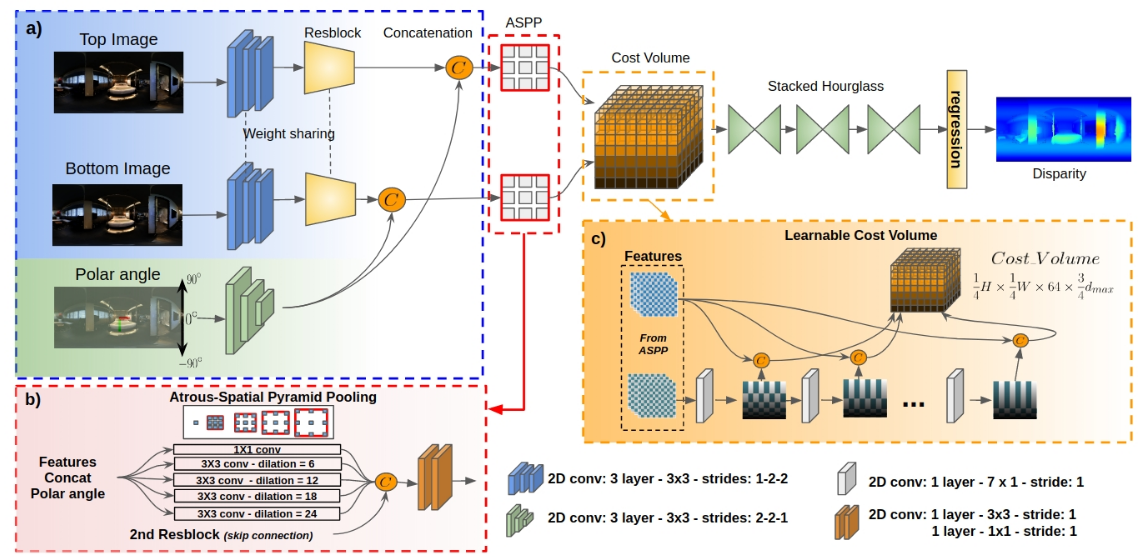
- 两分支特征提取 + 极角(polar angle)输入
- 额外输入每个像素的 polar angle(与畸变强度高度相关)作为几何提示。
- 为了分离外观与几何:RGB 用残差块提特征,polar angle 用 3 层 Conv2D 提特征;
- late fusion:在各自提完特征后再拼接(实验中优于 early fusion)。
- ASPP 模块
- 用 ASPP(空洞卷积多尺度)扩大感受野,以适配 360° 更大视野带来的长程依赖;
- 训练时用随机裁剪控制 cost volume 的显存占用。
- Learnable Cost Volume(LCV):可学习的“平移步长/平移方式”
- 传统 cost volume 常用“每层视差=1 像素平移”的固定规则;但在球面/等距柱状投影下,固定像素步长不等价于固定几何步长。
- 论文提出用一个 7x1 的 Conv2D shifting filter 来做“可学习的竖直平移”(并做 channel-wise shifting,避免通道混合)。
- padding:实验表明 replicate padding 的 LCV 更好。
- 训练策略:前 50 个 epoch 先“冻结”为普通 shift(稳定训练),之后再开启 shifting Conv2D 的学习。
- 3D Encoder-Decoder + 回归
- 采用 stacked hourglass 做 3D cost volume 聚合;
- 用 disparity regression(而非分类)输出连续视差;
- 损失:smooth L1(对 GT disparity)。
总体来说:
在特征提取阶段,360SD-Net 显式引入每个像素的 polar angle(极角)信息 作为几何先验。考虑到外观信息与几何信息在统计分布和语义上的差异,网络采用双分支结构:RGB 图像通过残差块提取外观特征,而极角图则通过轻量级卷积网络进行编码。两类特征在高层进行拼接(late fusion),实验结果表明该策略较早期融合方式更有利于网络稳定学习球面畸变模式。
针对 360° 图像视野范围大、长程依赖显著的特点,作者在特征提取后引入 ASPP(Atrous Spatial Pyramid Pooling)模块,通过多尺度空洞卷积扩大感受野,以增强对全局上下文的建模能力。为避免显存占用过高,训练过程中采用随机裁剪策略对输入进行约束。
论文的核心创新体现在 Learnable Cost Volume(LCV) 的设计上。传统 cost volume 构建方式依赖固定像素步长的平移操作,而在球面成像条件下,该操作并不对应固定的角度或深度增量。为此,360SD-Net 使用一个 7×1 的 Conv2D shifting filter 实现沿竖直方向的可学习平移,并采用 channel-wise shifting 以避免通道间信息混合。在边界处理上,实验表明 replicate padding 相较于 zero padding 能带来更稳定的性能提升。
在训练策略上,作者首先将 LCV 模块初始化为等效的固定平移操作,并在前若干 epoch 中冻结其参数,以保证训练初期的稳定性;随后逐步释放其学习能力,使网络能够自适应调整不同纬度下的特征对齐方式。
在代价体构建完成后,网络采用堆叠式 hourglass 结构对三维代价体进行正则化,并通过视差回归(disparity regression)方式直接输出连续的球面视差值,训练损失采用基于真实视差的 Smooth L1 损失函数。
4. 实验结果与分析
360SD-Net 在 MP3D(Matterport3D + MINOS 渲染)和 SF3D(Stanford3D 点云重投影)两套 360° 双目数据集上进行了系统评估。实验结果表明,在深度 RMSE 等指标上,该方法显著优于传统几何方法以及直接迁移的深度学习双目网络(如 GCNet、PSMNet),且推理时间与 PSMNet 基本相当,具备较好的实用性。
消融实验进一步验证了各模块设计的有效性:极角信息是最有效的几何提示形式,late fusion 优于 early fusion;ASPP 能稳定提升整体性能;而 LCV 是带来性能跃升的关键组件。在多种几何编码方式对比中,polar angle 明显优于水平角、半径或弧长等替代表示。
此外,作者还基于两台 Insta360 ONE X 构建了真实 top-bottom 双目系统,并通过标定对齐极轴。在真实数据上,采用灰度输入进行推理以减小域差,所得深度图和点云重建结果表明该方法具备一定的实际应用潜力。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 15
 0
- 0


 已为社区贡献1条内容

所有评论(0)