OpenMonoGS-SLAM:单目高斯溅射 SLAM 与开放集语义理解的融合突破
一、引言
1.1 研究背景与意义
同时定位与地图构建(SLAM)作为机器人、增强现实 / 虚拟现实(AR/VR)、自动驾驶等领域的核心技术,其核心目标是让智能体在未知环境中实时获取自身位置并构建环境地图。近年来,随着空间人工智能(Spatial AI)的兴起,单纯的几何重建已无法满足智能系统的需求,融合语义理解的 SLAM 技术成为研究热点 —— 它能让智能体不仅 “感知空间”,更能 “理解场景”,为后续的智能决策、人机交互提供关键支撑。
现有 SLAM 技术存在两大核心局限:
- 依赖特殊硬件或封闭语义模型:多数基于 3D 高斯溅射(3DGS)的 SLAM 方法需要深度传感器(如 RGB-D 相机)获取稠密深度信息,限制了在轻量化、低成本平台(仅配备单目 RGB 相机)的部署;同时,语义理解多局限于封闭集场景,依赖固定的类别 taxonomy 和标注数据,无法处理开放世界中的新类别物体。
- 单目 SLAM 性能瓶颈:单目 SLAM 因仅依赖 RGB 图像,具有部署灵活、成本低的优势,但现有方法在几何精度和重建完整性上难以媲美 RGB-D SLAM,如何在无深度输入的情况下实现高精度几何重建与开放语义理解的统一,是当前领域的关键挑战。
为此,本文提出OpenMonoGS-SLAM—— 首个将 3D 高斯溅射与开放集语义理解相结合的单目 SLAM 框架,通过融合视觉基础模型(VFMs)的泛化能力,实现了无需深度输入和 3D 语义标注的高精度定位、重建与开放语义理解。
原文链接:OpenMonoGS-SLAM: Monocular Gaussian Splatting SLAM with Open-set Semantics
代码链接:暂无
沐小含持续分享前沿算法论文,欢迎关注...
1.2 核心贡献
论文的核心贡献可概括为三点:
- 提出首个单目开放集语义 SLAM 框架:将视觉基础模型衍生的语义特征融入 3DGS 表示,通过多尺度特征表达,实现尺度感知的开放集语义地图构建,无需依赖深度传感器或稠密语义标注。
- 设计高效紧凑的语义融合策略:通过基于 CLIP 特征记忆库的注意力机制,将 2D 语义特征嵌入为低维高斯语义地图,实现高效的语义检索与融合;结合自监督损失,无需稠密标注即可完成开放集训练。
- 全面的性能验证:在标准数据集上验证了方法的优越性,在封闭集和开放集分割任务中均达到或超越现有基线,且仅依赖单目 RGB 输入,性能媲美甚至优于依赖 RGB-D 输入的方法。
二、相关工作综述
2.1 视觉基础模型(VFMs)
视觉基础模型通过在大规模图像数据集上进行自监督或弱监督预训练,具备强大的泛化能力和迁移能力,已深刻影响计算机视觉多个领域:
- 稠密特征学习:如 DINO、CroCo 等模型通过对比学习或掩码图像建模,学习到富含语义和几何信息的稠密特征,无需人工标注即可应用于目标发现、分割、稠密匹配等任务。
- 开放集能力拓展:SAM(分割一切模型)支持零样本分割,CLIP 实现跨模态(图像 - 文本)语义对齐,为开放集语义理解提供了核心技术支撑。
- 3D 任务适配:MASt3R、Dust3r 等模型将 2D 视觉特征与 3D 几何约束结合,为单目 3D 重建和相机跟踪提供了高精度的特征基础。
本文的核心思路之一是将这些视觉基础模型的优势整合到 SLAM 框架中,以最小化任务特异性监督,同时提升在复杂真实环境中的性能。
2.2 视觉 SLAM 技术演进
SLAM 技术的发展可分为三个关键阶段:
- 传统几何方法:基于运动恢复结构(SfM)和多视图立体视觉(MVS),依赖手工设计特征,精度有限且难以处理动态场景。
- 神经隐式表示:如 NeRF 通过神经网络建模场景辐射场,实现高保真渲染,但需离线训练,无法满足实时 SLAM 需求。
- 神经显式表示与 SLAM 融合:3D 高斯溅射(3DGS)的出现解决了 NeRF 实时性不足的问题,一系列基于 3DGS 的 SLAM 方法(如 SplatAM、GSSLAM)实现了实时稠密重建,但仍存在两个局限:① 多数依赖 RGB-D 输入;② 缺乏开放集语义理解能力,难以适应未知环境。
现有语义 SLAM 方法(如 SGS-SLAM、Hier-SLAM)虽尝试融入语义,但多局限于封闭集场景,且依赖深度输入或稠密语义标注。OpenMonoGS-SLAM 的创新之处在于,首次在单目设置下实现了 3DGS 与开放集语义的统一。
三、方法详解
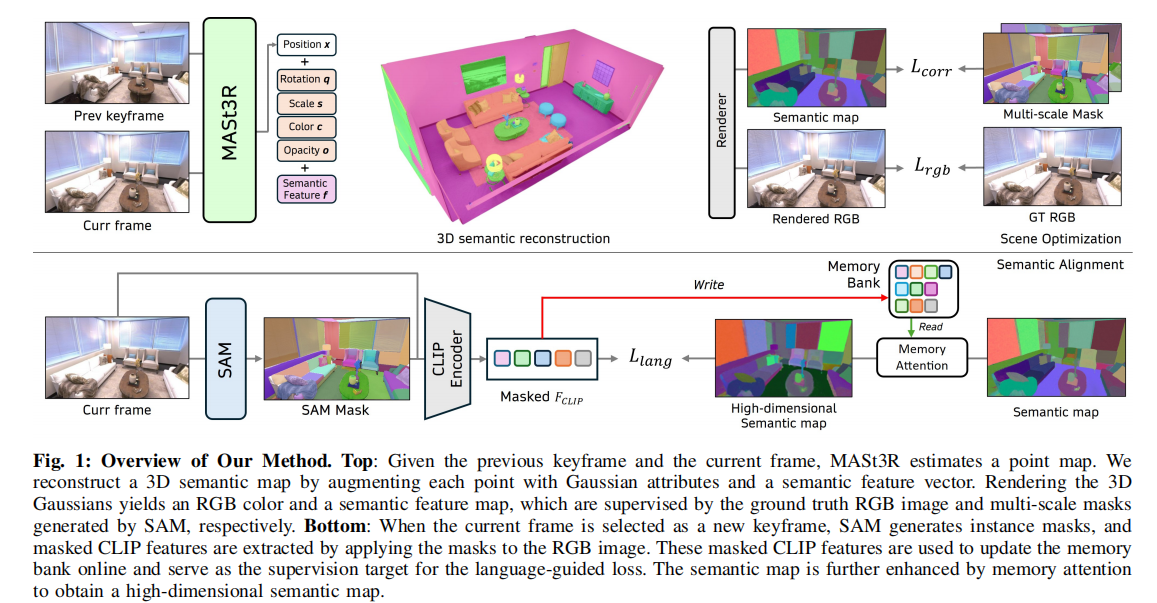
OpenMonoGS-SLAM 的整体框架基于 MASt3R-SLAM,核心是将视觉基础模型的语义特征融入 3D 高斯表示,并通过高效的记忆机制和自监督损失函数,实现几何重建与语义理解的联合优化。框架整体流程如图 1 所示:
3.1 基于 3DGS 的单目 SLAM 基础
3.1.1 MASt3R-SLAM 相机跟踪与点云估计
论文采用 MASt3R-SLAM 作为骨干网络,负责相机跟踪和稠密点云估计:
- 核心原理:MASt3R 通过提取像素级稠密特征,利用迭代优化最小化射线误差,建立不同帧之间的特征对应关系。
- 优化目标:对于参考帧
和目标帧
,通过最小化特征相似度损失找到最优像素对应:
其中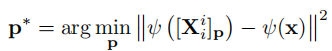
表示目标帧
- 相机跟踪损失:基于特征对应关系,通过最小化射线误差损失估计相机姿态:
其中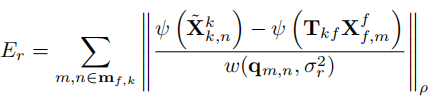
 为帧
的相对变换,w(⋅)为置信度加权函数,Huber 范数
 用于增强对异常值的鲁棒性。
3.1.2 3D 高斯表示与渲染
MASt3R 估计的 3D 点云用于初始化 3D 高斯集合,每个高斯包含以下属性:
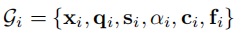
- 几何与外观属性:
(3D 位置)、
(四元数姿态)、
(尺度)、
(不透明度)、
(RGB 颜色);
- 语义属性:
 (可学习的低维语义特征)。
由于高斯初始化基于 MASt3R 的像素对齐点云,无需额外的稠密化步骤即可实现高精度渲染。渲染过程通过深度排序的阿尔法混合实现,RGB 颜色和语义特征的渲染公式分别为:
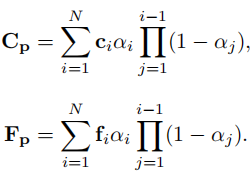
其中 为像素
的渲染颜色,
为像素
的渲染语义特征。为保证重建一致性,论文不仅使用关键帧,还引入额外的映射帧进行优化。
3.2 多尺度语义学习
为适应不同尺寸的物体语义理解,论文设计了多尺度语义学习策略:
- 2D 多尺度掩码生成:利用 SAM 对每张输入图像生成多尺度的实例掩码,这些掩码反映了场景中物体的尺度多样性;
- 3D 掩码提升:通过 MASt3R-SLAM 估计的深度信息和相机内参,将 2D 掩码提升到 3D 空间,得到 3D 语义掩码;
- 多视图一致性约束:参考 SAGA 方法,通过多视图对比学习确保不同视角下语义标注的一致性,避免单视图语义歧义。
3.3 语言嵌入的语义记忆库
SAM 生成的实例掩码缺乏语言语义关联,而直接存储所有高斯的高维 CLIP 特征会导致内存爆炸。为此,论文设计了高效的语义记忆库机制:
3.3.1 记忆库构建与更新
- 核心思想:维护一个存储代表性 CLIP 特征的记忆库,仅在新关键帧加入时更新,保证记忆库的多样性和紧凑性;
- 更新策略:当新关键帧的 CLIP 特征与记忆库中所有特征的余弦相似度均低于阈值
时,将其加入记忆库,避免冗余;
- 记忆库作用:为低维高斯语义特征提供高维语言语义的 “锚点”,实现语义的高效检索与融合。
3.3.2 注意力机制语义融合
在映射过程中,渲染得到的低维语义特征 通过注意力机制从记忆库中检索高维语义特征,公式如下:
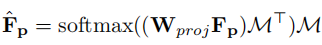
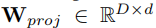 :将低维语义特征映射到记忆库特征空间的线性层;
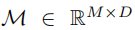 :包含M个高维 CLIP 特征的记忆库;
- 输出
 :融合了语言语义的高维语义特征,既保证了高斯表示的紧凑性,又提升了语义表达能力。
3.4 自监督学习目标
论文设计了四类自监督损失函数,联合优化几何、外观和语义:
3.4.1 光度监督(Lrgb)
通过最小化渲染图像与真实图像的差异,保证重建的视觉保真度:
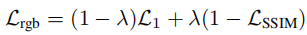
其中 为 L1 损失,
 为结构相似性指数,λ为平衡权重,确保亮度一致性和结构完整性。
3.4.2 多视图语义一致性损失(Lcorr)
通过对比学习确保不同视角下语义特征的一致性:
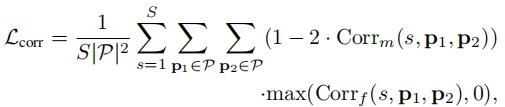
:尺度索引(S=4);
、
:分别表示掩码对应和特征对应;
- 核心作用:将语义相似的高斯特征拉近,语义不同的特征推远,保证多视图语义一致性。
3.4.3 语言引导的语义对齐损失(Llang)
通过回归损失将融合后的语义特征与 CLIP 特征对齐,注入语言先验:
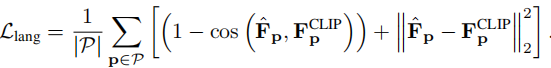
其中为像素
的 CLIP 特征,同时使用余弦相似度损失和 L2 损失,确保语义特征与语言空间的精准对齐。
3.4.4 总损失函数
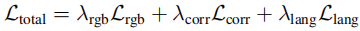
实验中设置权重: =1.0,
 =0.05,
 =0.05,平衡几何重建与语义学习。
四、实验与结果分析
4.1 实验设置
4.1.1 硬件与参数配置
- 硬件:单张 NVIDIA RTX 4090 GPU(24GB VRAM);
- 模型配置:MASt3R(预训练)、SAM(ViT-H)、CLIP(ViT-B),图像宽度 resize 到 512 像素;
- 训练参数:映射迭代次数 30K,记忆库阈值
 ,多尺度层数
 ;
- 开放集分割:采用 Grounded-SAM 实现文本提示驱动的分割。
4.1.2 数据集与评价指标
- 数据集:
- Replica 数据集:用于语义分割和新视角合成评估,提供 3D 语义标注;
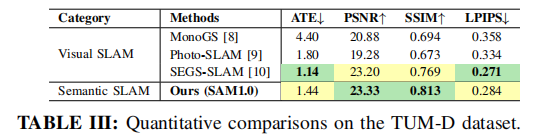
- TUM RGB-D 数据集:用于单目设置下的跟踪和重建质量评估。
- 评价指标:
- 跟踪精度:绝对轨迹误差(ATE RMSE);
- 重建质量:峰值信噪比(PSNR)、结构相似性(SSIM)、感知图像相似度(LPIPS);
- 语义分割:交并比(IoU)、平均交并比(mIoU)、频率加权交并比(FWIoU)。
4.1.3 基线方法
- 单目视觉 SLAM:MonoGS、Photo-SLAM、SEGS-SLAM;
- RGB-D 语义 SLAM:DNS-SLAM、SGS-SLAM、Hier-SLAM;
- 开放集分割:Feature 3DGS、Gaussian Grouping。
4.2 核心实验结果
4.2.1 新视角合成性能
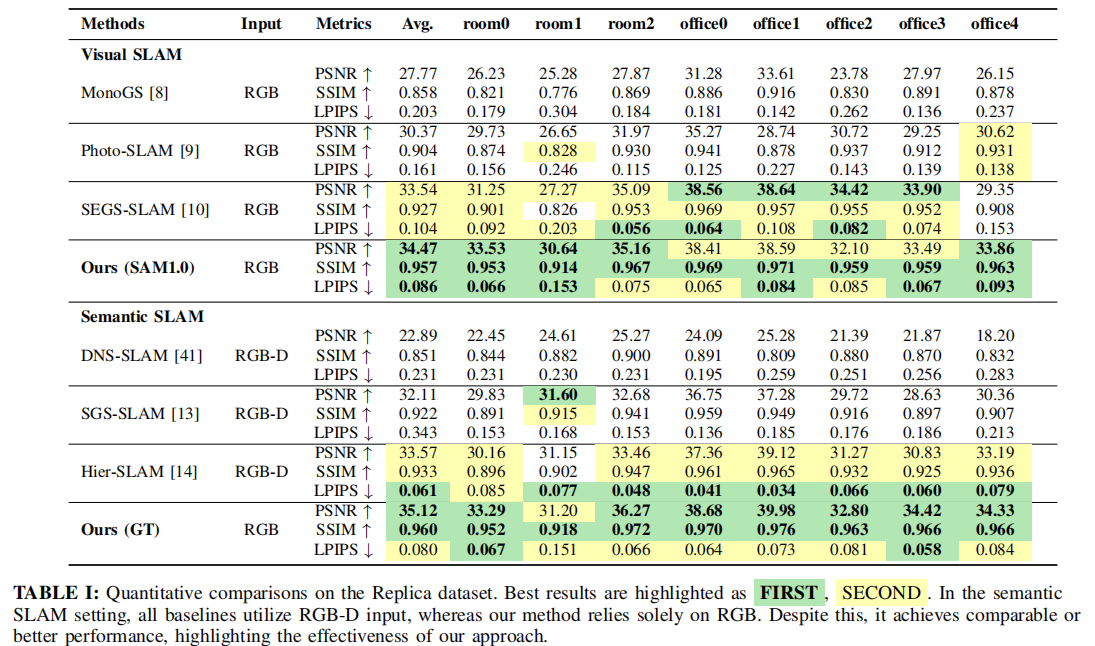
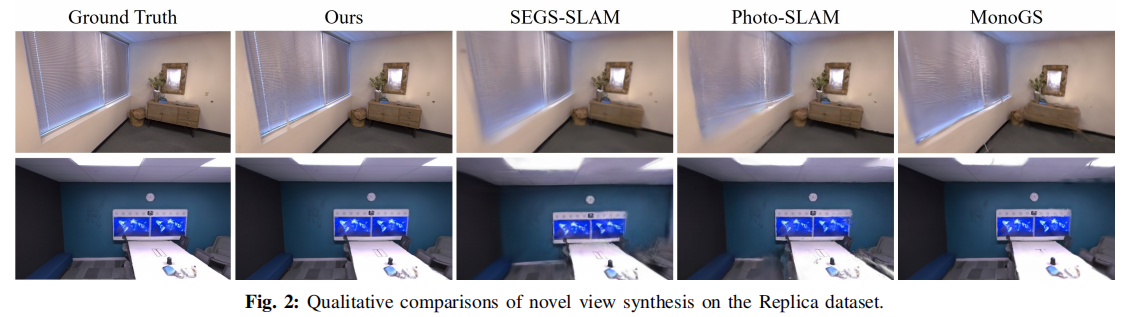
表 1 展示了 Replica 数据集上的新视角合成定量结果,图 2 为定性对比:
关键结论:
- 尽管仅使用单目 RGB 输入,OpenMonoGS-SLAM 的 PSNR 和 SSIM 均超过依赖 RGB-D 输入的 SGS-SLAM,LPIPS 略高于 SGS-SLAM 但显著优于其他单目基线;
- 语义信息的融入帮助模型更好地保留物体边界和结构一致性,重建结果更具视觉真实性。
4.2.2 相机跟踪性能
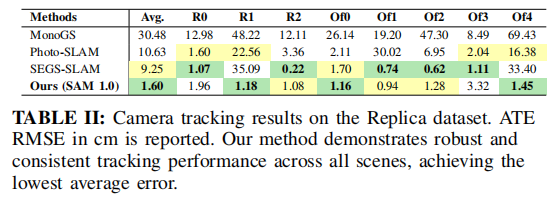
表 2 展示了 Replica 数据集上的 ATE RMSE 结果:
关键结论:
- OpenMonoGS-SLAM 的平均 ATE RMSE 仅为 1.60cm,远低于所有基线方法,且在所有场景中表现稳定(方差小);
- 视觉基础模型提供的丰富语义和几何先验,使相机跟踪在复杂场景中更鲁棒,有效抵抗遮挡和纹理缺失。
4.2.3 开放集分割性能
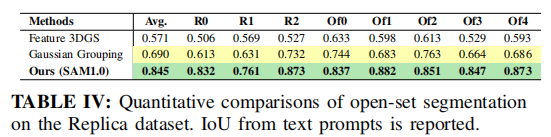
表 3 展示了文本提示驱动的开放集分割 IoU 结果,图 3 为定性对比:
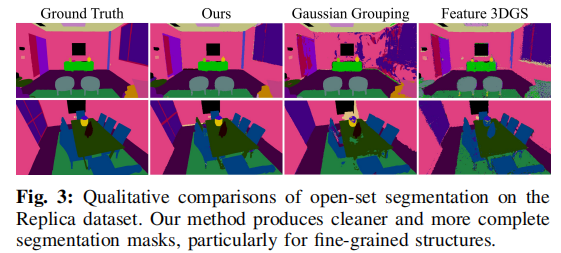
关键结论:
- OpenMonoGS-SLAM 的平均 IoU 达到 0.845,显著优于 Feature 3DGS(0.571)和 Gaussian Grouping(0.690);
- 记忆库机制有效融合了 CLIP 的语言语义,使模型能精准响应文本提示,分割掩码更完整、噪声更少,尤其在细粒度结构上表现突出。
4.2.4 封闭集分割性能
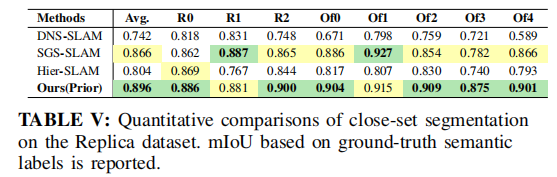
尽管核心目标是开放集语义,但论文也验证了模型在封闭集任务上的泛化能力,表 4 为 mIoU 结果:
关键结论:
- OpenMonoGS-SLAM 的平均 mIoU 达到 0.896,超过所有基线方法,仅在 R1(0.881 vs 0.887)和 Of1(0.915 vs 0.927)场景略低于 SGS-SLAM;
- 证明模型的语义学习框架不仅适用于开放集,也能高效适配封闭集任务,具备良好的通用性。
4.3 消融实验分析
为验证各核心组件的有效性,论文进行了消融实验,结果如表 5 和图 4 所示:
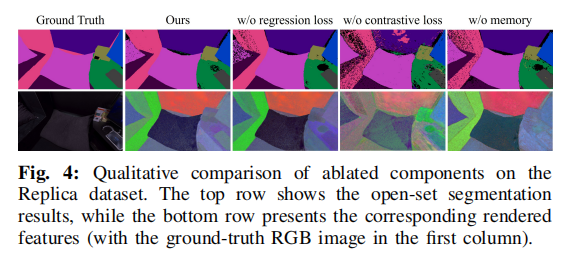
关键结论:
- 多视图对比损失至关重要:移除后 mIoU 下降 26%,分割掩码出现碎片化,证明多视图一致性约束是语义稳定性的核心;
- 语言回归损失不可或缺:移除后 mIoU 下降 4.5%,语义特征与语言空间对齐精度下降,开放集分割能力减弱;
- 记忆库机制提升显著:移除后 mIoU 下降 19%,FWIoU 和 Acc 下降约 10%,证明记忆库能有效整合跨帧语义信息,提升语义表达能力;
- 各组件协同作用:完整模型的各项指标均最优,验证了框架设计的合理性。
五、结论与未来展望
5.1 主要结论
OpenMonoGS-SLAM 通过融合 3D 高斯溅射与视觉基础模型,首次实现了单目设置下的开放集语义 SLAM,核心结论如下:
- 无需深度输入和 3D 语义标注:仅依赖单目 RGB 图像,通过自监督学习和视觉基础模型的泛化能力,实现高精度几何重建与语义理解;
- 开放集与封闭集双优:在开放集分割任务中显著优于现有方法,在封闭集任务中也达到 SOTA 水平,具备强通用性;
- 高效语义融合:基于记忆库的注意力机制,在保证高斯表示紧凑性的同时,注入高维语言语义,平衡了效率与性能。
5.2 局限性与未来方向
当前模型的主要局限性是对动态场景的鲁棒性不足(继承自 MASt3R 骨干网络),未来可从以下方向改进:
- 动态场景适配:融合 Monst3r 等针对动态环境训练的模型,提升对运动物体的鲁棒性;
- 实时性优化:进一步优化记忆库更新策略和渲染效率,适配更复杂的实时应用场景;
- 多模态融合:引入触觉、声音等多模态信息,提升语义理解的丰富性和鲁棒性;
- 端侧部署:探索模型轻量化方法,实现低算力设备上的部署。
六、技术总结
OpenMonoGS-SLAM 的核心创新在于 “将开放集语义理解无缝融入单目 3DGS-SLAM”,其技术路线可概括为:
- 基础架构:MASt3R-SLAM 提供高精度相机跟踪和点云初始化,3DGS 实现高效渲染;
- 语义增强:SAM 提供多尺度实例掩码,CLIP 提供跨模态语义对齐,记忆库实现高效语义融合;
- 优化目标:多损失联合优化,平衡几何精度、视觉保真度和语义一致性。
该方法不仅突破了现有 SLAM 对深度传感器和封闭语义模型的依赖,也为空间 AI 的发展提供了新的思路 —— 通过视觉基础模型的泛化能力,让 SLAM 系统具备更强的环境适应能力和语义理解能力,推动 SLAM 从 “几何重建工具” 向 “智能感知系统” 演进。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 13
 0
- 0


 已为社区贡献15条内容

所有评论(0)