卡尔曼滤波(EKF/IEKF)与非线性优化的统一关系
卡尔曼滤波(EKF/IEKF)与非线性优化(高斯-牛顿法)的统一关系
“Hessian 矩阵和协方差矩阵互为逆矩阵”,这一核心结论正是连接卡尔曼滤波(统计学/概率论范畴)与非线性优化(高斯-牛顿法)的关键钥匙。理解这一点,就能彻底厘清为什么扩展卡尔曼滤波(EKF)是一次高斯-牛顿迭代,而迭代扩展卡尔曼滤波(IEKF)是多次迭代。本文将结合通俗类比、核心公式与严谨推导,层层拨开迷雾,解析两者的统一本质。
信息矩阵和协方差矩阵
- 信息矩阵 = 对未知量的“了解程度”
- 协方差矩阵 = 对未知量的“不确定程度”
第一步:从高斯分布出发
假设我们对状态
x
x
x 的估计服从一个多维高斯分布,均值为
μ
\mu
μ,协方差矩阵为
P
P
P。
其概率密度函数(PDF)为:
p ( x ) = 1 ( 2 π ) k ∣ P ∣ exp ( − 1 2 ( x − μ ) T P − 1 ( x − μ ) ) p(x) = \frac{1}{\sqrt{(2\pi)^k |P|}} \exp \left( -\frac{1}{2} (x - \mu)^T P^{-1} (x - \mu) \right) p(x)=(2π)k∣P∣1exp(−21(x−μ)TP−1(x−μ))
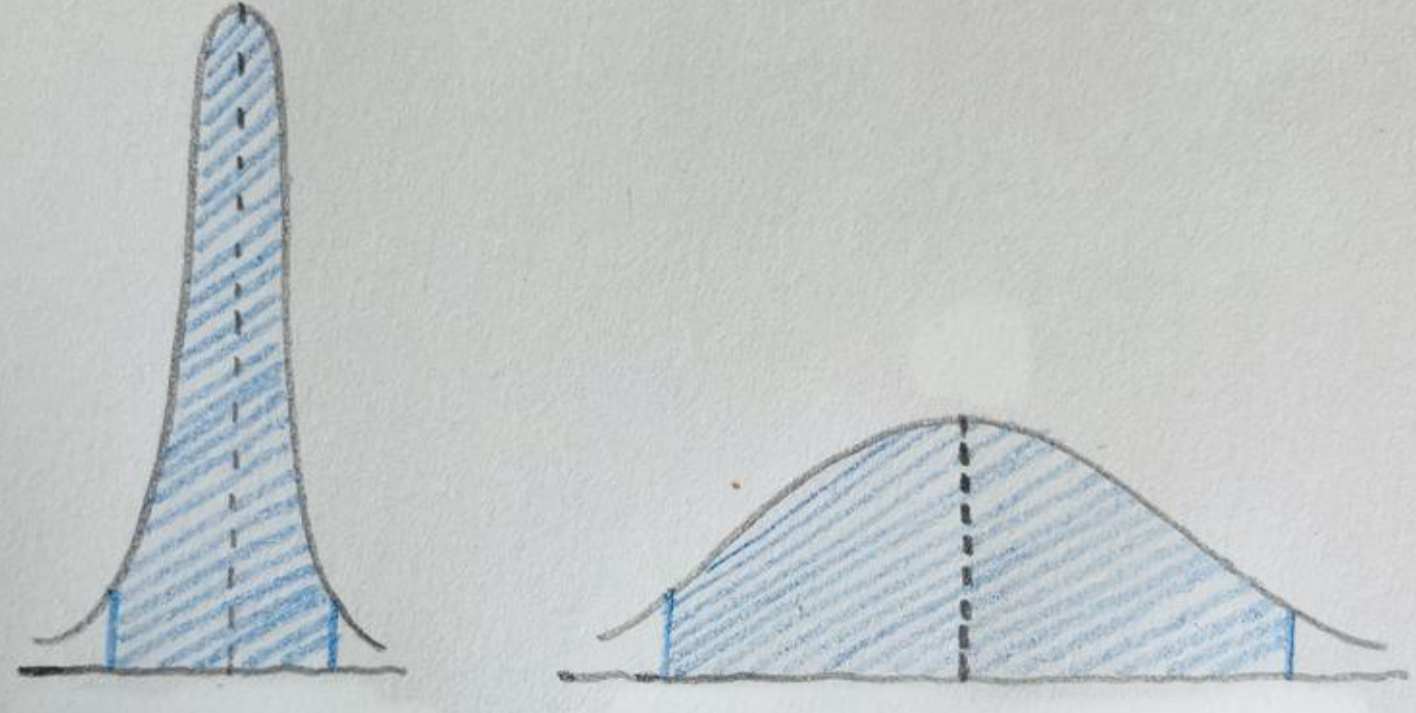
这里 P P P(协方差)直观上表示分布的“胖瘦”:
- P P P 很大 → \rightarrow → 钟形曲线很宽、很扁 → \rightarrow → 或者是“胖子”。
-
P
P
P 很小
→
\rightarrow
→ 钟形曲线很尖、很窄
→
\rightarrow
→ 或者是“瘦子”。
第二步:转为优化问题(负对数似然)
在状态估计(如 EKF/IEKF)或 SLAM 中,我们的目标是让概率
p
(
x
)
p(x)
p(x) 最大。
为了方便计算(把乘法变加法,去掉指数),我们通常是对概率取负对数,也就是求**负对数似然(Negative Log-Likelihood, NLL)**的最小值。
令代价函数
J
(
x
)
=
−
ln
(
p
(
x
)
)
J(x) = -\ln(p(x))
J(x)=−ln(p(x))。
去掉与
x
x
x 无关的常数项,我们得到一个二次型函数(抛物面):
J ( x ) = 1 2 ( x − μ ) T P − 1 ( x − μ ) + const J(x) = \frac{1}{2} (x - \mu)^T P^{-1} (x - \mu) + \text{const} J(x)=21(x−μ)TP−1(x−μ)+const
这就是我们要优化的“碗”(Bowl)。我们要找这个碗的最低点。
第三步:求导数,寻找 Hessian
现在,我们用微积分来看看这个“碗”的形状。
-
一阶导数(梯度,Gradient):
g = ∂ J ∂ x = P − 1 ( x − μ ) g = \frac{\partial J}{\partial x} = P^{-1} (x - \mu) g=∂x∂J=P−1(x−μ)
梯度为 0 的地方就是极值点( x = μ x=\mu x=μ)。 -
二阶导数(海森矩阵,Hessian):
对梯度再求一次导:
H = ∂ 2 J ∂ x 2 = ∂ ∂ x ( P − 1 ( x − μ ) ) = P − 1 \mathcal{H} = \frac{\partial^2 J}{\partial x^2} = \frac{\partial}{\partial x} (P^{-1} (x - \mu))= P^{-1} H=∂x2∂2J=∂x∂(P−1(x−μ))=P−1
或者使用高斯牛顿近似:
H = ( ∂ J ∂ x ) T P − 1 ( ∂ J ∂ x ) = P − 1 \mathcal{H} = (\frac{\partial J}{\partial x})^{\rm T} P^{-1} (\frac{\partial J}{\partial x})= P^{-1} H=(∂x∂J)TP−1(∂x∂J)=P−1
结果非常简单粗暴:
H = P − 1 \mathcal{H} = P^{-1} H=P−1
结论出现:Hessian 矩阵
H
\mathcal{H}
H 正好是协方差矩阵
P
P
P 的逆。
在信息论中,高斯分布的 Fisher 信息矩阵就是
P
−
1
P^{-1}
P−1。所以:Hessian = 信息矩阵。
第四步:物理意义推导
为什么说 Hessian 代表“了解程度”(信息),而 Covariance 代表“不确定性”?
让我们回到几何形状上,想象一个山谷(也就是我们的代价函数 J ( x ) J(x) J(x)):二阶导数(Hessian)代表“曲率”或“陡峭程度”
-
Hessian H \mathcal{H} H 很大:
- 这意味着二阶导数很大,函数的开口很陡峭。
- 形状像一个深井或尖锐的圆锥。
- 物理意义:稍微动一点点 x x x,代价函数 J ( x ) J(x) J(x) 就会剧烈变化。这说明观测数据对 x x x 约束得很死,我们对 x x x 的位置了解得非常清楚(信息量大)。位置稍微偏一点都不行。
- 对应协方差:因为 P = H − 1 P = \mathcal{H}^{-1} P=H−1, H \mathcal{H} H 很大 → \rightarrow → P P P 很小。不确定性极低。
-
Hessian H \mathcal{H} H 很小:
- 这意味着二阶导数接近 0,函数非常平坦。
- 形状像一个平底盘子。
- 物理意义: x x x 在盘子里动来动去,代价函数 J ( x ) J(x) J(x) 几乎不变。这说明观测数据对 x x x 没什么约束力,我们根本搞不清 x x x 到底在哪(信息量小)。
- 对应协方差:因为 P = H − 1 P = \mathcal{H}^{-1} P=H−1, H \mathcal{H} H 很小 → \rightarrow → P P P 很大。不确定性极高。
总结对照表
| 概念 | 数学符号 | 几何形状(一维类比) | 物理意义 |
|---|---|---|---|
| 协方差矩阵 | P P P | 抛物线的开口宽度 | 不确定性 (Uncertainty)。 越宽,如果不确定性越大,越拿不准。 |
| Hessian 矩阵 (信息矩阵) | H = P − 1 \mathcal{H} = P^{-1} H=P−1 | 抛物线的开口陡度 (曲率) | 信息量 (Information)。 越陡,说明把状态“锁”得越死,了解程度越高。 |
想象你在走钢丝(寻找最优值):
-
Hessian 大(协方差小):你掉进了一个深V型峡谷。只要你不在谷底,你就很难受。
- 推导:峡谷陡峭 → \rightarrow → 确定性高 → \rightarrow → 我很清楚自己在哪里。
-
Hessian 小(协方差大):你站在一个巨大的平坦足球场上。
- 推导:地面平坦 → \rightarrow → 随便走哪里高度都差不多 → \rightarrow → 我完全不知道“绝对中心”在哪里 → \rightarrow → 不确定性大。
这就是为什么在 SLAM 和滤波中,我们经常说:观测为系统注入了信息(增加了 Hessian 的值),从而降低了不确定性(减小了 Covariance 的值)。
一、核心直觉:卡尔曼滤波的“弹簧平衡”类比
无论是EKF、IEKF还是非线性优化,其核心目标都是求解“最准确的状态” x x x ,本质上都是一个加权最小二乘问题。我们可以用一个直观的“弹簧平衡”系统来理解这一过程:
-
先验(预测)约束:我们拥有状态的先验预测值 x ^ − \hat{x}^- x^− ,它像一根弹簧牵引着目标状态 x x x ,弹簧的“硬度”由 P − 1 P^{-1} P−1 (信息矩阵)决定。核心规律是:协方差 P P P 越大,代表先验预测的不确定性越强(越不准),对应的信息矩阵 P − 1 P^{-1} P−1 越小(弹簧越软),对 x x x 的牵引作用越弱。
-
观测(更新)约束:我们拥有观测值 z z z ,它通过观测方程 h ( x ) h(x) h(x) 也对状态 x x x 产生牵引,其弹簧“硬度”由 R − 1 R^{-1} R−1 (观测噪声协方差的逆)决定,观测噪声越小,弹簧越硬,对 x x x 的牵引作用越强。
整个过程的目标,就是找到让这个“弹簧系统”能量(即代价函数)最小的平衡点,也就是最优状态估计值 x x x 。
二、EKF vs 高斯牛顿
卡尔曼滤波的状态更新过程,本质上是求解一个非线性最小二乘问题,而高斯-牛顿法正是求解这类问题的核心方法,我们通过代价函数推导可清晰看到两者的关联。
最速法、牛顿法,高斯牛顿法都是一次迭代算法,但由于函数非线性化性以及线性化点的选择,从而需要多次迭代。
2.1 高斯牛顿 vs EKF
1. 定义非线性最小二乘问题
在
k
k
k 时刻,我们拥有先验信息
x
^
−
\hat{x}^-
x^−(协方差为
P
P
P)和观测信息
z
z
z(观测噪声协方差为
R
R
R)。根据最大后验估计(MAP),我们要最小化的代价函数为:
J ( x ) = 1 2 ∥ x − x ^ − ∥ P − 1 2 + 1 2 ∥ z − h ( x ) ∥ R − 1 2 J(x) = \frac{1}{2} \|x - \hat{x}^-\|_{P^{-1}}^2 + \frac{1}{2} \|z - h(x)\|_{R^{-1}}^2 J(x)=21∥x−x^−∥P−12+21∥z−h(x)∥R−12
2. 线性化:高斯-牛顿的第一步
为了求解
J
(
x
)
J(x)
J(x) 的极小值,高斯-牛顿法在当前参考点(对于 EKF 来说,这个点固定为
x
^
−
\hat{x}^-
x^−)对观测方程
h
(
x
)
h(x)
h(x) 进行一阶泰勒展开:
h
(
x
)
≈
h
(
x
^
−
)
+
H
(
x
−
x
^
−
)
其中
H
=
∂
h
∂
x
∣
x
^
−
h(x) \approx h(\hat{x}^-) + H(x - \hat{x}^-) \quad \text{其中 } H = \left. \frac{\partial h}{\partial x} \right|_{\hat{x}^-}
h(x)≈h(x^−)+H(x−x^−)其中 H=∂x∂h
x^−
令
Δ
x
=
x
−
x
^
−
\Delta x = x - \hat{x}^-
Δx=x−x^−,则代价函数近似为:
J ( Δ x ) ≈ 1 2 Δ x T P − 1 Δ x + 1 2 ( z − h ( x ^ − ) − H Δ x ) T R − 1 ( z − h ( x ^ − ) − H Δ x ) J(\Delta x) \approx \frac{1}{2} \Delta x^T P^{-1} \Delta x + \frac{1}{2} (z - h(\hat{x}^-) - H\Delta x)^T R^{-1} (z - h(\hat{x}^-) - H\Delta x) J(Δx)≈21ΔxTP−1Δx+21(z−h(x^−)−HΔx)TR−1(z−h(x^−)−HΔx)
3. 求导与 Hessian 矩阵近似
对
Δ
x
\Delta x
Δx 求梯度(一阶导):
∂
J
∂
Δ
x
=
P
−
1
Δ
x
−
H
T
R
−
1
(
z
−
h
(
x
^
−
)
−
H
Δ
x
)
\frac{\partial J}{\partial \Delta x} = P^{-1} \Delta x - H^T R^{-1} (z - h(\hat{x}^-) - H\Delta x)
∂Δx∂J=P−1Δx−HTR−1(z−h(x^−)−HΔx)
整理得:
∂
J
∂
Δ
x
=
(
P
−
1
+
H
T
R
−
1
H
)
Δ
x
−
H
T
R
−
1
(
z
−
h
(
x
^
−
)
)
\frac{\partial J}{\partial \Delta x} = (P^{-1} + H^T R^{-1} H) \Delta x - H^T R^{-1} (z - h(\hat{x}^-))
∂Δx∂J=(P−1+HTR−1H)Δx−HTR−1(z−h(x^−))
令一阶导等于
0
0
0 以寻找极值点,我们得到高斯-牛顿的增量方程:
(
P
−
1
+
H
T
R
−
1
H
)
⏟
H
(Hessian)
Δ
x
=
H
T
R
−
1
(
z
−
h
(
x
^
−
)
)
⏟
−
g
(Negative Gradient)
\underbrace{(P^{-1} + H^T R^{-1} H)}_{\mathcal{H} \text{ (Hessian)}} \Delta x = \underbrace{H^T R^{-1} (z - h(\hat{x}^-))}_{-g \text{ (Negative Gradient)}}
H (Hessian)
(P−1+HTR−1H)Δx=−g (Negative Gradient)
HTR−1(z−h(x^−))
这里的
H
\mathcal{H}
H 就是 Hessian 矩阵(也叫信息矩阵),它刻画了系统的确定度。
4. 关键转换:从信息矩阵到卡尔曼增益
现在我们解出
Δ
x
\Delta x
Δx:
Δ
x
=
(
P
−
1
+
H
T
R
−
1
H
)
−
1
H
T
R
−
1
(
z
−
h
(
x
^
−
)
)
\Delta x = (P^{-1} + H^T R^{-1} H)^{-1} H^T R^{-1} (z - h(\hat{x}^-))
Δx=(P−1+HTR−1H)−1HTR−1(z−h(x^−))
这一步已经是状态更新了,但看起来和卡尔曼滤波的
K
(
z
−
h
(
x
)
)
K(z-h(x))
K(z−h(x)) 并不像。我们需要引入 Sherman-Morrison-Woodbury 矩阵恒等式:
(
A
+
U
C
V
)
−
1
U
C
=
A
−
1
U
(
C
−
1
+
V
A
−
1
U
)
−
1
(A + UCV)^{-1} U C = A^{-1} U (C^{-1} + V A^{-1} U)^{-1}
(A+UCV)−1UC=A−1U(C−1+VA−1U)−1
将我们的变量代入恒等式:
A
=
P
−
1
⟹
A
−
1
=
P
A = P^{-1} \implies A^{-1} = P
A=P−1⟹A−1=P
U
=
H
T
U = H^T
U=HT
C
=
R
−
1
⟹
C
−
1
=
R
C = R^{-1} \implies C^{-1} = R
C=R−1⟹C−1=R
V
=
H
V = H
V=H
代入后得到:
(
P
−
1
+
H
T
R
−
1
H
)
−
1
H
T
R
−
1
=
P
H
T
(
R
+
H
P
H
T
)
−
1
(P^{-1} + H^T R^{-1} H)^{-1} H^T R^{-1} = P H^T (R + H P H^T)^{-1}
(P−1+HTR−1H)−1HTR−1=PHT(R+HPHT)−1
等式右边正是标准卡尔曼增益
K
K
K!
5. 结论:EKF 的真面目
经过上述推导,原本属于高斯-牛顿法的优化步,完美变成了卡尔曼滤波的更新步:
x
^
p
o
s
t
=
x
^
−
+
K
(
z
−
h
(
x
^
−
)
)
\hat{x}_{post} = \hat{x}^- + K(z - h(\hat{x}^-))
x^post=x^−+K(z−h(x^−))
核心本质总结:
EKF 的更新本质上就是一次高斯-牛顿迭代。它从先验点出发,计算一个梯度,迈出一步,然后就宣称找到了最优解。
后验协方差矩阵
P
p
o
s
t
P_{post}
Ppost 其实就是高斯-牛顿法中 Hessian 矩阵的逆:
P
p
o
s
t
=
H
−
1
=
(
P
−
1
+
H
T
R
−
1
H
)
−
1
P_{post} = \mathcal{H}^{-1} = (P^{-1} + H^T R^{-1} H)^{-1}
Ppost=H−1=(P−1+HTR−1H)−1
IEKF 的逻辑:既然 EKF 只走一步不准,IEKF 就把这个
x
^
p
o
s
t
\hat{x}_{post}
x^post 作为新的线性化点,重新计算
H
H
H 和
K
K
K,再走一步。直到走不动(收敛)为止,这就完成了从滤波器到全量优化器的华丽转身。
2.2 EKF vs 高斯牛顿
-
线性化点选定:
x o p = x ^ k ∣ k − 1 ≜ x ^ − x_{op} = \hat{x}_{k|k-1} \triangleq \hat{x}^- xop=x^k∣k−1≜x^− -
在先验点计算雅可比(一次定终身):
H k = ∂ h ∂ x ∣ x ^ − H_k = \left. \frac{\partial h}{\partial x} \right|_{\hat{x}^-} Hk=∂x∂h x^− -
近似 Hessian(用最粗糙的版本):
H ≈ P − 1 + H T R − 1 H \mathcal{H} \approx P^{-1} + H^T R^{-1} H H≈P−1+HTR−1H (注意:这个 H 是老的!) -
梯度(在先验点计算):
g = P − 1 ( x ^ − − x ^ − ) + H T R − 1 ( z − h ( x ^ − ) ) = H T R − 1 ( z − h ( x ^ − ) ) g = P^{-1}(\hat{x}^- - \hat{x}^-) + H^T R^{-1} (z - h(\hat{x}^-)) = H^T R^{-1} (z - h(\hat{x}^-)) g=P−1(x^−−x^−)+HTR−1(z−h(x^−))=HTR−1(z−h(x^−)) -
高斯-牛顿搜索方向(本该多次迭代的Δx,现在只算一次就敢上天):
Δ x = H − 1 g = ( P − 1 + H T R − 1 H ) − 1 H T R − 1 ( z − h ( x ^ − ) ) \Delta x = \mathcal{H}^{-1} g = (P^{-1} + H^T R^{-1} H)^{-1} H^T R^{-1} (z - h(\hat{x}^-)) Δx=H−1g=(P−1+HTR−1H)−1HTR−1(z−h(x^−)) -
最终状态更新(强行收手):
x ^ k ∣ k = x ^ − + Δ x = x ^ − + K ( z − h ( x ^ − ) ) \hat{x}_{k|k} = \hat{x}^- + \Delta x = \hat{x}^- + K (z - h(\hat{x}^-)) x^k∣k=x^−+Δx=x^−+K(z−h(x^−))
其中 K = P H T ( H P H T + R ) − 1 K = P H^T (H P H^T + R)^{-1} K=PHT(HPHT+R)−1
至此,EKF 全部算法步骤结束。
三、EKF与IEKF的核心区别:高斯-牛顿迭代次数的差异
明确了“卡尔曼更新=高斯-牛顿一次迭代”后,EKF与IEKF的区别就变得十分简单:两者的本质差异的是高斯-牛顿法的迭代次数,以及线性化点的选择。
3.1 EKF:高斯-牛顿法的单次迭代
EKF的核心特点是“仅线性化一次”:
-
线性化点固定:始终选在先验预测值 x ^ k ∣ k − 1 \hat{x}_{k|k-1} x^k∣k−1 ,即初始预测点。
-
迭代次数:仅执行一次高斯-牛顿迭代(算一次雅可比 H H H 、一次卡尔曼增益 K K K ,完成一次状态更新)。
-
局限性:当观测方程 h ( x ) h(x) h(x) 非线性较强(“曲面较弯曲”),且先验预测值离真实状态较远时,固定初始点的线性化近似误差会很大,导致状态估计精度下降——相当于“在初始位置估算一次下坡方向,闭着眼睛跳一步”,很可能偏离最优解。
3.2 IEKF:高斯-牛顿法的多次迭代(直至收敛)
IEKF的核心改进是“迭代线性化、逐步逼近最优解”,其逻辑完全对应高斯-牛顿法的完整求解过程(线性化→求解线性系统→更新状态→验证收敛):
-
第一步:在先验预测点 x ^ k ∣ k − 1 \hat{x}_{k|k-1} x^k∣k−1 线性化,执行一次标准EKF更新,得到第一次状态估计 x ^ ( 1 ) \hat{x}^{(1)} x^(1) 。
-
第二步:以更接近真实值的 x ^ ( 1 ) \hat{x}^{(1)} x^(1) 作为新的线性化点,重新计算雅可比矩阵 H H H (此时的“斜率”更准确)。
-
第三步:基于新的雅可比矩阵,重新构造Hessian矩阵(即重新计算卡尔曼增益 K K K ),执行第二次状态更新,得到 x ^ ( 2 ) \hat{x}^{(2)} x^(2) 。
-
重复上述步骤,直至状态估计值收敛(两次更新的差值小于设定阈值),停止迭代。
IEKF相当于“跳一步后,睁开眼修正方向,再跳几步,直到跳到坑底(最优解)”,能有效降低非线性较强场景下的估计误差,这也是VINS-Mono、ORB-SLAM3等顶级SLAM系统中,优先选用IEKF而非EKF的核心原因。
四、核心概念对应表(卡尔曼滤波 vs 非线性优化)
为进一步强化两者的统一认知,下表汇总了两个领域中核心概念的对应关系,清晰体现“同一本质、不同命名”的特点:
| 核心概念 | 卡尔曼滤波(EKF/IEKF)中的命名 | 非线性优化(高斯-牛顿法)中的命名 | 核心关系与解读 |
|---|---|---|---|
| P P P | 协方差矩阵 | 逆Hessian矩阵( H − 1 \mathcal{H}^{-1} H−1 ) | 协方差描述状态不确定性,Hessian描述代价函数“陡峭程度”(信息量); P P P 越大, H \mathcal{H} H 越小,不确定性越强、信息量越弱。 |
| P − 1 P^{-1} P−1 | 信息矩阵 | Hessian矩阵( H \mathcal{H} H ) | 两者完全等价,均描述“状态信息的置信度”,是连接两者的核心桥梁。 |
| z − h ( x ) z - h(x) z−h(x) | 新息(Innovation) | 残差(Residual) | 本质一致,均表示“观测值与状态估计值的偏差”,是更新状态的核心依据。 |
| K K K | 卡尔曼增益 | 近似牛顿步长系数 | 决定状态更新的“步长”,本质是平衡先验信息与观测信息的权重。 |
| EKF | 扩展卡尔曼滤波 | 单次高斯-牛顿迭代 | 仅在初始先验点线性化一次,近似求解最优解,计算量小但精度较低。 |
| IEKF | 迭代扩展卡尔曼滤波 | 多次高斯-牛顿迭代(直至收敛) | 动态更新线性化点,逐步逼近最优解,精度高,与高斯-牛顿法完全等价(高斯假设下)。 |
五、总结:非线性估计的终极真相
本文的核心结论可概括为一句话:EKF和IEKF本质上都是高斯-牛顿法求解非线性最小二乘问题的具体实现,区别仅在于迭代次数;卡尔曼滤波与非线性优化(高斯-牛顿法)在高斯假设下完全统一,只是“穿了不同的马甲”。
具体来说:
-
EKF是“简化版”高斯-牛顿法:只执行一次迭代,以先验预测点为固定线性化点,用一次更新近似最优解,牺牲精度换取计算效率。
-
IEKF是“完整版”高斯-牛顿法:执行多次迭代,动态更新线性化点,直至状态收敛,能精确求解非线性高斯最大后验(MAP)问题,精度更高。
-
核心桥梁是“协方差矩阵与Hessian矩阵互为逆矩阵”:这一关系将卡尔曼滤波的“协方差更新”与非线性优化的“代价函数优化”紧密结合,让我们能从统一的视角理解两类算法的本质。
理解这一统一关系,不仅能彻底厘清EKF与IEKF的区别,更能打通非线性估计领域的核心逻辑——无论是递归贝叶斯框架下的卡尔曼滤波,还是批量优化框架下的高斯-牛顿法,其底层目标都是找到最优状态估计,只是实现路径和命名方式不同而已。
滤波器(IEKF):
  时刻 k 到来 → 估计 x_k → 立即将 x_{k-1} 边际化掉
  ✅ 状态维度恒定,计算量恒定 O(1)
  ❌ 边际化是不可逆的,过去的信息被"压缩"进协方差矩阵
     → 无法对过去状态重新线性化
     → 一旦线性化点不准,误差被永久固化

图优化/滑窗(最小二乘问题)优化:
  保留最近 N 帧的状态 [x_{k-N}, ..., x_k]
  ✅ 可以反复重新线性化所有保留的状态
  ✅ 非线性误差处理更好
  ❌ 计算量随窗口大小增长 O(N)
因此:IEKF与单节点最小二乘优化迭代算法等效。
IEKF vs 单节点 Gauss-Newton 的算力对比
拆解计算量
设:
- n = 状态维度(FAST-LIO2 中 n ≈ 18~24)
- m = 观测数(一帧中用于匹配的点数,m ≈ 数百~数千)
┌──────────────────┬───────────────────────┬────────────────────┐
│    计算步骤       │   Gauss-Newton        │   IEKF              │
├──────────────────┼───────────────────────┼────────────────────┤
│ 构建 Jacobian J  │ O(mn)                 │ O(mn)  相同         │
│ (每个点对状态     │ m个点,每点n维偏导     │                     │
│  的偏导数)        │                       │                     │
├──────────────────┼───────────────────────┼────────────────────┤
│ 构建 H = J^TWJ   │ O(mn²)               │ O(mn²) 相同         │
│ (Hessian近似 /   │                       │ (等价于 H^T R^{-1}H)│
│  信息矩阵)       │                       │                     │
├──────────────────┼───────────────────────┼────────────────────┤
│ 构建 b = J^TWr   │ O(mn)                │ O(mn)  相同         │
│ (梯度)           │                       │                     │
├──────────────────┼───────────────────────┼────────────────────┤
│ 求解 Hδx = b     │ O(n³)                │ O(n³)  相同         │
│ (n×n 线性系统)    │                       │ (通过卡尔曼增益)     │
├──────────────────┼───────────────────────┼────────────────────┤
│ 协方差传播        │ ❌ 不需要             │ O(n²) ~ O(n³)      │
│ (预测阶段)        │                       │ ⚠️ 额外开销         │
├──────────────────┼───────────────────────┼────────────────────┤
│ 协方差更新        │ ❌ 不需要             │ O(n²) ~ O(n³)      │
│ P=(I-KH)P       │                       │ ⚠️ 额外开销         │
├──────────────────┼───────────────────────┼────────────────────┤
│ IMU预积分        │ 需要(提供先验)       │ 需要(预测阶段)     │
│ (作为先验项)      │ 但权重矩阵怎么设?     │ 自然融入协方差传播   │
├──────────────────┼───────────────────────┼────────────────────┤
│ 每次迭代总计      │ O(mn²) + O(n³)       │ O(mn²) + O(n³)     │
│                  │                       │ + O(n³)额外         │
└──────────────────┴───────────────────────┴────────────────────┘
关键数值分析
代入实际数字:
  n = 18 (状态维度)
  m = 1000 (每帧使用的点数)

主项 O(mn²):
  1000 × 18² = 324,000 次乘法运算

协方差额外开销 O(n³):
  18³ = 5,832 次乘法运算

比例:5,832 / 324,000 ≈ 1.8%
结论:
━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━
IEKF 比 Gauss-Newton 多出的计算量 ≈ 2%
                                  ↑
                            可以忽略不计!

真正的计算瓶颈不在状态估计,而在:
  🔴 ikd-Tree 最近邻搜索:每个点 O(log N),N=地图总点数
  🔴 局部平面拟合:每个点找 5 个邻居 → 拟合平面
  🔴 总计:O(m log N) 远大于 O(mn²)

  所以 IEKF 和 GN 的差异在整个系统中几乎看不到
━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━
FAST-LIO2 的额外优化技巧
FAST-LIO2 论文中还用了一个数学技巧来加速 IEKF:

传统卡尔曼增益:
  K = P H^T (H P H^T + R)^{-1}
  其中 (H P H^T + R) 是 m×m 矩阵 → 求逆 O(m³) 💀

FAST-LIO2 用 Woodbury 恒等式变换:
  K = (P^{-1} + H^T R^{-1} H)^{-1} H^T R^{-1}
  其中 (P^{-1} + H^T R^{-1} H) 是 n×n 矩阵 → 求逆 O(n³) ✅

  m ≈ 1000, n ≈ 18
  O(m³) = 10⁹  vs  O(n³) = 5832
  → 加速了 6 个数量级!

这就是为什么 FAST-LIO2 能做到 <10ms/帧
最终总结
┌─────────────────────────────────────────────────────┐
│                                                     │
│  "协方差性价比低"这个判断的修正:                       │
│                                                     │
│  计算开销:额外 ~2%,几乎免费                          │
│  获得收益:自动融合权重 + 退化处理 + 下游信息传递        │
│                                                     │
│  性价比结论:极高!是用 2% 的代价换来了核心能力          │
│                                                     │
│  真正"性价比低"的情况:                                │
│    当状态维度 n 很大时(如 SLAM 中优化上千个路标点)     │
│    n³ 不再可忽略 → 这时确实不适合维护完整协方差         │
│    → 这也是为什么大规模 SLAM 用图优化而非滤波           │
│                                                     │
└─────────────────────────────────────────────────────┘
协方差到底值不值得算?
如果只看"最终解出的位姿",确实等价,协方差的传递和更新带来更多的运算量。但协方差的价值不在于最终的解,而在于过程中的决策。
协方差的三个不可替代的作用
作用一:自动平衡传感器权重
核心问题:IMU 预测说"我在这",LiDAR 观测说"我在那"
          → 该信谁?信多少?

有协方差时(IEKF):
  ┌─────────────────────────────────────────────┐
  │ 两帧 LiDAR 之间 IMU 积分了 100ms             │
  │ → 协方差 P_pred 自动增长                      │
  │ → 表示"IMU 积了一会儿,不太确定了"             │
  │                                              │
  │ LiDAR 来了一帧,观测噪声 R 较小               │
  │ → 卡尔曼增益 K = P H^T (H P H^T + R)^{-1}   │
  │ → P 大、R 小 → K 大 → 更信 LiDAR ✅          │
  │                                              │
  │ 反过来,如果 LiDAR 退化(观测信息少):          │
  │ → R 在退化方向很大                             │
  │ → K 在该方向很小 → 更信 IMU ✅                 │
  │                                              │
  │ 这一切是 自动的、逐方向的、自适应的              │
  └─────────────────────────────────────────────┘

没有协方差时(纯优化):
  你需要手动设定权重矩阵 W:

  min  || r_lidar ||²_W_lidar + || r_imu ||²_W_imu

  W_lidar 和 W_imu 怎么设?
  → 固定值?那退化时怎么办?
  → 自适应?那你其实在重新发明协方差...
作用二:退化场景的逐方向处理
这是最关键的!

场景:长走廊
  x方向(沿走廊):LiDAR 几乎没有约束
  y方向(垂直墙壁):LiDAR 约束很强
  z方向(垂直地面):LiDAR 约束较强

协方差矩阵可以表示这种 各向异性的不确定性:

     ┌                    ┐
     │ σ²_x(大)   0    0  │
 P ≈ │  0    σ²_y(小)  0  │
     │  0      0   σ²_z(小)│
     └                    ┘

→ 卡尔曼增益在 x 方向小(信 IMU)
→ 卡尔曼增益在 y、z 方向大(信 LiDAR)
→ 自动实现了"退化方向靠 IMU,非退化方向靠 LiDAR"

纯优化若不维护协方差:
  要么整体信 LiDAR → x方向被噪声拽飞
  要么整体信 IMU → y、z方向精度浪费
  要么你自己做退化检测 + 方向分析 → 复杂度更高
作用三:传递给下游系统
FAST-LIO2 → RTABMAP

如果有协方差:
  RTABMAP 在图优化中为里程计边设置信息矩阵 Ω = P^{-1}
  → 精确反映这条边"哪个方向可信、哪个方向不可信"
  → 全局优化更准确

如果没有协方差:
  RTABMAP 只能用默认的固定权重
  → 所有里程计边一视同仁
  → 优化质量下降
你说的"求均值就够了"在以下条件下成立:
  ✅ 单一传感器(不需要融合权重)
  ✅ 各向同性的观测环境(不需要方向性权重)
  ✅ 不需要给下游提供不确定性信息

但在 FAST-LIO2 的场景下:
  ❌ LiDAR + IMU 紧耦合 → 需要融合权重
  ❌ 各种退化场景 → 需要方向性权重
  ❌ 要给 RTABMAP 提供协方差 → 需要不确定性
  → 协方差不可或缺

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 13
 0
- 0


 已为社区贡献4条内容

所有评论(0)