多头注意力机制:Multi-Head Self-Attention
·
Multi-Head Self-Attention得到的新的词向量可以比Self-Attention得到的词向量有进一步提升。
1 为什么要MultiHeadAttention
1.1 多头的原理
经过上面内容的介绍,我们算是在一定程度上对于自注意力机制有了清晰的认识,不过在上面我们也提到了自注意力机制的缺陷就是:**模型在对当前位置的信息进行编码时,会过度的将注意力集中于自身的位置,**因此作者提出了通过多头注意力机制来解决这一问题。同时,使用多头注意力机制还能够给予注意力层的输出包含有不同子空间中的编码表示信息,从而增强模型的表达能力。
在说完为什么需要多头注意力机制以及使用多头注意力机制的好处之后,下面我们就来看一看到底什么是多头注意力机制。
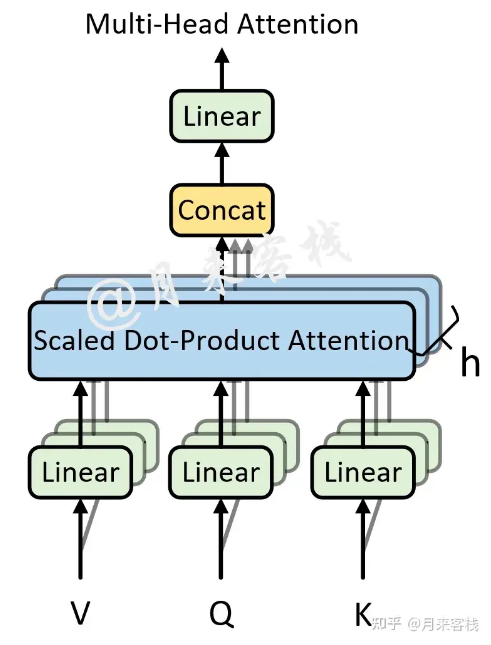
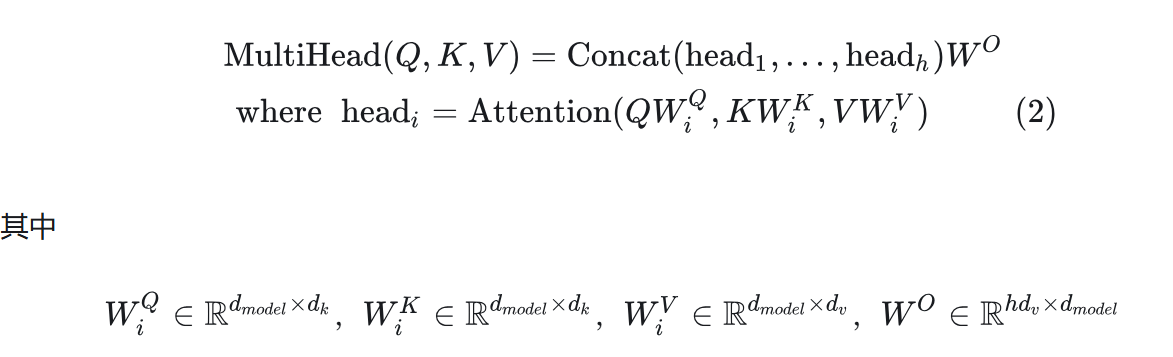
如图7所示,可以看到所谓的多头注意力机制其实就是将原始的输入序列进行多组的自注意力处理过程;然后再将每一组自注意力的结果拼接起来进行一次线性变换得到最终的输出结果。具体的,其计算公式为:
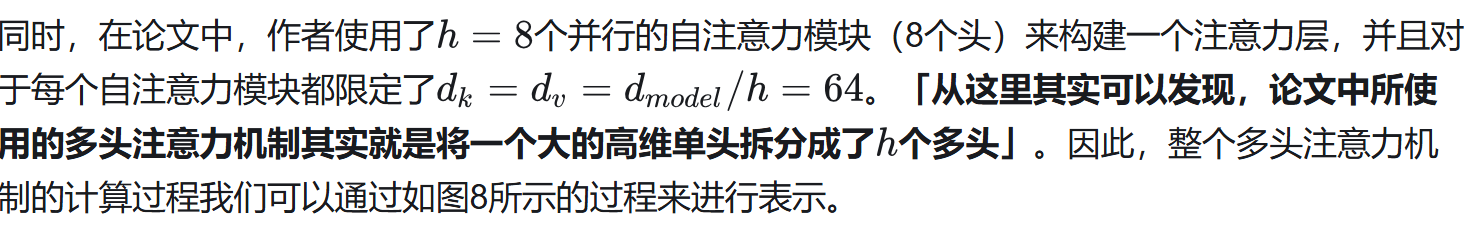
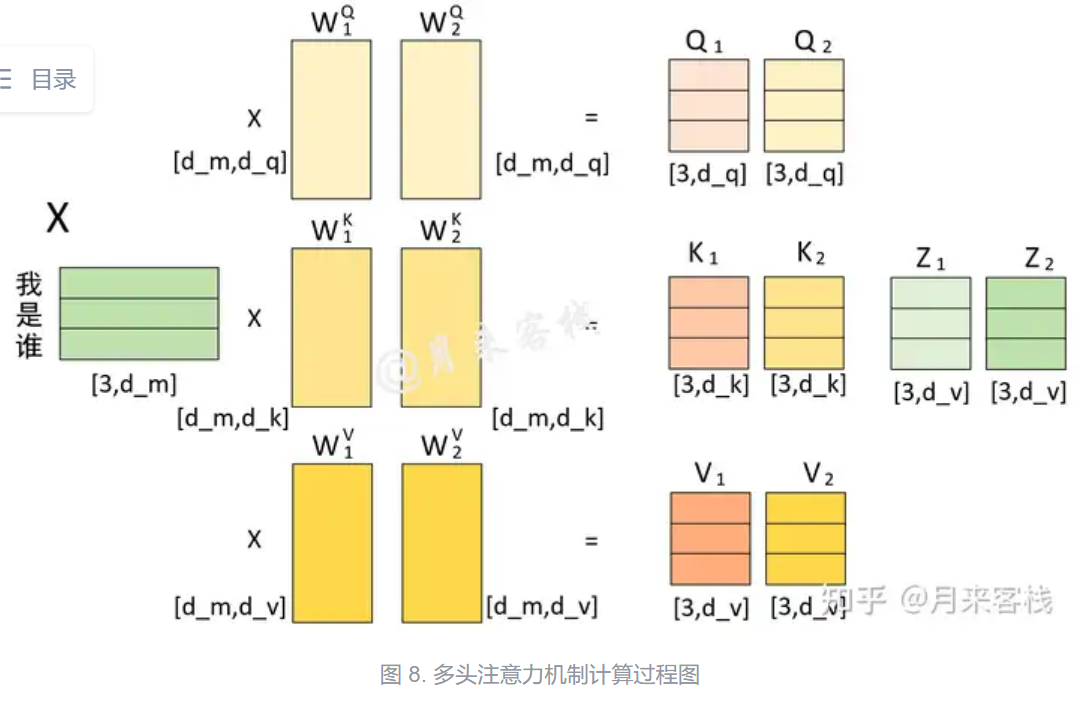
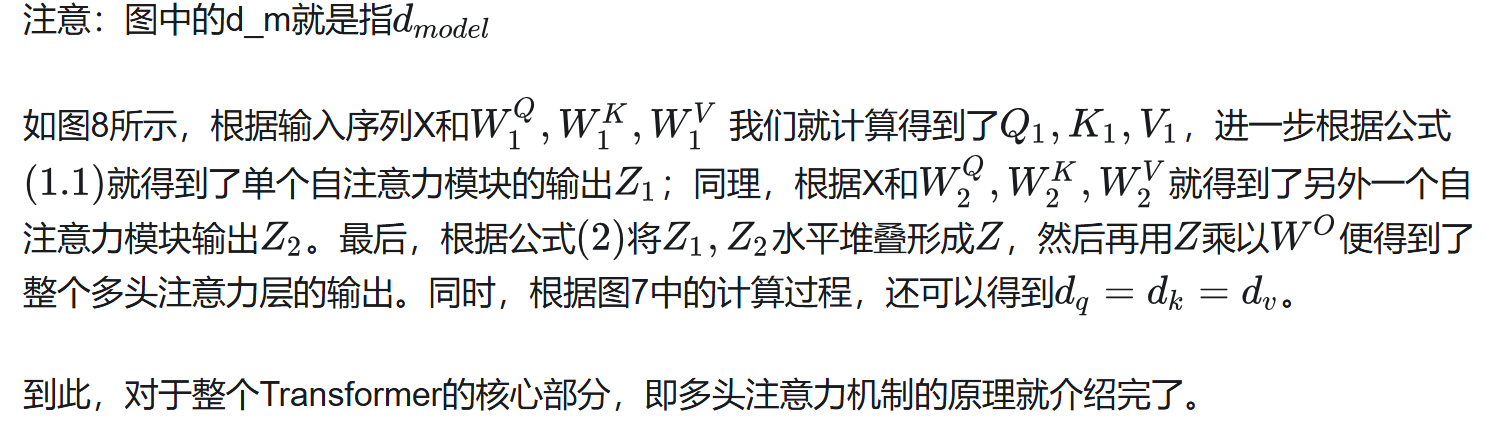
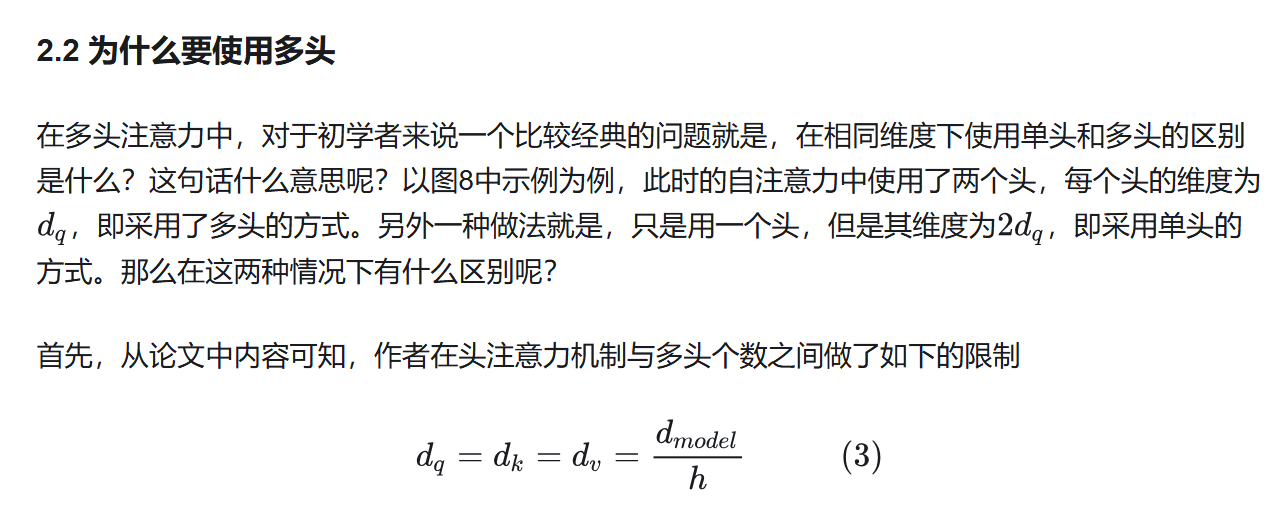
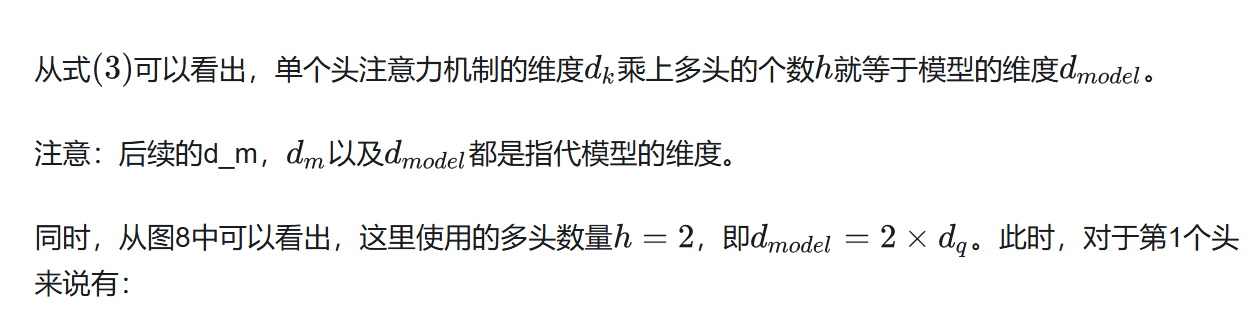
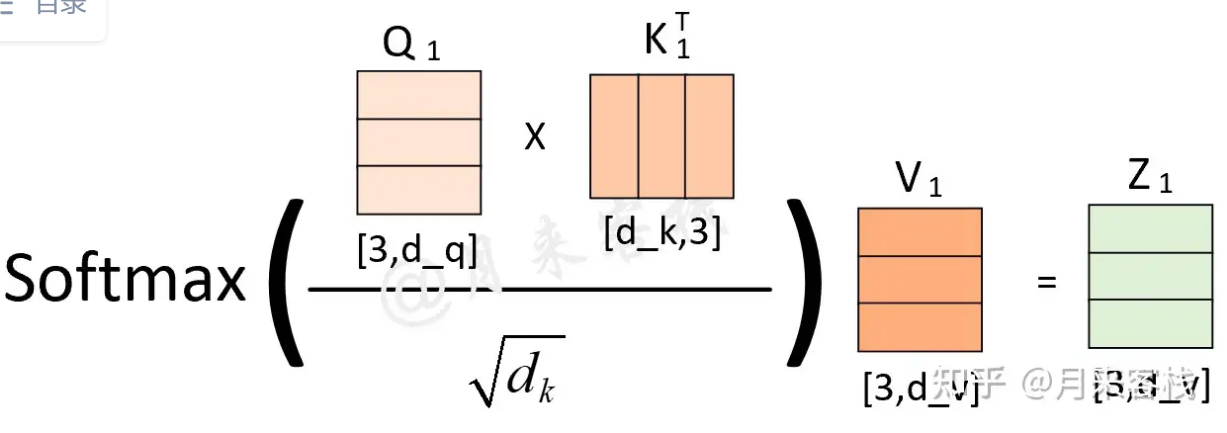 对于第2个头来说有:
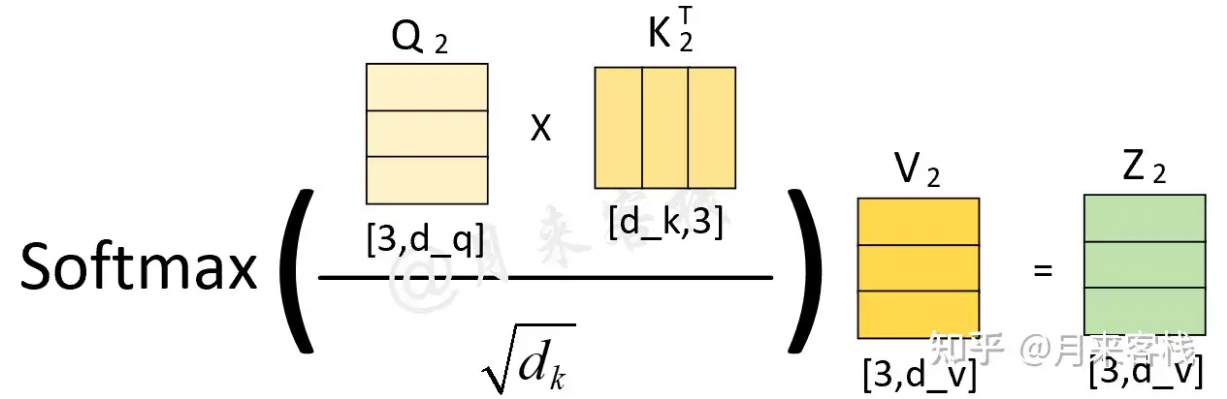
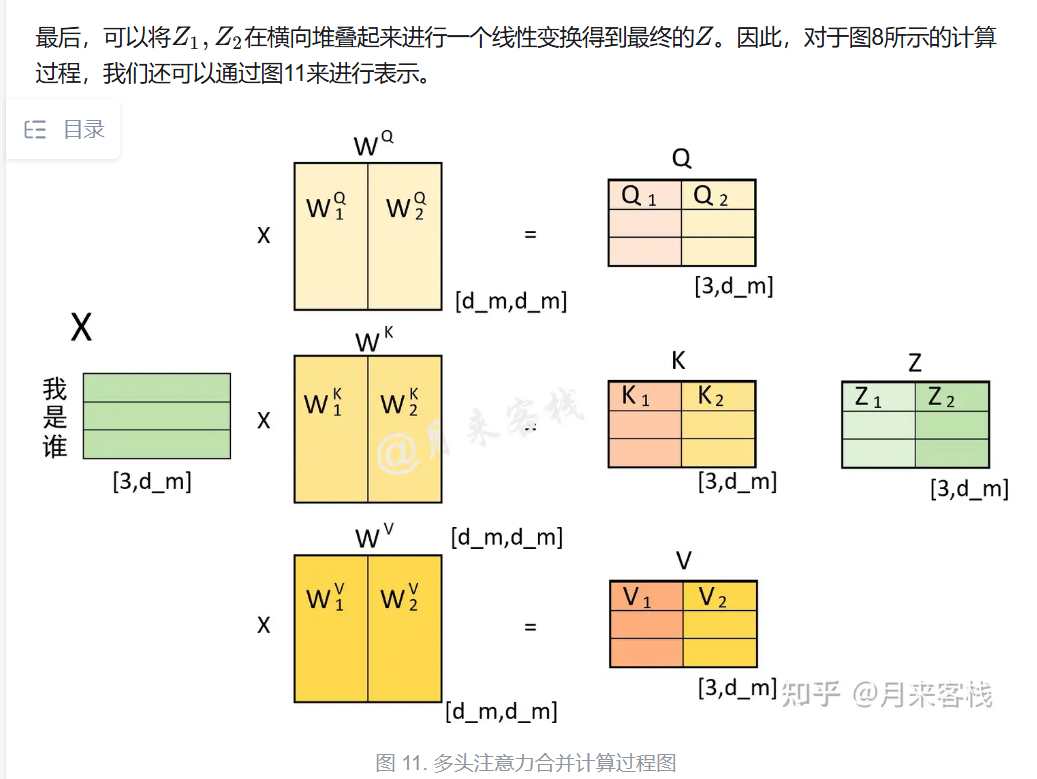
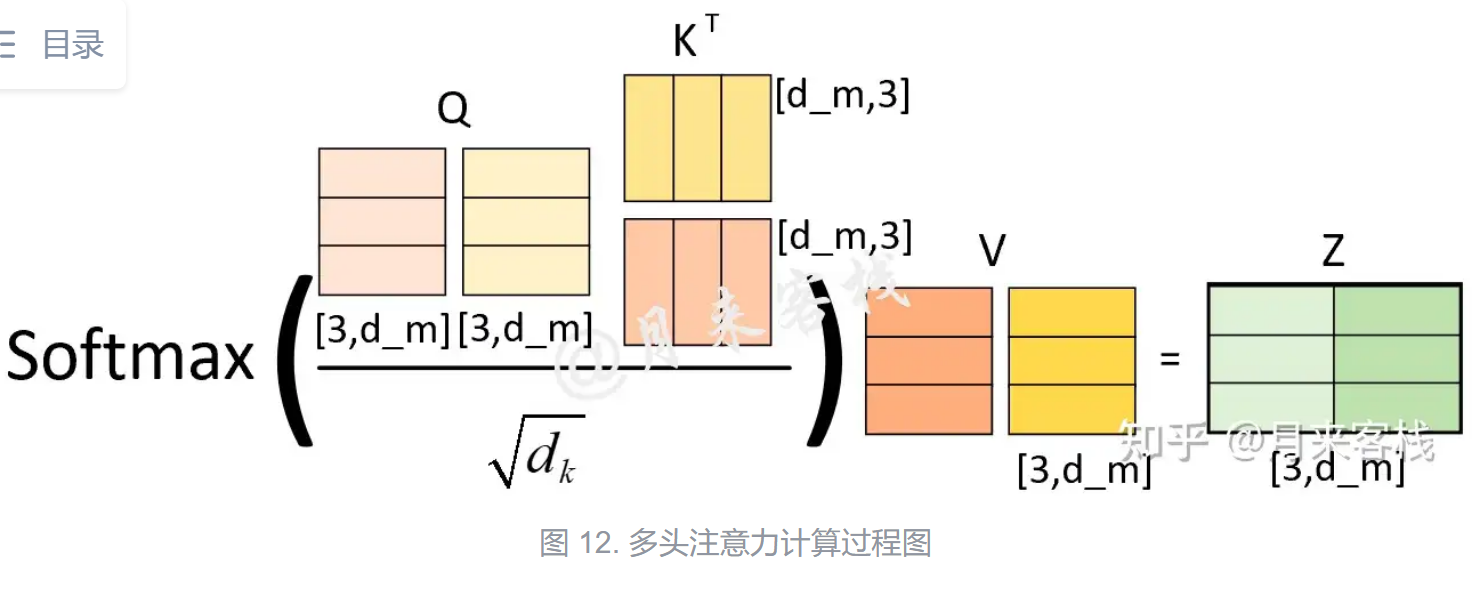
说了这么多,终于把铺垫做完了。此时,假如有如图13所示的头注意力计算过程
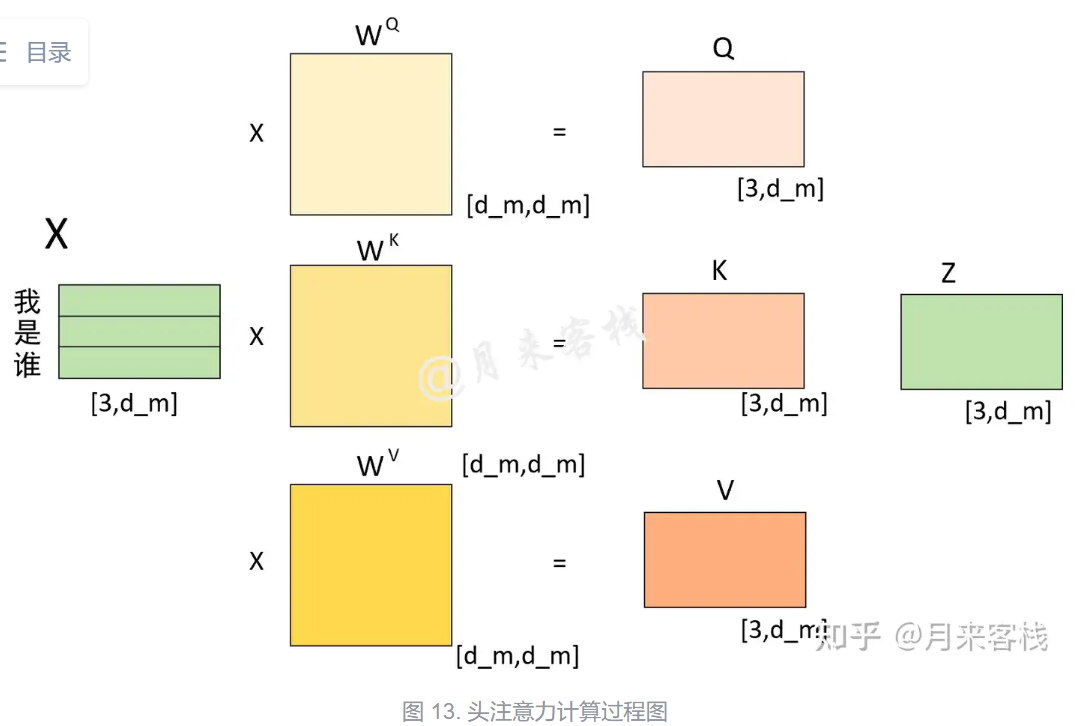
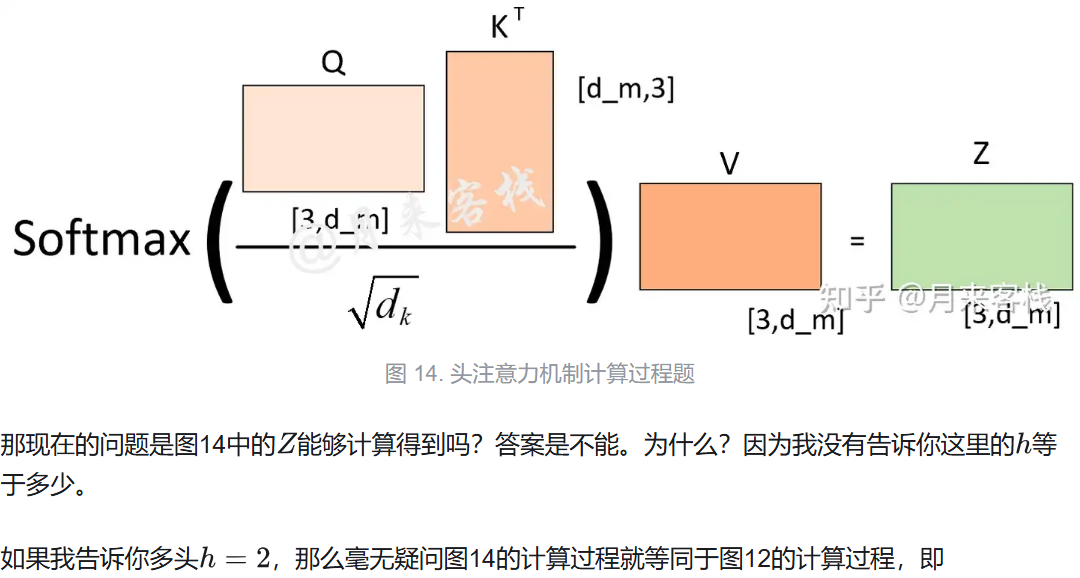
如图13所示,该计算过程采用了头注意力机制来进行计算,且头的计算过程还可通过图14来进行表示。



北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 7
 0
- 0


 已为社区贡献7条内容

所有评论(0)