基于核的目标跟踪综述
基于核的目标跟踪在自动驾驶中的研究综述
1. 引言
驾驶辅助系统和自动驾驶在过去几十年中迅速发展,旨在减少交通事故并提升驾驶舒适性[1]。自动驾驶的最早概念可追溯至通用汽车公司在1939年世界博览会上展示的自动化车辆高速公路系统模型[2]。在20世纪90年代,许多政府支持了自动驾驶项目,例如美国的国家智能公路系统联盟(NAHSC)项目、日本的智能公路系统研究协会(AHSRA)项目、德国的PROMETHEUS项目以及法国的La Route Automatisée(LARA)项目[3]。早期的自动驾驶主要针对低速高速公路场景设计,具备变道、避障和近距离编队行驶等功能[4]。这些应用通常需要基础设施的支持(如磁性标记或专用车道)。随着信息处理系统和传感器技术的快速发展,近年来自动驾驶已扩展到城市交通环境。
自动驾驶将根据对驾驶环境的感知结果自动执行横向或纵向控制。例如,通过转向执行器上的横向控制,车辆可以变道以实现超车或避障;通过制动和油门执行器上的纵向控制,车辆可以实现自动编队行驶。多种传感器已被用于提供用于横向和纵向控制的周围环境信息,例如红外图像传感器、声呐、激光测距仪、雷达等。与这些传感器相比,视觉传感器能够提供更丰富的高分辨率信息,如形状和纹理。
感知模块将利用这些视觉信息来检测、识别和跟踪车道、车辆、行人、交通标志和交通信号灯等感兴趣目标。因此,视觉感知已成为自动驾驶的关键技术[5],[6]。目标检测与跟踪是视觉感知的两个重要组成部分,基于计算机视觉的车辆和行人检测的近期综述可参见文献[7]和[8]。然而,针对自动驾驶的目标跟踪尚未得到足够的关注。
自动驾驶中的一项关键任务是跟踪周围物体,包括环境中遇到的特定移动物体(如附近车辆和行人)或静态物体(如交通标志和交通信号灯)的位置和动态信息。在半自动驾驶中,需要检测并跟踪驾驶员面部以分析疲劳驾驶情况。近年来,计算机视觉领域中的许多跟踪算法已被用于自动驾驶中的目标跟踪,并取得了令人瞩目的成果[9],[10]。本文综述了一些可用于基于视觉的自动驾驶系统的近期跟踪技术,特别是基于核理论的跟踪方法。
目标跟踪是在视频序列中寻找与目标模板最匹配的候选目标的过程。通常,视觉跟踪器包含目标表示、目标定位、滤波和数据关联等组件,这些过程可以结合使用以提高跟踪器的鲁棒性和效率。然而,由于三维世界投影到二维图像所造成的信息丢失,以及图像中的噪声,光照变化、复杂且非刚性的物体运动、物体间及场景与物体间的遮挡,以及实时处理的需求,为目标跟踪[11]带来了巨大挑战。过去几十年中,人们提出了许多跟踪算法,并取得了显著进展。通常,跟踪算法的性能通过鲁棒性、准确性、可靠性、适应性以及实时工作能力的定性比较来评估。在自动驾驶应用的这些跟踪方法中,基于核的目标跟踪因其简洁的描述、非线性表示能力和计算效率而得到认可。
核理论在目标跟踪中的应用可分为两个方面:一方面是作为空间加权强度直方图中目标的描述,结合均值漂移算法进行跟踪,称为基于核的跟踪;另一方面则对应于由某些机器学习算法(如核支持向量机(kernel-SVM)、核 Fisher判别(KFD)分析和核主成分分析(KPCA))引入的高维非线性特征空间中的标量积,被称为基于核的学习。
本文简要回顾了这两个方面的最新进展,本文的方法论见于图1。我们并未试图全面涵盖所有现有文献,而是介绍核理论的一些基本概念,并展示其在目标跟踪中的应用或变体。在每一部分末尾进行了定性评估,并利用公开的车辆和行人测试序列数据库对几种著名的基于核的跟踪器进行了定量比较。文中讨论了这些跟踪器的性能,并突出了它们的优缺点。本文旨在为读者提供自动驾驶中可行的跟踪方法,并提出目标跟踪领域一些有前景的未来研究方向。
本文的结构安排如下:在第2节中,简要介绍了核密度估计和核技巧的一些基本概念。在第3节中,介绍了基于核的目标跟踪,讨论了简单核和多核方法,并给出了定性比较。在第4节中,总结了用于跟踪的基于核的学习算法。我们还介绍了核支持向量机、核费舍尔判别和核主成分分析的基本思想,并分析了这些算法中应用的核技巧。对五种跟踪方法的定量比较在七段视频序列上的实验结果在第5节中给出并进行了讨论。结论以及对未来研究方向的展望在第6节中呈现。
2. 核描述
本节简要介绍核密度估计和核技巧的一些基本概念,这将有助于读者理解后续章节中将要提到的算法。
2.1 核密度估计
核密度估计(KDE)或帕曾估计是一种非参数密度估计方法。给定N个从D维空间RD中未知概率密度p(X)抽取的观测值{Xi}i=1,…,n。在点X处的密度可按参考文献[12]估计为:
$$ p(X)= \frac{1}{N \cdot h^D} \sum_{n=1}^{N} K\left(\frac{X - X_i}{h}\right) $$
其中K(·)是具有如下定义的核函数:
$$ K(u)= \begin{cases}
1 & |u_i| < \frac{1}{2}, i= 1,…, D \
0 & \text{else}
\end{cases} $$
根据(2)的定义,当观测值Xi位于以X为中心、边长为h的立方体内时,$K\left(\frac{X-X_i}{h}\right)$为1,否则为0;$\sum_{n=1}^{N} K\left(\frac{X-X_i}{h}\right)$是位于X附近区域内的观测值总数。如果h足够小,则与X相邻区域相关的概率可计算为$P= \frac{1}{N}\sum_{n=1}^{N} K\left(\frac{X-X_i}{h}\right)$。此外,如果在此区域内p(X)近似为常数,则有$p(X) = P/h^D$,其中$h^D$是D维空间中边长为h的超立方体的体积,如(1)所解释。
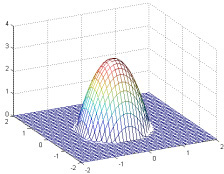
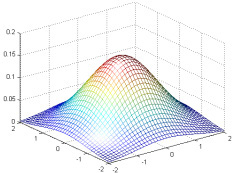
公式(2)被称为均匀核或帕尔曾窗,h是核的带宽。核K的轮廓定义为函数[0,∞) → R,使得$K(X) = k(|X|^2)$,其他常用的核及其轮廓见表1,所有这些核都应满足以下条件[13]:
$$
\int_{R^D} K(X)dX= 1 \quad \lim_{|X|\to \infty} |X|^DK(X)= 0 \
\int_{R^D} XK(X)dX= 0 \quad \int_{R^D} XX^T K(X)dX= C_K I
$$
2.2 核技巧
核概念最早由Aizerman等人[14]提出,但直到Boster等人[15]在支持向量机中重新引入后才引起广泛关注。核函数被定义为在某个高维特征空间中的标量或内积的表示:
$$ k(X, X’)= \phi(X)^T \cdot \phi(X’) $$
其中 $\phi(X)$ 是一个非线性特征空间映射。事实上,第2.1节中给出的核函数是该定义的一种特例,因为 $|X|^2= X^T \cdot X$ 仍然是一个标量积。如果某个算法的表达形式使得输入向量 X仅以标量积的形式出现,则我们可以用合适的核函数来替换该标量积,这种核替换被称为核技巧。
有效核函数被定义为 $\phi(X)^T \cdot \phi(X)$,如果已知特征映射,则可以找到相应的核函数。然而,在大多数情况下,$\phi(X)$ 并未明确给出。Shawe-Taylor 和 Cristianini[16]给出了 $k(X,X’)$ 成为有效核函数的充分必要条件,即格拉姆矩阵K(其元素由$K_{nm} = k(X_n,X_m)$给出)对于集合{Xn}的所有可能选择都应是半正定的。
表2 列出了一些广泛使用的核,并参见[12]和[17]以获取详细描述。
3. 基于核的跟踪
模板匹配是视频序列中目标跟踪的常用方法。通常使用图像强度、颜色特征或图像梯度来构建模板,然后利用相似性度量通过匹配模板和候选区域来计算目标的位置。然而,模板匹配是一种暴力搜索方法,导致计算成本较高。通过将候选区域的位置限制在前一帧目标邻近区域,可以降低计算成本[21]。基于核的目标跟踪(KBOT)正是此类策略的一种。该方法最初由Comaniciu 等人提出[22],随后许多研究人员的工作主要集中在以下几个问题上:
- 如何估计目标的尺度和方向变化?
- 哪种核轮廓适合用于跟踪?
- 如何调整核带宽?
- 目标跟踪中使用多少个核是合适的?
前三个问题应在单核和多核跟踪中均得到解决,因此我们将KBOT中的本节分为单核跟踪和多核跟踪。
3.1 单核跟踪
在大多数常见情况下,一个核函数足以表示目标的加权直方图。这种表示方法简单且需要的计算较少。首先介绍基于核的均值漂移,然后讨论核粒子滤波器。
3.1.1 基于核的均值漂移
均值漂移算法是一种基于核密度估计的非参数方法,用于模式搜索[23]。通常,在均值漂移跟踪中,目标由圆形区域表示,并使用颜色直方图作为特征。然而,这种表示仅包含目标的强度信息,在实际应用中并不足够。
Comaniciu 等人[22]采用各向同性核对基于直方图的目标特征表示进行正则化,同时考虑了目标区域的强度值和空间位置的描述。目标模型在其特征空间中的概率密度函数表示为pdf ,即$qu = C \cdot \sum_{i=1}^{n} k(|X^ _i|^2) \cdot \delta[b(X^ i) - u]$,其中$k(·)$ 是第2.1节中定义的核函数,${X^*_i} {i=1,…,n}$ 表示定义为目标模型区域内的归一化像素位置,$\delta$ 是克罗内克δ函数,$u = 1..m$ 为直方图区间。
C 是归一化常数,使得 $\sum_{u=1}^{m} qu= 1$,函数 $b: R^2 \to {1,.., m}$ 将位于 $X^ _i$ 的像素与其在量化特征空间中的直方图索引 $b(X^ i)$ 相关联。以 $y$ 为中心的目标候选区域 ${X_i} {i=1,…, nh}$ 也可以类似地表示为 $pu(y)= C_h \cdot \sum_{i=1}^{nh} k(|\frac{y-X_i}{h}|^2) \cdot \delta[b(X_i) - u]$。采用巴塔查里亚系数作为相似性度量,然后执行均值漂移以获得目标位置。此处使用的核轮廓为伊坂尼科夫核,其作为特征直方图的权重。伊坂尼科夫核是一种凸且单调递减的核函数,为目标中心较远的像素分配较小的权重。该核的应用提高了密度估计的鲁棒性,因为外围像素最不可靠,常常受到遮挡(杂波)或背景干扰的影响。这种基于核函数的跟踪方法称为 KBOT。
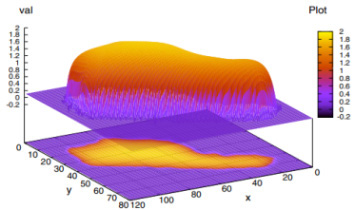
在KBOT中,核轮廓的带宽对应于目标的搜索区域,当目标尺度变化时,应自动调整该带宽。许多算法被提出以适应目标的尺度和方向变化。文献[24]中采用对象仿射模型来描述缩放问题,并利用两帧之间的对象角点对应关系来估计该模型的参数。通过反向跟踪连续帧中对象质心的配准,可估计仿射模型中的缩放幅度。然而,该方法需要更多的内存空间和较高的计算成本。Parameswaran等人[25]使用可调核来跟踪行走的人,其中目标被划分为多个块,每个块对应一个具有不同带宽的核。但这些带宽是在动作捕捉的样本图像训练中预先设定的,且未考虑最优带宽参数对人物姿态的依赖性。一种非对称目标核被提出用于跟踪具有尺度和方向变化的目标[26],[27],[28],[29]。该非对称核表示目标的形状(如图2所示),从而减少由核内非目标区域引起的估计偏差。Leichter等人[30]提出了仿射核变换,该跟踪器将目标边界线索引入跟踪过程,当目标尺度变化时,核被进行仿射变换。
此外,李等人[31]应用基本集分析来估计目标的尺度。张等人[32]使用Canny边缘检测来确定目标的变化趋势。一些可变形轮廓跟踪方法[33],[34]被用来处理尺度变化问题。这些尺度自适应算法大多依赖于目标的角点、边缘或轮廓等附加信息,而这些附加信息对光照变化和非刚性形变不够稳定。此外,仿射模型或变换无法处理平面外运动。
遮挡是KBOT中的另一个棘手问题,已有基于片段或局部信息的方法被提出以应对该问题[35],[36],[37],[38]。在此方法中,目标被划分为多个片段,每个目标和候选块的颜色直方图表示为 ${q(k)} {k=1,..,K}$ 和 ${p(k)(y)} {k=1,..,K}$,其中K为片段数量。然后使用KBOT计算每个片段的新候选位置 ${\hat{y}(k)} {k=1,..,K}$。新的目标位置$\hat{y}$通过这K个候选位置的加权和计算得到,公式为$\hat{y} = \sum {k=1}^{K} \lambda_k \cdot \hat{y}(k)$,其中 $\lambda_k$是第k个片段的权重,由目标与背景分布的比例确定。然而,该方法未考虑这些片段之间的关系,不适用于非刚性目标跟踪。局部信息与全局信息之间的关系也应被考虑,每个片段的局部位置可能受部分遮挡影响而偏离真实位置,如何检测这种偏移并利用合适的局部信息获取全局位置仍是一个开放问题。
KBOT的另一个局限性是无法跟踪快速移动的目标。阿里等人[39]计算了图像的高斯金字塔,并首先将KBOT应用于最粗糙的图像层级l,然后将该层级l的估计位置作为初始估计传递到下一个更高分辨率的层级(l −1),并从层级(l − 1)到(l − 2)重复此过程,直到达到最高分辨率的图像层级。该方法能够轻松跟踪相对于其尺寸具有较大运动的快速移动目标。然而,不同金字塔层级中的核带宽保持恒定。在最粗糙的图像中,核包含了大量非目标区域,这会偏移运动估计,导致丢失被跟踪的目标。沈等人[40]提出了一种新颖的多带宽均值漂移方法,该方法将模拟退火算法与基于核的均值漂移跟踪过程相结合,称为退火均值漂移。该方法中的带宽起到类似于传统退火中温度的作用。所提出的算法即使在从较远位置初始化的情况下,也能显著提高找到真实目标位置的可能性。通过增加KBOT的搜索带宽可以解决快速移动目标的跟踪问题,这可以通过使用金字塔或多带宽搜索策略来实现。然而,随着带宽的增加,更多的背景信息被包含进来,这会使算法变得不稳定,特别是当背景具有与目标相似的特征或背景中存在其他相似对象时。
在过去的几十年中,人们提出了更灵活的KBOT算法。Tyagi 等人[41]通过融合多个已校准相机的证据实现目标跟踪。该算法采用特征级融合框架,直接在三维空间中对目标进行跟踪,并可通过基于前景目标三维点云聚类的自动重新初始化技术启动。该跟踪器工作在三维空间中,由于物体的实际尺寸不随时间变化,因此核函数的带宽在跟踪过程中保持恒定。伯奇菲尔德和兰加拉詹[42]在基于核的跟踪器中提出了空间图特征。空间图与其特征的直方图相同,但为每个直方图区间增加了额外的空间均值和协方差。空间图能够更丰富地描述目标,从而提高跟踪的鲁棒性。普拉德扎德等人[43]将均值漂移方法与基于LBP的跟踪算法结合,以获得更精确的结果。居等人[44]提出了一种由自构建模糊聚类生成的模糊颜色直方图,以减少光照变化对均值漂移跟踪算法的影响。马济南和阿米尔-拉提菲[45]利用二值掩膜提取运动信息,并通过将该掩膜相乘得到新的核函数。该核函数能够克服杂波干扰,实现对与背景颜色相似的目标的跟踪。刘[46]构造了包含 Gabor和熵特征的多特征伪彩色图像 (MFPCIs),并直接使用KBOT在红外图像中实现跟踪。王等人[47]将形状信息融入基于核的跟踪器的外观模型中。此外,在核跟踪中还采用了一些其他相似性度量准则;杨等人[48]在聚类分析中采用平均分离准则来度量相似性,莱希特[49]在均值漂移跟踪中使用跨区间度量。敏武等人[50]结合均值漂移与置信传播(BP)方法实现多目标跟踪,而自适应分箱颜色模型被应用于文献[51]中的均值漂移跟踪。
KBOT 是一种简单且有效的目标跟踪算法,因其低计算复杂度以及对刚性和非刚性目标的跟踪鲁棒性而著称。因此,它可用于自动驾驶以满足实时处理需求。然而,在复杂环境中,由于目标表示较为简单,该方法的鲁棒性可能降低。在实时视频序列中采用此算法时,需加以注意。在大多数情况下,KBOT 是一种基于颜色特征的跟踪方法。为了应对复杂环境,例如背景与目标颜色相似、突然的光照变化和遮挡等情况,应将其与其他特征相结合。
- 目标表示加权直方图应根据跟踪结果自动更新,特别是对于非刚性目标跟踪。
- 在目标跟踪中应用多个模板图像是必要的。
还应注意,合适的跟踪方法应考虑目标跟踪及其周围环境的特性。
3.1.2 核粒子滤波
粒子滤波(PF)已广泛用于处理多模态视觉跟踪问题中的非线性和非高斯系统,它是一种基于蒙特卡洛采样的递归贝叶斯滤波的假设跟踪器。然而,粒子滤波通常要求大量粒子用于估计状态变量的后验概率密度函数,导致计算成本高昂,从而限制了其在实时跟踪中的应用。
核粒子滤波器(KPF)由张等人提出[52],[53]以解决此问题,KPF在传统粒子滤波器框架中引入了核密度估计和均值漂移,以减少跟踪所需的粒子数量。给定时间t的粒子及其对应的权重,KPF可概括如下:
- 核密度估计用于估计后验密度$\hat{p}(x_t |Y_t)$,其中,$x_t$是目标状态,$Y_t$是时间t的观测。
- 均值漂移被用于沿梯度方向移动粒子,使其趋近于后验估计的模态,然后对新粒子重新赋权。
后验密度 $p(x_t |Y_t)$ 基于这些新粒子和权重进行计算。
近年来,已提出了一些应用和改进。施密特等人[54]提出了用于从非标定相机获取的视频流中进行三维人体跟踪的核粒子滤波(KPF)。张和黄[55]将核粒子滤波(KPF)应用于基于无线局域网(WLAN)的室内平面图上的人体位置跟踪。谢等人[56]采用核粒子滤波(KPF)和边缘方向直方图(EOH)来跟踪颜色特征与背景相似的目标。姚等人[57]指出,并非核粒子滤波(KPF)中的所有粒子都适合用于均值漂移算法以优化其位置,因此提出了增量巴塔恰里亚距离(IBD)和矩阵条件数来确定适合执行均值漂移的粒子。
在核粒子滤波器中,均值漂移被用于将权重可忽略的粒子沿梯度上升方向移动,使这些粒子收敛到邻近的局部极大值。这些新粒子具有较高的似然性,并且在重采样后大部分得以保留,从而减少了跟踪所需的粒子数量,同时也解决了常规粒子滤波器中的贫化问题。然而,核粒子滤波器引入的另一个问题是次优解;经过均值漂移过程后,粒子多样性降低,可能导致收敛到局部最优。众所周知,粒子滤波器是贝叶斯框架的数值实现,因此这种基于核的均值漂移也可以直接应用于贝叶斯框架中以修改模型[58],[59],[60]。
3.2 多核跟踪
随着KBOT在视觉跟踪中的应用日益广泛,发现单个核函数在复杂运动的目标或复杂环境下进行跟踪时,表现不如预期。格雷戈里等人指出[61]:无论结构如何,单个核函数最终受限于两个因素:
- 直方图的维度(这可能取决于可用的图像结构)。
- 其导数结构与图像的空间结构之间的相互作用,正如直方图所揭示的那样。
因此,提出了多核跟踪(MKT)以提升KBOT的有效性。多个核可以具有不同特征或位置的属性。柯林斯[62]采用了空间核和尺度核来处理为均值移动晶状跟踪选择核尺度的问题。张等人[63]采用双核进行视觉跟踪,一个用于候选区域与目标模型之间的相似性,另一个用于候选区域与其周围背景之间的对比度,该双核分别通过巴塔恰里亚系数和桑森-尔文散度进行度量。
MKT框架由哈格提出[61],在该框架中,采用平方差之和(SSD)作为相似性度量,而非巴塔查里亚系数,并推导出牛顿型迭代法以求解优化过程。目标区域的位移通过在目标不同位置放置的多个核获得。目标区域与候选区域 q和p(c)的表征直方图通过直方图拼接方法获得。这种多核 SSD跟踪在跟踪性能上表现良好,并且用较少迭代次数收敛。跟踪过程中所使用的核彼此相互独立,因此该方法也被称为多独立核跟踪 (MIKT)。使用独立核的一个优点是,一个核的错误估计可能不会影响其他核的正确估计。然而,一旦某个核经历了一次坏的迭代,跟踪器便无法恢复。
多协作核跟踪 (MCKT) 由范等人提出[64],该方法考虑了核之间的约束,并将核跟踪问题视为具有$\sqrt{\Omega} q - \sqrt{p(y)}= M \cdot y(y+y)= 0$的线性系统,其中,y是核中心向量,M是测量矩阵,$\Omega$是核之间的约束矩阵。通过利用多个核之间的内在关系,不仅提高了“核可观测性”,而且自然扩展了KBOT的适用性,以应对连接式目标和复杂运动。然而,此处考虑的约束为几何约束,虽可恢复平面内旋转和平移,但在视角和尺度变化下无效。因此,提出了交叉比不变约束[65]。
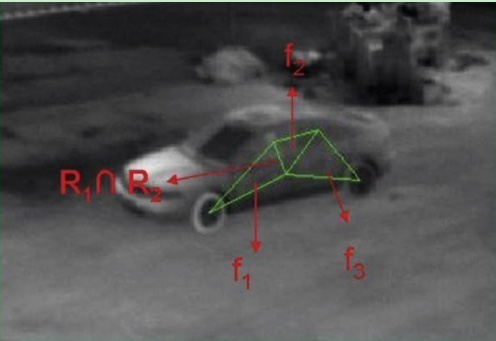
基于MIKT和MCKT,马蒂尔沃和绿菲喀[66]提出了分段侯变核跟踪 (PAKT),用于跟踪非平面目标。该方法中,由每三个核的中心描述的三角网格被考虑在内。对每个网格三角形估计其侯变变换,并需满足约束条件:每个三角形的侯变变换必须与其相邻三角形的侯变变换相兼容,这些约束在图3中进行了说明。该方法能够跟踪具有出平面运动的刚性目标以及可变形目标。然而,它无法实时运行。
通常,多核跟踪(MKT)方法将跟踪区域划分为多个部分,每个部分使用一个单核进行跟踪。直观来看,并非所有核都会受到复杂杂波、部分遮挡或光照变化的影响,因此多核跟踪(MKT)的性能优于单核跟踪。在自动驾驶中应用时,由于核之间具有稳定的空间关系,使得跟踪结果更具鲁棒性,因此多核跟踪(MKT)更适合于跟踪刚性物体(如车辆、交通标志和灯光)。然而,在跟踪非刚性目标(如行人或驾驶员面部)时,核之间的约束将变得更加复杂。
 原始图像,(b) 由目标形状生成的核,(c) 从(b)生成的梯度核,(来自参考文献[28]的图))
 =f 2(R1 ∩R2))。目标将是找到这些变换 fi,并满足在交集上给出的约束条件(引自参考文献 [66] 的图))
4. 基于核的学习
核学习机已广泛应用于机器学习和模式识别[69],[70],[71],[72],已被证明相比早期的机器学习方法(如神经网络),核学习机具有更强的数学倾向,并且也引起了统计学和数学界的广泛关注[17]。同时,这些核学习机在目标跟踪中变得尤为流行;尤其是在复杂环境中,基于核的学习方法仍面临性能挑战。根据核方法的学习机制,本节分为两部分:检测式跟踪和增量核子空间学习。为了使读者理解这些学习算法中所采用的核技巧,有必要对支持向量机(SVM)进行一些详细描述。
4.1 检测式跟踪
检测式跟踪将跟踪问题视为一个分类任务,通过应用离线或在线学习分类器来区分跟踪目标与背景。支持向量机(SVM)和核Fisher判别(KFD)是这类分类算法,它们不仅在分类与回归问题中表现出实际意义,而且在有监督与无监督学习中也具有应用价值[73]。
4.1.1 支持向量机
对于二类线性分类器 fi 在监督学习的分类问题中,训练数据集包含N个输入向量X1,…,XN,分别对应目标值y1,…,yN,其中yN ∈{−1, 1}。如果这些训练样本可以通过一个超平面分离,则线性分类模型具有如下形式的决策函数
$$ y(X)= w^T \cdot X+ b $$
其中 w 是超平面的法向量,b是偏移量。
公式 (5) 满足 fi es y(Xn) > 0,适用于标签为 yn= 1 的训练样本,以及 y(Xn) < 0,适用于 yn= −1。决策边界定义为 {X | w^T \cdot X+ b= 0}。然而,存在许多满足上述条件的 w 和 b 解。支持向量机(SVM)引入了边界间隔的概念,以确定具有最大边界间隔的最优超平面。边界间隔被定义为决策边界与任意样本之间的最小距离。如果对 w 和 b 进行重新缩放,使得所有训练样本满足 yn ·(w^T \cdot X+b) ≥ 1,则边界间隔可度量为 2/‖w‖,这等价于最小化 ‖w‖²。那些满足 yn ·(w^T \cdot X+ b) = 1 的训练样本被称为支持向量 (SVs)。通过这种方式,该分类问题转化为如下定义的二次规划问题:
$$
\min_{w,b} \frac{1}{2}|w|^2 \
\text{Subject to } y_t \cdot(w^T \cdot X_t+ b) \ge 1 \text{ for } t= 1,…, N
$$
这个约束优化问题可以通过引入拉格朗日乘子转换为对偶表示
$$
\min_{\alpha} \sum_{i=1}^{N} \alpha_i - \frac{1}{2} \sum_{i=1}^{N} \sum_{j=1}^{N} \alpha_i\alpha_j y_iy_j( X_i \cdot X_j) \
\text{Subject to } \alpha_i \ge 0 \quad i= 1,…, N \
\sum_{i=1}^{N} \alpha_iy_i= 0
$$
其中 α=(αi, . . . , αN)^T是拉格朗日乘子。通过求解上述方程,可得到系数 α,公式(5)中的决策函数可表示为
$$ y(X)= \text{sgn} \left( \sum_{i=1}^{N} y_i \alpha_i( X_i \cdot X)+ b \right) $$
然而,在大多数应用中,线性可分离是一个相当严格的条件(如图4 (a)所示,不存在能够分离这两类的线性超平面)。在这种情况下,采用非线性特征空间映射函数 ∅(X)将训练数据映射到一个可能高得多的特征空间(如图4 (b)所示)。在这个高维特征空间中,映射后的训练数据线性可分离。注意,分类器中的计算过程仅以如下形式出现标量积,核技巧可以被使用,公式 (7) 变为∑Ni=1 αi − 1/2 ∑Ni=1∑Nj=1 αiαjyiyj · k(Xi ·Xj)。通过赋予核函数 k(Xi,Xj)特定的形式,∅(Xi)^T · ∅(Xj) 可以直接计算,避免了特征映射函数 ∅(X) 的明确引入,从而允许以隐式方法使用高维甚至无穷维的特征空间。这种基于核技巧的非线性分类问题被称为核支持向量机 (kernel SVM)。
将支持向量机(SVM)应用于跟踪的研究见于参考文献[75],其中SVM与基于光流的跟踪器相结合,称为支持向量跟踪(SVT)。SVT的过程可概括如下:SVM分类器可在当前帧中检测可能的候选区域,并将其传递给SVT。SVT可进一步优化这些候选区域的位置,以达到支持向量机得分的局部最大值。如果得分为正,则该候选区域被判定为跟踪目标,并启动基于光流的跟踪器。当前帧中的优化位置可作为下一帧的初始估计,依此类推。SVT结合了基于光流跟踪的计算效率和通用分类器SVM的强大能力,从而增强了跟踪器和分类器各自的性能。然而,该方法无法处理部分遮挡、短暂消失和重新出现的情况。此外,在参考文献[75]中分类器与跟踪器是独立工作的,而沈等人[76]使其成为一种协作工作。沈等人通过最大化由SVM定义的复杂代价函数,推广了标准的基于核的均值漂移跟踪器。在SVM中使用概率积核(PPK)构建决策函数,并通过最大化该代价函数来确定下一帧中的最优位置。在此框架中考虑了多个模板,并通过SVM实现模板更新。陈等人[77]提出了一种描述-判别协同的目标跟踪方法,其中支持向量数据描述(SVDD)作为描述组件用于描述目标的全局属性,结构化输出支持向量机(SSVM)则作为判别协同组件用于区分跟踪目标与背景。参考文献[78]中提出了一种自步学习算法以实现长期跟踪,其中基于外观的模板由SVM进行学习和更新。
在大多数检测式跟踪方法中,分类器更新需要将估计的目标位置转换为一组带标签的训练样本。然而,如何最好地执行这一中间步骤尚不明确。Hare等人[79]扩展了在线结构化输出支持向量机学习方法[80],[81]以解决此问题。该结构化输出预测可直接预测帧间目标位置的变化,避免了中间分类步骤,从而减少了采样和标注过程中的误差。同时采用预算机制以防止支持向量数量的无界增长。此外,还提出了一种用于跟踪的半监督支持向量机[82]。
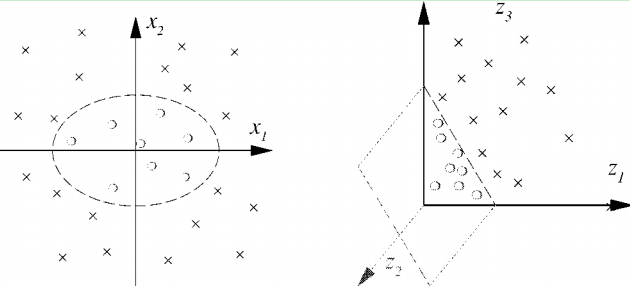 在输入空间中,该构造对应于一个非线性槽球决策边界。(b) 通过映射到三维特征空间中的(x1, x2) →(z1,z2,z3)= (x1², √2 x1x2, x2²),存在一个线性超平面可以分离这些特征(引自文献 [74]))
4.1.2 核Fisher判别
Fisher线性判别(FLD)是一种线性分类器,将分类问题视为一个降维问题。对于第4.1.1节中的二类分类问题,Fisher通过y = w^T ·X将高维训练样本X映射到一维,因此对于新到达的样本Xt 如果yt大于指定阈值时,yt= 1,否则yt= −1。FLD通过使投影后类别均值之间具有较大间隔,同时使每个类内的方差较小,从而减小类间重叠。因此,瑞利系数定义为系数定义为 J(w)= w^T SBw / w^T SWw,其中 SB为类间协方差矩阵;SW为类内协方差矩阵。与第4.1.1节类似,核方法也可应用于FLD,通过非线性映射 ∅(X)来处理非线性分类问题。这种基于核的FLD被称为核Fisher判别(KFD),详细描述见参考文献[83],[84]和[85]。
增量KFD也被改进以解决目标跟踪中的在线更新问题。Lin等人[86]将目标/背景问题建模为一个多类问题。目标类的样本分布由单个高斯模型表示,而非目标的背景类则由高斯混合模型表示。每帧都应用FLD来解决该分类问题,并使用顺序Karhunen-Loeve算法(SKL)基于先前结果增量更新FLD。沈等人[87]提出了一种计算高效的非线性核学习策略,以找到能够区分被跟踪目标与背景的判别模型。该判别模型在KFD模型中构建,而QR分解使得能够在实时条件下更新最优非线性子空间。
检测式跟踪方法的目的是训练一个分类器,以区分目标与其周围的背景。FLD和SVM是模式识别与机器学习中常用的两种典型线性分类器。通过应用核技巧,核分类器(核费舍尔判别和基于核的SVM)能够通过将训练数据映射到线性可分离的高维特征空间来处理非线性分类问题。通过指定特定形式的核函数,可以避免在高维(甚至无限维)特征空间中的直接计算。然而,该方法需要大量正负样本用于分类器训练,并且在没有关于目标区域和尺度的先验信息的情况下,在图像中检测目标将耗费较多时间。因此,在自动驾驶中,这种检测式跟踪方法必须与一些跟踪算法(如基于光流的跟踪器[75]或基于核的均值漂移[76])相结合,以满足实时处理条件。此外,在实际应用中,选择合适的训练数据集对分类器学习的重要性往往超过选择学习算法本身。一般来说,SVM的表现优于KFD。然而,Chakrabarti等人[88]和Cooke [89]已证明SVM与FLD在支持向量分类上的等价性。通常,检测式跟踪方法包含两个必要部分:a)样本的生成与标注;b)分类器的更新。这种增量学习方法确保了目标模板的更新,适用于因光照不稳定和姿态变化导致外观变化的可变形目标的跟踪。需要注意的是,提升方法(boosting[90])是另一种广泛使用的分类方法,此处未详细讨论。提升方法与核方法之间的联系可参见文献[73]。文献[79]指出,SVM在更多情况下取得了成功由于其良好的泛化能力、对标签噪声的鲁棒性以及通过应用核实现目标表示的灵活性,该方法比基于提升的分类器更具优势。
4.2 核子空间学习
由于子空间特征能够在低维空间中表示跟踪目标的外观,因此多年来已被广泛应用于目标跟踪[89],[90],[91],[92],[93]。为了满足在线和实时应用的需求,近年来提出了增量式子空间学习方法[94]。在大多数这类子空间方法中,主成分分析(PCA)是主要的降维数据特征提取算法。本质上,PCA是一种线性子空间方法,只能进行线性子空间特征提取,因此不适用于高度复杂且非线性的数据分布。相比之下,核子空间提取方法在非线性特征提取应用中展现出其优势,例如人脸识别[95]、单帧超分辨率[96]、图像去噪[97]、多视角特征描述符获取[98]以及目标跟踪[99]。
核主成分分析(KPCA)[100]是核子空间提取的主要过程,它应用非线性映射函数 ∅(X)来构建高维特征空间(希尔伯特空间),以进行线性特征提取。KPCA中需要进行特征分解的协方差矩阵为C=1/N∑Ni=1 ∅(Xi)∅(Xi)^T,通过核技巧可以隐式地计算该矩阵。Chin 和 Suter[99]指出,在KPCA的运行时应用中存在较高的存储资源和计算负载成本,因此提出了增量式KPCA,以在目标外观及周围光照变化的情况下保持恒定的更新速度和内存使用。通常,KPCA要求使用正定核(例如多项式核或高斯径向基函数)。Liwicki 等人[101]提出了一种用于在线学习的一类不定核(非正定核)的精确框架,用于跟踪任务。该算法应用于克林空间而非希尔伯特空间,无需计算原像,因此既高效又准确。这些不定核是基于梯度的,它们直接在 4 ∗ D维特征空间(D是输入向量的维度)中计算标量积,而不是使用核技巧,因此无法实时运行。张等人[102]对标准PCA和KPCA算法的计算进行了近似处理。这些近似方法丢弃了接近均值中心的数据点,并利用剩余的数据点来近似标准 PCA和KPCA,通过使用少量的部分数据点,所提出的算法降低了内存消耗和时间开销。
简而言之,KPCA 是通过在核特征空间中应用标准 PCA而得到的扩展。KPCA 能有效提取目标的非线性特征,常与粒子滤波器结合用于跟踪。这种鲁棒性表现使其成为自动驾驶中特别是在复杂环境或非刚性目标下进行目标跟踪的良好选择。然而,在每次 KPCA 或增量 KPCA 迭代过程中,都需要计算特征协方差矩阵(通常为高维)的奇异值分解,导致计算成本较高,不适合实时跟踪(参考文献[94]中为4帧/秒,参考文献[101]中为3帧/秒,参考文献[99]中为7-1帧/秒)。另一个在线学习中的一个挑战是支持集可能会随着时间增长到任意大的规模,可以采用截断和收缩等策略[103]。还提出了一些其他的降维方法,如费舍尔准则[104],[105]和核熵成分分析(核ECA)[106],[107]。
5. 算法实现与讨论
在本节中,对上述提到的一些代表性算法在自动驾驶或驾驶辅助系统场景下对车辆、行人和人脸的跟踪进行了定量比较。我们首先介绍用于实验比较的跟踪器和数据集,然后讨论结果。
5.1 跟踪器和数据集
实现了五种采用不同方法的跟踪方法,以评估它们在目标跟踪中的性能。GKT(广义基于核的跟踪)[76]是结合KBOT和SVM框架提出的,Struck[79]基于SVM理论实现,在线Boosting[90]利用提升方法进行跟踪,IPCA[94]通过增量主成分分析实现跟踪,DIKT[101]则基于增量 KPCA框架完成跟踪。
使用了七段视频序列 V1-7来评估算法性能(V1-3来自文献[8]中的行人检测序列,V4-7已在文献[79],[90],[94]和[101]中用于目标跟踪)。这些视频序列几乎包含了实际应用环境中光照变化、尺度变化、大幅姿态变化、局部形变和暂时遮挡的情况。可以利用这些视频评估自动驾驶中车辆和行人的跟踪性能,以及驾驶辅助系统中驾驶员面部的跟踪性能。表5总结了这些测试序列的主要特征。
5.2 跟踪结果与讨论
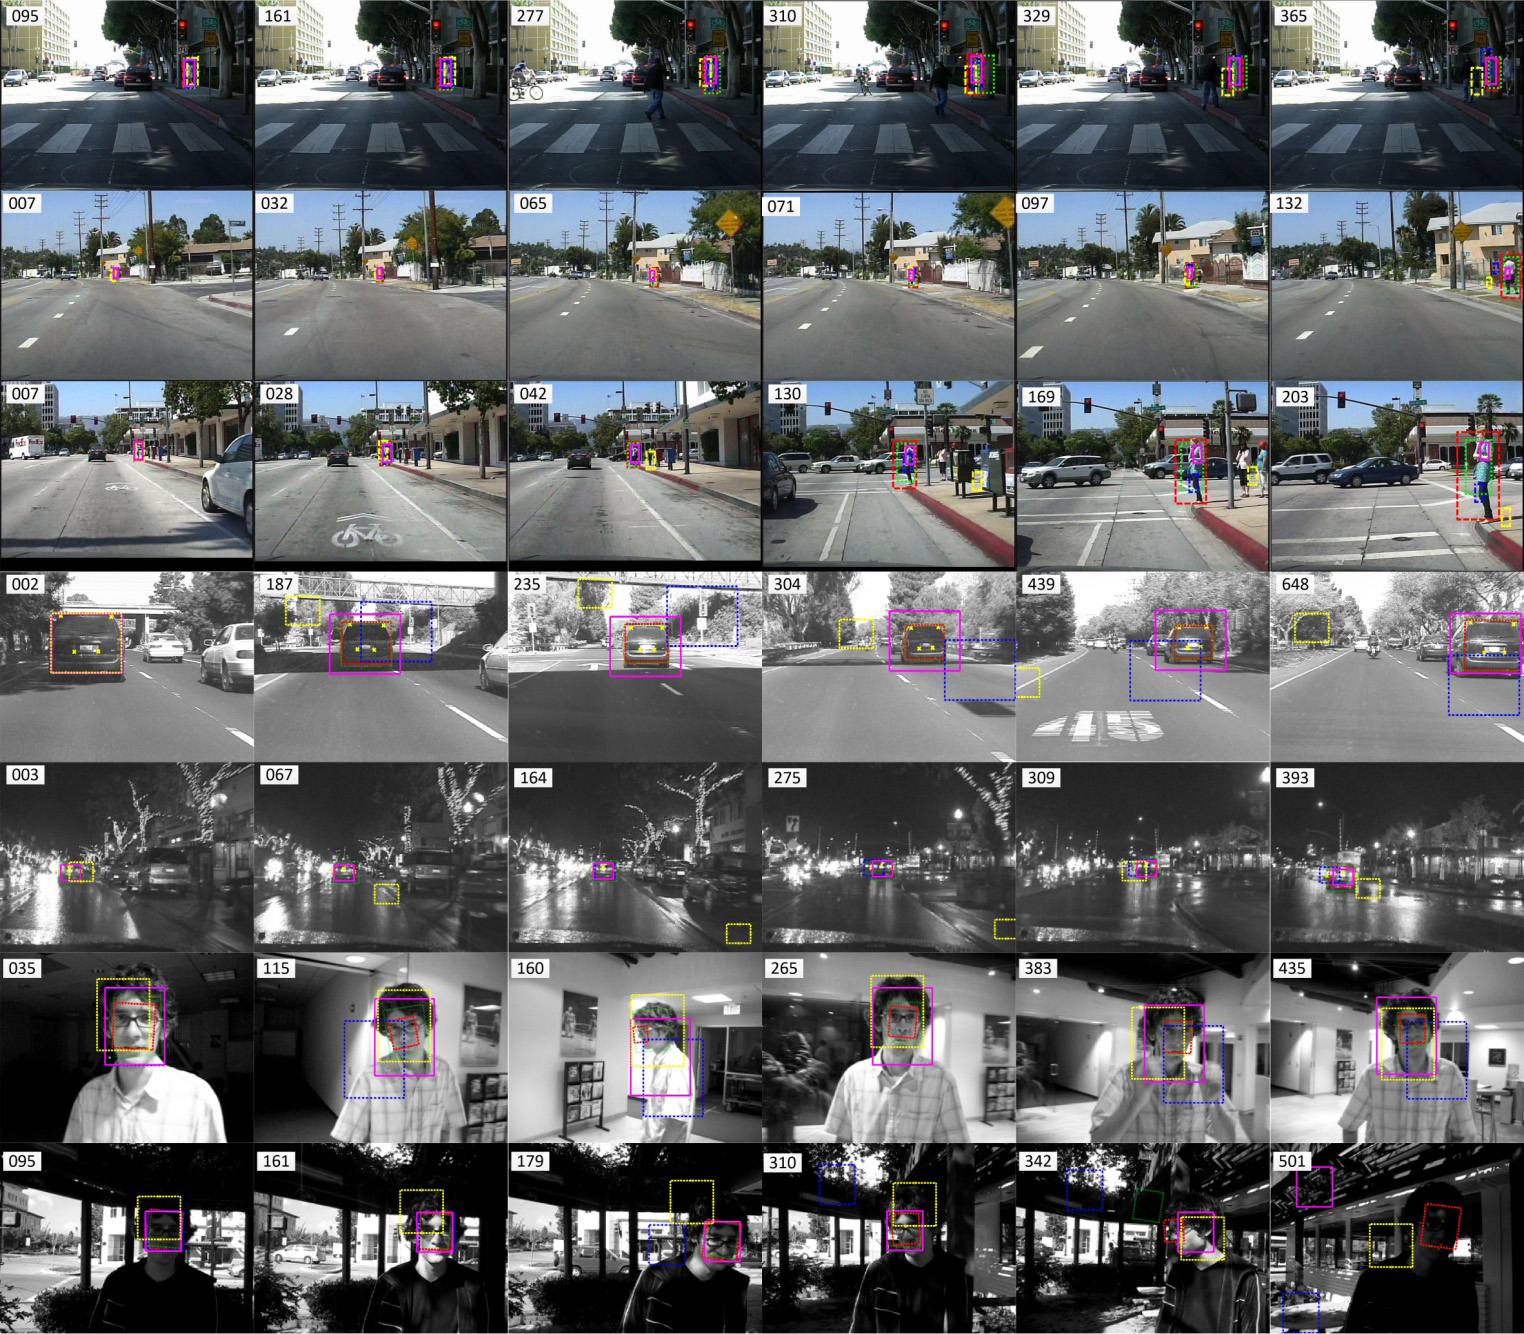
这些序列的代表性跟踪结果如图5所示。所有跟踪器均在初始帧中使用相同的目标模板进行初始化,每个跟踪器的跟踪结果以不同颜色和线型的矩形表示。
与文献[94]和[101]一样,采用特征点的估计位置与真实值之间的均方根(RMS)误差作为定量性能评估的标准。在V1-3序列中,目标位置的顶点被选为特征点,V4-7序列中特征点的真实值可在DIKT数据集中找到。该评估标准为像素误差,受目标大小或视频序列的影响。因此,每个序列的均方根误差范围不同。然而,该标准可用于在同一序列中比较不同跟踪器的结果。均方根误差绘制于图6中,各均方根误差的颜色对应图5中跟踪结果的颜色。从图5可以看出,GKT在V4和V5,序列中丢失了目标,因此其均方根误差未在图6中绘制以供比较。
所有算法在目标于第329帧后完全遮挡时均丢失了目标。DIKT在其余六个视频序列中表现出最佳性能。IPCA和 Struck能够在V2-6的整个序列中跟踪目标,但在V7中,当目标同时经历大幅姿态变化和光照变化时,两者均丢失了目标。在线Boosting相比其他跟踪器稳定性较差,在遇到光照变化时即丢失目标。GKT在V1,V6和V7的大多数帧中能够跟踪目标,但在其他视频中由于序列质量较差(仅灰度且目标颜色特征与背景相似)而丢失目标。此外,Struck、在线Boosting和GKT无法处理目标的尺度变化和方向变化,导致这些算法在目标尺度发生变化的V2和V7中性能较差。
实时处理是自动驾驶中目标跟踪的另一个重要要求。每个跟踪器的计算效率如表6所列。所有这些结果均在配备 1.8GHz Intel Core E2160处理器和2GB内存的台式机上获得。
考虑到每个跟踪器的计算效率,我们可以得出结论:在线子空间学习算法(IPCA 和 DIKT)在稳定性和实时工作之间实现了良好的权衡。基于 PCA和核主成分分析(KPCA)的子空间跟踪可以通过子空间更新来处理光照变化、大幅姿态变化和非刚性运动,目标的尺度变化可通过考虑粒子滤波变量中的噪声干扰来解决。子空间的附加信息可以提高跟踪器的稳定性。在序列 V7 中,由于剧烈的姿态变化和光照变化,增量主成分分析(IPCA)在第310帧之后失效。光照变化。DIKT利用基于梯度的核的附加信息进行跟踪,这提高了跟踪器的鲁棒性,但降低了计算效率。此外,IPCA和DIKT中的多子空间模板也增强了跟踪器的稳定性。
GKT是核均值漂移与支持向量机的结合,是一种基于颜色特征的跟踪方法,因此在仅灰度序列V4和目标颜色特征与背景相似的序列V2,3,5中大多会失败。该颜色特征容易受光照变化影响,但在人脸跟踪中对面部表情具有较高的稳定性。
Struck和在线Boosting分别是基于支持向量机和Boosting的基于检测的跟踪方法。在光照变化的序列V1-V7中,Struck表现优于Boosting,但由于结构化输出预测过程,其在所有五种算法中计算效率最低。此外,在线 Boosting和GKT的计算效率受目标区域大小的影响,在最小目标区域的序列V6 中计算效率最高,而随着目标区域增大,计算效率下降。
 分别采用在线Boosting (), 增量主成分分析 (),GKT (), Struck () 和 DIKT () 方法得到的结果。真实值用黄色十字表示。V1-V3是行人跟踪序列;V4和 V5分别是白天和夜间移动车辆跟踪序列;V6和V7是室内和室外面部跟踪序列)
 , 增量主成分分析 (),GKT (),Struck () 和 DIKT (),GKT 在序列V4和V5中丢失了目标,因此 我们没有绘制这两个序列的均方根误差)
6. 结论与未来研究方向
在城市交通中实现完全自动驾驶在不久的将来仍然是一个极其困难的问题。城市交通中自动驾驶所面临的最大挑战是在视觉图像中的目标检测与跟踪。本文综述了可用于配备视觉传感器的自动驾驶系统中的基于核的目标跟踪策略。基于核的跟踪已成为视觉跟踪领域的热门话题,因其简洁的描述和较高的计算效率而受到认可。本文介绍了核密度估计(KDE)和核技巧的基本概念,并调研了应用于自动驾驶目标跟踪中的核方法。基于核的技术应用分为两个方面:基于核的目标跟踪和核在线学习。在基于核的跟踪中,核函数用于将空间位置信息加入到目标的加权直方图表示中。均值漂移方法基于该表示在连续帧中实现目标跟踪。文中回顾了单核与多核跟踪方法。在核在线学习中,核函数隐式地计算高维特征空间中的标量积,从而解决非线性问题。本文还简要介绍了若干核学习机(如支持向量机、核费舍尔判别和核主成分分析)在跟踪中的应用。同时给出了定性与定量比较。五个跟踪器在七组测试序列上进行了评估,理论与实验分析使我们能够得出结论:在线子空间学习该算法在自动驾驶环境中的目标跟踪稳定性与实时运行之间实现了良好的权衡。根据调查,建议以下几个有前景的方向,以期提高自动驾驶中跟踪方法的灵活性。
误差估计是一个在跟踪算法开发过程中被忽视的重要问题。在跟踪过程中,可能会出现三维世界向二维图像投影时的误差、由复杂环境导致的模糊图像中提取的特征点误差、跟踪框架中转移模型和观测模型的状态参数误差等。在经典方法中,通常采用高斯噪声模型进行误差估计与传播,该高斯模型是一种概率模型,能够保证结果以最大概率接近真实值。然而,有时人们更希望得到一个能够确定包含真实值的结果,而非仅具有最高概率的结果。区间分析(IA)正是一种实现此类策略的方法。特勒和拉姆达尼[108]已将IA应用于相机标定和三维重建,其中将像素坐标视为两个未知但有界变量(区间数),并利用区间约束传播方法来传递这种不确定性。IA还可应用于自标定[109]、可变形图像配准[110]以及二维图像滤波器设计[111]。考虑到在跟踪框架中应用IA(例如,区间核函数),可以保证跟踪结果的真实值,并提高自动驾驶中跟踪算法的鲁棒性。
在跟踪系统的实际应用中,自动配准和重新初始化是两个需要考虑的重要问题。自动注册需要对目标进行在线学习,如上所述,已有许多在线学习算法被提出。然而,重新初始化却很少被考虑。在某些特殊条件下,目标可能会被背景场景结构遮挡一秒钟,并从任意方向重新出现。迄今为止,尚无跟踪方法能够处理这一问题。尽管已有基于多摄像头的重新初始化方法[41],[112],但针对单摄像头的重新初始化准则仍是一个开放性挑战。
总体而言,几乎所有的跟踪方法仅利用了来自二维图像平面的图像信息;这种基于二维的跟踪计算效率较高,但由于三维世界向二维图像投影时造成的信息丢失,其鲁棒性较差。多摄像头已被用于获取跟踪目标的三维信息[113],[114]然而,计算多个摄像头之间的关系以及深度估计需要较大的计算代价。随着相机制造商硬件设备的发展,许多深度相机(例如微软提供的kinect或Creative Senz3D)已经可用。我们可以直接从这些相机获取深度信息,避免了自行进行复杂的计算。利用深度信息进行跟踪的优势主要有两点:一是深度信息增强了跟踪目标的特征表示;二是我们所关注的三维点的坐标可以直接获得,借助这些在世界坐标系中的坐标,可以估计动力学模型和运动约束。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 19
 0
- 0


 已为社区贡献7条内容

所有评论(0)