Python实现贝叶斯优化器(Bayes_opt)优化卷积神经网络-双向长短时记忆循环神经网络回归模型(CNN-BiLSTM回归算法)项目实战
说明:这是一个机器学习实战项目(附带数据+代码+文档+视频讲解),如需数据+代码+文档+视频讲解可以直接到文章最后获取。
1.项目背景
随着大数据和计算能力的提升,深度学习模型在众多领域取得了显著的成功。然而,这些模型通常包含大量的超参数需要调优,这对模型的最终性能有着直接的影响。特别是在涉及多个子模型的复杂架构中,如结合了卷积神经网络(CNN)用于特征提取和双向长短时记忆循环神经网络(BiLSTM)用于序列建模的混合模型中,超参数的优化变得更加重要但也更加困难。
本项目旨在利用贝叶斯优化技术来自动寻找CNN-BiLSTM回归模型的最佳超参数配置。通过应用贝叶斯优化,我们希望能够在保证模型性能的同时,减少调参所需的时间和资源。这不仅有助于提高模型的预测精度,也能为未来类似模型的设计提供一种有效的优化方案。
本项目通过Python实现贝叶斯优化器(Bayes_opt)优化卷积神经网络-双向长短时记忆循环神经网络回归模型(CNN-BiLSTM回归算法)项目实战。
2.数据获取
本次建模数据来源于网络(本项目撰写人整理而成),数据项统计如下:
| 编号 | 变量名称 | 描述 |
| 1 | x1 | |
| 2 | x2 | |
| 3 | x3 | |
| 4 | x4 | |
| 5 | x5 | |
| 6 | x6 | |
| 7 | x7 | |
| 8 | x8 | |
| 9 | x9 | |
| 10 | x10 | |
| 11 | y | 因变量 |
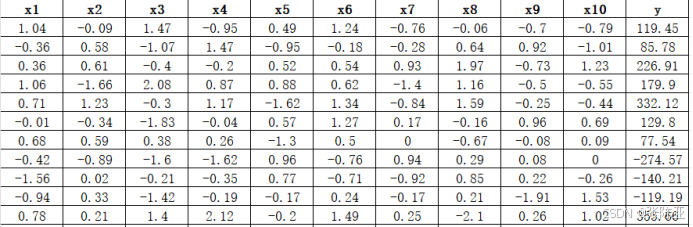
数据详情如下(部分展示):
3.数据预处理
3.1 用Pandas工具查看数据
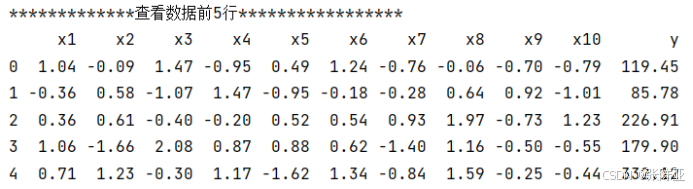
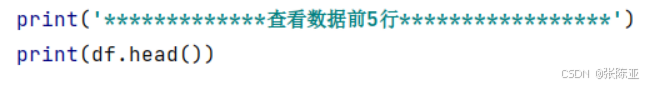
使用Pandas工具的head()方法查看前五行数据:
关键代码:
3.2数据缺失查看
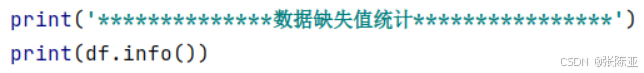
使用Pandas工具的info()方法查看数据信息:

从上图可以看到,总共有11个变量,数据中无缺失值,共2000条数据。
关键代码:
3.3数据描述性统计
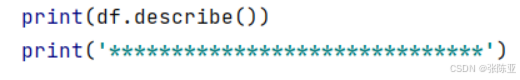
通过Pandas工具的describe()方法来查看数据的平均值、标准差、最小值、分位数、最大值。

关键代码如下:
4.探索性数据分析
4.1 y变量分布直方图
用Matplotlib工具的hist()方法绘制直方图:

4.2 相关性分析

从上图中可以看到,数值越大相关性越强,正值是正相关、负值是负相关。
5.特征工程
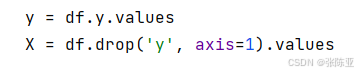
5.1 建立特征数据和标签数据
关键代码如下:
5.2 数据集拆分
通过train_test_split()方法按照80%训练集、20%测试集进行划分,关键代码如下:

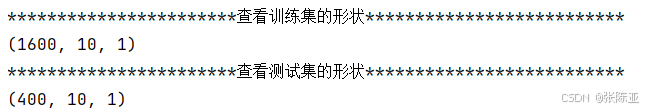
5.3 数据样本增维
数据样本增加维度后的数据形状:
6.构建贝叶斯优化算法优化CNN-BiLSTM回归模型
主要使用贝叶斯优化算法优化CNN-BiLSTM回归算法,用于目标回归。
6.1 构建调优模型
| 编号 | 模型名称 | 调优参数 |
| 1 | CNN-BiLSTM回归模型 | int(units) |
| 2 | round(learning_rate, 4) | |
| 3 | int(epochs) |
6.2 最优参数展示
最优参数结果展示:

6.3 最优参数构建模型
| 编号 | 模型名称 | 调优参数 |
| 1 | CNN-BiLSTM回归模型 | units=int(params_best['units']) |
| 2 | round(params_best['learning_rate'], 4) | |
| 3 | epochs=int(params_best['epochs']) |
6.4 模型摘要信息

6.5 模型网络结构

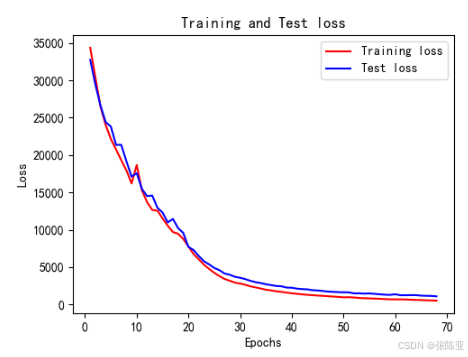
6.6 模型训练集测试集损失曲线图
7.模型评估
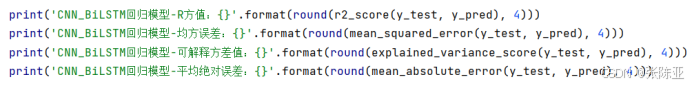
7.1评估指标及结果
评估指标主要包括R方、均方误差、解释性方差、绝对误差等等。
| 模型名称 | 指标名称 | 指标值 |
| 测试集 | ||
| CNN-BiLSTM回归模型 | R方 | 0.971 |
| 均方误差 | 1089.9386 | |
| 解释方差分 | 0.971 | |
| 绝对误差 | 17.5616 | |
从上表可以看出,R方分值为0.971,说明模型效果比较好。
关键代码如下:
7.2 真实值与预测值对比图

从上图可以看出真实值和预测值波动基本一致,模型效果良好。
8.结论与展望
综上所述,本文采用了贝叶斯优化算法寻找卷积神经网络-双向长短时记忆循环神经网络回归算法的最优参数值来构建回归模型,最终证明了我们提出的模型效果良好。此模型可用于日常产品的预测。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 28
 0
- 0


 已为社区贡献6条内容

所有评论(0)