“自动驾驶的眼睛”:语义分割是怎么让车“看懂”世界的
什么是语义分割?像素级“贴标签”🖍️
当我们人类看一张街景照片时,大脑会自动识别出“这是马路”、“那是行人”、“前面有辆车”。这种能力对我们来说几乎是本能。但对一辆自动驾驶汽车来说,它必须通过算法来“看懂”这张图——这就是语义分割的任务。
🧩 用“贴标签”来理解
想象你在玩一款填色游戏,每个区域都要涂上不同的颜色:
- 灰色代表“道路”
- 红色代表“车辆”
- 黄色代表“行人”
- 蓝色代表“天空”
- 绿色代表“树木”
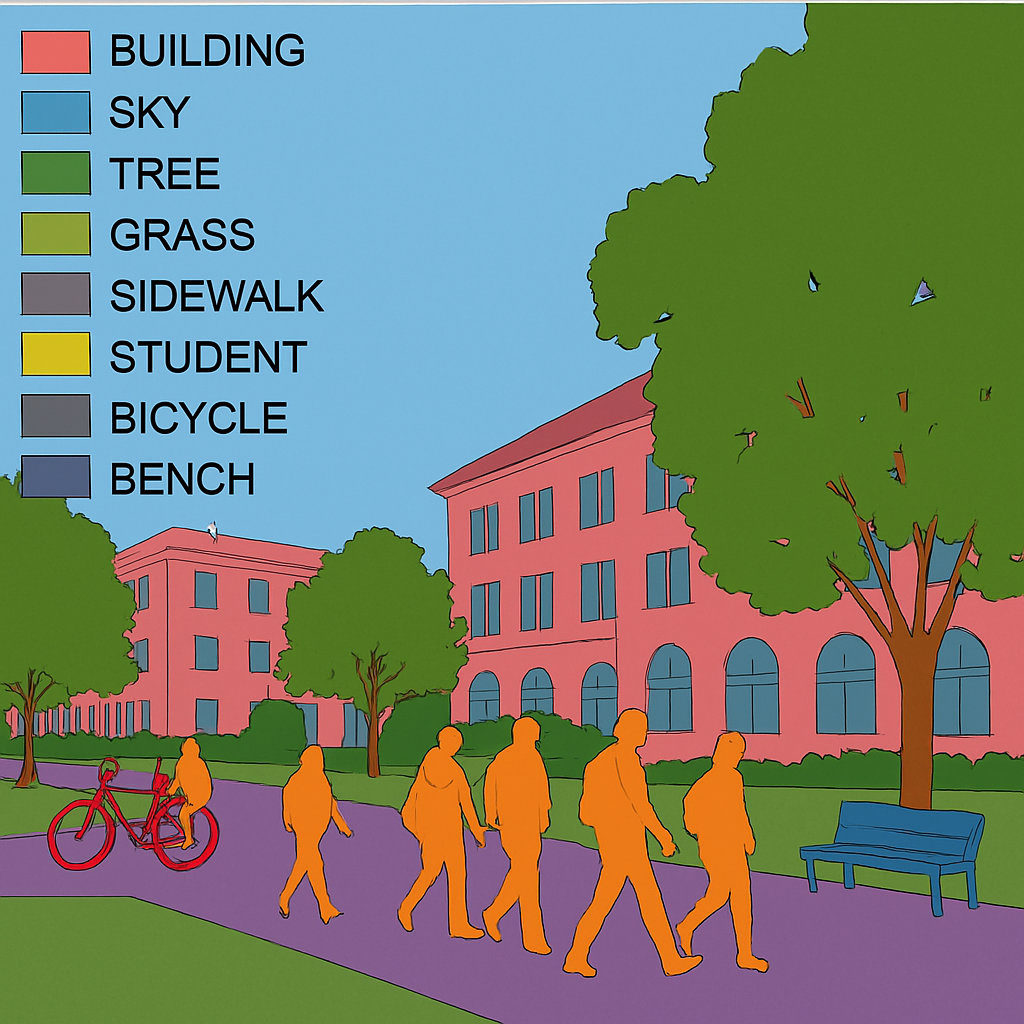
语义分割就是让计算机对图像中的每一个像素都进行这样的“分类”,也就是“贴标签”。最终,整张图像就变成了一张五彩斑斓的“语义地图”,每种颜色代表一个物体类别。
🧠 它和“识别物体”有什么不同?
你可能听说过“目标检测”技术,它会在图像中画出一个个方框,告诉你“这里有辆车”、“那里有个行人”。而语义分割更进一步——它不是画框,而是精确到每一个像素,就像用画笔勾勒出每个物体的轮廓。
这种精细的理解能力,对自动驾驶来说非常重要。比如:
- 判断车道线的准确位置
- 识别出路边的非机动车
- 区分“人行道”和“马路边”
🖼️ 一张图胜过千言万语
它就像一幅“彩色版”的现实世界。每个区域都被赋予了明确的语义标签,让车不仅能“看到”,还能“理解”它所处的环境。
为什么车要“看懂”每一块地面?🚧
对人类来说,走在街上时我们会下意识地判断哪里能走、哪里不能走。比如我们知道不能走到马路中间,也知道看到红灯要停下。但对自动驾驶汽车来说,它必须通过“看懂”每一块地面,来做出正确的决策。
🚗 自动驾驶的“眼睛”需要全局理解
自动驾驶系统的第一步是“感知”——也就是理解周围环境。语义分割就像是这双“眼睛”的核心部分,它告诉系统:
- 哪些区域是可行驶的道路
- 哪些区域是人行道、绿化带、建筑物
- 哪些区域有行人、自行车、其他车辆
只有理解了这些信息,车辆才能判断:
- 当前是否在正确的车道上?
- 前方是否有障碍物或行人?
- 是否需要减速、停车或变道?
🧭 决策和规划的基础
语义分割提供的“像素级地图”会被送入后续的路径规划模块。比如:
- 如果前方是“道路”,车辆可以继续前进;
- 如果前方是“行人”或“非机动车”,车辆需要减速或绕行;
- 如果检测到“施工区域”或“封闭道路”,车辆需要重新规划路线。
可以说,没有语义分割,自动驾驶就像是闭着眼睛开车。
🧱 举个例子:识别“马路牙子”
人类很容易看出马路边缘的“马路牙子”,知道那是不能开的。但对机器来说,如果没有语义分割,它可能只看到一块灰色区域,不知道那是“禁止通行”的边界。
语义分割能准确标出“道路”和“非道路”的边界,避免车辆误入人行道或绿化带。
红绿灯、行人、自行车:语义分割怎么帮忙?🚦🚶♀️🚲
在自动驾驶的世界里,识别“物体”只是第一步,理解“它们在干什么、在哪里、和环境的关系”才是关键。语义分割在这方面扮演了非常重要的角色。
🔍 不只是“看到”,更是“理解”
传统的目标检测技术可以告诉系统:“前方有一个人”、“左边有一辆车”。但它无法告诉系统:
- 这个人是不是在斑马线上?
- 这辆车是不是停在非机动车道上?
- 红绿灯是挂在杆子上,还是只是广告牌?
语义分割通过对整个画面进行像素级的理解,能提供这些上下文信息,让系统更聪明地判断场景。
🚦 红绿灯识别的“辅助线索”
红绿灯是自动驾驶中非常关键的元素,但它体积小、位置高、背景复杂,容易被误判。语义分割可以帮助系统:
- 识别出红绿灯所在的“支架”或“路口区域”
- 判断红绿灯是否属于当前车道
- 区分红绿灯和其他类似形状的物体(比如广告灯箱)
这就像是给目标检测“加了背景知识”,让判断更准确。
🚶♀️ 行人与非机动车的“行为预判”
语义分割还能帮助系统判断行人或非机动车的位置和意图:
- 行人是在斑马线上,说明可能要过马路
- 自行车在非机动车道上,说明是正常通行
- 如果行人突然出现在车道边缘,系统可以提前减速
这些细节,往往是避免事故的关键。
🧠 举个例子:雨天的路口
在雨天或夜晚,摄像头拍到的图像可能模糊不清。语义分割模型可以结合历史经验和上下文信息,依然判断出:
- 哪些区域是“人行道”
- 哪些是“积水的马路”
- 哪些是“模糊但可能是行人”的区域
这让自动驾驶系统在复杂环境下依然具备一定的“容错能力”。
它和人类视觉有什么不一样?👁️🤖
我们每天都在用眼睛观察世界,大脑会自动帮我们识别出“这是车”、“那是人”、“前面是红灯”。但自动驾驶汽车并没有大脑,它只能依靠算法来“看”和“理解”周围的环境。那么,语义分割和人类视觉到底有什么不同呢?
🧠 人类靠经验,机器靠训练
人类识别物体靠的是经验和直觉。比如你小时候看到过一次红绿灯,以后就能在各种场景中认出它。而语义分割模型则需要通过大量的数据训练,才能学会识别不同的物体。
它的训练过程就像是“看了成千上万张图”,每张图都标注了“这块是车”、“那块是人行道”,久而久之,它就学会了如何给新图像“贴标签”。
🎯 精度更高,但也更“死板”
语义分割的一个优势是精度高。它能把每一个像素都分类清楚,甚至能识别出远处一个小小的交通锥,或者马路边一只停着的电动车。
但它也有局限:
- 缺乏灵活性:人类可以根据上下文“猜”出一个模糊物体是什么,而语义分割模型可能就识别不出来。
- 容易被干扰:强光、雨雾、镜面反射等情况,可能会让模型“看花眼”。
🔄 不会疲劳,也不会走神
相比人类司机,语义分割还有一个天然优势:它不会累,也不会分心。不管是凌晨三点,还是连续开车十小时,它都能保持同样的识别精度。
这对于提升自动驾驶的安全性来说,是一个非常重要的补充。
🧬 可扩展性强,适应不同城市和场景
语义分割模型可以根据不同地区、不同天气、不同交通规则进行“定制训练”。比如:
- 在上海,它可以识别出“非机动车道”和“电瓶车”
- 在美国,它可以识别出“校车”和“STOP标志”
- 在雨天,它可以识别出“积水区域”和“反光路面”
这种灵活的适应能力,是人类视觉难以比拟的。
未来的车,会不会比人还“看得清”?🔮🚘
随着技术的不断进步,语义分割正在从“实验室里的研究成果”变成“量产车上的标配”。未来,它不仅能让车“看清楚”,甚至可能在某些方面比人类看得更准、更快、更稳。
🌧️ 在极端天气中保持清晰感知
人类在雨天、雾天、夜晚开车时,视线会受到严重影响。但语义分割模型可以结合多种传感器(如红外摄像头、激光雷达),在低能见度条件下依然保持对环境的理解:
- 识别出积水区域,避免涉水熄火
- 判断出模糊轮廓是行人还是广告牌
- 在夜间准确分辨车道线和路缘
这让自动驾驶在“人类最容易出错”的场景中,反而更有优势。
🧠 多模态融合:不仅靠“眼睛”,还有“耳朵”和“触觉”
未来的自动驾驶系统不会只依赖摄像头。语义分割将与其他感知方式融合:
- 激光雷达提供三维结构信息
- 毫米波雷达感知动态目标
- 高精地图提供静态环境参考
语义分割就像是“视觉大脑”的核心,负责把这些信息整合成一张“理解图”,让车辆做出更聪明的决策。
🧭 从“看得清”到“看得懂”
未来的语义分割不仅要识别物体,还要理解它们的行为和意图:
- 行人是站着、走着,还是突然加速?
- 自行车是正常通行,还是准备横穿马路?
- 前方车辆是正常行驶,还是在临时停车?
这就像是从“识图”走向“读懂场景”,让自动驾驶更接近人类的判断力。
🚀 走向端到端的智能驾驶
随着AI模型的发展,语义分割可能不再是一个“单独的模块”,而是融入整个感知-决策-控制的闭环中。也就是说,未来的车可能不再“先看清再思考”,而是直接“看图做决定”。
这将大大提升系统的反应速度和整体效率。这也就是为什么每一家都在说端到端才是未来

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 5
 0
- 0


 已为社区贡献8条内容

所有评论(0)