LangGraph爆了!MapReduce模式轻松实现任务分解与并行处理,收藏这篇超详细教程!
本文深入探讨了LangGraph中的MapReduce模式,这是一种高效的任务分解与并行处理方式,适用于大规模数据处理和计算密集型任务。文章详细解释了MapReduce的核心思想,即“分而治之”,将复杂任务分解为Map(映射)和Reduce(归约)两个阶段,并展示了如何在LangGraph中利用Send对象和条件边实现动态任务分解和结果归约。通过一个大规模文档处理的示例,本文演示了如何使用LangGraph的MapReduce模式进行高效的数据处理,包括数据分割、并行映射和结果聚合。最后,文章总结了MapReduce模式的优势和应用场景,为读者提供了实用的参考和指导。
LangGraph之MapReduce 模式:任务分解与并行处理
在上一节中,我们学习到如何在LangGraph中创建并行节点执行的分支,利用fan-out和fan-in机制、条件分支以及稳定排序的技术来实现高效的工作流。通过示例代码,用户能够深入理解这些概念,并将在实际应用中得到有效的运用。
本节我们将重点探讨 LangGraph 中的MapReduce 模式:
MapReduce 是一种高效的任务分解与并行处理模式,广泛应用于数据处理和工作流设计中。
MapReduce 模式通过 Send 对象 和 条件边 提供了灵活的实现方式,适用于动态任务分解和结果归约。
LangGraph通过其Send API解决了这些挑战。利用条件边,Send可以将不同的状态分发给多个节点实例。重要的是,发送的状态可以与核心图形的状态不同,从而实现灵活而动态的工作流管理。
MapReduce 模式:任务分解与并行处理
在构建复杂智能体系统时,经常会遇到需要处理大规模数据或执行计算密集型任务的场景。例如:
- • 批量处理海量文档进行信息提取
- • 并行生成多个创意文案
- • 分布式分析用户行为数据
MapReduce (映射-归约) 模式为我们提供了一种高效、可扩展地处理这类问题的通用解决方案。
MapReduce 模式的核心思想
MapReduce 模式的核心思想可以用两个词概括:“分而治之”。它将一个复杂、大规模的计算任务分解成两个相互协作的阶段:
Map 阶段 (映射)
- • "分"的过程:将原始的、大规模的输入数据分割成多个独立的、规模较小的子数据集
- • 并行处理:每个子数据集分配给不同的计算节点并行处理
- • 独立执行:每个计算节点独立地对分配的子数据集执行相同的"映射"操作
Reduce 阶段 (归约)
- • "治"的过程:将 Map 阶段并行生成的多个中间结果进行"归约"操作
- • 聚合汇总:将分散的、局部的中间结果合并成最终的、全局的结果
- • 整合提炼:将 Map 阶段的"半成品"组装成"成品"
MapReduce 的核心优势
- • 并行处理:充分利用并行计算资源,显著提高数据处理效率
- • 高扩展性:易于扩展,可以通过增加计算节点来处理更大规模的数据
- • 简化编程模型:隐藏了底层并行计算的复杂性,开发者只需关注业务逻辑
示例:LangGraph 中的 MapReduce 实现
from typing import Annotated, List, Anyfrom typing_extensions import TypedDictfrom langgraph.graph import StateGraph, START, ENDfrom langgraph.constants import Sendimport operatorimport re# 定义整体状态结构体class OverallState(TypedDict): # 原始大规模输入数据 large_input_data: List[str] # 分割后的子数据集 sub_datasets: List[List[str]] # Map 阶段的处理结果 (使用 operator.add Reducer 收集结果) intermediate_results: Annotated[List[dict], operator.add] # Reduce 阶段的最终结果 final_result: dict# 定义 Map 节点的私有状态结构体class MapState(TypedDict): sub_data: Any # 子任务数据类型可以是任意类型def split_large_data(input_data: List[str], num_sub_tasks: int = 10) -> List[List[str]]: """将大规模数据分割成子数据集""" chunk_size = max(1, len(input_data) // num_sub_tasks) chunks = [] for i in range(0, len(input_data), chunk_size): chunks.append(input_data[i:i + chunk_size]) return chunksdef split_input_data(state: OverallState): """分割节点函数:只负责数据分割,不返回 Send 对象""" input_data = state["large_input_data"] # 从状态中获取大规模输入数据 sub_datasets = split_large_data(input_data, num_sub_tasks=4) # 将大规模数据分割成子数据集 print(f"🔄 分割节点: 将 {len(input_data)} 个文档分割成 {len(sub_datasets)} 个子数据集") for i, sub_dataset in enumerate(sub_datasets): print(f"📦 子数据集 {i}: {len(sub_dataset)} 个文档") return {"sub_datasets": sub_datasets}def route_to_map_nodes(state: OverallState): """路由函数:根据分割的数据创建 Send 对象""" sub_datasets = state["sub_datasets"] print(f"🔀 路由函数: 创建 {len(sub_datasets)} 个并行任务") send_list = [] for i, sub_dataset in enumerate(sub_datasets): # 遍历每个子数据集 send_list.append( Send("map_node", {"sub_data": sub_dataset}) # 为每个子数据集创建一个 Send 对象 ) print(f"✅ 路由完成: 创建了 {len(send_list)} 个 Send 对象") return send_list # 返回 Send 对象列表,用于动态路由到多个 Map 节点实例def process_sub_data(sub_data: List[str]) -> dict: """处理子任务数据,生成中间结果""" word_count = {} total_chars = 0 for doc in sub_data: # 统计词频 words = re.findall(r'\b\w+\b', doc.lower()) for word in words: word_count[word] = word_count.get(word, 0) + 1 # 统计字符数 total_chars += len(doc) return { "word_count": word_count, "doc_count": len(sub_data), "total_chars": total_chars, "unique_words": len(word_count) }def map_node(state: MapState): """Map 节点函数,输入状态为 MapState""" sub_data = state["sub_data"] # 从状态中获取子任务数据 print(f"🔧 Map 节点: 开始处理 {len(sub_data)} 个文档") intermediate_result = process_sub_data(sub_data) # 处理子任务数据,生成中间结果 print(f"✅ Map 节点: 处理完成,找到 {intermediate_result['unique_words']}个不同单词") return {"intermediate_results": [intermediate_result]} # 返回中间结果,用于后续 Reduce 阶段聚合def aggregate_results(intermediate_results: List[dict]) -> dict: """聚合中间结果,生成最终结果""" global_word_count = {} total_docs = 0 total_chars = 0 for result in intermediate_results: total_docs += result["doc_count"] total_chars += result["total_chars"] # 合并词频统计 for word, count in result["word_count"].items(): global_word_count[word] = global_word_count.get(word, 0) + count # 找出最高频和最低频的词 if global_word_count: sorted_words = sorted(global_word_count.items(), key=lambda x: x[1],reverse=True) most_common = sorted_words[0] least_common = sorted_words[-1] else: most_common = ("", 0) least_common = ("", 0) return { "total_documents": total_docs, "total_characters": total_chars, "total_unique_words": len(global_word_count), "total_words": sum(global_word_count.values()), "most_common_word": most_common, "least_common_word": least_common, "word_distribution": dict(sorted_words[:10]) # 只保留前10个高频词 }def reduce_node(state: OverallState): """Reduce 节点函数,输入状态为 OverallState""" intermediate_results = state["intermediate_results"] # 从状态中获取 Map 阶段生成的中间结果列表 print(f"🔄 Reduce 节点: 汇聚 {len(intermediate_results)} 个中间结果") final_result = aggregate_results(intermediate_results) # 聚合中间结果,生成最终结果 print(f"✅ Reduce 完成: 汇总了 {final_result['total_documents']} 个文档") return {"final_result": final_result} # 返回最终结果# 构建 MapReduce 图print("🏗️ 构建标准 MapReduce 图...")builder = StateGraph(OverallState)# 添加节点builder.add_node("split_node", split_input_data)builder.add_node("map_node", map_node)builder.add_node("reduce_node", reduce_node)# 连接 MapReduce 流程中的节点和边builder.add_edge(START, "split_node")# 关键修正:分离数据分割和任务路由# 分割节点 -> Map 节点 (条件边, 使用专门的路由函数)builder.add_conditional_edges("split_node", route_to_map_nodes, ["map_node"])# Map 节点 -> Reduce 节点 (普通边)builder.add_edge("map_node", "reduce_node")# Reduce 节点 -> END (普通边)builder.add_edge("reduce_node", END)mapreduce_graph = builder.compile()print("✅ 图构建完成!")# 测试数据:模拟大规模文档数据large_documents = [ "LangGraph is a powerful framework for building AI agent systems with complex workflows.", "The framework provides comprehensive state management and advanced flow control capabilities.", "Parallel processing in LangGraph enables efficient task execution and resource utilization.", "MapReduce pattern helps process large datasets effectively using distributed computing principles.", "AI agents can use various tools and manage complex workflows with sophisticated coordination.", "State management is crucial for building reliable and scalable distributed systems.", "LangGraph supports dynamic branching with Send API for flexible workflowdesign.", "Concurrent execution improves overall system performance and throughput significantly.", "The Send API enables dynamic task distribution and parallel processing capabilities.", "Reducer functions ensure safe concurrent state updates in multi-threadedenvironments.", "Graph-based workflows provide clear visualization and better debugging capabilities.", "Advanced error handling and retry mechanisms ensure robust system operation."]print("\n=== 🚀 MapReduce 大规模文档处理演示 ===")print(f"📄 输入文档数量: {len(large_documents)}")print(f"📊 使用 Send API 实现动态任务分发")print(f"🔄 MapReduce 流程: 分割 -> 并行映射 -> 归约")print("\n" + "="*60)# 执行 MapReduce 流程result = mapreduce_graph.invoke({ "large_input_data": large_documents, "sub_datasets": [], "intermediate_results": [], "final_result": {}})print("="*60)print("\n=== ✨ MapReduce 处理结果 ===")final_result = result["final_result"]print(f"📊 总文档数: {final_result['total_documents']}")print(f"📝 总字符数: {final_result['total_characters']}")print(f"🔤 不同单词数: {final_result['total_unique_words']}")print(f"🔢 总单词数: {final_result['total_words']}")print(f"🏆 最高频词: '{final_result['most_common_word'][0]}' ({final_result['most_common_word'][1]} 次)")print(f"🥉 最低频词: '{final_result['least_common_word'][0]}' ({final_result['least_common_word'][1]} 次)")print(f"\n📈 高频词汇 TOP 10:")for word, count in final_result['word_distribution'].items(): print(f" 📌 {word}: {count}")🏗️ 构建标准 MapReduce 图...✅ 图构建完成!=== 🚀 MapReduce 大规模文档处理演示 ===📄 输入文档数量: 12📊 使用 Send API 实现动态任务分发🔄 MapReduce 流程: 分割 -> 并行映射 -> 归约============================================================🔄 分割节点: 将 12 个文档分割成 4 个子数据集📦 子数据集 0: 3 个文档📦 子数据集 1: 3 个文档📦 子数据集 2: 3 个文档📦 子数据集 3: 3 个文档🔀 路由函数: 创建 4 个并行任务✅ 路由完成: 创建了 4 个 Send 对象🔧 Map 节点: 开始处理 3 个文档✅ Map 节点: 处理完成,找到 33个不同单词🔧 Map 节点: 开始处理 3 个文档✅ Map 节点: 处理完成,找到 26个不同单词🔧 Map 节点: 开始处理 3 个文档✅ Map 节点: 处理完成,找到 28个不同单词🔧 Map 节点: 开始处理 3 个文档✅ Map 节点: 处理完成,找到 32个不同单词🔄 Reduce 节点: 汇聚 4 个中间结果✅ Reduce 完成: 汇总了 12 个文档=============================================================== ✨ MapReduce 处理结果 ===📊 总文档数: 12📝 总字符数: 1039🔤 不同单词数: 89🔢 总单词数: 130🏆 最高频词: 'and' (8 次)🥉 最低频词: 'operation' (1 次)📈 高频词汇 TOP 10: 📌 and: 8 📌 langgraph: 3 📌 for: 3 📌 with: 3 📌 workflows: 3 📌 state: 3 📌 capabilities: 3 📌 is: 2 📌 framework: 2 📌 building: 2
💡 MapReduce 实现核心要点:
流程设计
-
- 分割阶段 (Split):将输入文档按块大小分割,为并行处理做准备
-
- 映射阶段 (Map):多个 Map 节点并发处理不同的数据块,执行词频统计
-
- 归约阶段 (Reduce):汇聚所有 Map 结果,生成全局统计
实际应用场景
- • 文档分析:批量处理大量文档进行内容分析
- • 数据挖掘:从海量数据中提取统计信息
- • 并行计算:任何可以分割处理的计算密集型任务
AI时代,未来的就业机会在哪里?
答案就藏在大模型的浪潮里。从ChatGPT、DeepSeek等日常工具,到自然语言处理、计算机视觉、多模态等核心领域,技术普惠化、应用垂直化与生态开源化正催生Prompt工程师、自然语言处理、计算机视觉工程师、大模型算法工程师、AI应用产品经理等AI岗位。
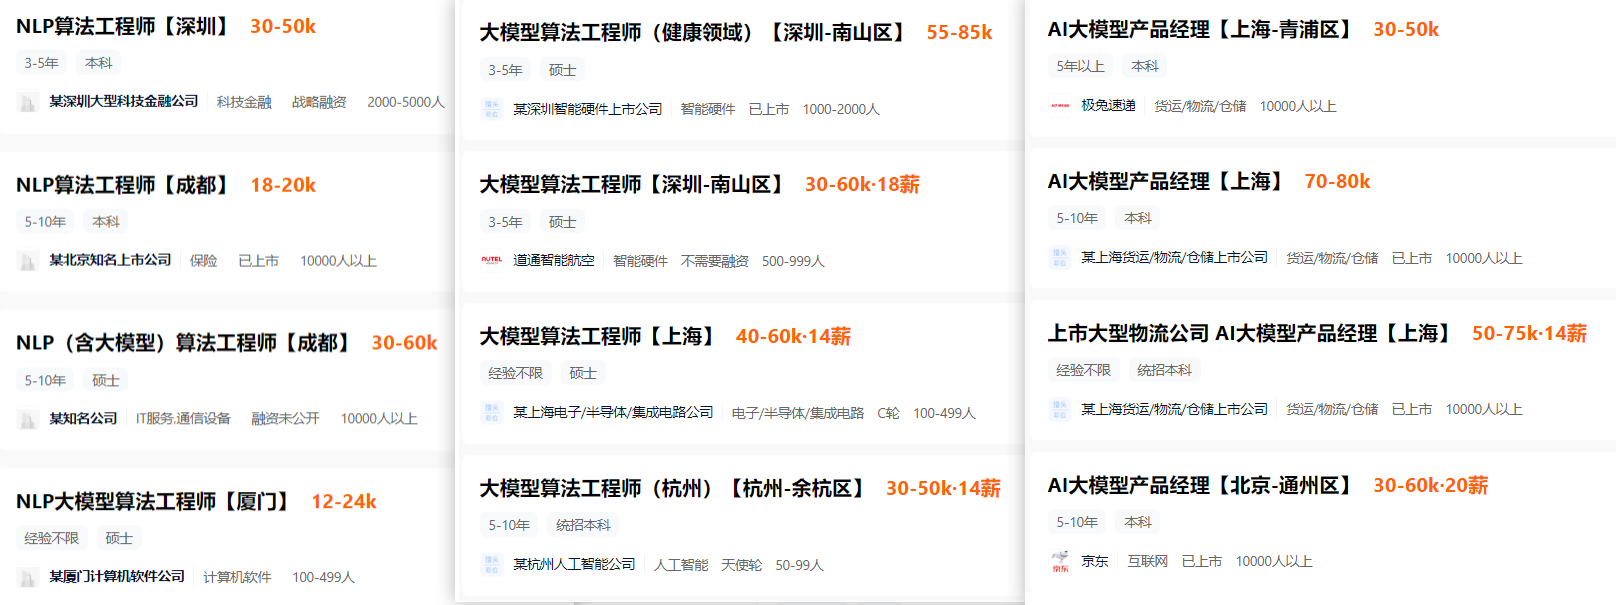
掌握大模型技能,就是把握高薪未来。
那么,普通人如何抓住大模型风口?
AI技术的普及对个人能力提出了新的要求,在AI时代,持续学习和适应新技术变得尤为重要。无论是企业还是个人,都需要不断更新知识体系,提升与AI协作的能力,以适应不断变化的工作环境。
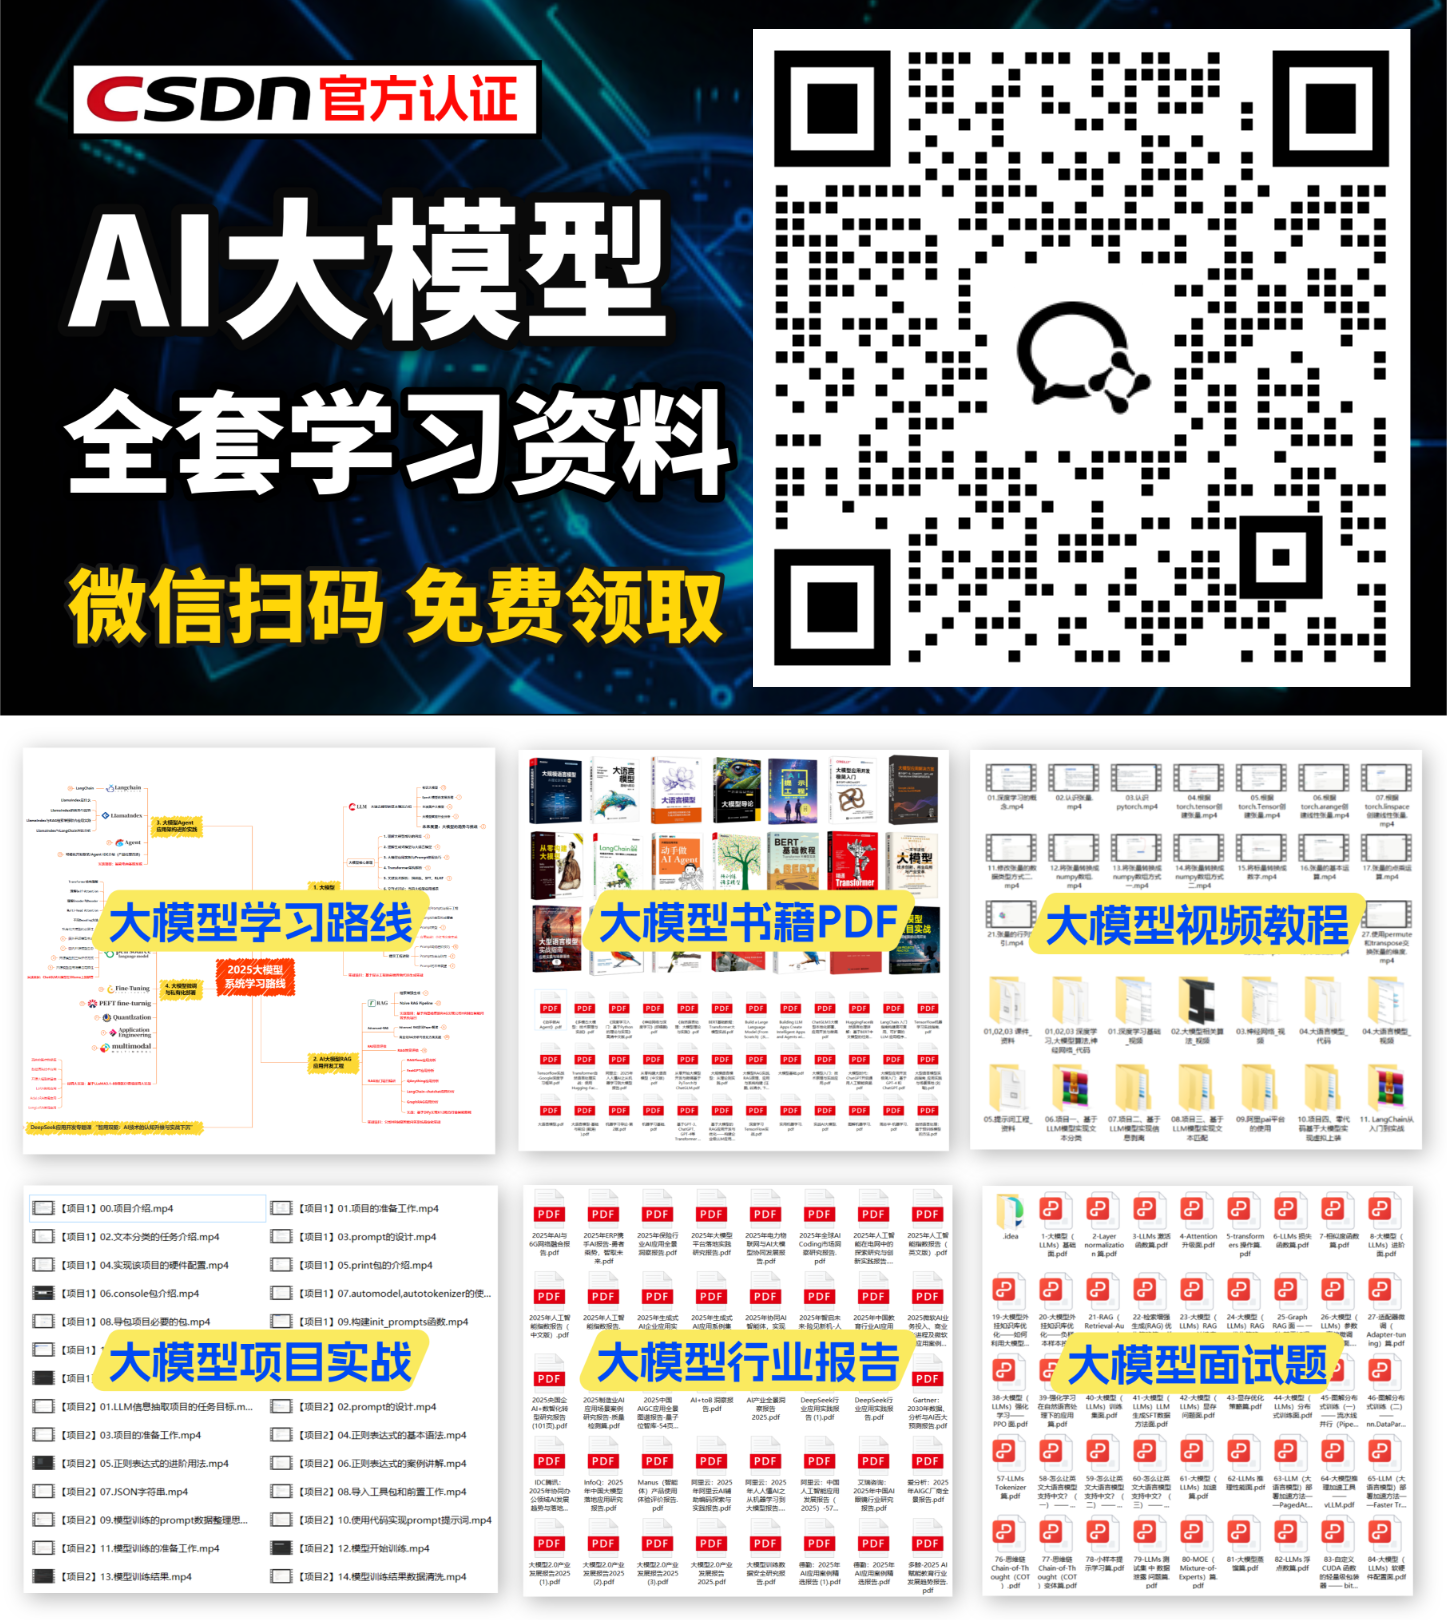
因此,这里给大家整理了一份《2025最新大模型全套学习资源》,包括2025最新大模型学习路线、大模型书籍、视频教程、项目实战、最新行业报告、面试题等,带你从零基础入门到精通,快速掌握大模型技术!
由于篇幅有限,有需要的小伙伴可以扫码获取!
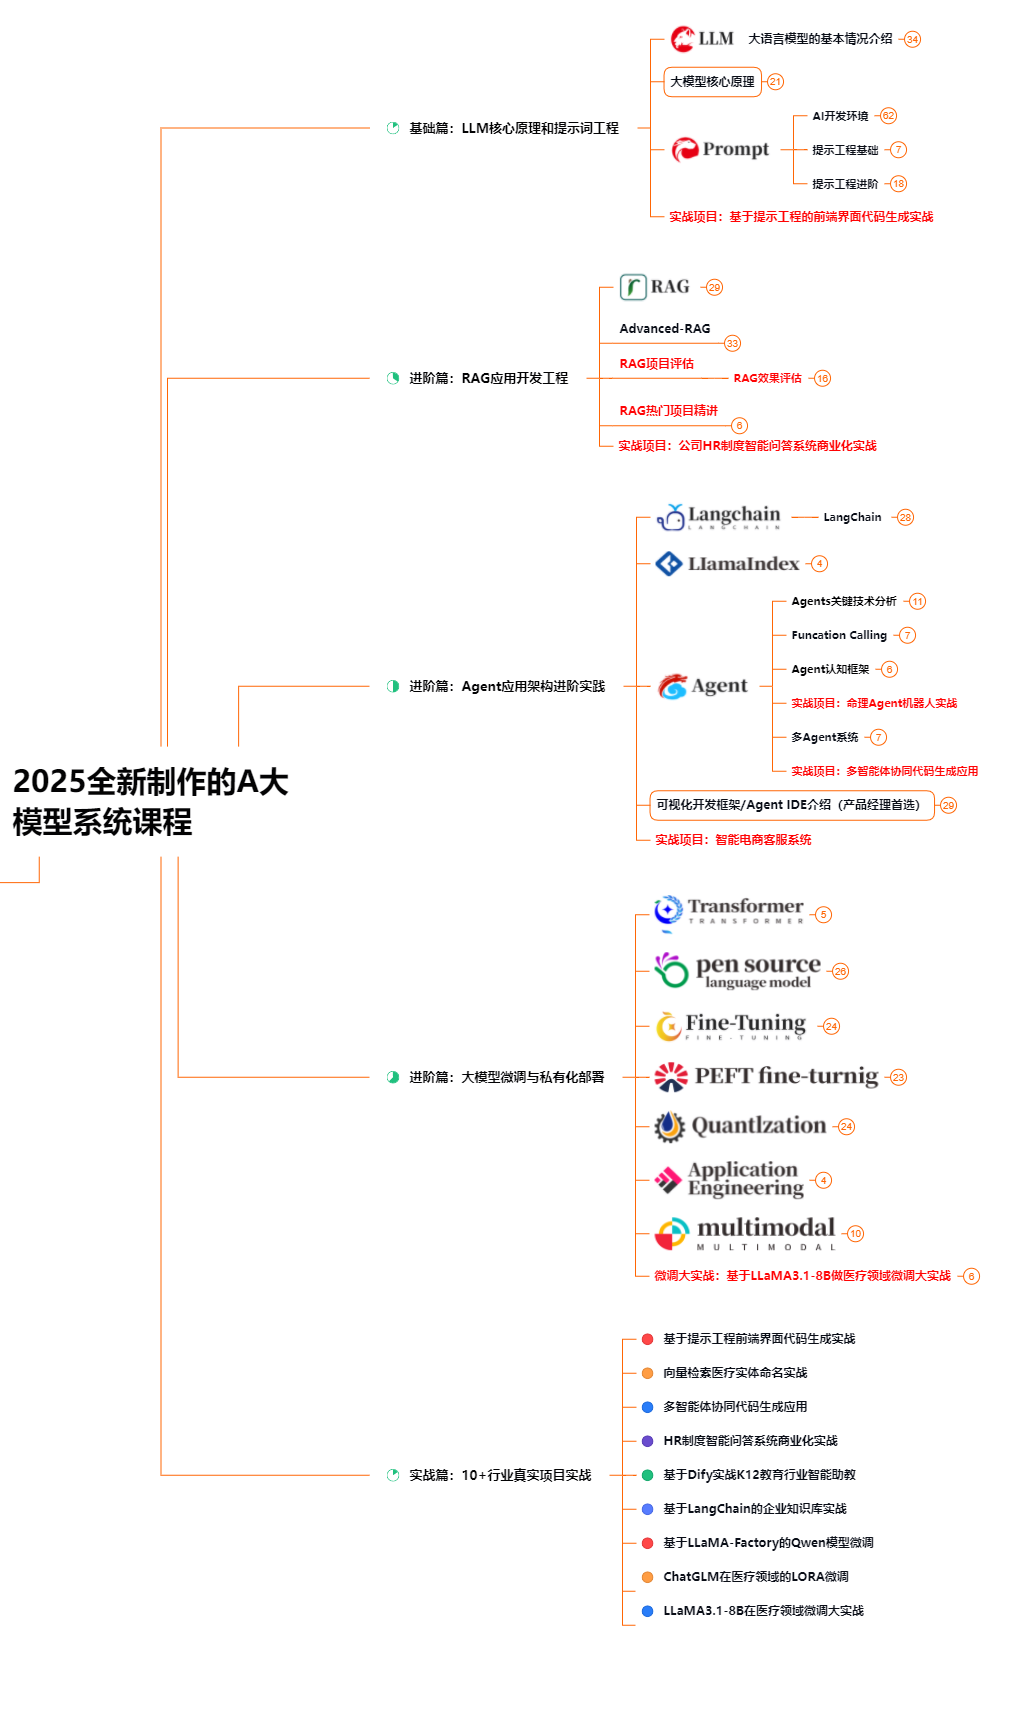
1. 成长路线图&学习规划
要学习一门新的技术,作为新手一定要先学习成长路线图,方向不对,努力白费。这里,我们为新手和想要进一步提升的专业人士准备了一份详细的学习成长路线图和规划。
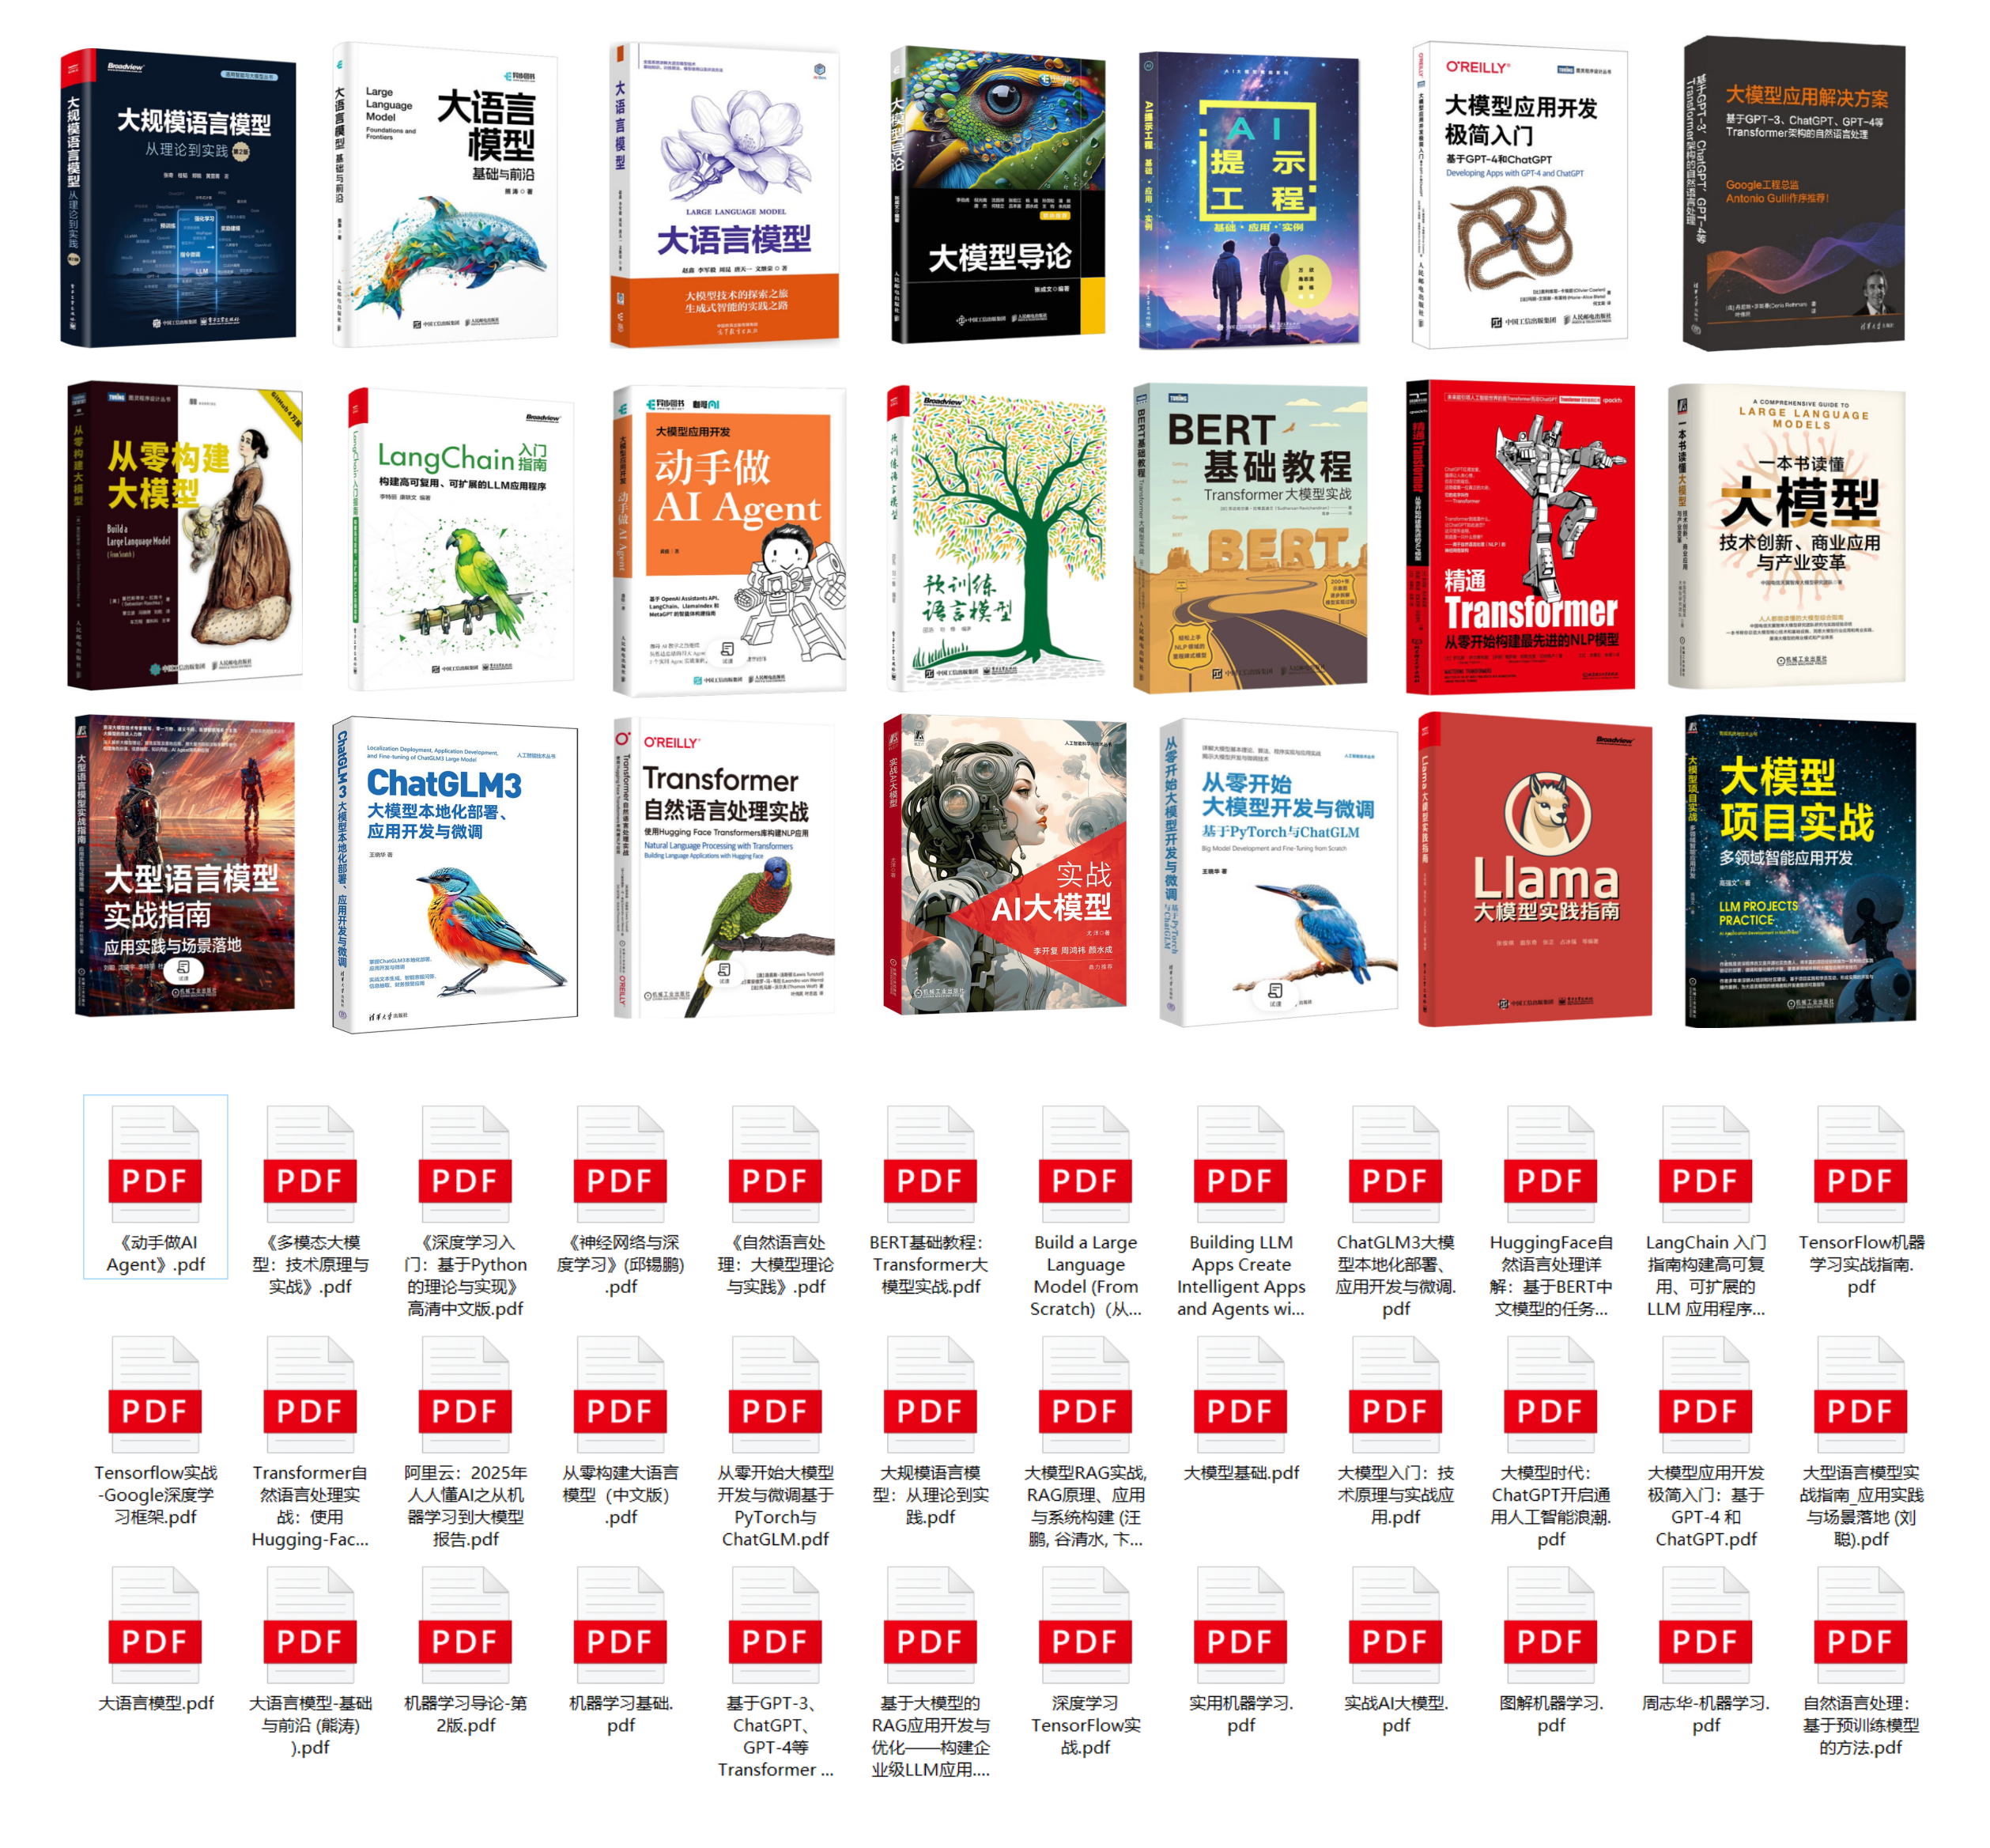
2. 大模型经典PDF书籍
书籍和学习文档资料是学习大模型过程中必不可少的,我们精选了一系列深入探讨大模型技术的书籍和学习文档,它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。(书籍含电子版PDF)
3. 大模型视频教程
对于很多自学或者没有基础的同学来说,书籍这些纯文字类的学习教材会觉得比较晦涩难以理解,因此,我们提供了丰富的大模型视频教程,以动态、形象的方式展示技术概念,帮助你更快、更轻松地掌握核心知识。
4. 大模型项目实战
学以致用 ,当你的理论知识积累到一定程度,就需要通过项目实战,在实际操作中检验和巩固你所学到的知识,同时为你找工作和职业发展打下坚实的基础。
5. 大模型行业报告
行业分析主要包括对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。
6. 大模型面试题
面试不仅是技术的较量,更需要充分的准备。
在你已经掌握了大模型技术之后,就需要开始准备面试,我们将提供精心整理的大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。
为什么大家都在学AI大模型?
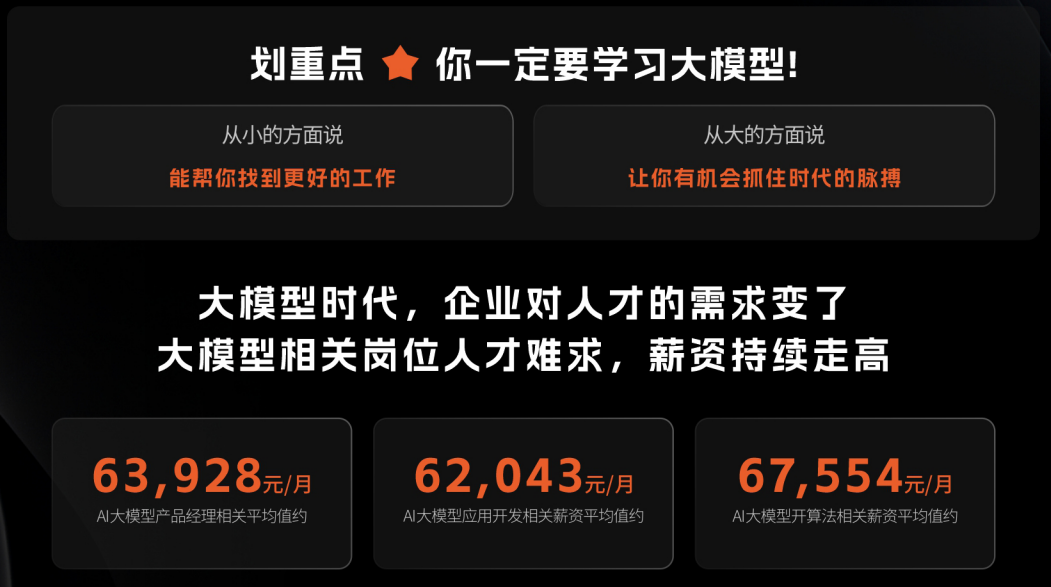
随着AI技术的发展,企业对人才的需求从“单一技术”转向 “AI+行业”双背景。企业对人才的需求从“单一技术”转向 “AI+行业”双背景。金融+AI、制造+AI、医疗+AI等跨界岗位薪资涨幅达30%-50%。
同时很多人面临优化裁员,近期科技巨头英特尔裁员2万人,传统岗位不断缩减,因此转行AI势在必行!
这些资料有用吗?
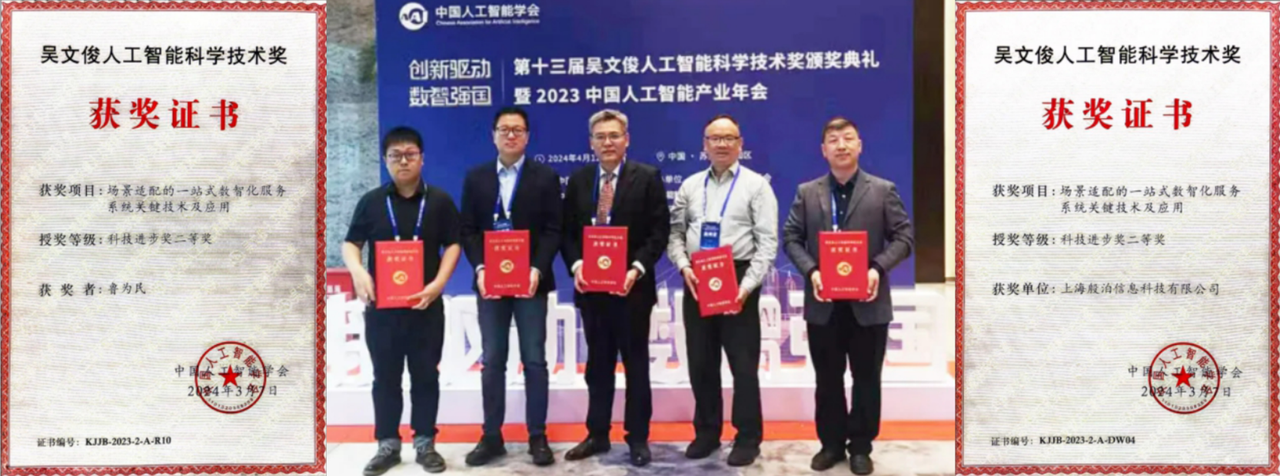
这份资料由我们和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
大模型全套学习资料已整理打包,有需要的小伙伴可以
微信扫描下方CSDN官方认证二维码,免费领取【保证100%免费】

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 24
 0
- 0


 已为社区贡献40条内容

所有评论(0)