大模型微调实战:从 0 到 1 构建列车信息智能问答系统及助教感悟 ---- Datawhale篇
大模型微调实战:从 0 到 1 构建列车信息智能问答系统及助教感悟
引言
大家好,我是本次 Datawhale AI 夏令营大模型微调技术方向的助教。在这个夏天,我们共同聚焦于讯飞「结构化数据的用户意图理解和知识问答挑战赛」,围绕列车时刻表数据展开了一场大模型微调的实践之旅。从跑通 Baseline 到深入理解模型蒸馏,从单字段查询到复杂时间推理,我们见证了大模型在结构化数据理解任务中的强大潜力。本文将分享项目实战中的核心技术要点(尤其聚焦模型蒸馏的落地应用),并谈谈作为技术助教的思考与感悟。
一、项目实战:列车信息问答系统的大模型微调之路
1.1 项目背景与核心目标
在智慧交通场景中,乘客常常需要从复杂的列车时刻表中快速获取精准信息(如检票口位置、停留时间、跨车次关联等)。传统查询方式效率低下,而大模型在表格理解方面的进展为解决这一问题提供了新方案。
本项目的核心目标是:基于列车时刻表结构化数据,通过大模型微调技术,构建一个能理解表格语义、处理时间计算、跨字段推理的智能问答系统。评估指标不仅关注答案准确率(40%),还包括回答响应时长(30%)和信息传达效率(30%),这要求我们在模型性能与效率之间找到平衡。
1.2 核心技术:模型蒸馏在项目中的落地实践
在本次项目中,我们采用模型蒸馏(Model Distillation) 技术构建高质量微调数据,这是提升模型性能的关键。模型蒸馏的核心思想是:利用一个性能强大的 "教师模型"(Teacher Model)指导 "学生模型"(Student Model)学习,使小模型在特定任务上达到接近大模型的效果。
(1)蒸馏框架设计
我们的蒸馏流程分为三个核心步骤,形成 "数据生成 - 模型学习 - 效果验证" 的闭环:
原始表格数据 → 编程生成问题 → 教师模型生成答案 → 构建SFT数据集 → 学生模型微调 → 问答系统
- 教师模型:选择参数量较大、理解能力更强的模型(如 Qwen3-8B),负责基于表格数据生成高质量答案。
- 学生模型:选择参数量适中的模型(如 Qwen1.8B 或 LoRA 微调的 Qwen3-8B),通过学习教师模型的输出提升自身在列车问答任务上的表现。
- 蒸馏目标:让学生模型学会 "如何从表格中提取信息并生成准确答案",同时保持更快的推理速度(契合赛事对响应时长的要求)。
(2)为什么选择模型蒸馏?
在项目初期,我们尝试过两种数据生成方案:
- 方案 1:人工标注问答对(准确率高但成本极高,200 条数据需数人天);
- 方案 2:让单一模型同时生成问题和答案(效率高但易出现逻辑错误,如 "问题问检票口,答案答始发站")。
模型蒸馏完美平衡了效率与质量:
- 问题由编程生成(保证逻辑正确,如 "K123 次列车的检票口是?" 必然对应表格中的 "检票口" 字段);
- 答案由教师模型生成(利用大模型的理解能力处理复杂推理,如时间计算、多字段关联);
- 学生模型通过学习这些高质量问答对,快速掌握任务规律。
(3)蒸馏过程的关键实现
① 问题生成:确保 "问得对"
以下是我实现的问题生成代码,覆盖了单字段查询、多条件筛选和时间推理等场景,确保问题与表格数据的强相关性:
def generate_questions(row: dict):
    """
    基于单行列车数据生成多样化问题
    row: 字典格式的列车信息(包含车次、始发站、终到站等字段)
    return: 问题列表
    """
    questions = []
    # 1. 单字段查询(基础样本)
    questions.append(f"{row['车次']}次列车的始发站是哪里?")
    questions.append(f"{row['车次']}次列车在哪个检票口检票?")
    questions.append(f"{row['车次']}次列车的发车时间是几点?")

    # 2. 多条件查询(中等难度样本)
    questions.append(f"{row['车次']}次列车需要在哪个候车厅候车?对应的站台是多少?")
    questions.append(f"{row['车次']}次列车从哪个站出发?最终到达哪里?")

    # 3. 时间推理(高难度样本)
    if row['到点'] != '无数据' and row['开点'] != '无数据':
        questions.append(f"{row['车次']}次列车在当前站的停留时长是多久?")
        questions.append(f"如果{row['车次']}次列车晚点30分钟,新的发车时间是几点?")

    return questions

# 测试代码
if __name__ == "__main__":
    # 模拟一行列车数据
    sample_row = {
        "车次": "K4547/6",
        "始发站": "成都西",
        "终到站": "佳木斯",
        "到点": "23:40:00",
        "开点": "00:12:00",
        "候车厅": "综合候乘中心,高架候车区西区",
        "检票口": "1B",
        "站台": "2"
    }
    print("生成的问题示例:")
    for q in generate_questions(sample_row):
        print(f"- {q}")
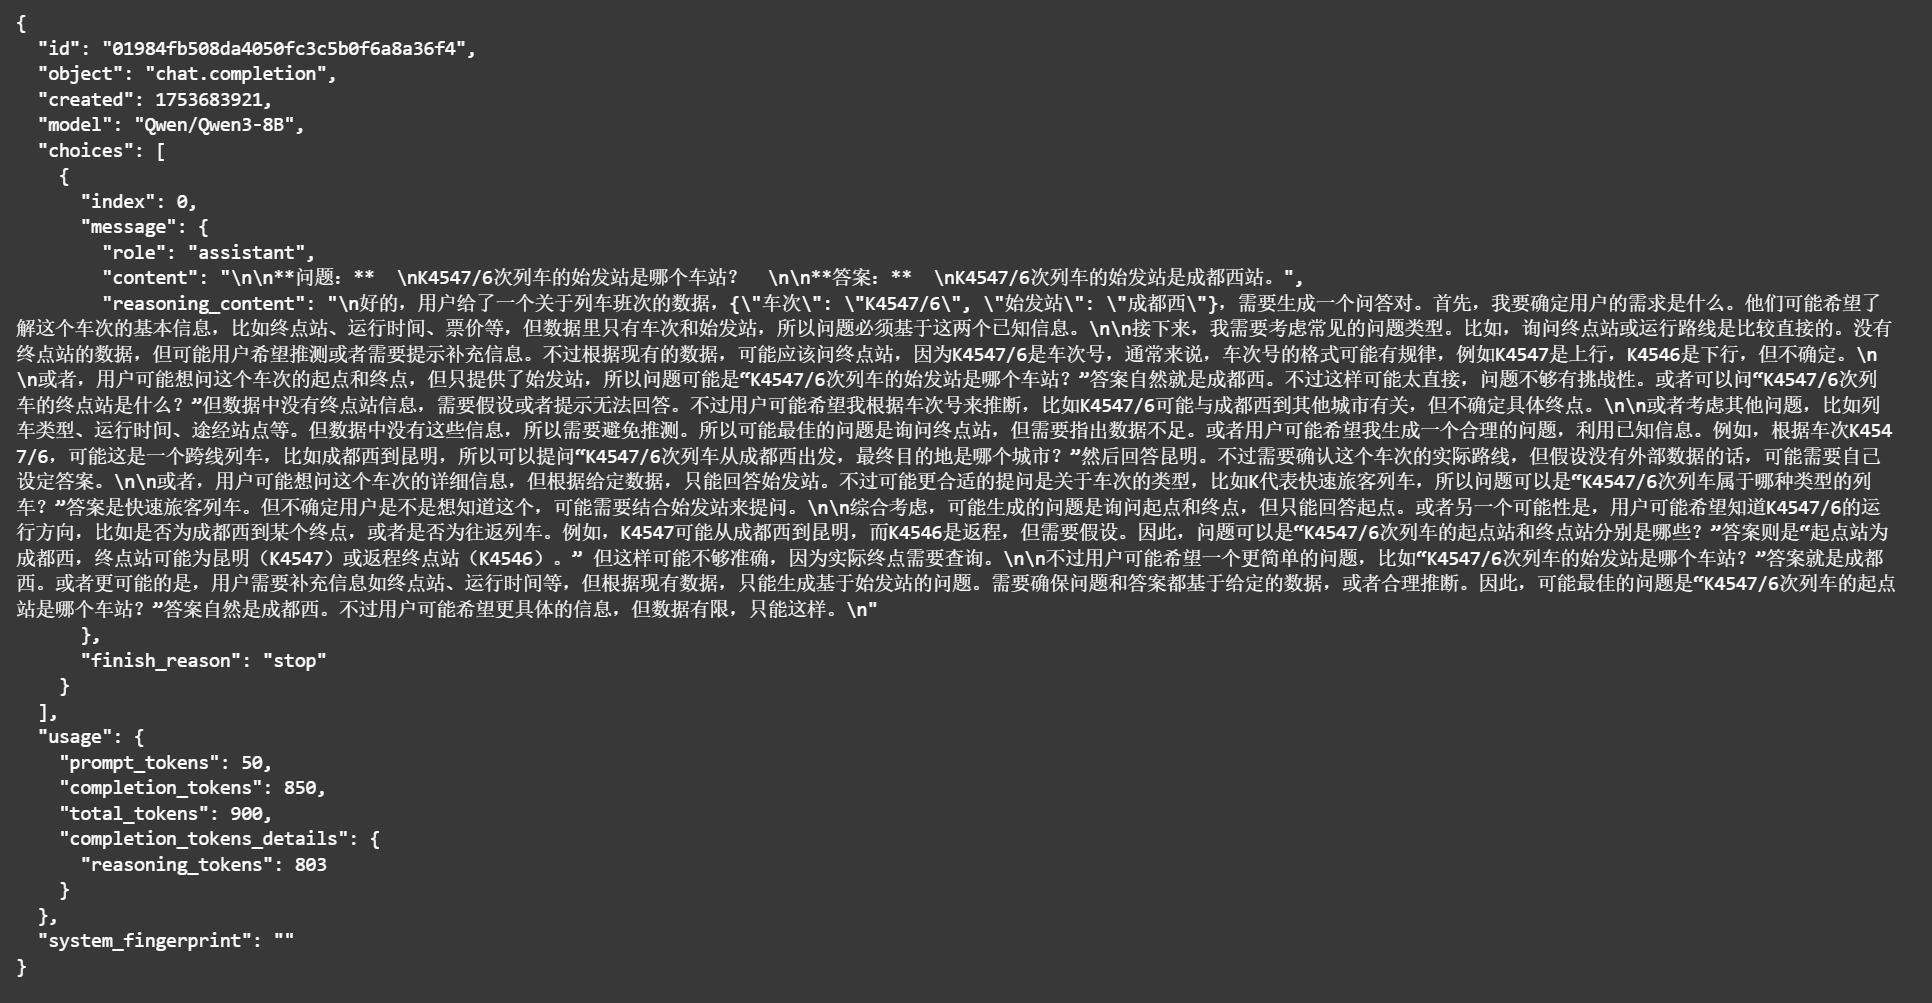
② 教师模型生成答案:确保 "答得准"
调用 Qwen3-8B(免费模型) 作为教师模型,传入表格数据和问题,生成精准答案:
def teacher_model_inference(data: dict, question: str):
    # 格式化表格数据为模型易理解的文本
    data_text = f"列车信息:车次={data['车次']},始发站={data['始发站']},终到站={data['终到站']},到点={data['到点']},开点={data['开点']},候车厅={data['候车厅']},检票口={data['检票口']}"

    # 构建Prompt,明确任务
    prompt = f"""基于以下列车信息,回答问题。要求答案简洁准确,仅包含必要信息。
信息:{data_text}
问题:{question}
答案:"""

    # 调用教师模型API
    response = requests.post(
        url="https://api.siliconflow.cn/v1/chat/completions",
        json={
            "model": "Qwen/Qwen3-8B",
            "messages": [{"role": "user", "content": prompt}]
        },
        headers={"Authorization": "Bearer YOUR_API_KEY"},
        timeout=60
    )

    return response.json()['choices'][0]['message']['content']
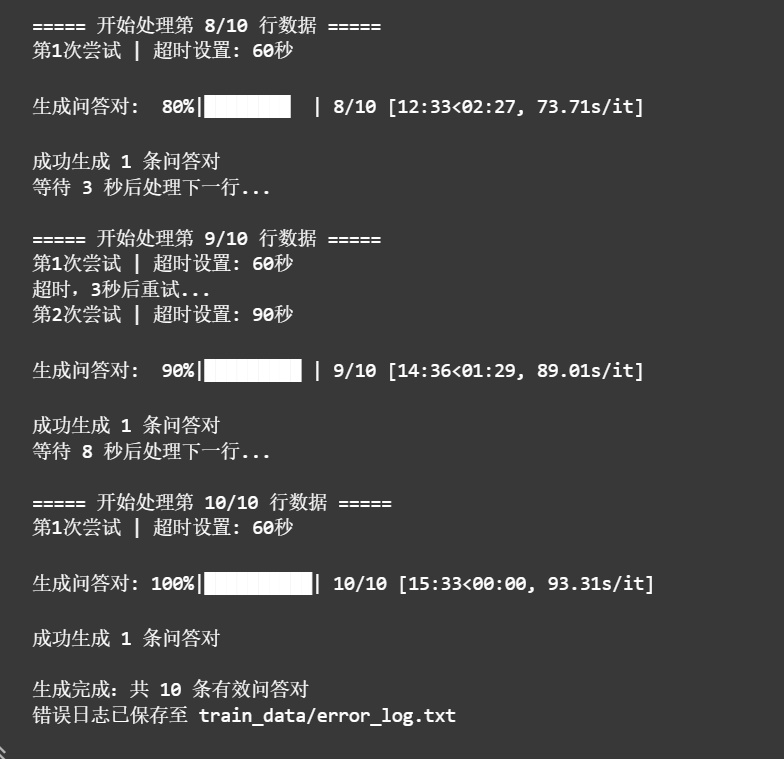
③ 构建 SFT 数据集:蒸馏的 "知识载体"
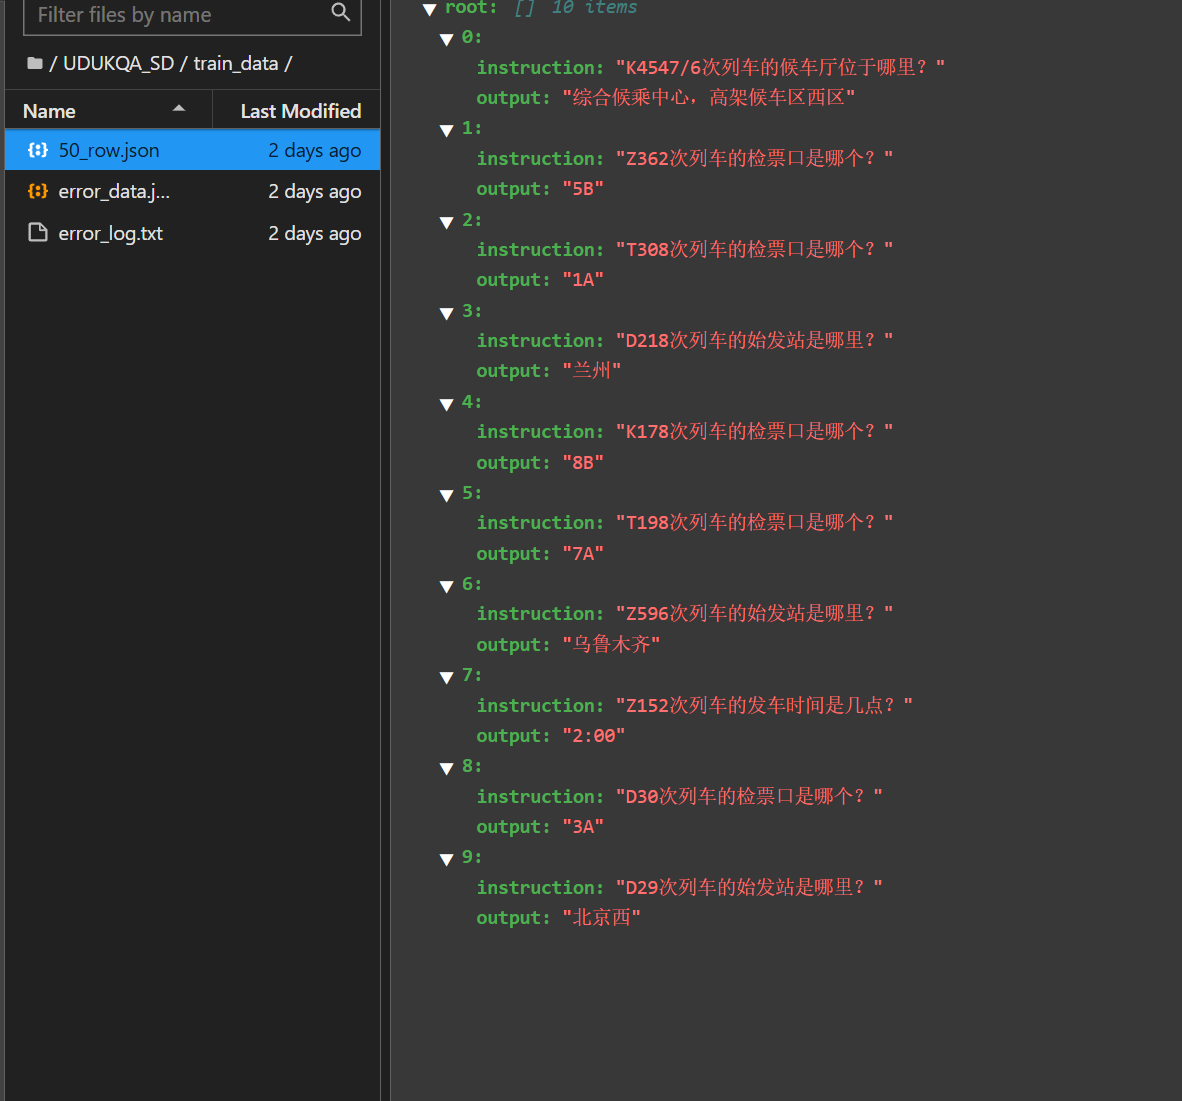
将生成的问题和答案整理为Alpaca格式,作为学生模型的微调数据:
# 示例SFT数据格式
[
    {
        "instruction": "K4547/6次列车在哪个检票口检票?",
        "output": "1B号检票口"
    },
    {
        "instruction": "K4547/6次列车的发车时间是几点?在哪个候车厅候车?",
        "output": "发车时间是00:12,在综合候乘中心,高架候车区西区候车"
    }
]
④ 学生模型微调:知识迁移
在讯飞星辰 MaaS 平台选择 Qwen3-8B 模型,采用 LoRA(低秩适配)技术进行微调:
- LoRA 优势:仅训练少量参数(低秩矩阵),既能让学生模型学习教师知识,又能保持推理速度;
- 关键参数:秩(rank)设为 16,alpha 设为 32,平衡微调效果与参数量;
- 训练策略:学习率 5e-5, epochs=3,避免过拟合(因数据集中问题模板存在重复模式)。
1.3 进阶优化:提升蒸馏效果的实战技巧
(1)硬蒸馏 vs 软蒸馏
在基础方案中,我们采用 "硬蒸馏"(学生模型学习教师模型的最终答案)。为提升复杂问题处理能力,可引入 "软蒸馏":
- 让教师模型输出答案的概率分布(而非仅最终答案);
- 学生模型学习这种概率分布,捕捉更丰富的推理信息(如 "停留时长 3 分钟" 比 "5 分钟" 的概率高)。
(2)数据增强:扩大蒸馏样本多样性
- 反向问题生成:从答案反推问题(如已知 "检票口 1B",生成 "哪个车次在 1B 检票口检票?");
- 噪声注入:在问题中加入同义表述(如 "候车地点" 与 "在哪里候车"),提升模型鲁棒性。
(3)多教师蒸馏
当单一教师模型在某些问题上表现不佳时(如复杂时间计算),可引入多个教师模型:
- 用 Qwen3-8B 处理文本关联问题;
- 用 CodeLlama 处理时间计算问题;
- 学生模型综合学习多个教师的输出,进一步提升准确率。
1.4 个人真实模型优化代码复现
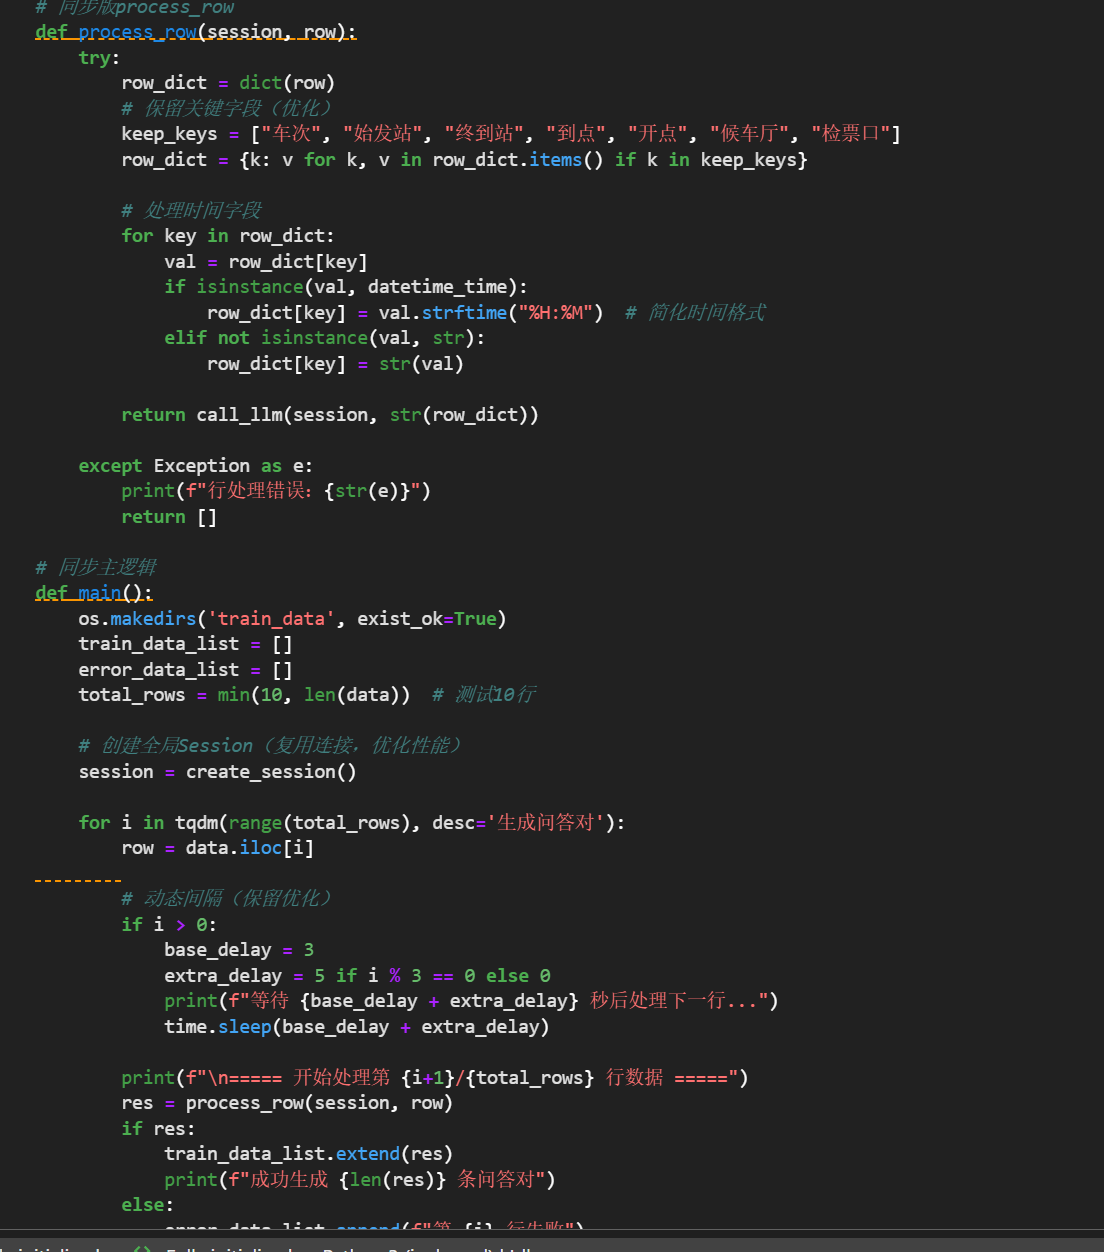
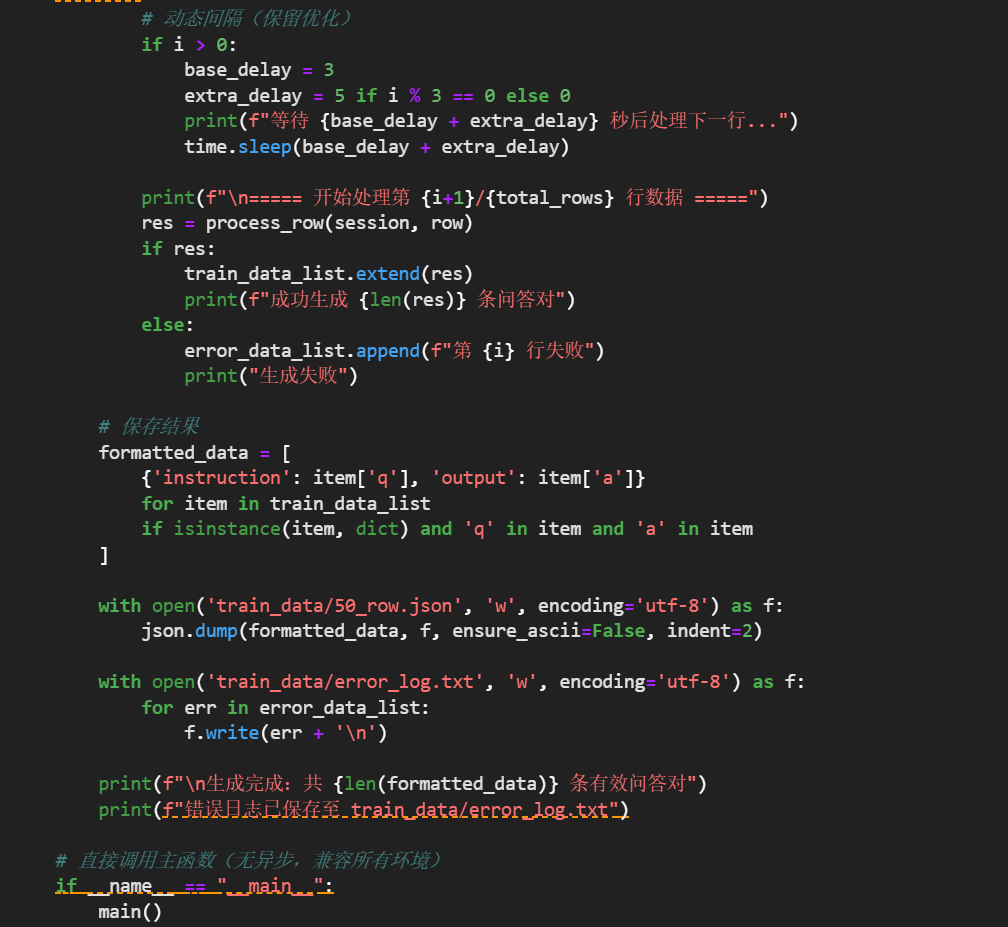
程序运行成功固然很好,但很多时候,程序出错或者运行时长过长等一系列问题时,作为开发者的我们需要第一时间查到问题所在,所以我建议代码提升不仅仅模型上面的优化,也应该把错误日志也自动记录下来!
二、技术助教感悟
作为本次夏令营的技术助教,在与学员们共同学习和实践的过程中,我对模型蒸馏和大模型微调有了更深刻的理解:
1. 模型蒸馏不是 "银弹",数据质量是前提
很多学员初期遇到 "微调后模型效果差" 的问题,排查发现并非蒸馏流程错误,而是数据集中存在大量 "问题 - 答案不匹配" 的样本(如教师模型因 Prompt 模糊生成了错误答案)。这让我意识到:蒸馏的效果上限由数据质量决定。
在指导学员时,我会强调 "数据清洗三步法":
- 抽样验证:随机检查 10% 的样本,确保问题与答案对应;
- 规则过滤:用正则表达式剔除明显错误(如答案含 "无数据" 但问题字段实际有值);
- 难度分层:按 "简单 - 中等 - 复杂" 标记样本,确保各难度比例合理(如 7:2:1)。
2. 小模型也能 "打败" 大模型:任务适配的重要性
有学员困惑:"为什么参数量更小的 Qwen1.8B(经蒸馏)比未微调的 Qwen7B 表现更好?" 这恰恰体现了蒸馏的价值 ——大模型的通用能力虽强,但在垂直任务上,经专项蒸馏的小模型能更高效地聚焦核心知识。
例如在列车问答中,学生模型只需掌握 "车次 - 检票口 - 时间" 的关联规则,无需大模型的通用知识(如写诗、代码生成)。这种 "专才" 优势使其在响应速度和准确率上双优。
3. 从 "调参" 到 "理解任务本质" 的思维转变
初期学员常陷入 "调参陷阱":反复调整 LoRA 的秩和学习率,却忽视对任务的理解。其实,列车问答的核心是 "字段映射 + 逻辑推理":
- 字段映射:问题中的 "检票口" 对应表格的 "检票口" 字段;
- 逻辑推理:"停留时长 = 开点 - 到点"(需处理跨天情况)。
当学员开始主动设计覆盖这些逻辑的问题模板时,模型效果往往能大幅提升 —— 这印证了 "任务分析比参数调优更重要"。
4. 技术社区的互助加速学习
夏令营中,学员们自发分享了许多实战经验:
- 有学员发现 "将时间格式统一为 HH:MM 能减少教师模型的计算错误";
- 有人提出 "用 Pandas 预计算停留时长,直接作为答案(替代教师模型生成)",解决了时间推理准确率低的问题。
这种集体智慧让蒸馏方案不断迭代,也让我深刻体会到 Datawhale"以学习者为中心" 的价值 ——技术学习从来不是孤军奋战,而是一群人的相互启发。
三、总结与展望
本次项目中,模型蒸馏技术展现了强大的落地价值:通过 "编程生成问题 + 教师模型生成答案" 的模式,我们高效构建了高质量微调数据,让学生模型在列车问答任务上达到了接近大模型的性能,同时保持更快的响应速度。
作为技术助教,我最大的收获是看到学员们从 "只会跑代码" 到 "能设计蒸馏方案" 的成长。未来,模型蒸馏在垂直领域的应用将更加广泛 —— 医疗、金融、教育等行业都可通过类似思路,让大模型知识赋能场景化任务。
最后,感谢 Datawhale 提供的实践平台,也祝愿各位学员在大模型技术的探索中持续精进。记住:最好的学习方式是动手实践,最大的进步来自解决真实问题。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 35
 0
- 0


 已为社区贡献3条内容

所有评论(0)