论文学习笔记——弱监督语义分割(Learning Integral Objects with Intra-Class Discriminator for Weakly-Supervised Sema)
基础概念
-
Feature manifold(特征流形)
流形是一种空间,一个流形好比是一个 m 维的数据在 d 维的空间上被扭曲的结果。其中(m > d)(一般维度压缩的方法中都会提到这个概念)

上图中每张图片为同一张人脸的 64×64 的灰度图,如果按照列(或行)拼起来,就可以得到一个 4096 维的向量,这样一来,每一张图片就可以看成是 4096 维欧氏空间中的一个点。很显然,并不是 4096 维空间中任意一个点都可以对应于一张人脸图片的,这就类似于球面的情形,我们可以假定所有可以是人脸的 4096 维向量实际上分布在一个 d 维 (d < 4096) 的子空间中。而特定到 Isomap 的人脸这个例子,实际上我们知道所有的 698 张图片是拍自同一个人脸(模型),不过是在不同的 pose 和光照下拍摄的,如果把 pose (上下和左右)当作两个自由度(也就是坐标轴),而光照当作一个自由度,那么这些图片实际只有三个自由度,换句话说,存在一个类似于球面一样的参数方程(当然,解析式是没法写出来的),给定一组参数(也就是上下、左右的 pose 和光照这三个值),就可以生成出对应的 4096 维的坐标来。换句话说,这是一个嵌入在 4096 维欧氏空间中的一个 3 维流形。 实际上,上面的那张图就是 Isomap 将这个数据集从 4096 维映射到 3 维空间中,并显示了其中 2 维的结果,图中的小点就是每个人脸在这个二维空间中对应的坐标位置,其中一些标红圈的点被选出来,并在旁边画上了该点对应的原始图片,可以很直观地看出这两个维度正好对应了 pose 的两个自由度平滑变化的结果。 就我目前所知,把流形引入到机器学习领域来主要有两种用途:一是将原来在欧氏空间中适用的算法加以改造,使得它工作在流形上,直接或间接地对流形的结构和性质加以利用;二是直接分析流形的结构,并试图将其映射到一个欧氏空间中,再在得到的结果上运用以前适用于欧氏空间的算法来进行学习。 这里 Isomap 正巧是一个非常典型的例子,因为它实际上是通过“改造一种原本适用于欧氏空间的算法”,达到了“将流形映射到一个欧氏空间”的目的。Isomap 所改造的这个方法叫做 Multidimensional Scaling (MDS) ,MDS 是一种降维方法,它的目的就是使得降维之后的点两两之间的距离尽量不变(也就是和在原是空间中对应的两个点之间的距离要差不多)。只是 MDS 是针对欧氏空间设计的,对于距离的计算也是使用欧氏距离来完成的。如果数据分布在一个流形上的话,欧氏距离就不适用了。
CAM 与 ICD 的不同
-
CAM(Class activation maps)
- 在此过程中,主要标准是类别间的区分。局部区域中较容易识别的前景物体像素主导了激活,例如人的脸部或汽车的车轮。其他前景像素则无法与背景区分开
- 该模型的最终目标是学习类别间识别的边界。但是,要获得WSSS的整体对象蒙版,我们需要精确地区分像素是属于前景对象还是属于背景。因为前景像素和背景像素位于同一图像中,所以这种鉴别主要在同一图像级类别内进行,即,类别内鉴别
- 通常,如图所示,CAM所学习的类间边界不符合我们对前景和背景之间的类内区分的要求。因此,仅通过对CAM分数进行阈值化就很难获得完整的目标蒙版
- CAM做到的核心内容为分离不同类物体,只能给出目标对象的稀疏和不完整的估计,因此难以平衡前景的召回率和背景的假阳性率
-
ICD(Intra-Class Discriminator)
- 为解决上述问题,文章引入了一个类内的分类器,目的是在同类下,能够清楚分出前景以及后景
- 因此ICD相比CAM更适合于WSSS类问题
-
为提升WSSS问题的精度需要对上述模型进行融合使用,通过下图可以清楚的看出两者的关系

-
ICD的贡献
- 文章在将CAM应用于WSSS时发现了边界不匹配问题,即图像级类间识别与所需像素级类内分割之间的差距
- 文章提出了一种有效的端到端类内鉴别器(ICD)方法,通过学习类内边界来分离前景对象和背景来解决此问题
- 文章进行了广泛的实验,以分析文章提出的ICD方法的有效性。 所提出的模型实现了基于图像标签的WSSS的最新性能
ICD
-
模型框架

如图所示,本文提出一个端到端的模型框架,存在两个分支,一个为CAM(CAM只在部分前景区域激活,但突出显示的区域集中在前景上),另一个就是本文提出的ICD模型。框架综合CAM给出的得分以及ICD给出前景和后景的得分,计算出最终的结果
-
ICD分支
ICD分支中存在两条路径:-
Bottom-Up Estimation(自底向上的估计)
ICD的核心思想是基于特征流形将像素分为前景和背景组。我们通过学习每个类 c c c的方向向量 w c w_c wc来解决这个问题。假设 X = { X i } i = 1 N X=\left \{ X_i \right \}^N_{i=1} X={Xi}i=1N为所有输入图像的合集, f i f_i fi为对应输入图像 X i X_i Xi的特征图,其大小为 H × W H \times W H×W,通过学习得到的方向向量为:
L b u ( X ) = − 1 N H W ∑ i = 1 N ∑ k = 1 H W ∑ c = 1 C y i , c ( w c T f i , k ) 2 (1) L_{bu}(X) = - \frac{1}{NHW}\sum^N_{i=1}\sum^{HW}_{k=1}\sum^C_{c=1}y_{i,c}(w^T_cf_{i,k})^2 \tag{1} Lbu(X)=−NHW1i=1∑Nk=1∑HWc=1∑Cyi,c(wcTfi,k)2(1)
w c = w c ^ ∥ w c ^ ∥ 2 (2) w_c = \frac{\hat{w_c}}{\|\hat{w_c}\|_2} \tag{2} wc=∥wc^∥2wc^(2)
其中 f i , k f_{i,k} fi,k为特征图 f i f_i fi中第 k k k个像素点, y i , c y_{i,c} yi,c是一个二进制标签(当第 c c c个标签存在于图像中时,为1;反之为0)。为了防止琐碎的无穷大解, w c w_c wc受到L2-归一化的约束,如方程式2中所示。优化公式1可以促进 w c w_c wc将像素特征分为两类。这些特征共享相同的图像级类标签,并且属于第c类的前景或背景。因此,ICD不会像CAM那样陷入难以进行类间分区的问题。由于前景(或背景)像素的特征趋于聚集在一起,并且前景和背景的向量通常不重叠,如图1所示,方向矢量学会将其分为两类,分别是前景与背景。因此,很自然地采用在定向向量上特征投影的符号(正负),来区分前景和后景。为此,我们通过以下方式计算每个像素的得分:
S ^ i , k , c = w c T f i , k (3) \hat{S}_{i,k,c} = w_c^Tf_{i,k} \tag{3} S^i,k,c=wcTfi,k(3)
其中, S ^ i , k , c \hat{S}_{i,k,c} S^i,k,c的绝对值可以看作为自信度,符号(正负)表示像素属于前景还是背景。注意,到目前为止,暂时还不知道是正号代表前景,还是负号代表前景,反之亦然。但我们注意到,虽然CAM只在部分前景区域激活,但突出显示的区域集中在前景上。(这一属性被前人们论文提出的方法的高效性广泛的证明了,因为它们将CAM中的高分区域作为前景种子。)因此,我们可以利用这个属性来识别这两个组中的哪一个是前景。为此,对于图像中呈现的每个类,我们首先根据公式3中的符号将像素分成两组。例如, I i , c p o s = { k ∣ S ^ i , k , c > 0 , y i , c = 1 } I^{pos}_{i,c} = \left \{k|\hat{S}_{i,k,c} > 0,y_{i,c} = 1 \right \} Ii,cpos={k∣S^i,k,c>0,yi,c=1}和 I i , c n e g = { k ∣ S ^ i , k , c < 0 , y i , c = 1 } I^{neg}_{i,c} = \left \{k|\hat{S}_{i,k,c} < 0,y_{i,c} = 1 \right \} Ii,cneg={k∣S^i,k,c<0,yi,c=1}。定义 M i , k , c M_{i,k,c} Mi,k,c为对应的CAM得分,我们计算这两组CAM得分的均值:
M ˉ c g = 1 N ∣ I i , c g ∣ ∑ i = 1 N ∑ k ∈ I i , c g M i , k , c , g ∈ { p o s , n e g } (4) \bar{M}^g_c=\frac{1}{N|I^g_{i,c}|}\sum^N_{i=1}\sum_{k\in I^g_{i,c}} M_{i,k,c}, \quad g\in\{pos,neg\}\tag{4} Mˉcg=N∣Ii,cg∣1i=1∑Nk∈Ii,cg∑Mi,k,c,g∈{pos,neg}(4)
其中 ∣ ⋅ ∣ |\cdot| ∣⋅∣表示集合中元素的数量。然后比较 M ˉ c p o s \bar{M}^{pos}_c Mˉcpos和 M ˉ c n e g \bar{M}^{neg}_c Mˉcneg的值,如果后者也就是 M ˉ c n e g \bar{M}^{neg}_c Mˉcneg的值更大,则反转ICD的得分。因此在ICD的得分 S ^ i , k , c \hat{S}_{i,k,c} S^i,k,c中,正值永远表示前景。
S ^ i , k , c = S ^ i , k , c ⋅ sign ( M ˉ c p o s − M ˉ c n e g ) (5) \hat{S}_{i,k,c} = \hat{S}_{i,k,c} \cdot \text{sign}(\bar{M}^{pos}_c - \bar{M}^{neg}_c) \tag{5} S^i,k,c=S^i,k,c⋅sign(Mˉcpos−Mˉcneg)(5)
其中, sign ( ⋅ ) \text{sign}(\cdot) sign(⋅)是一个符号函数,将正值映射为 1 1 1,负值映射为 − 1 -1 −1。出于效率方面的考虑,我们将上述步骤作为网络中的一个模块来进行实施,以便可以在线调整ICD分数的符号。 我们通过公式4,来计算本地平均CAM分数。 在每个小型批次中,并采用步长为0.9的移动平均策略来更新全局平均CAM分数。 然后根据公式5来进行全局CAM分数符号翻转。
-
Top-Down Adaptation(自上而下的适应)
-
首先,通过对每个超像素中的ICD分数 S i , k , c S_{i,k,c} Si,k,c取平均值,从而得到精炼的ICD分数 S i , k , c ′ S'_{i,k,c} Si,k,c′。
-
上述步骤有助于恢复通常在下采样过程中丢失的物体边界信息。 随后根据改进的ICD分数生成二进制掩码 B i , k , c B_{i,k,c} Bi,k,c:
B i , k , c = Π ( S i , k , c ′ > 0 ) , k ∈ { 1 , … , H W } (6) B_{i,k,c} = \Pi(S'_{i,k,c}>0),\quad k\in\{1,\dotsc,HW\} \tag{6} Bi,k,c=Π(Si,k,c′>0),k∈{1,…,HW}(6)
其中, Π ( ⋅ ) \Pi(\cdot) Π(⋅)为指针函数,当状态为True时为1,反之为0。 -
最后,我们训练了一个新的分支来拟合二进制掩码,并得出了新的ICD分数 S i , k , c ′ ′ S''_{i,k,c} Si,k,c′′,并通过极大似然估计来构建损失函数:
L t d ( X ) = − 1 N H W ∑ i = 1 N ∑ k = 1 H W ∑ c = 1 C y i , c ( B i , k , c log σ ( S i , k , c ′ ′ ) ) + ( 1 − B i , k , c ) log ( 1 − σ ( S i , k , c ′ ′ ) ) (7) L_{td}(X)=-\frac{1}{NHW}\sum^N_{i=1}\sum^{HW}_{k=1}\sum^C_{c=1}y_{i,c}(B_{i,k,c}\log \sigma(S''_{i,k,c}))+(1-B_{i,k,c})\log(1-\sigma(S''_{i,k,c})) \tag{7} Ltd(X)=−NHW1i=1∑Nk=1∑HWc=1∑Cyi,c(Bi,k,clogσ(Si,k,c′′))+(1−Bi,k,c)log(1−σ(Si,k,c′′))(7)
其中, σ ( ⋅ ) \sigma(\cdot) σ(⋅)为 s i g m o i d sigmoid sigmoid函数, S i , k , c ′ ′ S''_{i,k,c} Si,k,c′′为分支的预测值,也是最后生成遮罩的最终ICD得分。
-
-
-
损失函数
整个ICD框架是和CAM一起训练的。将 L c a m ( X ) L_{cam}(X) Lcam(X)表示为CAM的多类别Sigmoid损失函数,总的损失函数为:
L a l l ( X ) = L c a m ( X ) + L b u ( X ) + L t d ( X ) (8) L_{all}(X)= L_{cam}(X)+L_{bu}(X)+L_{td}(X)\tag{8} Lall(X)=Lcam(X)+Lbu(X)+Ltd(X)(8)
其中论文对上述 L b u ( X ) L_{bu}(X) Lbu(X)和 L t d ( X ) L_{td}(X) Ltd(X)两个损失函数提出了两个变体(改进方案):- 使用
L
1
L1
L1正则化(将原先的平方改为绝对值)来学习
w
c
w_c
wc:
L a b s ( X ) = = − 1 N H W ∑ i = 1 N ∑ k = 1 H W ∑ c = 1 C y i , c ∣ w c T f i , k ∣ (9) L_{abs}(X)== - \frac{1}{NHW}\sum^N_{i=1}\sum^{HW}_{k=1}\sum^C_{c=1}y_{i,c}|w^T_cf_{i,k} |\tag{9} Labs(X)==−NHW1i=1∑Nk=1∑HWc=1∑Cyi,c∣wcTfi,k∣(9) - 另一个直观的选择是将其视为标准的二分类问题,该问题会生成在线伪标签并采用Sigmo损失函数进行训练:
Y i , k , c = Π ( w c T f i , k > 0 ) (10) Y_{i,k,c}=\Pi(w^T_cf_{i,k}>0)\tag{10} Yi,k,c=Π(wcTfi,k>0)(10)
L s i g ( X ) = − 1 N H W ∑ i = 1 N ∑ k = 1 H W ∑ c = 1 C y i , c ( Y i , k , c log σ ( w c T f i , k ) + ( 1 − Y i , k , c ) log ( 1 − σ ( w c T f i , k ) ) ) (11) L_{sig}(X)=-\frac{1}{NHW}\sum^N_{i=1}\sum^{HW}_{k=1}\sum^C_{c=1}y_{i,c}(Y_{i,k,c}\log \sigma(w^T_cf_{i,k})+(1-Y_{i,k,c})\log(1-\sigma(w^T_cf_{i,k}))) \tag{11} Lsig(X)=−NHW1i=1∑Nk=1∑HWc=1∑Cyi,c(Yi,k,clogσ(wcTfi,k)+(1−Yi,k,c)log(1−σ(wcTfi,k)))(11) - 通过分析梯度,论文揭示了这些变体的联系。 这三个变体的梯度可以统一形式表示:
∂ L ( X ) ∂ w c = − ∑ i − 1 N ∑ k = 1 N W ( y i , c sign ( w c T f i , k ) ) ⋅ λ i , k ⋅ f i , k (11) \frac{\partial L(X)}{\partial w_c}=-\sum^N_{i-1}\sum ^{NW}_{k=1}(y_{i,c}\text{sign}(w^T_cf_{i,k}))\cdot \lambda_{i,k}\cdot f_{i,k}\tag{11} ∂wc∂L(X)=−i−1∑Nk=1∑NW(yi,csign(wcTfi,k))⋅λi,k⋅fi,k(11)
其中:
λ i , k = { ∣ w c T f i , k ∣ for L b u 1 for L a b s ∣ σ ( w c T f i , k ) − Y i , k , c ∣ for L s i g (12) \lambda_{i,k}= \begin{cases} |w^T_cf_{i,k} |\qquad\qquad&\text{for}\quad L_{bu}\\ 1 &\text{for}\quad L_{abs}\\ |\sigma(w^T_cf_{i,k})-Y_{i,k,c}|&\text{for}\quad L_{sig}\tag{12} \end{cases} λi,k=⎩⎪⎨⎪⎧∣wcTfi,k∣1∣σ(wcTfi,k)−Yi,k,c∣forLbuforLabsforLsig(12)
公式11和12显示,梯度是特征的加权和。文章最初的方法将更多的权重放在具有较大绝对值投影的特征上,这通常是可靠的,因为它们距离决策边界较远。 相比之下,Sigmoid损失函数法对决策边界附近特征权重的关注度更高,这是次要的,因为这些估计值不可靠。
- 使用
L
1
L1
L1正则化(将原先的平方改为绝对值)来学习
w
c
w_c
wc:
-
训练并生成种子
在训练过后,通过适应的ICD得分 S i , k , c ′ ′ S''_{i,k,c} Si,k,c′′来生成种子。对于只有单类别的图像,我们直接使用ICD分数以阈值为0的方式生成遮罩(pseudo-masks)。对于多类别的图像,将被所有ICD分数标记为背景的像素用作种子背景,而其他像素为前景。如果有一个像素被多个ICD分数标记为前景,我们将采用CAM分数和ICD分数的乘积来确定其类别,因为CAM是专门被类别识别问题优化的。CRF后处理也被采用以进一步完善细节。
效果展示
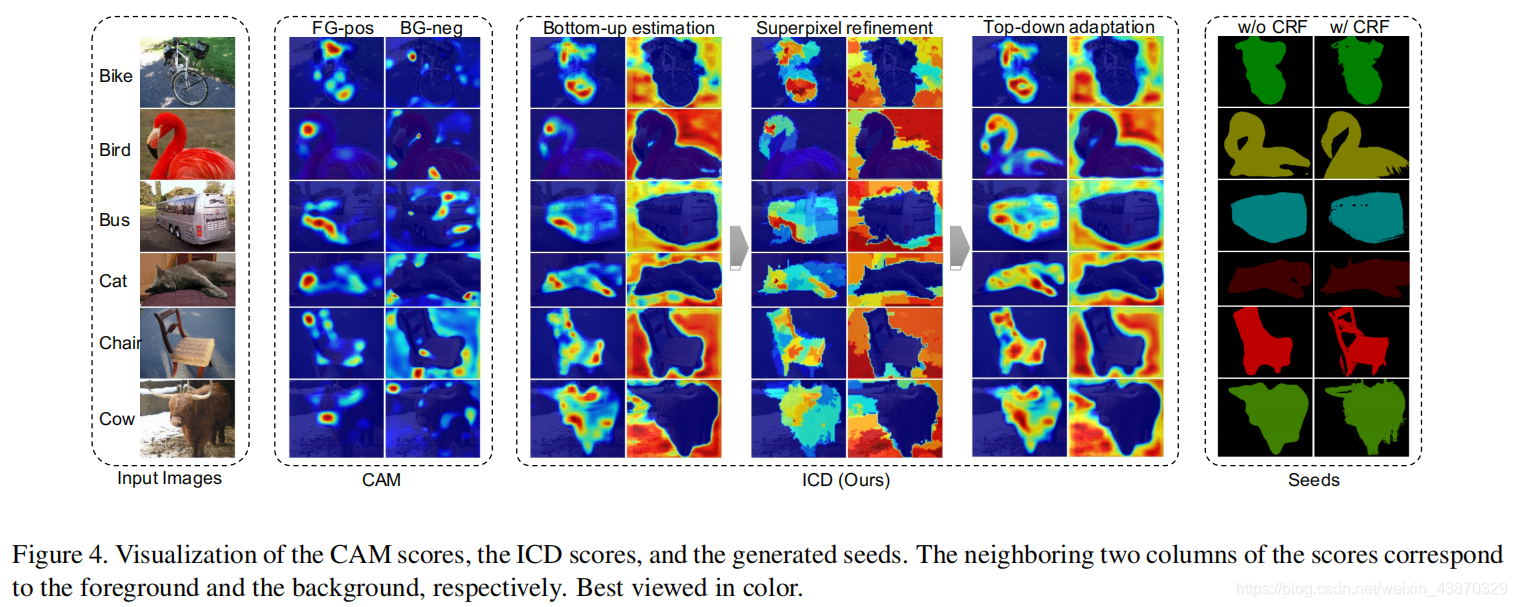
通过上图可以看出,论文提出的方法所展示出的结果效果非常出色。最后使用CRF进行优化后对物体的细节部分有了更高的精度。
论文代码:https://github.com/js-fan/ICD
原文地址:Learning Integral Objects with Intra-Class Discriminator for Weakly-Supervised Semantic Segmentation

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 3
 0
- 0


 已为社区贡献1条内容

所有评论(0)