《强化学习》 DP动态规划
·
奖赏设计
累计奖赏和折扣累计奖赏


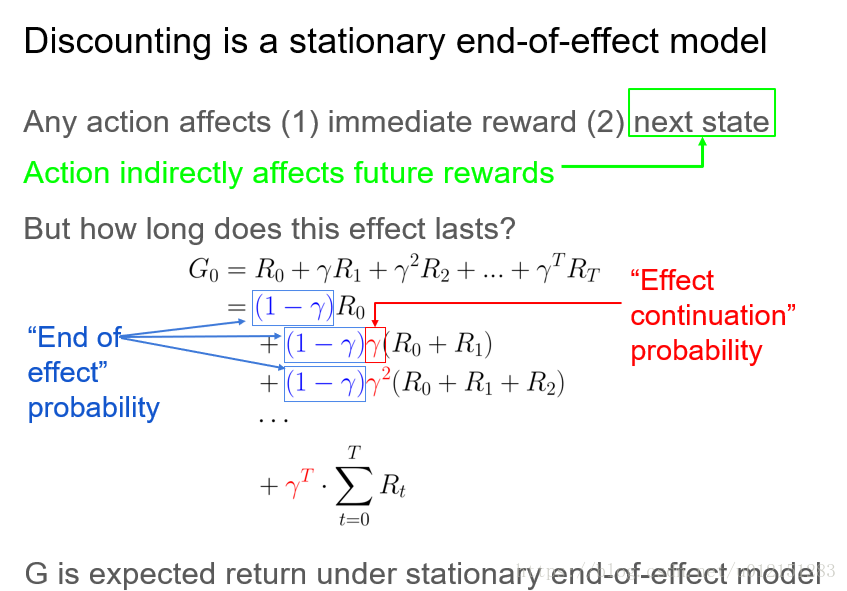
数学上看,折扣奖赏机制可以将累计回报转化为递推的形式:
Gt=Rt+γ(Rt+1+γRt+2+...)=Rt+γGt+1Gt=Rt+γ(Rt+1+γRt+2+...)=Rt+γGt+1
<script type="math/tex; mode=display" id="MathJax-Element-2">\begin{aligned}
G_t &= R_t +\gamma(R_{t+1}+\gamma R_{t+2}+...)\\
&=R_t + \gamma G_{t+1}
\end{aligned}</script>
折扣是一种固定效应模型
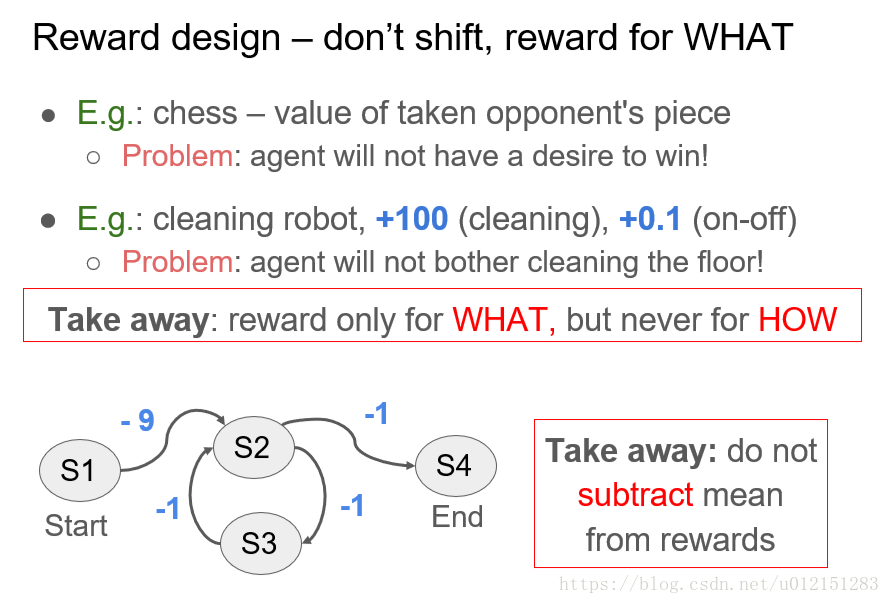
奖赏设计:不要平移,奖励做什么而不是怎么做
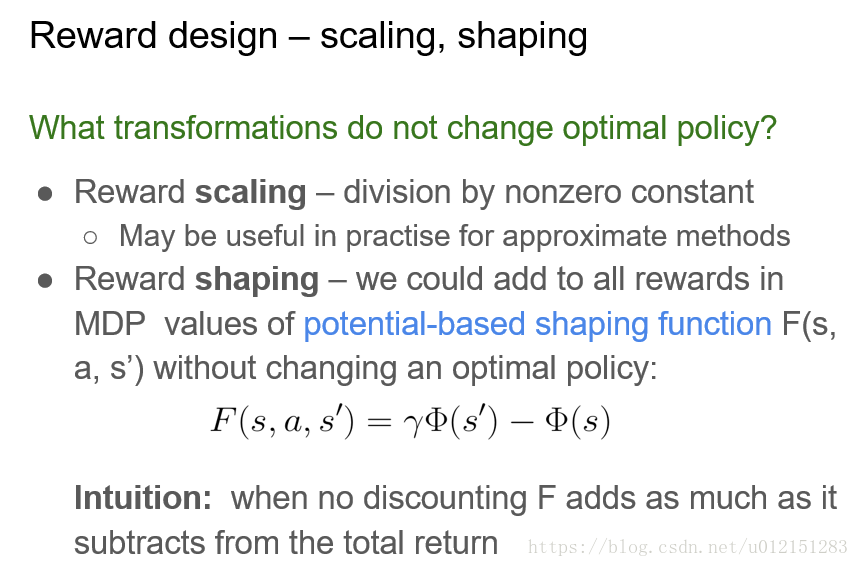
奖赏设计:缩放,塑形
贝尔曼等式
状态值函数
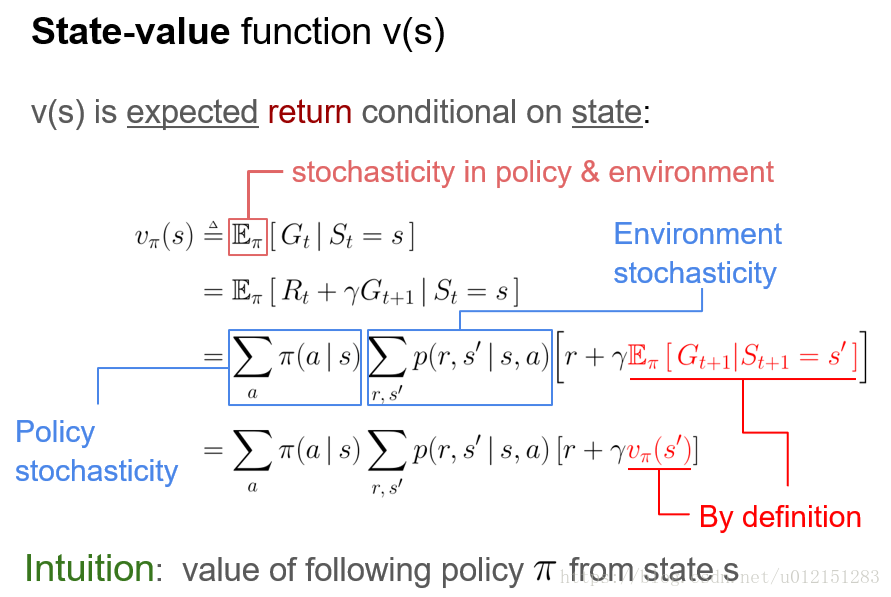
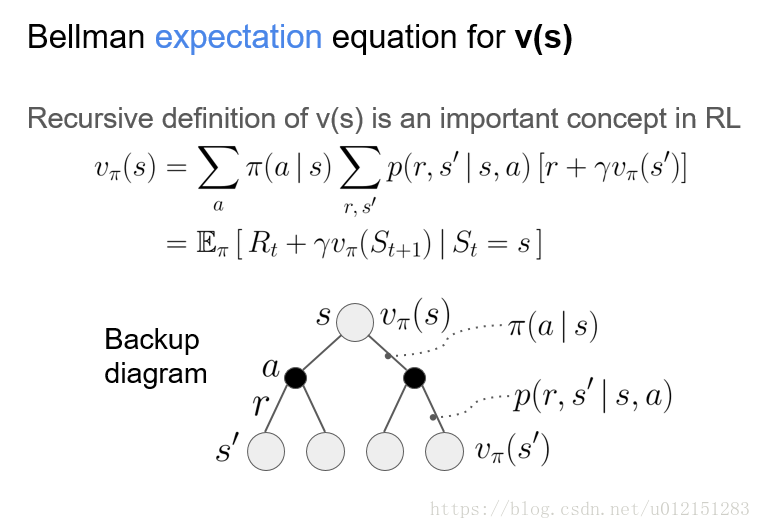
值函数的贝尔曼期望等式
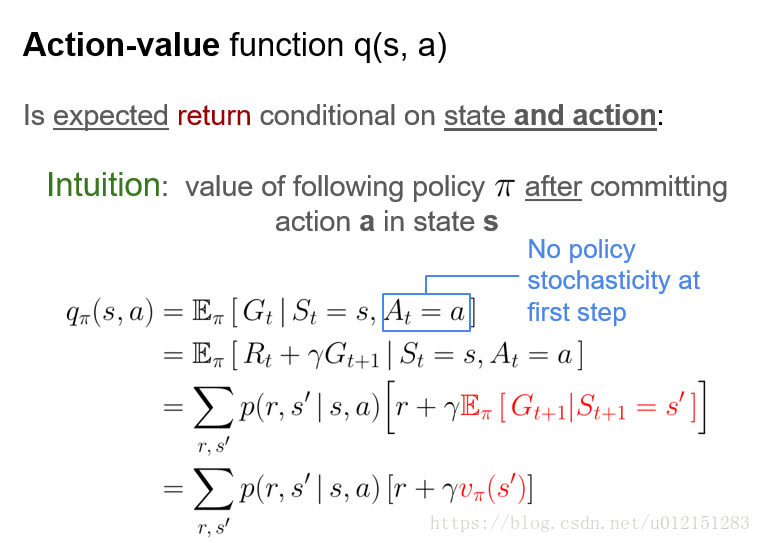
动作值函数
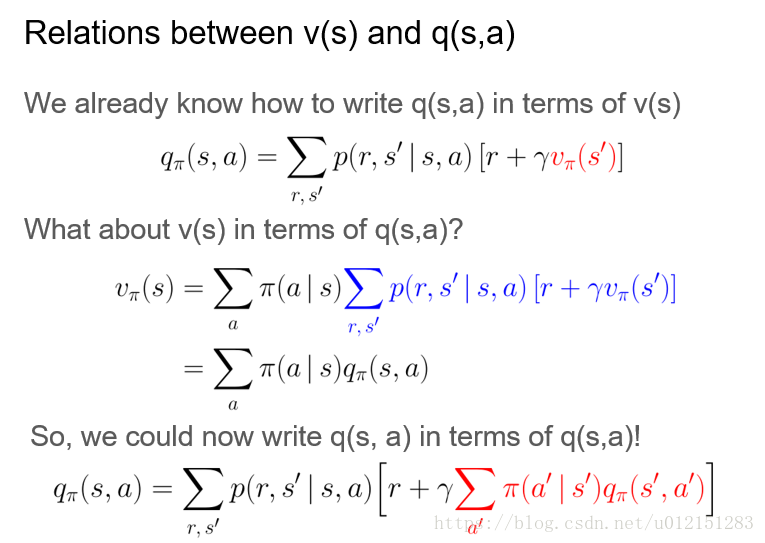
两者关系
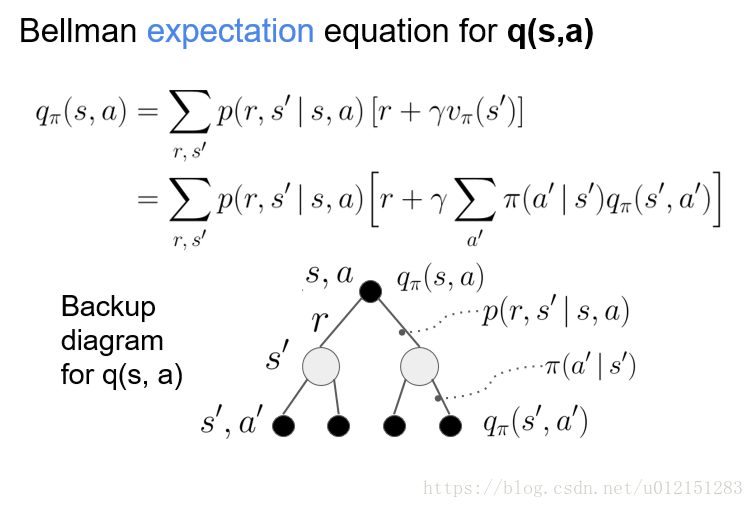
动作值函数的贝尔曼期望等式
衡量策略优劣
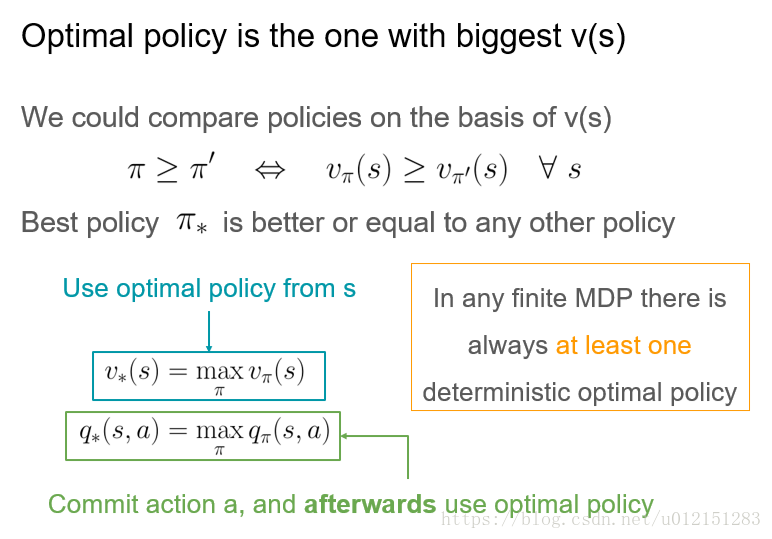
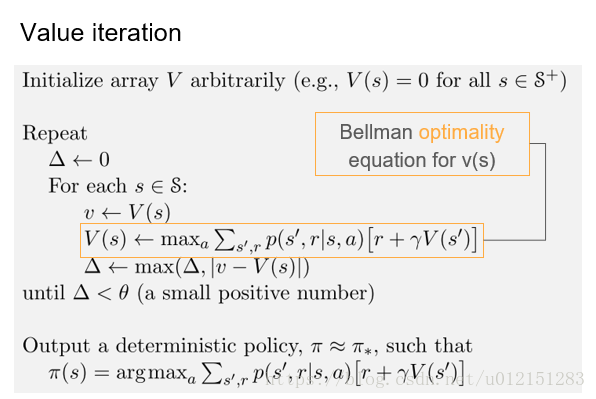
贝尔曼最优等式
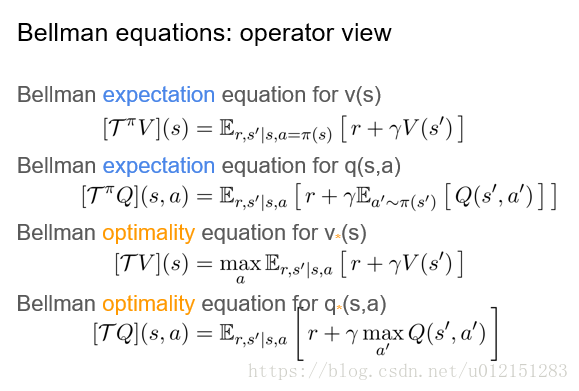
广义策略迭代GPI
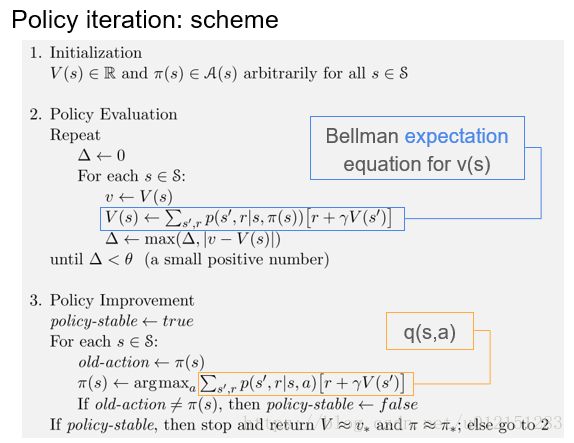
策略评估
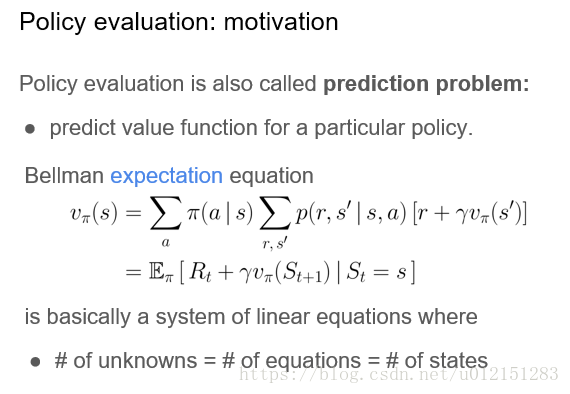
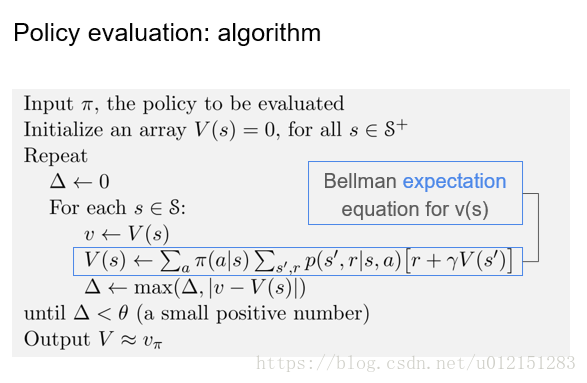
策略改进
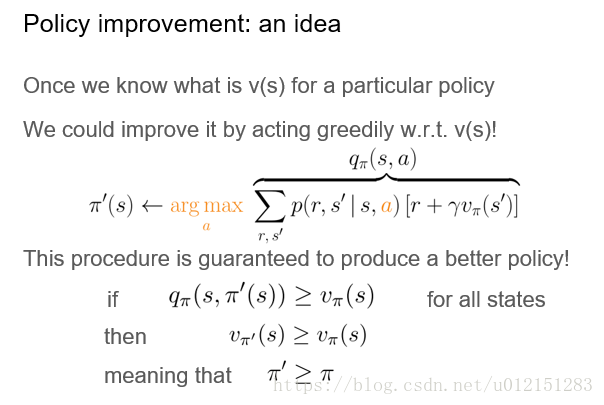
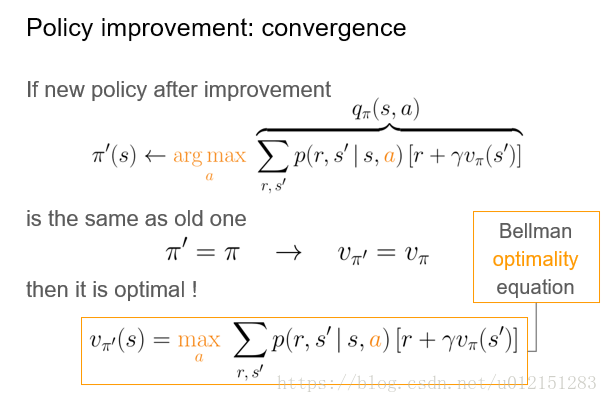
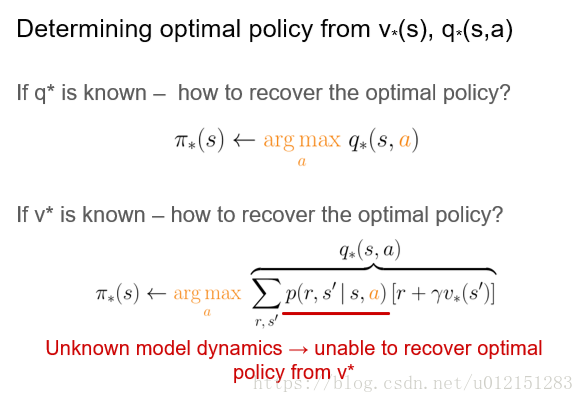
GPI
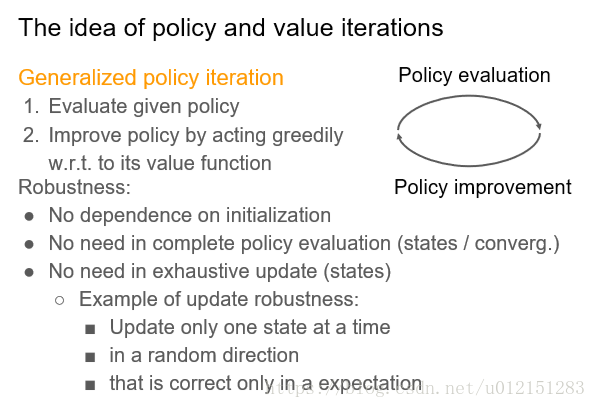
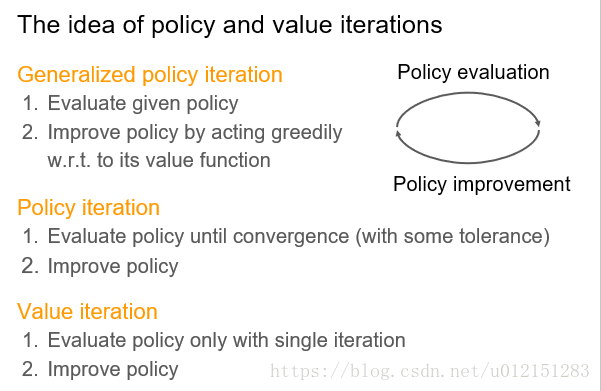
策略迭代
值迭代
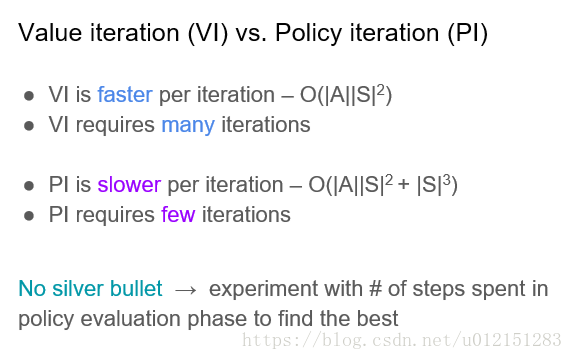
对比

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献3条内容

所有评论(0)