注意力机制原理及代码详解
注意力机制由来
注意力机制,就如我们平常所说的注意力一样,是一个聚焦点。比如对于下图:
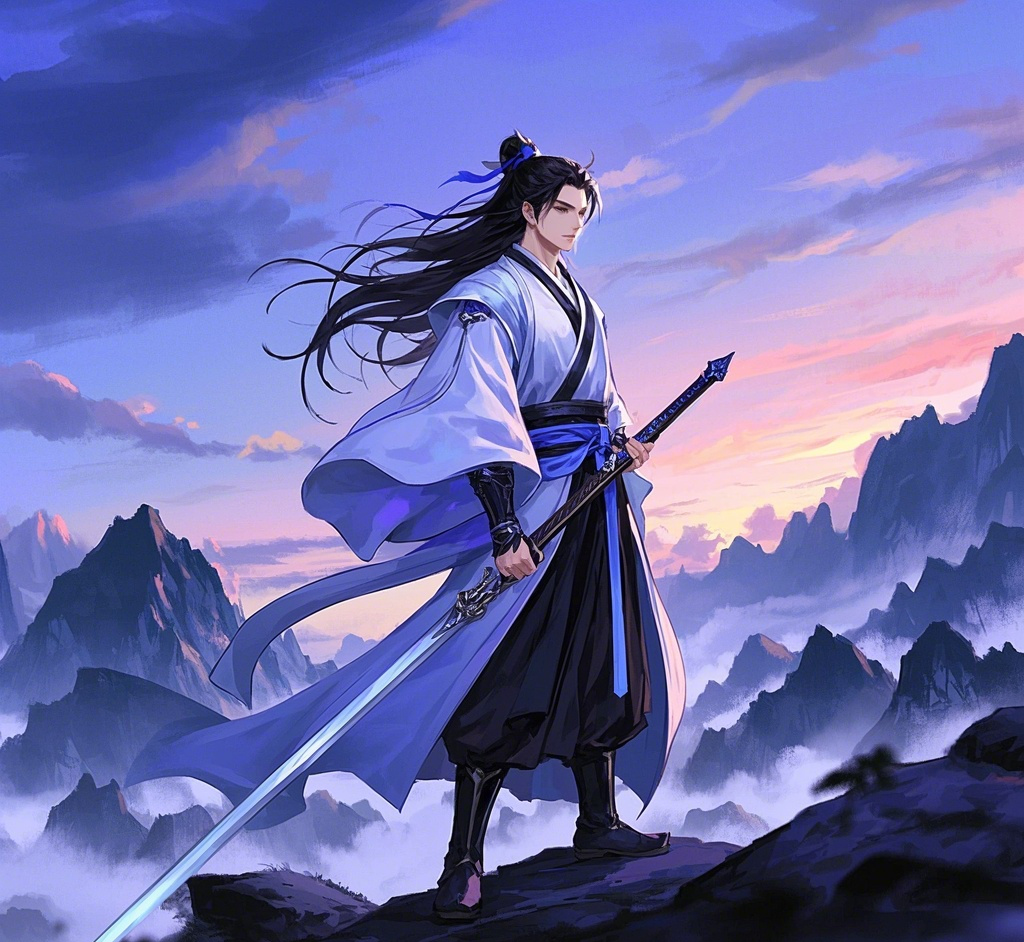
我们第一眼会聚焦到图片的中心,因为我们注意到图片的中央有一个人;其次,我们会注意到背后的天空、远处的山峰及脚下的大地。正如图片中的东西对我们的吸引力有大有小,是我们产生了对应的注意力反馈,在模型中我们可以凭借着两个向量的相关程度确定对应的权重矩阵,模拟注意力产生的过程。
注意力机制实现过程
对于一个普通的编码-译码器(Encoder-Decoder)架构:
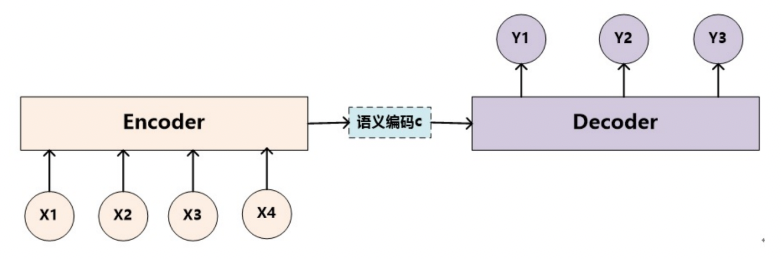
简单解释一下,是对应的输入,将我们输入的一串数据经过一系列编码层的黑箱操作之后得到输出:语义向量
。
而在译码层,我们通过及之前的输出确定该输出
,也就是
。
那么,有我们传统的架构公式可以看出,这只是一个个冰冷的操作的累加,并没有侧重点。比如对输出的贡献都是一样的,因为它没有变;又比如
对
的贡献类似,可能相同或者是通过同一个函数的多次关系作用与
。举个例子,如果我们做翻译任务:
I am Chinese -> 我是中国人
对于这个句子,肯定不是总的语义向量对每个输出有相同的贡献度,而是对应的位置贡献度最大;"I" 和 "am" 对 "Chinese" 的贡献度也不一样,因为 "Chinese" 有多重语义,可能 "I" 贡献度更大。所以,加入注意力机制是十分有必要的。改进之后: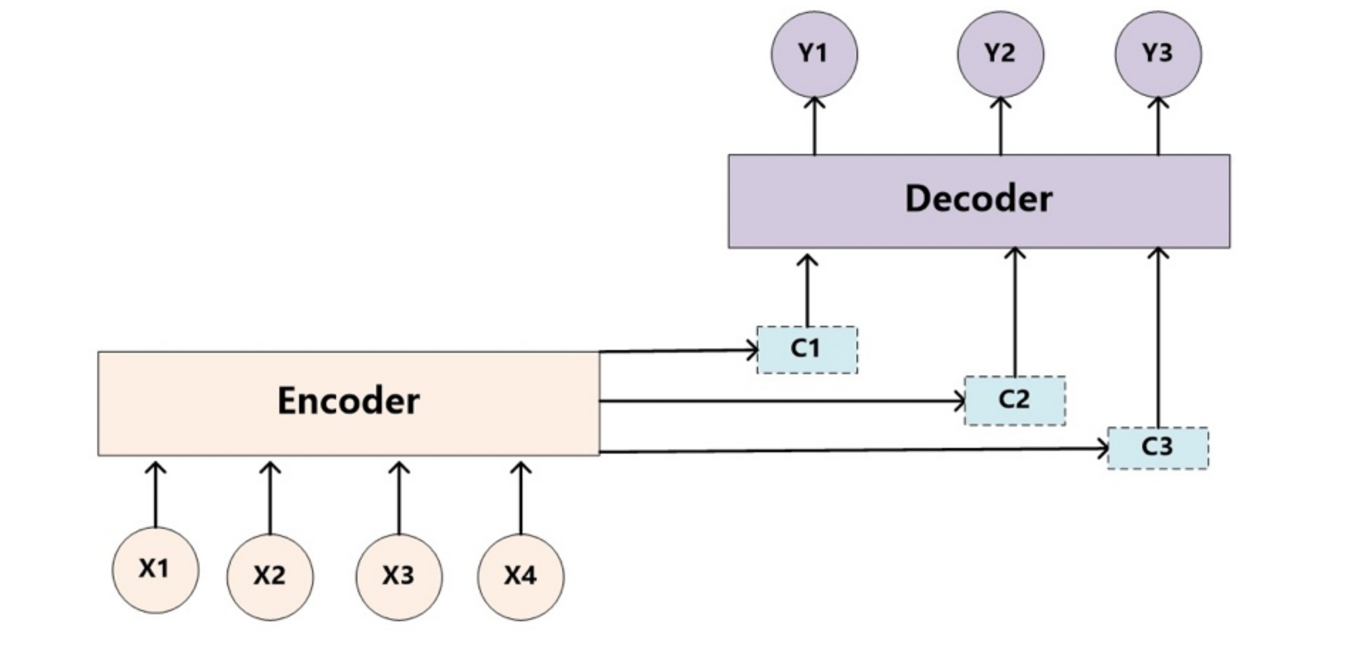
如图,对于每一个输出,我们都会生成相对应的语义向量
。并且在生成过程中,按照各输入
与输出的相关性确定对应的权重矩阵,也就是加权求和。
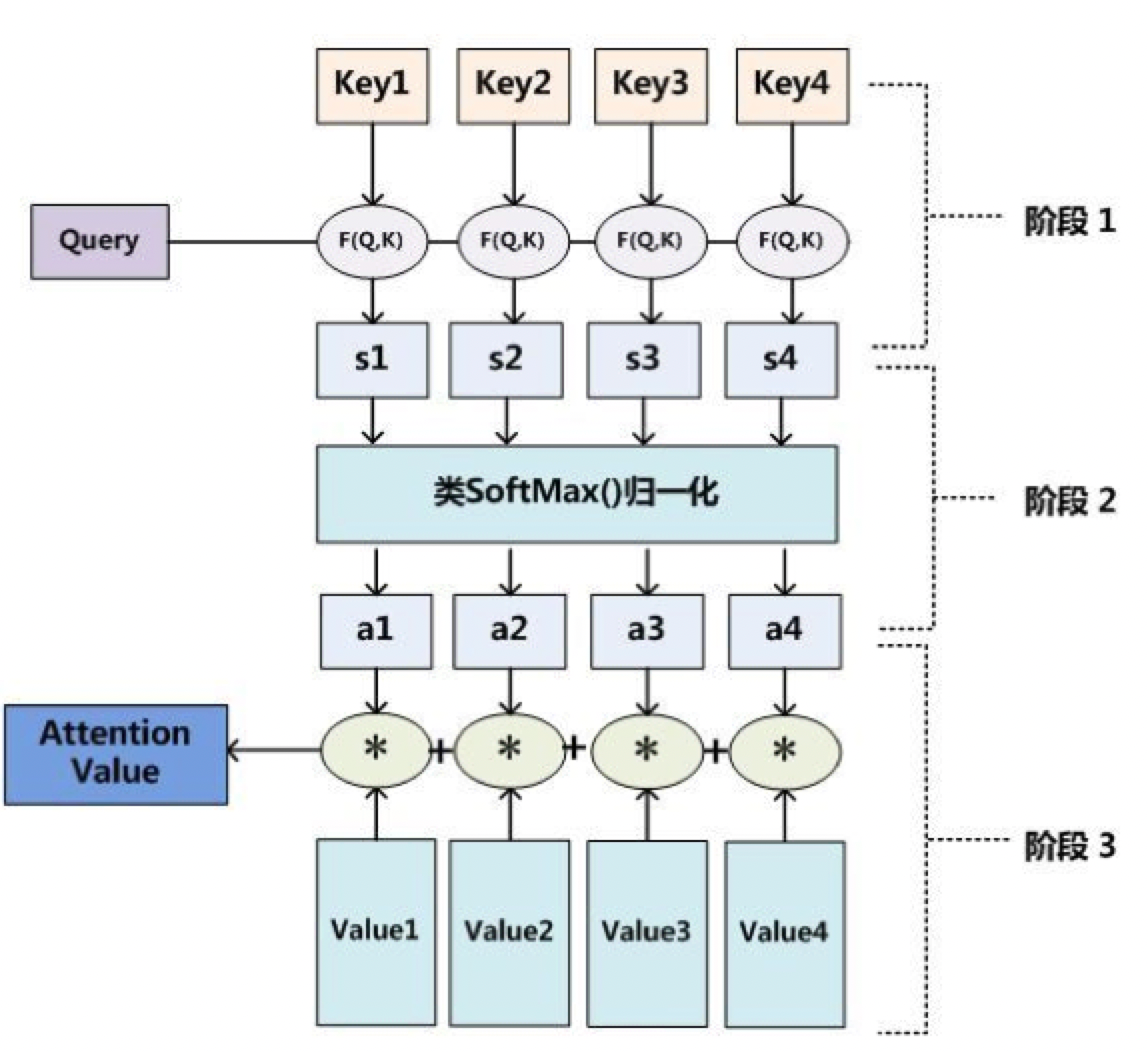
那么怎么求相关性呢?不要忘了在经过预处理之后,我们的和
都是一个多维的向量,求相关性就可以转化为求两个向量的点积,再经过归一化处理就得到了对应输入的权重矩阵。
实际中,每个输入被看作两个部分:。前者是对应单词的键,包含单词的特征,类似文章的摘要或标题;后者是单词的实际值,类似文章的内容。而要求的输出就是
,是要查询的对象。最终的注意力公式:
过程如:
代码及详解
简而言之,注意力机制就是在初始的时候设置三个线性层K,Q,V,它们对同一个向量进行线性变换,在经过一步步的反向传播后调整线性层的权重,使线性变换后的K,Q,V实现了对应的功能。
代码实现的每一步都写在注释里了:
import torch
import torch.nn as nn
import torch.nn.functional as F

class MyAtt(nn.Module):
    def __init__(self, query_size, key_size, value_size1, value_size2, output_size):
        super(MyAtt, self).__init__()
        self.query_size = query_size
        self.key_size = key_size
        self.value_size1 = value_size1
        self.value_size2 = value_size2
        self.output_size = output_size

        # [输入维度, 输出维度]
        # 线性层1 注意力权重分布
        # 编码层
        self.attn = nn.Linear(query_size + key_size, value_size1)

        # 线性层2 注意力结果表示按照指定维度输出层 self.attn_combine
        # 解码层
        self.attn_combine = nn.Linear(query_size + value_size2, output_size)

    def forward(self, Q, K, V):
        # 1 求查询张量q的注意力权重分布, attn_weights[1,32]
        # [1,1,32],[1,1,32]--> [1,32],[1,32]->[1,64]
        # [1,64] --> [1,32]
        # tmp1 = torch.cat( (Q[0], K[0]), dim=1)  去掉QK矩阵的第一个批次维度,并且把两个矩阵按照最后一个维度(1 * 32)拼接起来
        # tmp2 = self.attn(tmp1)  经过编码层处理
        # tmp3 = F.softmax(tmp2, dim=-1)  按照最后一个维度进行归一化
        attn_weights = F.softmax(self.attn(torch.cat((Q[0], K[0]), dim=-1)), dim=-1)  # 得到注意力权重分布

        # 2 求查询张量q的结果表示 bmm运算, attn_applied[1,1,64]
        # [1,1,32] * [1,32,64] ---> [1,1,64]
        # attn_weights.unsqueeze(0)给attn_weights补齐批次维度
        attn_applied = torch.bmm(attn_weights.unsqueeze(0), V)  # 进行加权计算

        # 3 q 与 attn_applied 融合,再按照指定维度输出 output[1,1,64]
        # 3-1 q与结果表示拼接 [1,32],[1,64] ---> [1,96]
        output = torch.cat((Q[0], attn_applied[0]), dim=-1)
        # 3-2 shape [1,96] ---> [1, 1 ,32]
        output = self.attn_combine(output).unsqueeze(0)

        # 4 返回注意力结果表示output:[1,1,32], 注意力权重分布attn_weights:[1,32]
        return output, attn_weights

if __name__ == '__main__':
    query_size = 32
    key_size = 32
    value_size1 = 32  # 32个单词
    value_size2 = 64  # 64个特征
    output_size = 32
    batch_size = 1  #生成数量
    seq_len = 1  #序列长度
    feature_dim = 32  # 特征维度

    Q = torch.randn(batch_size, seq_len, feature_dim)
    K = torch.randn(batch_size, seq_len, feature_dim)
    V = torch.randn(batch_size, seq_len * value_size1, feature_dim * 2)
    # V = torch.randn(batch_size, value_size1, value_size2)

    myattobj = MyAtt(query_size, key_size, value_size1, value_size2, output_size)

    # 2 把QKV数据扔给注意机制,求查询张量q的注意力结果表示、注意力权重分布
    output, attn_weights = myattobj(Q, K, V)
    print('output->', output.shape, output)
    print('attn_weights->', attn_weights.shape, attn_weights)

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 4
 0
- 0


 已为社区贡献1条内容

所有评论(0)