循环神经网络实验:从基础到进阶

简介:循环神经网络(RNN)作为深度学习模型,在处理序列数据时表现突出,具备记忆能力。本项目“rnn-experiment”旨在通过Python实现和训练RNN模型,重点探索其基本结构和变种如LSTM和GRU。实验流程涵盖了数据预处理、模型构建、训练、评估、优化及应用。参与者将学习到RNN的工作原理、构建技巧、性能评估与优化策略,并能将其应用于多个序列学习任务。
1. 循环神经网络(RNN)基础介绍
1.1 RNN简介
循环神经网络(RNN)是一种用于处理序列数据的神经网络。与其他类型的神经网络如卷积神经网络(CNN)不同,RNN因其内部的循环机制,特别擅长处理具有时间序列特点的数据,例如文本、语音、时间序列预测等。RNN能够利用其内部的记忆单元对之前的信息进行记忆,使其能够处理动态变化的输入序列。
1.2 RNN的工作原理
RNN的工作原理建立在时间步的概念上,每一个时间步接受当前的输入以及前一个时间步的状态作为输入,产生当前时间步的输出和新的状态信息。这种设计使得RNN能够把先前的信息和当前的输入结合起来,以形成对序列数据的整体理解。
1.3 RNN的主要应用场景
由于其独特的结构和工作原理,RNN在许多领域都有广泛的应用,包括语音识别、机器翻译、视频分析、自然语言处理等。这些应用都依赖于RNN对序列数据的理解和预测能力,尤其是在处理顺序性信息时RNN展现出的优势,使其成为时间序列分析不可或缺的工具。
2. Python在RNN实现中的应用
Python作为一门通用编程语言,在机器学习和深度学习领域中占据着举足轻重的地位。通过其简洁的语法和强大的社区支持,Python成为了数据科学家和机器学习工程师的首选工具。在本章中,我们将深入探讨Python在RNN实现中的应用,涵盖编程基础、深度学习库的安装与配置,以及Python实现深度学习算法的实例。
2.1 Python编程基础
2.1.1 Python语言的特点
Python语言以其易读性和简洁的语法而闻名,使得开发者能够以较少的代码行实现复杂的功能。它支持多种编程范式,包括面向对象、命令式、函数式和过程式编程。Python具有动态类型系统和垃圾收集功能,这些特性使得Python在处理复杂数据结构时更为高效。此外,Python拥有一个丰富的标准库,以及大量的第三方库,这极大地增强了Python在数据科学和机器学习领域的应用能力。
2.1.2 Python在数据分析中的作用
在数据分析和机器学习领域,Python成为了不折不扣的首选语言。其原因在于Python拥有如NumPy、Pandas和Matplotlib这样的库,它们专门用于数据处理、统计分析和数据可视化。这些库的出现,使得Python在数据预处理、数据探索以及结果呈现方面具有强大的工具支持。更重要的是,Python在机器学习领域有着广泛的生态系统,如scikit-learn、TensorFlow和PyTorch等,这些深度学习库让Python在构建复杂的模型时变得异常简单。
2.1.3 Python编程环境搭建
在开始Python编程之前,我们首先需要搭建一个合适的编程环境。推荐使用Anaconda这个Python发行版,它包含了Python解释器和大量的科学计算相关的库。Anaconda通过其包管理器 conda ,能够方便地管理和安装所需的库。此外,推荐使用Jupyter Notebook作为开发环境,它允许我们在一个可交互的文档中混合编写代码、文本和数学公式,非常适合机器学习的实验和原型开发。
2.2 Python在深度学习库中的应用
深度学习是机器学习的一个子领域,主要研究如何使用神经网络来模拟人脑进行思考和学习。Python之所以在深度学习中扮演着重要角色,很大程度上归功于其丰富的深度学习库。
2.2.1 安装和配置深度学习库
在Python中使用深度学习库之前,需要先进行安装。通常我们会使用 pip 或 conda 这两个包管理工具来安装。例如,安装TensorFlow和PyTorch,可以使用以下命令:
pip install tensorflow
pip install torch torchvision
或使用conda:
conda install tensorflow
conda install pytorch torchvision -c pytorch
安装完成后,可以创建一个Python脚本,并导入相应的库来测试是否安装成功。
2.2.2 利用Python实现深度学习算法
使用Python实现深度学习算法,通常需要遵循以下步骤:
- 准备数据:加载和预处理数据,将其转换为深度学习库能够处理的格式。
- 构建模型:使用深度学习库定义网络结构。
- 编译模型:设置训练参数,如损失函数、优化器和评估指标。
- 训练模型:使用数据对模型进行训练。
- 评估模型:使用测试数据评估模型性能。
- 优化模型:根据评估结果调整模型结构或参数。
接下来,我们将以构建一个简单的循环神经网络(RNN)为例,展示如何使用Python和Keras(TensorFlow的高级API)来实现序列数据的处理。
from keras.models import Sequential
from keras.layers import SimpleRNN, Dense

# 定义模型结构
model = Sequential()
model.add(SimpleRNN(50, input_shape=(timesteps, input_dim), return_sequences=False))
model.add(Dense(1, activation='sigmoid'))

# 编译模型
model.compile(loss='binary_crossentropy', optimizer='adam', metrics=['accuracy'])

# 训练模型
model.fit(X_train, y_train, epochs=100, batch_size=64)

# 评估模型
loss, accuracy = model.evaluate(X_test, y_test)
print('Test Loss:', loss)
print('Test Accuracy:', accuracy)
在上面的代码中,我们构建了一个包含50个神经元的简单RNN模型,并使用二元交叉熵作为损失函数进行编译。之后,我们使用 fit 方法对模型进行训练,并使用测试数据集评估模型性能。
通过本章的介绍,我们了解到Python在深度学习中的基础应用和安装配置过程,并通过一个简单的RNN实现示例,展示了Python在实现深度学习算法时的便利性和强大功能。接下来的章节将更深入地探讨RNN的基本结构和工作原理。
3. RNN基本结构与工作原理
3.1 RNN的结构组成
RNN通过其独特的结构设计可以处理序列数据。理解其结构是掌握RNN工作原理的基础。
3.1.1 神经元和权重
在RNN中,基本单元是神经元,与前馈神经网络中的神经元类似,但RNN中的神经元在不同时间步之间共享相同的权重,即权重是时不变的。这种设计使得RNN能够记忆前一个状态的信息。RNN的基本结构如下图所示:
在上图中,每个神经元在不同的时间步中都使用相同的权重矩阵W。这种设计允许网络在计算当前状态时,考虑到之前时间步的状态。
3.1.2 时间步和隐藏状态
RNN的一个关键概念是时间步(timesteps)。一个时间步是指网络在给定的输入后进行一次前向传播。而隐藏状态(hidden state)是RNN的记忆单元,它保存了序列中的信息。隐藏状态在每一个时间步中都会更新,可以认为是网络的历史记录。隐藏状态的更新通常表示为:
h_t = f(Ux_t + Wh_{t-1} + b)
其中h_t是当前时间步的隐藏状态,x_t是当前时间步的输入,U和W是权重矩阵,b是偏置项,f是激活函数。
3.2 RNN的数学原理
3.2.1 前向传播和反向传播
前向传播是RNN处理输入序列的过程。在每个时间步,网络根据当前输入和上一时间步的隐藏状态计算新的隐藏状态。最终,网络输出当前时间步的结果。
反向传播通过时间(backpropagation through time,BPTT)是RNN训练的关键。在BPTT中,损失函数相对于每个时间步的参数的梯度通过链式法则累积起来,从而计算出整个序列的梯度。然后,可以使用梯度下降或其变体来更新权重。
3.2.2 梯度消失和梯度爆炸问题
RNN在训练过程中面临的主要挑战之一是梯度消失和梯度爆炸问题。由于RNN的权重在时间上共享,网络在长序列上的训练过程中梯度可能会指数级衰减(梯度消失)或增长(梯度爆炸),这会严重影响网络的性能。
梯度消失会导致RNN难以学习到长期依赖关系,因为网络的权重无法在长距离的序列上进行有效的更新。梯度爆炸则可能导致模型训练过程的不稳定,甚至发散。解决这些问题通常需要使用梯度剪切(gradient clipping)、梯度规范化(gradient normalization)或者使用更加复杂的RNN变体,如LSTM和GRU。
代码块:RNN的前向传播示例
下面是一个简单的RNN前向传播的代码示例,使用了Python的TensorFlow库:
import tensorflow as tf

# 定义RNN的参数
num_units = 64  # RNN单元的数量

# 输入数据的占位符,假设输入数据的维度是[batch_size, time_steps, input_size]
X = tf.placeholder(tf.float32, [None, None, input_size])

# 使用BasicRNNCell创建RNN单元
cell = tf.nn.rnn_cell.BasicRNNCell(num_units)

# 在给定的输入X上执行前向传播
outputs, final_state = tf.nn.dynamic_rnn(cell, X, dtype=tf.float32)

# 代码解释:
# tf.nn.rnn_cell.BasicRNNCell创建了一个基本的RNN单元。
# tf.nn.dynamic_rnn函数用于根据输入数据X执行前向传播,它会返回所有时间步的输出以及最终的状态。
以上代码演示了RNN的前向传播过程。通过构建网络和执行前向传播,我们可以看到网络是如何接收输入并生成输出的。这种结构是RNN在序列学习中应用的基础。
以上就是RNN的基本结构和工作原理的详细解读。在下一章中,我们将继续深入了解RNN的变种结构,如长短期记忆网络(LSTM)和门控循环单元(GRU),以及它们如何更有效地处理序列数据。
4. LSTM和GRU变种及门控机制
4.1 LSTM的结构与原理
4.1.1 LSTM单元的组成
LSTM(Long Short-Term Memory)单元是一种特殊的RNN,其设计目的是解决传统RNN在处理长期依赖问题时所面临的梯度消失或梯度爆炸的问题。LSTM的结构由几个关键组件构成:遗忘门(forget gate)、输入门(input gate)、和输出门(output gate)。
遗忘门负责决定哪些信息应该从单元状态中丢弃,输入门控制着新输入数据中有多少应该被存储在单元状态中,而输出门则决定单元状态中的信息如何影响当前输出。
# LSTM单元的伪代码
forget_gate = sigmoid(W_f * [h_{t-1}, x_t] + b_f)
input_gate = sigmoid(W_i * [h_{t-1}, x_t] + b_i)
cell_state = forget_gate * cell_state + input_gate * tanh(W_c * [h_{t-1}, x_t] + b_c)
output_gate = sigmoid(W_o * [h_{t-1}, x_t] + b_o)
h_t = output_gate * tanh(cell_state)
其中, sigmoid 是S型激活函数, tanh 是双曲正切激活函数, W 和 b 分别是权重矩阵和偏置项。 h_{t-1} 和 x_t 分别是上一个时间步的隐藏状态和当前时间步的输入。
4.1.2 LSTM如何解决长期依赖问题
LSTM通过引入门控机制有效地解决了传统RNN在长序列学习中的难题。这种机制能够使得网络有选择性地记住和忘记信息。长期依赖问题主要源于梯度在反向传播过程中会指数级地衰减或增长,这使得网络难以学习到序列的早期信息。
通过遗忘门,LSTM能够决定每个时间步应该丢弃哪些信息。如果一个信息是不重要的,那么遗忘门的输出接近于0,相应的权重就会在更新时减少。反之,如果信息很重要,那么遗忘门的输出接近于1,权重得以保留。输入门和输出门同样可以防止梯度在更新时发生显著变化,从而使得网络能够学习到长序列中的依赖关系。
4.2 GRU的结构与原理
4.2.1 GRU单元的设计思想
GRU(Gated Recurrent Unit)是LSTM的一个简化版本,旨在减少模型复杂性同时保持与LSTM相似的性能。GRU的核心思想是将LSTM的两个状态(单元状态和隐藏状态)合并为一个状态,并简化门的结构。
GRU中包含了两个门:更新门(update gate)和重置门(reset gate)。更新门负责决定多少新输入应该和旧状态合并在一起,而重置门则控制着如何合并来自过去的信息。
# GRU单元的伪代码
reset_gate = sigmoid(W_r * [h_{t-1}, x_t])
update_gate = sigmoid(W_z * [h_{t-1}, x_t])
candidate_state = tanh(W * [reset_gate * h_{t-1}, x_t])
h_t = (1 - update_gate) * h_{t-1} + update_gate * candidate_state
这里, W_r 、 W_z 和 W 是权重矩阵, h_{t-1} 和 x_t 分别是上一个时间步的隐藏状态和当前时间步的输入。 reset_gate 和 update_gate 共同决定了信息的更新和保留程度。
4.2.2 GRU与LSTM的比较分析
在结构上,GRU比LSTM少了一个状态,同时门的数量也从三个减少到了两个。这使得GRU在计算复杂度上有所降低,训练模型时可能会更快收敛。然而,在某些情况下,LSTM的额外门和状态能够提供更精细的控制,可能在某些任务上会有更好的表现。
实际应用中,GRU往往作为LSTM的轻量级替代品出现。虽然GRU在很多情况下效率更高,但并没有绝对的证据表明它总是优于LSTM。研究和实验表明,两种结构的性能往往取决于具体任务。因此,选择LSTM还是GRU通常需要基于实验结果来决定。
注意: 在LSTM和GRU的选择上,重要的是要了解每种结构的特点和适用情况,然后通过实验来确定哪种更适合给定的问题。在实践中,深度学习模型的选择往往需要考虑到模型的复杂度、训练时间、资源消耗和具体任务的需求。
5. TensorFlow和PyTorch框架介绍
5.1 TensorFlow框架概述
5.1.1 TensorFlow的核心概念
TensorFlow是由Google开发的一个开源的机器学习库,最初用于研究和生产中复杂的神经网络。TensorFlow的核心是其数据流图的概念,这个图由节点(操作)和线(张量)组成,能够在不同的计算设备上分布式地执行运算。
数据流图: TensorFlow的数据流图使用图形的形式来表示计算的执行过程,其中节点(操作)表示数学运算,边(张量)则表示多维数据数组,这些数组在节点之间流动,即数据的传递路径。图中的每个节点都可能具有多个输入和输出,这使得构建复杂模型变得直观。
张量: 在TensorFlow中,张量是多维数组的一种表示形式,它可以是标量、向量、矩阵或更高维度的数组。张量的形状定义了其维度的大小。
会话(Session): TensorFlow中用于执行定义好的图的运行环境。在会话中运行图,并且在会话中可以计算张量。
5.1.2 构建和运行模型的基本流程
在TensorFlow中构建和运行模型主要包含以下几个步骤:
- 构建模型: 使用TensorFlow提供的API定义数据流图,构建模型的计算结构。
- 初始化变量: 在图中定义的变量需要被初始化,以便在会话中使用。
- 构建输入数据: 通过
tf.placeholder()或其他方法来构建模型的输入数据。 - 训练模型: 使用优化器和损失函数,对模型进行训练。
- 运行会话: 初始化会话,并在会话中运行图来执行训练、评估或预测操作。
在实际操作中,通常会将代码组织在不同的Python文件或类中,以保持代码的模块化和易于管理。下面是一个简单的TensorFlow模型构建和运行的代码示例:
import tensorflow as tf

# 定义输入数据的占位符
X = tf.placeholder(tf.float32, [None, 784])
Y = tf.placeholder(tf.float32, [None, 10])

# 构建神经网络结构
W1 = tf.Variable(tf.truncated_normal([784, 256]))
b1 = tf.Variable(tf.zeros([256]))
layer1 = tf.nn.relu(tf.matmul(X, W1) + b1)

W2 = tf.Variable(tf.truncated_normal([256, 128]))
b2 = tf.Variable(tf.zeros([128]))
layer2 = tf.nn.relu(tf.matmul(layer1, W2) + b2)

W3 = tf.Variable(tf.truncated_normal([128, 10]))
b3 = tf.Variable(tf.zeros([10]))
logits = tf.matmul(layer2, W3) + b3

# 定义交叉熵损失函数
loss = tf.reduce_mean(tf.nn.softmax_cross_entropy_with_logits(labels=Y, logits=logits))

# 选择优化器并进行优化
optimizer = tf.train.AdamOptimizer().minimize(loss)

# 初始化变量
init = tf.global_variables_initializer()

# 在会话中运行模型
with tf.Session() as sess:
    sess.run(init)
    # 训练过程可能包含多个迭代
    for epoch in range(epochs):
        # 在这里添加数据的处理逻辑
        # 运行优化器
        sess.run(optimizer, feed_dict={X: x_data, Y: y_data})
在这个示例中,定义了一个简单的三层全连接神经网络,使用了ReLU激活函数,并采用softmax交叉熵损失函数。模型通过Adam优化器进行优化。代码中的注释部分需要开发者根据具体问题来实现数据的预处理和迭代训练逻辑。
5.2 PyTorch框架概述
5.2.1 PyTorch的动态计算图
PyTorch是一个动态计算图的深度学习框架,由Facebook的人工智能研究团队开发。PyTorch的一个主要特点是它的动态计算图(也称为即时(imperative)计算图),这使得构建图的过程更加直观和灵活。
在PyTorch中,开发者可以使用标准的Python控制流结构来构建计算图。这与TensorFlow的静态图不同,静态图需要先定义完整的图,然后才能执行。在PyTorch中,图是动态构建的,这意味着开发者可以使用普通的Python代码来构建复杂的前向传播逻辑。
自动梯度计算: PyTorch的另一个核心特性是它能够自动计算梯度,这使得实现梯度下降和反向传播变得非常简单。PyTorch使用 torch.autograd 模块来自动追踪计算图的值以及执行梯度计算。
易用性和灵活性: 除了动态图的特性之外,PyTorch的API设计注重直观和易用性。例如,它使用类似Numpy的接口来处理多维数组(在PyTorch中称为张量),并且提供了丰富的数据集和模型构建工具。
5.2.2 PyTorch与TensorFlow的对比
PyTorch和TensorFlow是目前最流行的两个深度学习框架,它们各有特色,适应不同的使用场景。下面对两者进行一个简单的对比分析:
性能和优化: TensorFlow在模型训练的性能优化上比较成熟,支持自动微分以及广泛的部署平台。PyTorch同样性能优秀,特别是在研究领域,其动态图特性被广泛认为在原型设计和调试方面更为高效。
易用性: 从易用性的角度来看,PyTorch更倾向于科学研究者的使用习惯,拥有更简洁直观的API和更好的调试支持。TensorFlow的API则稍微复杂一些,需要更多的学习成本。
部署: TensorFlow提供了TensorFlow Serving和TensorFlow Lite等工具,方便模型在服务器端和移动设备端进行部署。PyTorch也支持通过TorchScript进行模型的序列化,以便在不支持Python的环境中部署模型。
社区和生态系统: TensorFlow有一个庞大且活跃的社区,提供了大量的教程、工具和库。PyTorch的社区虽然相对较小,但近年来增长迅速,尤其在研究社区中非常流行。
最终,选择哪个框架往往取决于项目需求、团队的熟悉程度和项目的预期目标。在一些实际案例中,开发者可能会根据具体的应用场景在两者之间切换。
下面是一个简单的PyTorch模型构建和训练的代码示例:
import torch
import torch.nn as nn
import torch.optim as optim

# 定义一个简单的线性网络
class Net(nn.Module):
    def __init__(self):
        super(Net, self).__init__()
        self.fc1 = nn.Linear(784, 256)
        self.fc2 = nn.Linear(256, 128)
        self.fc3 = nn.Linear(128, 10)

    def forward(self, x):
        x = torch.relu(self.fc1(x))
        x = torch.relu(self.fc2(x))
        x = self.fc3(x)
        return x

# 实例化网络和优化器
net = Net()
criterion = nn.CrossEntropyLoss()
optimizer = optim.Adam(net.parameters(), lr=0.001)

# 假设x_data和y_data已经准备好
# x_data = ...
# y_data = ...

# 训练过程
for epoch in range(epochs):
    # 前向传播
    outputs = net(x_data)
    loss = criterion(outputs, y_data)
    # 反向传播和优化
    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
在这个PyTorch的模型示例中,定义了一个简单的三层全连接网络。PyTorch使用 torch.nn.Module 作为所有神经网络模块的基类,通过继承并实现 forward 方法来定义前向传播逻辑。训练循环中使用了 backward 方法来自动计算梯度,并通过 step 方法更新参数。
总结而言,TensorFlow和PyTorch各有优劣,它们在深度学习领域的应用非常广泛。掌握它们的使用方法,将为进行深度学习研究和开发提供强大的工具支持。
6. RNN实验流程:数据预处理、模型构建、训练、评估、优化
6.1 数据预处理
6.1.1 数据清洗和格式化
在RNN的实验流程中,数据预处理是至关重要的一步。它涉及到从原始数据中提取有用信息,并且为模型训练做好准备。数据清洗和格式化的目的在于去除噪声和无关数据,确保数据的质量和一致性。
首先,需要对数据进行清理,包括处理缺失值、异常值、重复数据以及规范化文本格式(如大小写统一、去除特殊字符等)。例如,在处理文本数据时,通常会将所有字符转换为小写,并去除标点符号,以便模型能够聚焦于重要的文本内容。
import pandas as pd

# 示例:数据清洗
data = pd.read_csv('data.csv')
# 去除缺失值
data_cleaned = data.dropna()
# 去除重复数据
data_cleaned = data_cleaned.drop_duplicates()
# 标准化文本格式
def clean_text(text):
    text = text.lower()
    text = text.replace('[^a-z\s]', '')
    return text

data_cleaned['cleaned_text'] = data_cleaned['text_column'].apply(clean_text)
在上述代码中,我们首先读取数据,然后去除含有缺失值的行、重复行,最后对文本数据进行小写转换和非字母字符的删除。
6.1.2 构建训练集和测试集
数据集通常被分为训练集、验证集和测试集。训练集用来训练模型,验证集用来调整超参数,而测试集则用来评估模型的最终性能。在划分数据集之前,应当对数据进行随机打乱,以防止数据中潜在的顺序性对模型训练造成影响。
from sklearn.model_selection import train_test_split

# 假设 X 是特征集,y 是目标标签
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
在以上代码中,我们使用了 train_test_split 函数来将数据集分为训练集和测试集。 test_size=0.2 表示测试集占总数据集的20%, random_state 参数保证每次划分的结果保持一致。
6.2 RNN模型的构建与训练
6.2.1 设计RNN网络结构
设计RNN网络结构时,需要考虑神经网络层数、每层的神经元数量、激活函数、损失函数和优化器等因素。对于时间序列数据,通常会选择LSTM或GRU层作为网络的基础结构,因为这两种结构更适合处理长序列数据。
在TensorFlow中,可以使用 Keras API 来设计网络结构。以下是一个简单的LSTM网络结构示例:
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import LSTM, Dense

model = Sequential()
model.add(LSTM(units=50, return_sequences=True, input_shape=(input_shape)))
model.add(LSTM(units=50))
model.add(Dense(units=1))

model.compile(optimizer='adam', loss='mean_squared_error')
在这个例子中,我们构建了一个两层的LSTM网络,每层有50个LSTM单元,并且使用了一个Dense层作为输出层。模型使用adam优化器和均方误差损失函数进行编译。
6.2.2 训练模型和超参数调优
训练模型时,要设置合适的迭代次数(epochs)、批次大小(batch size)以及验证集,以便监控模型在未见数据上的性能。超参数调优则是优化过程中的关键步骤,可以帮助找到更好的模型配置以提高性能。
history = model.fit(X_train, y_train, epochs=100, batch_size=32, validation_data=(X_val, y_val))
model.fit 函数用于训练模型。 epochs 参数表示训练的轮数, batch_size 是每次向模型输入的样本数量, validation_data 提供了一个验证集来评估模型的性能。
6.3 模型评估与优化
6.3.1 模型性能评估方法
评估模型性能常用的指标包括准确率(Accuracy)、精确率(Precision)、召回率(Recall)、F1分数(F1 Score)等,具体选用哪个指标取决于问题的性质和业务需求。在序列学习任务中,特别是在时间序列预测问题中,常常会使用如均方误差(MSE)和均方根误差(RMSE)这样的指标。
from sklearn.metrics import mean_squared_error

y_pred = model.predict(X_test)
mse = mean_squared_error(y_test, y_pred)
print('Mean Squared Error:', mse)
在上述代码中,我们用模型对测试集进行预测,并计算均方误差(MSE)来评估模型性能。
6.3.2 模型优化策略
模型优化可以通过多种策略来实现,包括但不限于调整模型架构、使用正则化技术、进行数据增强、或者尝试不同的超参数。此外,早停(Early Stopping)和模型集成(Ensembling)也是常用的技术。
早停策略是指在训练过程中监测模型在验证集上的性能,一旦性能不再提升或开始下降,则停止训练。这样可以防止过拟合,并且节省计算资源。以下是如何在代码中实现早停的示例:
from tensorflow.keras.callbacks import EarlyStopping

early_stopping = EarlyStopping(monitor='val_loss', patience=5)

history = model.fit(X_train, y_train, epochs=100, batch_size=32,
                    validation_data=(X_val, y_val),
                    callbacks=[early_stopping])
在上面的代码中,我们创建了一个早停的回调函数,当验证集上的损失值5次迭代都没有改善时,训练会提前终止。
通过这些策略,我们可以逐步提高RNN模型的性能,使其更好地适应序列数据学习任务。
7. 序列学习任务的实际应用
7.1 应用RNN在自然语言处理中
7.1.1 语言模型和文本生成
在自然语言处理(NLP)中,RNN的应用之一是构建语言模型,这些模型能够预测下一个单词的出现概率,进而生成文本。通过在大量文本数据上训练RNN,模型学会捕捉文本中的语言规律和模式。
语言模型的构建通常使用的是字符级别的RNN模型,或者更常见的单词级别的模型。一个典型的训练过程是将文本数据分割为一系列的输入序列,然后模型尝试预测每一个序列后的单词。
示例代码:使用字符级别的RNN进行文本生成
from keras.models import Sequential
from keras.layers import LSTM, Dense
import numpy as np

# 假设我们有一个用于训练的文本字符串
text = """你的文本数据"""

# 将文本转换为字符级的序列
chars = sorted(list(set(text)))
char_indices = dict((c, i) for i, c in enumerate(chars))
indices_char = dict((i, c) for i, c in enumerate(chars))

# 准备用于训练的数据集
maxlen = 40
step = 3
sentences = []
next_chars = []
for i in range(0, len(text) - maxlen, step):
    sentences.append(text[i: i + maxlen])
    next_chars.append(text[i + maxlen])
print('Number of sequences:', len(sentences))

# 将序列转换为整数序列
x = np.zeros((len(sentences), maxlen, len(chars)), dtype=np.bool)
y = np.zeros((len(sentences), len(chars)), dtype=np.bool)
for i, sentence in enumerate(sentences):
    for t, char in enumerate(sentence):
        x[i, t, char_indices[char]] = 1
    y[i, char_indices[next_chars[i]]] = 1

# 构建RNN模型
model = Sequential()
model.add(LSTM(128, input_shape=(maxlen, len(chars))))
model.add(Dense(len(chars), activation='softmax'))

# 编译和训练模型
model.compile(loss='categorical_crossentropy', optimizer='adam')
model.fit(x, y, batch_size=128, epochs=10)

# 生成文本的函数
def generate_text(length, diversity):
    start_index = np.random.randint(0, len(text) - maxlen - 1)
    generated = ''
    sentence = text[start_index: start_index + maxlen]
    generated += sentence

    for i in range(length):
        x_pred = np.zeros((1, maxlen, len(chars)))
        for t, char in enumerate(sentence):
            x_pred[0, t, char_indices[char]] = 1.
        preds = model.predict(x_pred, verbose=0)[0]
        next_index = sample(preds, diversity)
        next_char = indices_char[next_index]

        generated += next_char
        sentence = sentence[1:] + next_char

    return generated

# 从模型中采样,生成文本
def sample(preds, temperature=1.0):
    preds = np.asarray(preds).astype('float64')
    preds = np.log(preds) / temperature
    exp_preds = np.exp(preds)
    preds = exp_preds / np.sum(exp_preds)
    probas = np.random.multinomial(1, preds, 1)
    return np.argmax(probas)

# 调用函数生成一段文本
print(generate_text(500, 0.5))
在这个例子中, generate_text 函数用于生成文本,它从训练好的模型中进行采样以生成连续的字符序列。通过调整 temperature 参数可以控制生成文本的多样性,即随机性。
7.1.2 机器翻译和语音识别
RNN还被广泛应用于机器翻译和语音识别等序列到序列的任务中。例如,在机器翻译中,RNN可以将一种语言的句子序列映射到另一种语言的句子序列。通过学习大量的双语文本对,RNN模型能够捕捉句子中的语法结构和词汇对应关系。
语音识别任务中,输入的语音信号首先被转换为声学特征序列,然后RNN负责将这些特征转换为文字序列。这里,RNN需要处理序列数据中的时间依赖性,并且能够理解声音信号的动态变化。
7.2 应用RNN在时间序列分析中
7.2.1 股票市场预测
时间序列分析是金融市场分析的重要部分。RNN因其能够处理时间序列数据的时序特性,成为股票市场预测的有力工具。通过分析历史股票价格数据,RNN可以预测未来的股价走势。这种分析帮助投资者做出更明智的投资决策。
示例代码:使用RNN对股票价格进行预测
import numpy as np
import matplotlib.pyplot as plt
from keras.models import Sequential
from keras.layers import LSTM, Dense, Dropout

# 假设我们有一个股票价格时间序列数据集
# data = ...

# 将数据进行归一化处理
data = (data - np.mean(data)) / np.std(data)

# 生成训练数据
def create_dataset(dataset, look_back=1):
    X, Y = [], []
    for i in range(len(dataset) - look_back - 1):
        a = dataset[i:(i + look_back), 0]
        X.append(a)
        Y.append(dataset[i + look_back, 0])
    return np.array(X), np.array(Y)

look_back = 5
X, y = create_dataset(data, look_back)
X = np.reshape(X, (X.shape[0], X.shape[1], 1))

# 分割数据集为训练集和测试集
train_size = int(len(X) * 0.67)
test_size = len(X) - train_size
X_train, X_test = X[0:train_size], X[train_size:len(X)]
y_train, y_test = y[0:train_size], y[train_size:len(y)]

# 构建RNN模型
model = Sequential()
model.add(LSTM(4, input_shape=(look_back, 1)))
model.add(Dense(1))
model.compile(loss='mean_squared_error', optimizer='adam')
model.fit(X_train, y_train, epochs=100, batch_size=1, verbose=2)

# 进行预测
train_predict = model.predict(X_train)
test_predict = model.predict(X_test)

# 绘制结果
plt.plot(data)
plt.plot(np.concatenate((np.zeros(look_back), train_predict), axis=0))
plt.plot(np.concatenate((np.zeros(look_back + test_size), np.zeros(len(train_predict)) + np.max(y_train), test_predict), axis=0))
plt.show()
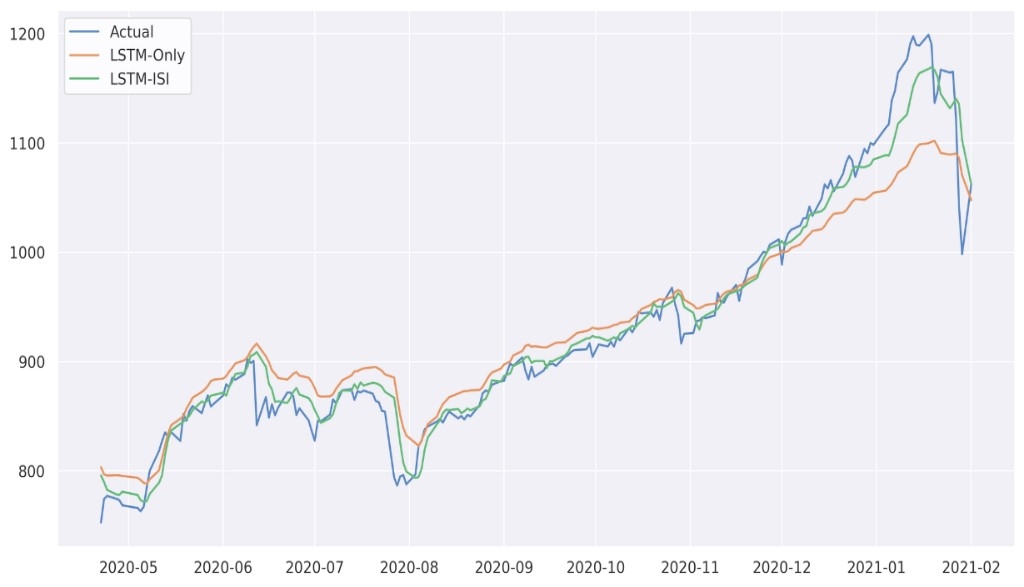
在这个例子中,我们首先创建了输入数据集,然后构建了LSTM模型进行训练和预测。通过绘制原始数据和预测数据,我们可以直观地看到模型对股票价格的预测表现。
7.2.2 预测和分类时间序列数据
RNN也可用于其他类型的时间序列数据的预测与分类。例如,可以使用RNN预测能源消耗量、天气变化、交通流量等。在分类任务中,RNN可以通过时间序列中的模式识别来预测序列所属的类别,例如信用卡欺诈检测、故障诊断等。
在时间序列分类中,通常使用双向RNN或者1D卷积神经网络结合RNN来提取序列的时空特征,以提高分类性能。这些方法能够有效地从数据的动态变化中学习复杂的模式。
在实际应用中,除了RNN以外,通常还会和其他深度学习技术结合使用,以提升模型在特定任务上的表现。例如,结合长短时记忆网络(LSTM)或门控循环单元(GRU)能够解决传统RNN难以应对的长期依赖问题。此外,还会结合其他结构,比如注意力机制,从而进一步提升模型的性能和泛化能力。
简介:循环神经网络(RNN)作为深度学习模型,在处理序列数据时表现突出,具备记忆能力。本项目“rnn-experiment”旨在通过Python实现和训练RNN模型,重点探索其基本结构和变种如LSTM和GRU。实验流程涵盖了数据预处理、模型构建、训练、评估、优化及应用。参与者将学习到RNN的工作原理、构建技巧、性能评估与优化策略,并能将其应用于多个序列学习任务。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 27
 0
- 0


 已为社区贡献23条内容

所有评论(0)