【深度估计】MVSA-多视图一致性的深度估计transformer
项目地址:MVSAnywhereMVSAnywhere: Zero-Shot Multi-View Stereo, 2025 https://nianticlabs.github.io/mvsanywhere/
对于深度估计主要关注两方面,一方面要求局部的边界清晰,另一方面则要求图像中的近景深度以及无限远深度的准确预测,在depth anything(单目深度估计)的基础上增加了多视图几何一致性的信息来估计深度,增强了泛化性,也是一个必然的方法,单目深度固然简单粗暴效果好,但既然有大量的图像数据,为何不把它们的信息共享起来,在多视图信息的基础上使得深度估计更加准确呢?在结果上来说,作者这篇的工作对于图像中无限远的深度估计以及前景背景的划分都有较大的提升。更多细节可以查看论文。
一、简介
从多视角图像中计算精确深度是计算机视觉领域一项基础而长期的挑战。然而,现有大多数方法在不同领域和场景类型(如室内与室外)间的泛化能力较差。训练通用多视角立体模型面临诸多挑战,例如:如何最优利用基于Transformer的架构?当输入视角数量可变时如何整合额外元数据?以及如何估计有效深度范围(该范围在不同场景间差异显著且通常无法预先获知)?针对这些问题,我们提出MVSA——一种新颖且通用的"多视角立体视觉任意场景适配"架构,通过跨领域和深度范围的泛化实现全域适用。MVSA创新性地将单目线索与多视角线索相结合,并采用自适应代价体积来解决尺度相关问题。我们在Robust Multi-View Depth Benchmark基准测试中实现了零样本深度估计的领先性能,超越了现有多视角立体和单目基线方法。
近年来基于学习的多视角立体视觉(MVS)方法已能生成精确深度[6,95,96],但这些方法通常难以泛化至与训练数据差异显著的场景和相机配置。因此,亟需开发对训练-测试分布差异更具鲁棒性的通用MVS方法。
近期场景无关单目深度模型仅需单张输入图像即可预测真实尺度[2,26,30,56,81,98]或相对尺度[39,59,93,94]的深度。它们通常通过海量合成/真实RGB-D数据训练,在面对全新数据时展现出惊人的泛化能力。
但单目模型天然受限于输入信息:仅凭单张图像,模型被迫依赖单目几何线索(如消失点)和学习模式[15],无法利用更强的多视角信号。虽然存在时序扩展方案[55,68,80,85,90],但其重点在于时序感知一致性,而非多视角一致性。在推理时可获取多视角的场景中,多视角信息理应带来更精确的深度估计[36,49,70]。
开发通用MVS方法需解决两大挑战:首先需处理任意深度范围。现有MVS方法通常需要预设深度搜索范围以沿极线构建离散深度箱的代价体积,这些深度范围要么固定(取自训练数据)[62],要么需在测试时逐图提供[76,95,96]。其次,视觉Transformer(ViT)[17]的优势促使我们探索如何将传统CNN架构的MVS模块升级为Transformer架构。
我们提出新型通用MVS方法"多视角立体视觉全域适配"(MVSA)。与近期高性能单目方法类似,它通过跨深度范围的多样化数据训练获得泛化能力。我们的核心技术创新包括:
• 基于Transformer的混合架构:通过创新的代价体积分块器(Cost Volume Patchifier)在保留细节的前提下将代价体积转换为token,同时融合单目ViT特征
• 视角/尺度无关的代价体积构建机制:支持任意数量输入源的几何元数据融合,突破传统固定视角数拼接方法[62]的限制
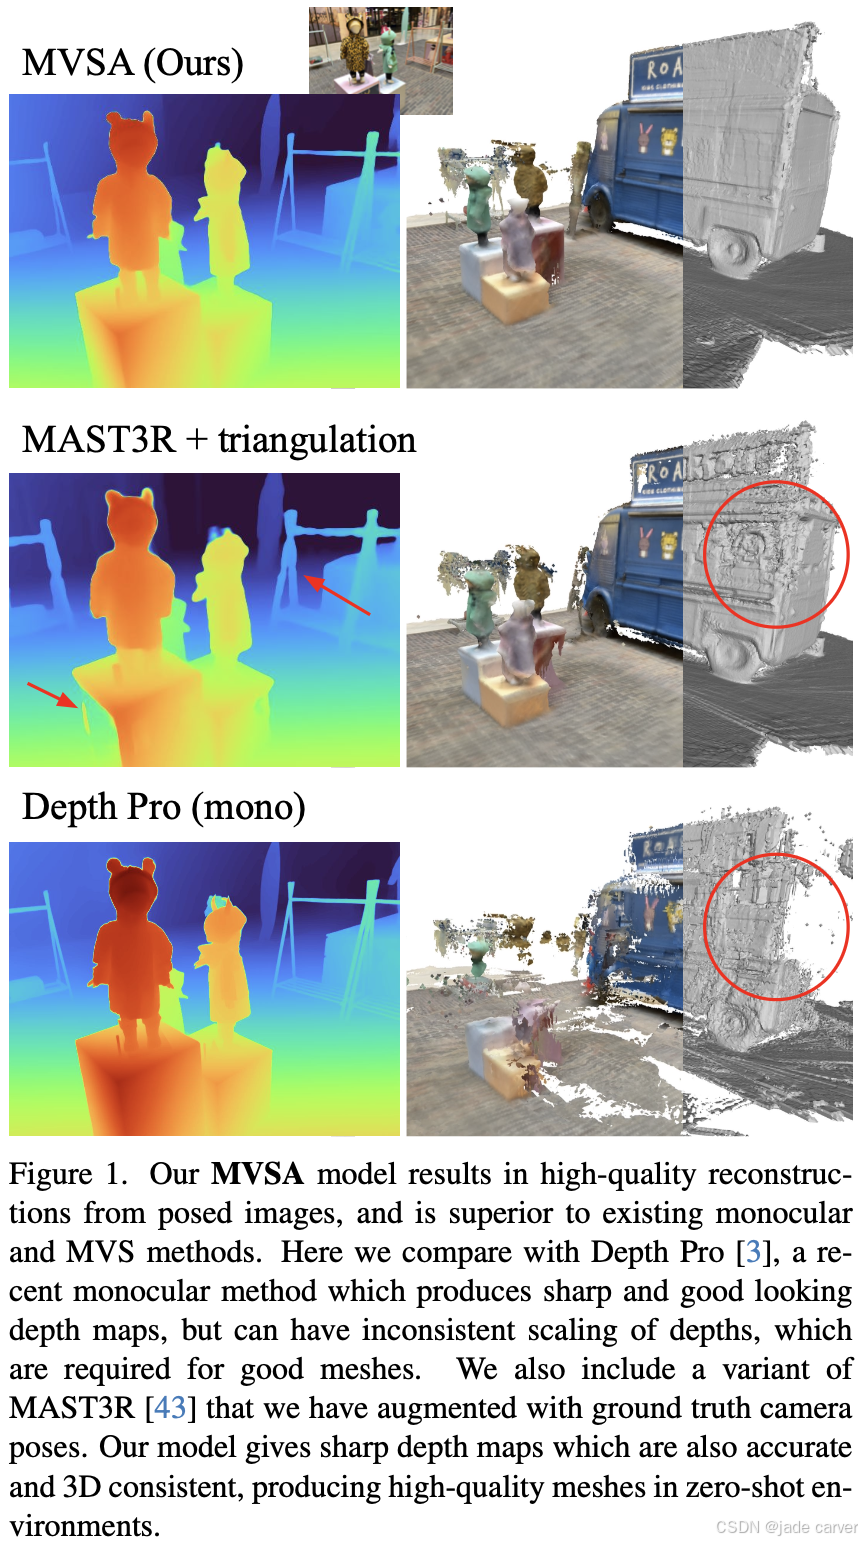
MVSA能预测高精度且三维一致的深度,在包含多种挑战性数据的Robust Multi-View Depth Benchmark[67]上达到零样本(state-of-the-art)性能。实验表明,相较其他深度重建方法,我们的深度预测能生成更优质的三维网格重建结果(图1)。
二、方法
我们的模型输入包含一张H×W参考图像Iₐ及其相邻源帧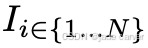 ,每帧均附带相对位姿和相机内参。测试时需为参考图像预测稠密深度图D̂ᵣ。为实现通用MVS方法,我们致力于满足以下目标:
- 跨域泛化能力:当前多数MVS方法仅在单一领域(如纯室内或纯驾驶场景)训练测试,而本系统需适应任意场景。
- 全范围深度适应:深度预测需同时满足近距表面(如机器人应用)与远距场景(如无人机/自动驾驶)的精度需求。在SIM等非度量坐标系场景中,系统需对坐标尺度具有鲁棒性。
- 源帧数量/选择的鲁棒性:传统MVS系统在源帧与参考帧重叠度低时表现不佳。本方法需对测试时源帧数量保持无关性。
- 三维一致深度预测:不同视角预测的深度应保持几何一致性。融合一致深度图将生成具有精确三维表面估计的网格。据我们所知,本模型是首个在单一系统中同时解决这四大挑战的方案。
2.1MVSAnywhere简介
我们提出MVSAnywhere(MVSA)——一种创新的通用多视角立体视觉系统,其设计全面实现了前述所有特性。为实现跨域泛化能力,该系统采用基于Transformer的大型架构,输入包含:
- 来自参考图像与源图像的多视角信息
- 通过单目参考图像编码器直接从参考图像提取的单视角信息
整体架构(图3及补充材料)受近期MVS方法[62]启发,包含五个核心组件:
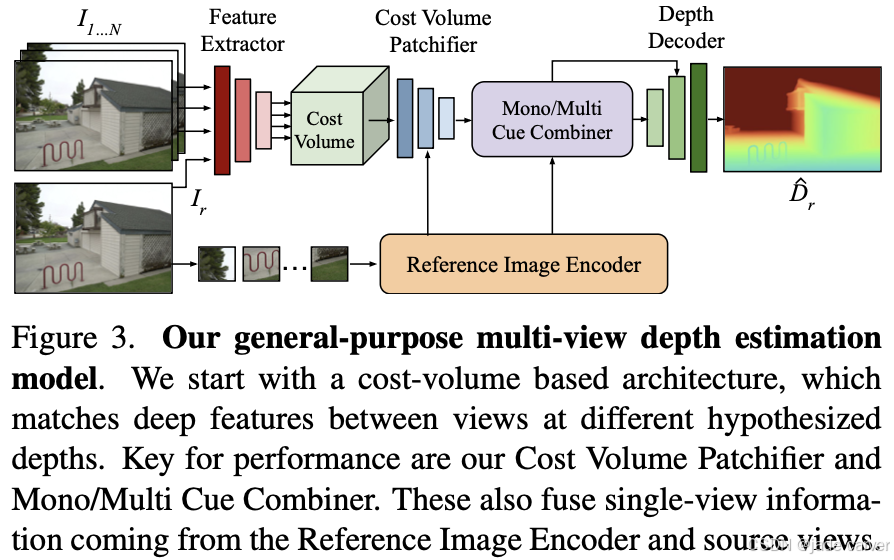
特征提取器
将源图像与参考图像编码为深度特征图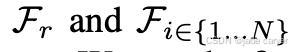 (分辨率H/4×W/4),采用ResNet18[29]前两个模块实现。
代价体积
遵循[7,34,40,79]方法,通过假设深度值(即深度箱D)将各源视图特征图 扭曲至参考视图,随后与
 及元数据拼接[62]。具体创新详见2.2节。
参考图像编码器
采用Depth Anything V2[94]的ViT Base[17]编码器(预训练权重),从Iᵣ提取强单目特征。ViT Base处理14×14图像块,输入图像需缩放至(14H/16)×(14W/16)分辨率,输出特征尺寸为H/16×W/16。该设计使系统对源帧与参考帧低重叠情况具有鲁棒性。
单目/多视角线索融合器
将代价体积与参考图像的"分块化"特征转换为特征序列输入深度解码器。通过2.3节所述新型组件实现单目与多视角线索融合。
深度解码器
基于[58]解码器架构,逐步上采样并处理融合器模块的特征,最终输出参考图像分辨率的深度图。
2.2代价体的构建-处理元数据与尺度
2.2.1参考的方法
这个代价体的构建思路来源于SimpleRecon[62],该文章表明,将几何与相机位姿元数据(metadata)整合至代价体积(cost volume)可显著提升深度估计精度。其具体实现流程为:
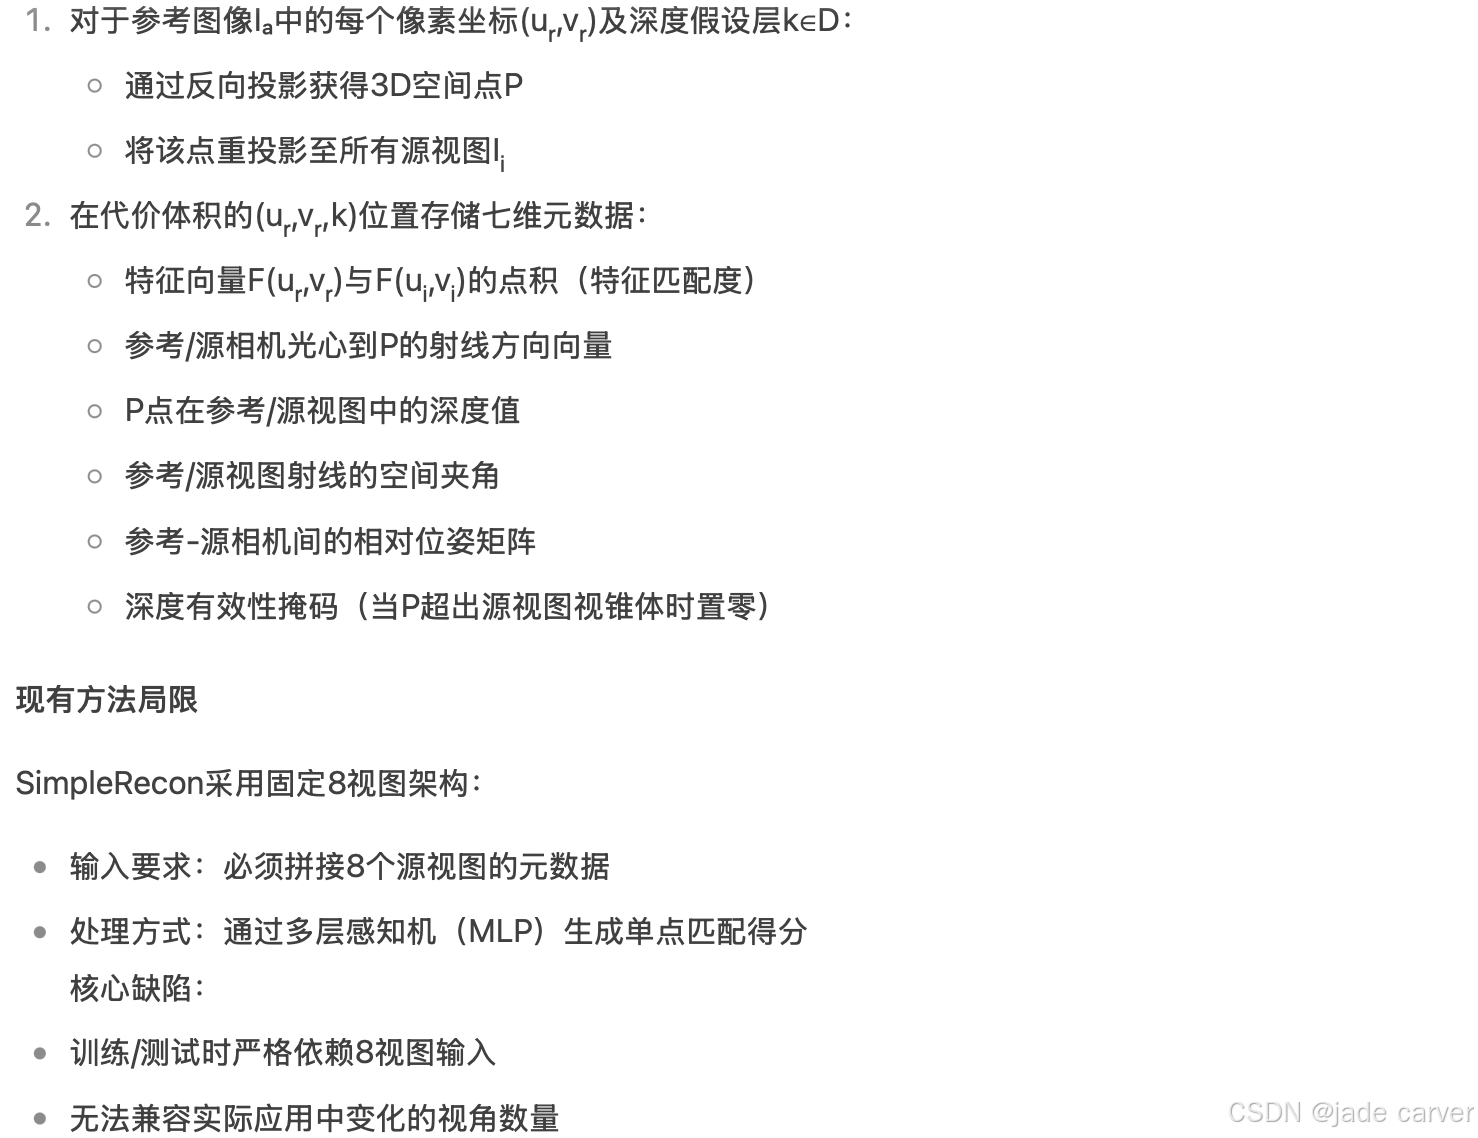


2.2.2本文改进

动态视角聚合模块
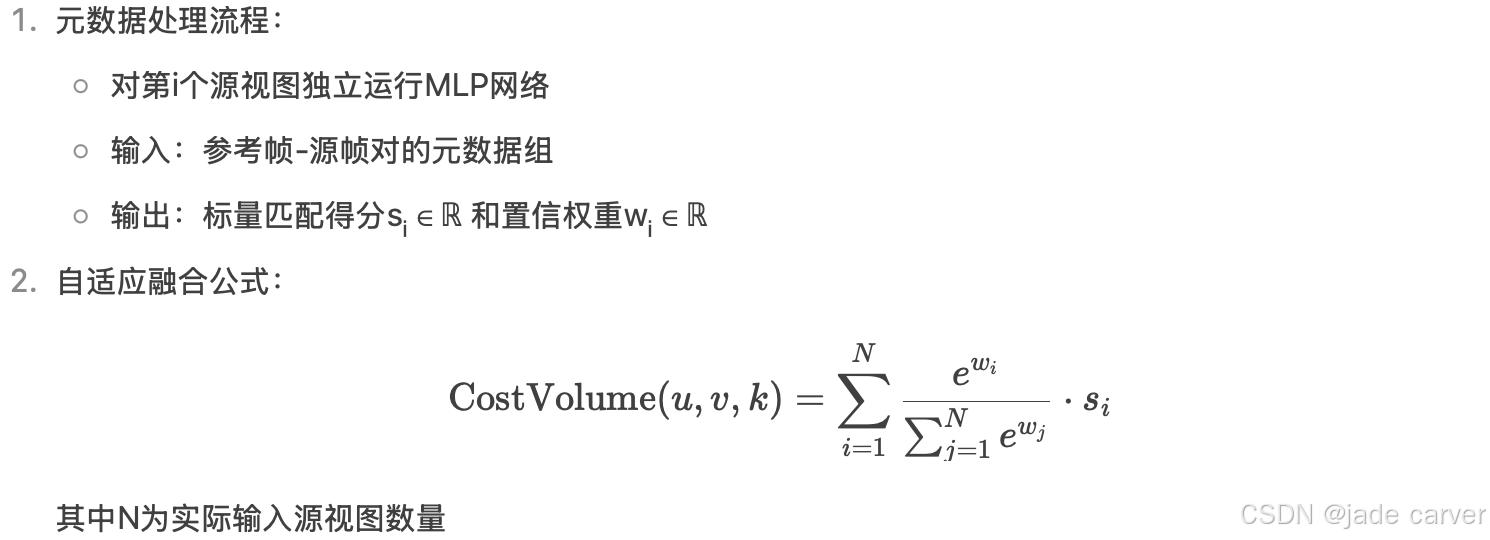
多尺度归一化
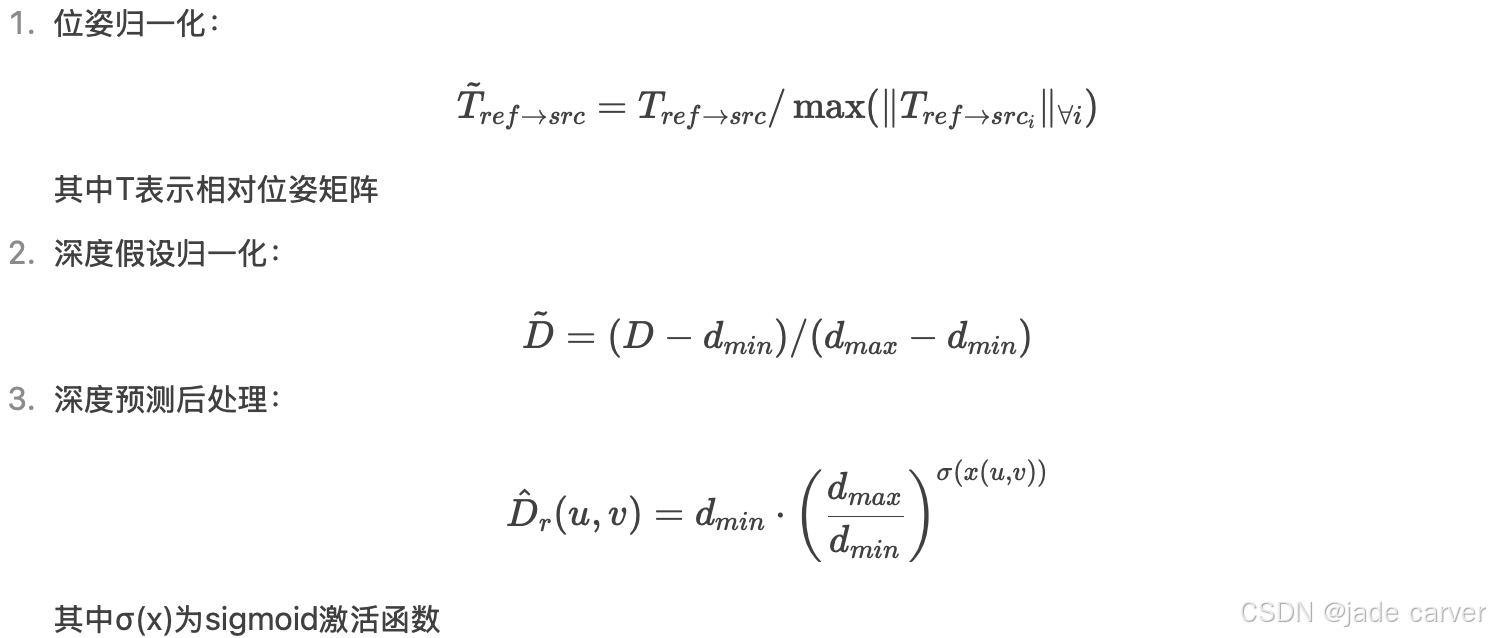
2.3Cost Volume Patchifier and Mono/Multi Cue Combiner

给定形状为|D|×H/4×W/4的代价体积(cost volume),以及形状为C×H/16×W/16的参考图像编码器特征(来自不同模块的输出),我们提出关键问题:如何最优融合这些特征以提供最强的解码信号?受Transformer在单目深度预测中的成功启发[3,58,94],采用ViT-Base网络构建单目/多视角线索融合器,生成token序列供解码器转换为深度预测。
1. 代价体分块化(Cost Volume Patchifier)
将参考图像编码器前两个模块的特征(分别上采样至1/4和1/8输入分辨率),与代价体积进行通道拼接
,然后通过两级步进卷积生成H/16×W/16的token序列输出与单目特征序列长度对齐。
2.多层级线索融合
将代价体积token与线性投影后的单目特征token相加,在ViT的第2/5/9/11模块重复融合过程
实现多尺度单目线索注入。
架构对比(图4)
| 方案 | 处理方式 | 缺陷 |
|---|---|---|
| 基础方案(a) | 直接对代价体积分块 | 缺乏参考图像结构引导 |
| 本方案(b) | 联合参考图像特征分块 | 保留几何与语义上下文 |

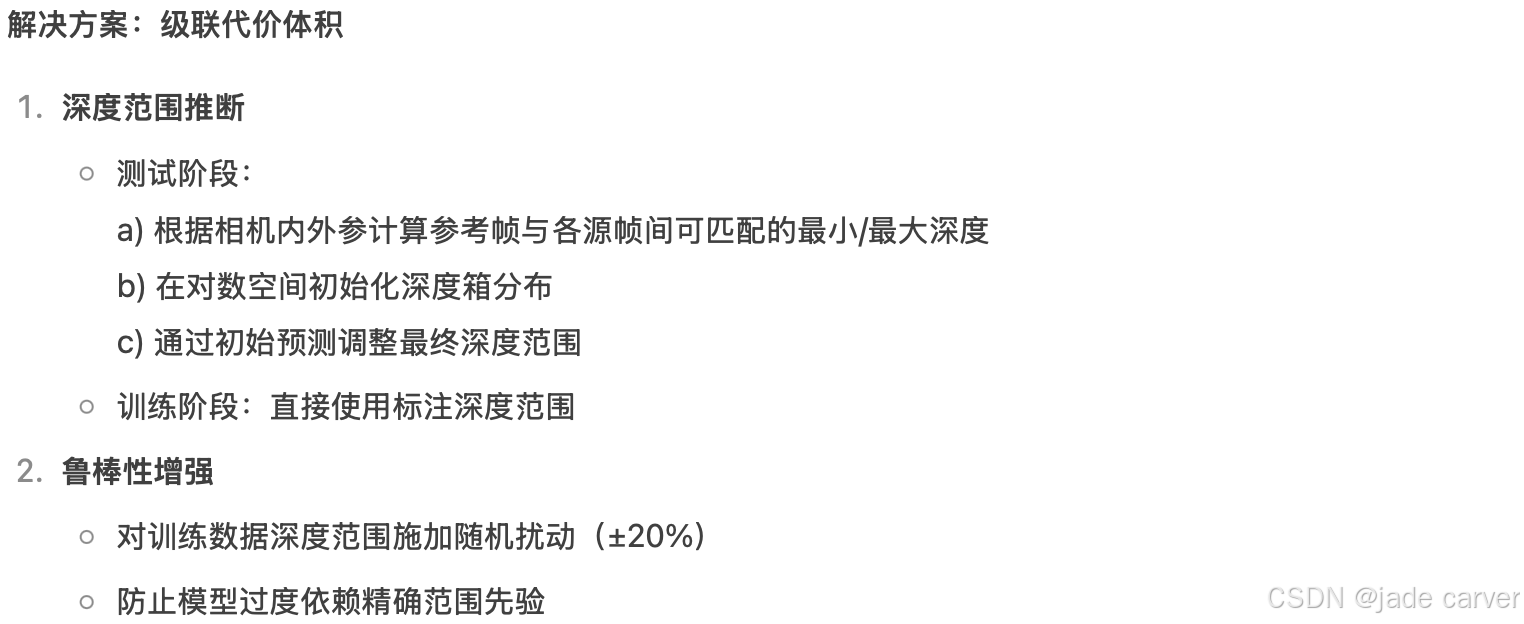
2.4 任意深度范围泛化
构建代价体积时需预设深度假设集D(即深度箱),用于将特征图 扭曲至不同平面L。关键问题在于:如何选择D以适应任意深度范围?不同数据集的深度范围差异巨大(见图2),固定范围会导致次优结果。

2.5 训练与loss
损失函数
采用文献[62]的监督损失组合:
对数L1损失:GT深度与预测深度的对数差异:
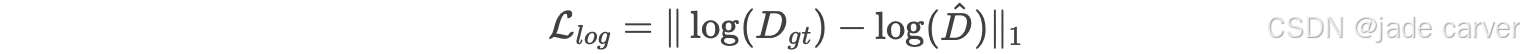
梯度/法向损失:增强几何一致性
- 一阶梯度损失:保持边缘锐度
- 表面法向损失:优化曲面连续性
(训练时在解码器的四个输出尺度上计算损失,推理阶段仅保留最终尺度的预测结果)
核心参数配置
| 参数项 | 设定值 | 技术意义 |
|---|---|---|
| 输入分辨率 | 640×480 | 平衡计算成本与细节保留 |
| 深度箱数量 | 64(对数空间采样) | 近处高密度/远处低密度分布 |
| 关键帧选择策略 | 密集序列[18,62] | 时序连续性优先 |
| 稀疏序列几何重叠优选 | 非连续帧的鲁棒匹配 |
训练数据策略
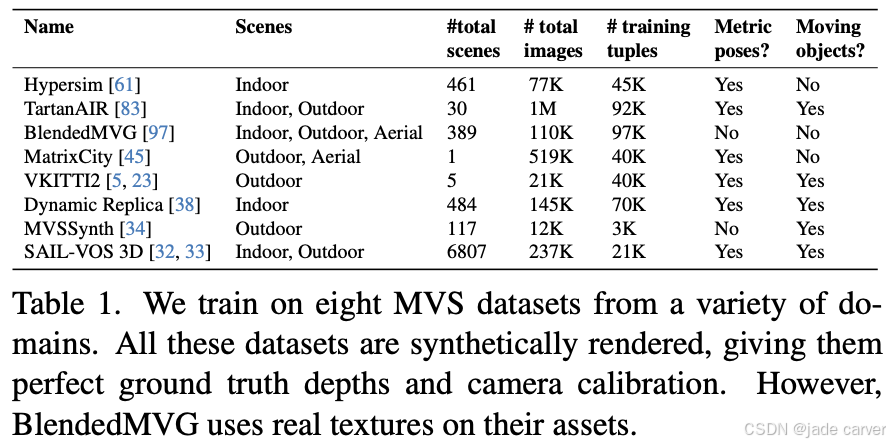
我们在Tab1中列出的大量多样化的合成数据集上进行训练。这些训练数据集的子集包含移动对象。我们的参考图像编码器是从Depth Anything V2(DAV2)[94]初始化的,它使用与我们类似的合成数据集训练的教师网络,以及使用与我们的评估基准不重叠的各种真实图像蒸馏的学生网络。DAV2是从预训练的DI-NOv2 [54]网络中初始化的,反过来又在互联网图像上训练。
三、实验
我们通过深度估计与三维重建两项任务评估MVSA性能,同时实现并报告了多项新基线的结果(这些方法此前未在目标基准测试中被评估)。

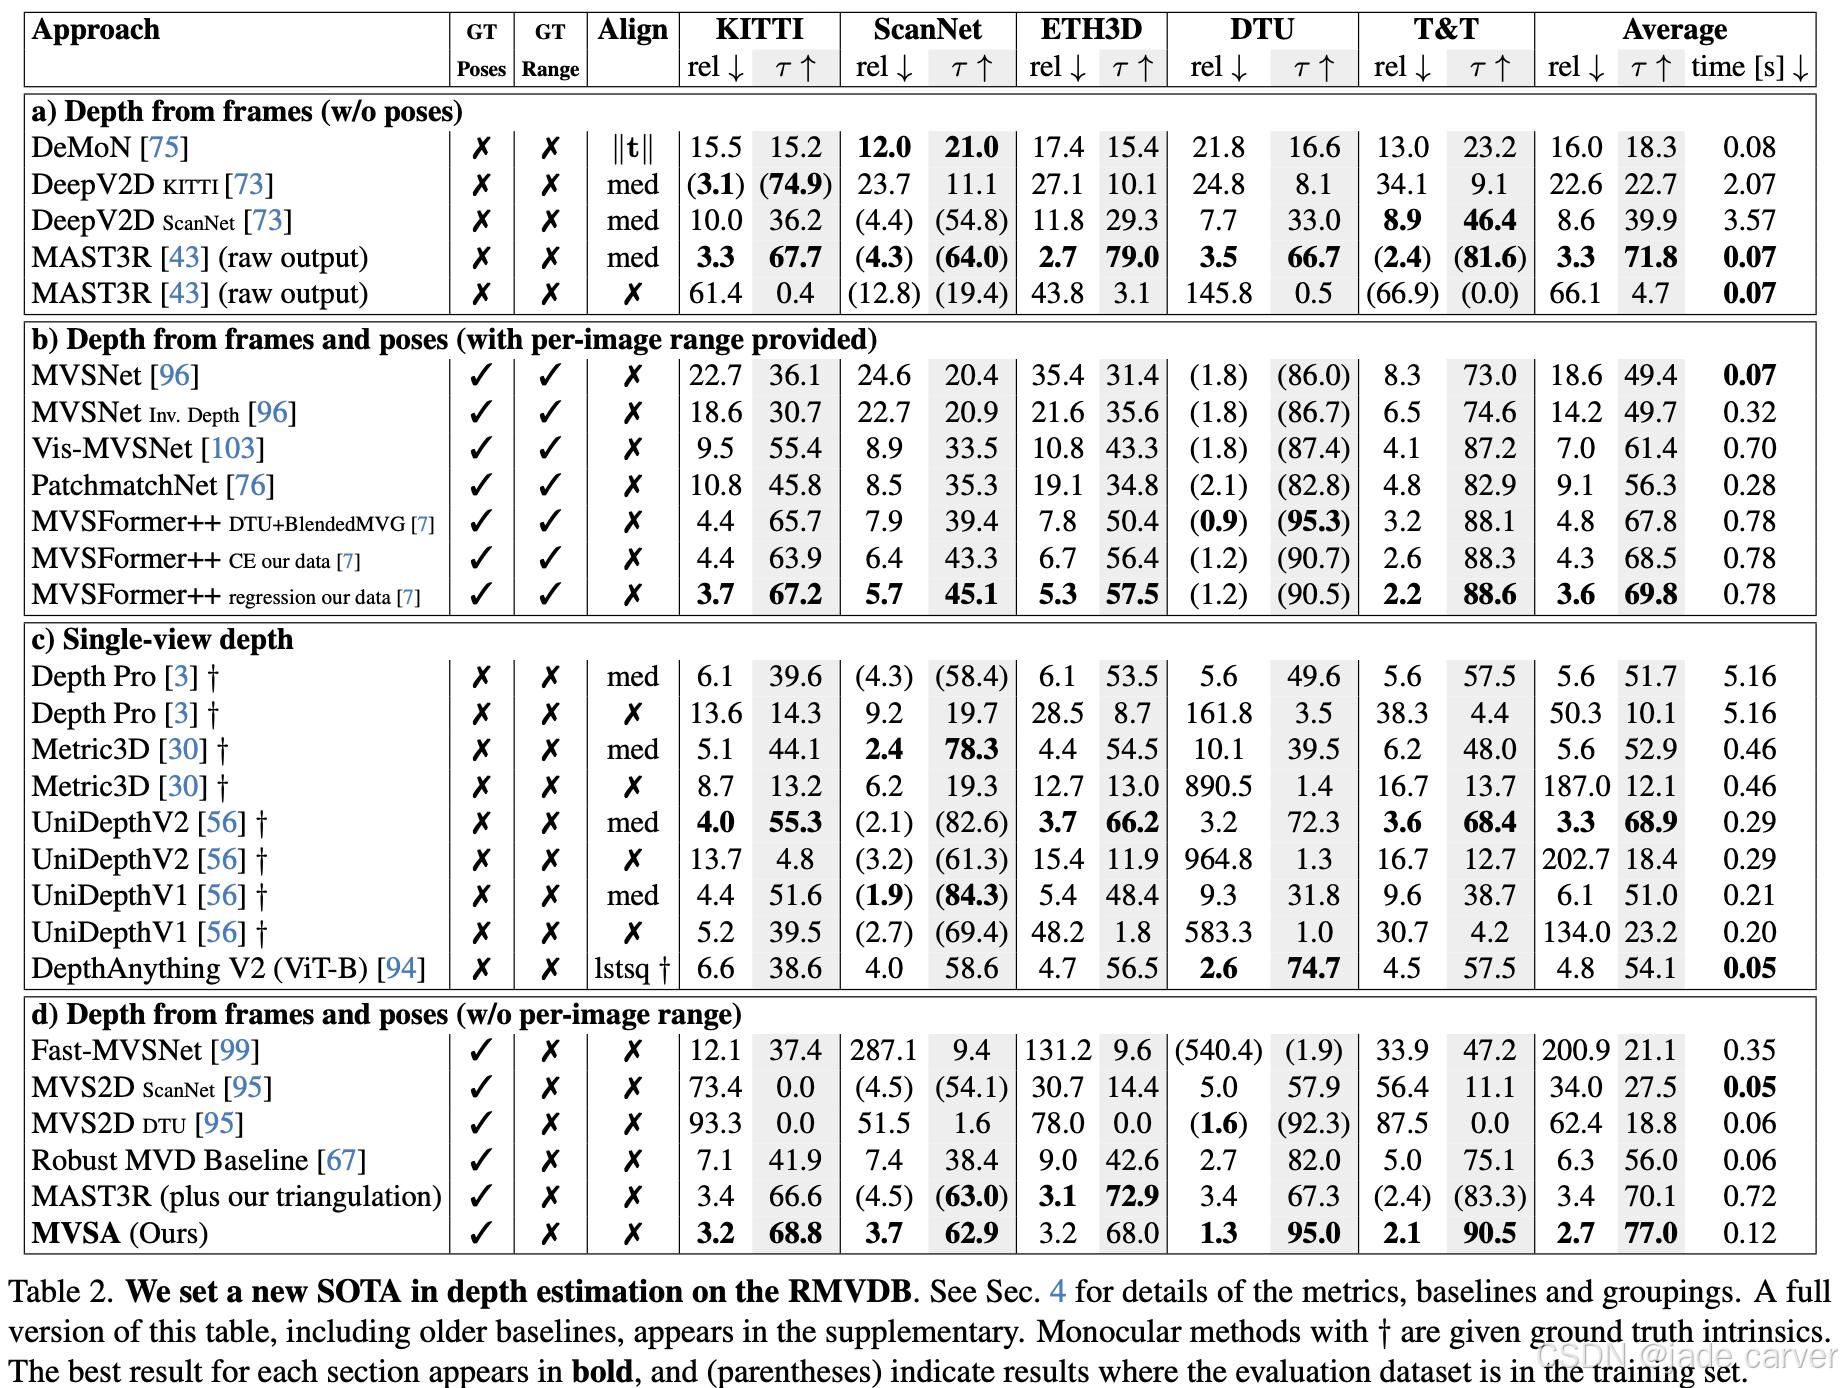
评估指标
- 相对绝对误差(rel):|d̂-d|/d
- 阈值1.03的inlier百分比:max(d̂/d,d/d̂)<1.03
定量分析如表2:
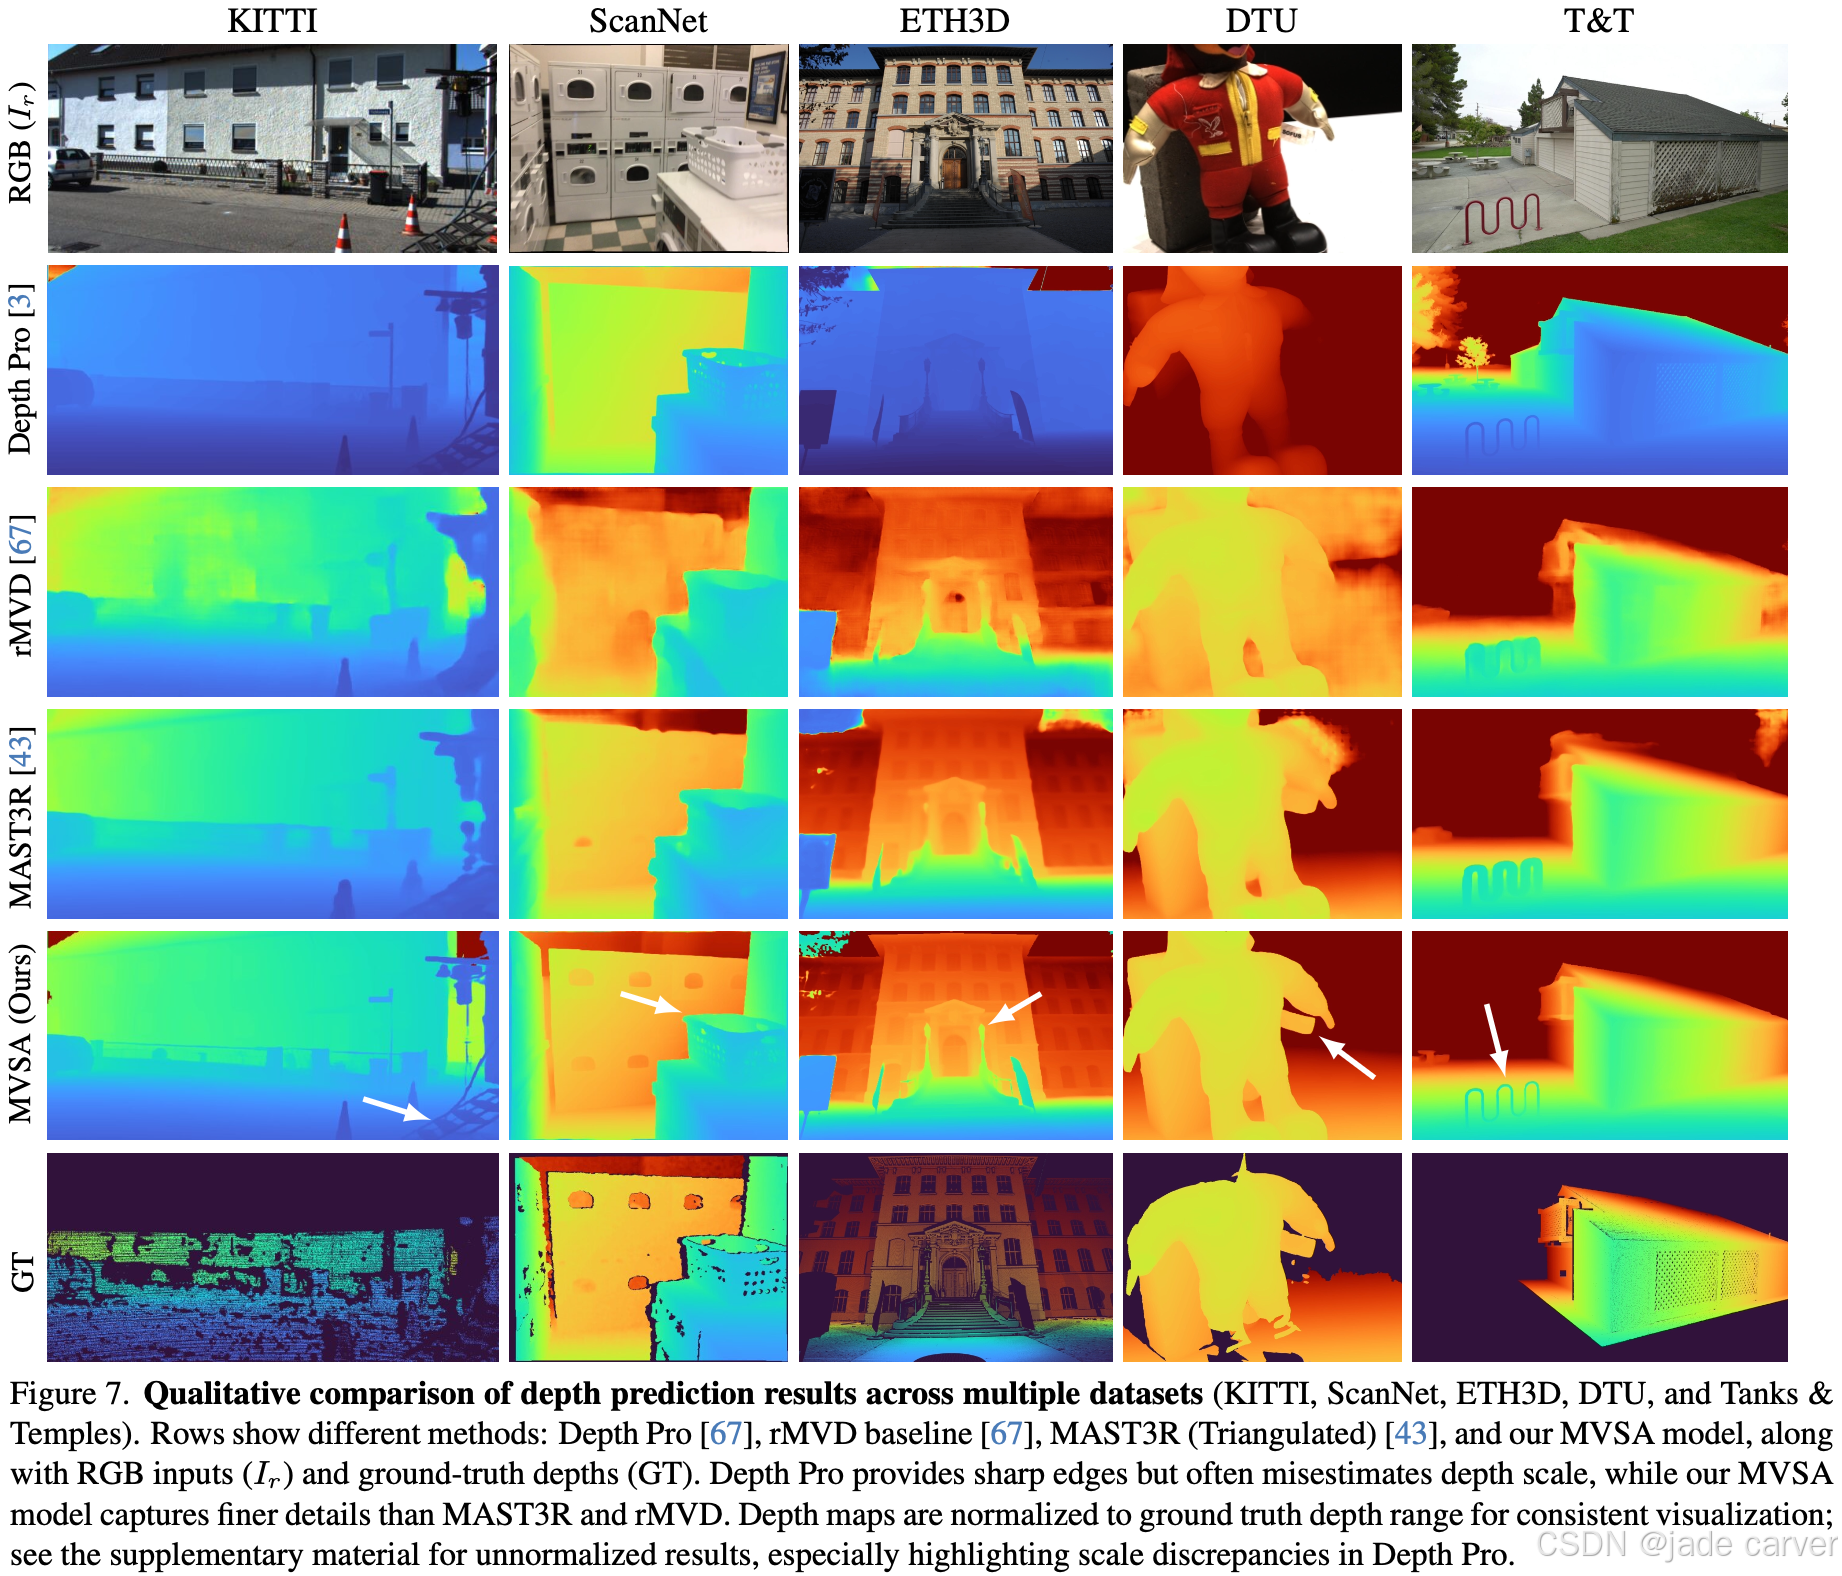
定性分析(图6-7)
- 边缘细节:MVSA保持更清晰的深度边界
- 运动物体:在KITTI动态场景中表现稳健
- 尺度一致性:无需后处理即实现准确米制深度

四、结论与不足
我们提出了MVSAnywhere这一通用多视角立体视觉框架,通过ViT架构优化、动态几何元数据融合和自适应深度范围处理,在多个挑战性数据集上实现了零样本SOTA性能,部分场景甚至超越领域专用模型。该工作为跨域部署、灵活视图配置和三维重建提供了实用解决方案。
当前方法未显式建模时序连续性,可能导致视频应用的帧间抖动;级联代价体积结构带来约30%的计算开销;在超近距(<0.5m)或超远距(>1km)场景仍需参数调整。这些局限为未来研究指明了改进方向。
参考文献:https://nianticlabs.github.io/mvsanywhere/resources/MVSAnywhere.pdf

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 20
 0
- 0


 已为社区贡献1条内容

所有评论(0)